

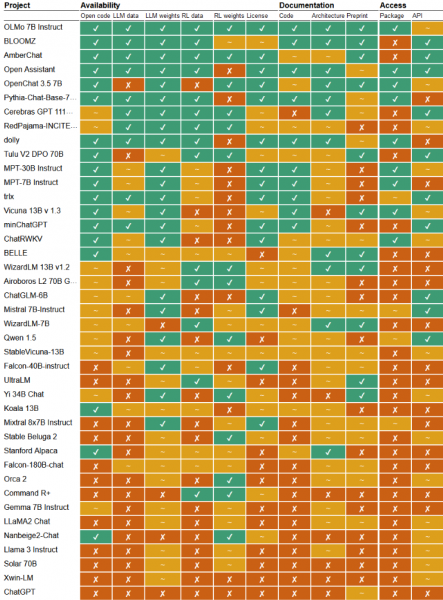
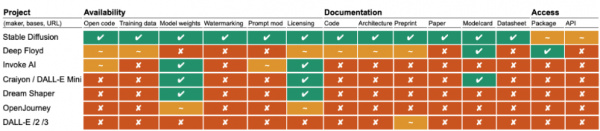
Forscher der Universität Nijmegen (Niederlande) haben ein Ranking der Offenheit von 40 großen Sprachmodellen und 7 Modellen zur Generierung von Bildern aus Text beschrieben, die von den Herstellern als offen deklariert werden. Da die Kriterien für die Offenheit von Modellen des maschinellen Lernens noch in der Entwicklung sind, besteht derzeit die Situation, dass als offen verbreitete Modelle mit Lizenzen verkauft werden, die den Anwendungsbereich einschränken (zum Beispiel verbieten viele Modelle die Verwendung in kommerziellen Projekten). Zudem stellen Hersteller häufig keinen Zugang zu den verwendeten Trainingsdaten zur Verfügung, geben keine Details zur Implementierung preis oder öffnen nicht den vollständigen begleitenden Code.
Die meisten Modelle, die als „offen“ positioniert werden, sollten tatsächlich als „offene Gewichtung“ oder genauer „verfügbare Gewichtung“ betrachtet werden, da sie unter einschränkenden Lizenzen verbreitet werden, die die Nutzung in kommerziellen Produkten untersagen. Drittanbieter können mit solchen Modellen experimentieren, haben jedoch keine Möglichkeit, das Modell an ihre Bedürfnisse anzupassen oder die Implementierung zu inspizieren. Mehr als die Hälfte der Modelle bietet keine detaillierten Informationen zu den für das Training verwendeten Daten und veröffentlicht auch keine Informationen zur inneren Funktionsweise und Architektur.
Am offensten gelten die Modelle BloomZ, AmberChat, OLMo, Open Assistant und Stable Diffusion, die unter offenen Lizenzen zusammen mit den Quellcodes, Daten und der API-Implementierung veröffentlicht wurden. Modelle von Google (Gemma 7B), Microsoft (Orca 2) und Meta (Llama 3), die von den Herstellern als offen positioniert werden, landeten am Ende des Rankings, da sie keinen Zugang zu den Quelldaten bieten, technische Details zur Implementierung nicht offenlegen und die Gewichtungen des Modells unter Lizenzen verbreiten, die den Anwendungsbereich einschränken. Das beliebte Modell Mistral 7B befindet sich etwa in der Mitte des Rankings, da es unter einer offenen Lizenz bereitgestellt wird, jedoch nur teilweise dokumentiert ist, keine Informationen über die verwendeten Trainingsdaten preisgibt und nicht vollständig offenen begleitenden Code hat.
Forschende haben 14 Kriterien für die Offenheit von KI-Modellen vorgeschlagen, die Bedingungen für die Verbreitung von Code, Trainingsdaten, Gewichtungsfaktoren, Datenvarianten und faktoren, die durch Reinforcement Learning (RL) optimiert wurden, sowie die Verfügbarkeit von einsatzbereiten Paketen, APIs, Dokumentationen und detaillierten Implementierungsbeschreibungen umfassen.
Gemäß dem von der OSI (Open Source Initiative) vorgeschlagenen Entwurf zur Definition von offener KI sind die Hauptkriterien für die Offenheit eines KI-Systems die Bereitstellung der Möglichkeit zur Nutzung für beliebige Zwecke ohne die Notwendigkeit, eine separate Erlaubnis zu erhalten; das Studium der Funktionsweise des Systems und die Inspektion seiner Komponenten; die Möglichkeit zur Änderung zu beliebigen Zwecken; sowie die Übertragung an Dritte sowohl der Originalversion als auch der bearbeiteten Fassung nach Änderungen.
Um die Möglichkeit zur Durchführung von Änderungen zu bieten, sollte das KI-System Folgendes beinhalten:
- Detaillierte Informationen über die für das Training verwendeten Daten und die Methodologie des Trainings. Die Informationen müssen ausreichend sein, damit ein professioneller Entwickler in der Lage ist, ein entsprechendes KI-System mit denselben oder ähnlichen Daten selbst zu rekonstruieren.
- Das Vorhandensein von Quellcode, der sowohl die Ausführung des KI-Systems als auch den Trainingsprozess ermöglicht (in der oben betrachteten Tabelle ist in der Spalte "Code" bei vielen Modellen ein "~" angegeben, was teilweise Vorhandensein von Code bedeutet, wenn der Code zum Starten des Modells verfügbar ist, jedoch der Code für das Training oder die Erstellung des Modells fehlt). Der Code sollte auch Bereiche wie Preprocessing, Datenvalidierung und Tokenisierung abdecken. Darüber hinaus sollte eine detaillierte Beschreibung der Modellarchitektur bereitgestellt werden.
- Die Modelparameter (Gewichtsfaktoren), die darauf hindeuten, dass ein einsatzbereiter Snapshot des Status nach dem Training oder eine finale optimierte Version des Modells vorliegt.
Quelle: opennet.ru
