

In unseren Projekten verwenden wir eine mikroservicebasierte Architektur. Bei der Entstehung von Engpässen in der Leistung wird viel Zeit für das Monitoring und die Analyse von Protokollen aufgewendet. Bei der Protokollierung der Zeiten einzelner Vorgänge in die Logdatei ist es in der Regel schwierig zu verstehen, was zu den Aufrufen dieser Vorgänge geführt hat, die Reihenfolge der Aktionen nachzuvollziehen oder die zeitliche Verschiebung eines Vorgangs im Verhältnis zu einem anderen in verschiedenen Diensten zu verfolgen.
Um den manuellen Aufwand zu minimieren, haben wir uns entschieden, ein Werkzeug zur Tracierung zu nutzen. In diesem Artikel werden wir erörtern, wie und wozu Tracierung verwendet werden kann und wie wir es gemacht haben.
Welche Probleme können mit Tracierung gelöst werden
- Engpässe in der Leistung sowohl innerhalb eines einzelnen Dienstes als auch im gesamten Ausführungsbaum zwischen allen beteiligten Diensten zu finden. Zum Beispiel:
- Viele kurze aufeinanderfolgende Aufrufe zwischen Diensten, zum Beispiel für Geokodierung oder auf die Datenbank.
- Lange Wartezeiten beim Ein- und Ausgabe, zum Beispiel beim Datentransfer über das Netzwerk oder beim Lesen von der Festplatte.
- Langes Parsen von Daten.
- Lange Operationen, die CPU erfordern.
- Codeabschnitte, die für das Endergebnis nicht erforderlich sind und entfernt oder verzögert ausgeführt werden können.
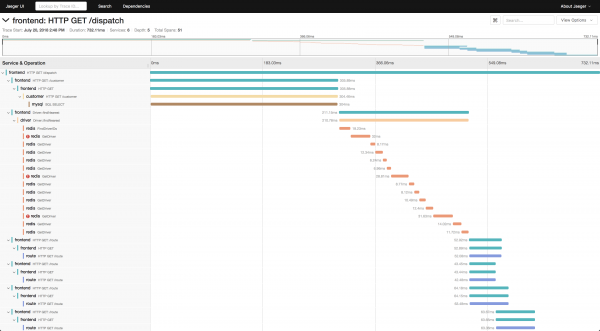
- Visuell nachvollziehen, in welcher Reihenfolge was aufgerufen wird und was passiert, wenn eine Operation ausgeführt wird.

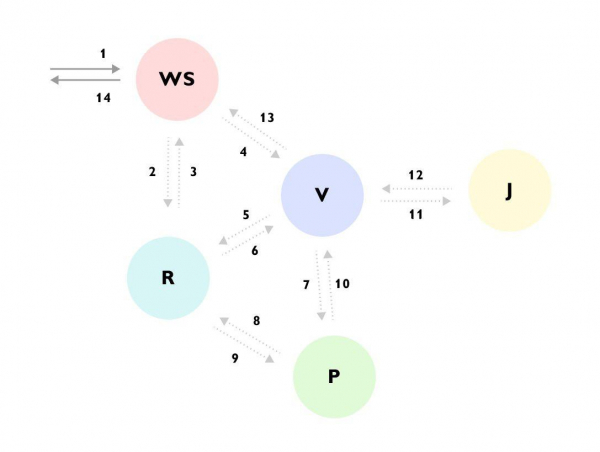
Es ist sichtbar, dass zum Beispiel die Anfrage im Dienst WS angekommen ist -> der Dienst WS die Daten über den Dienst R ergänzt hat -> dann eine Anfrage an den Dienst V gesendet hat -> der Dienst V viele Daten aus dem Dienst R geladen hat -> dann den Dienst P aufgerufen hat -> der Dienst R ein weiteres Mal aufgerufen wurde -> der Dienst V das Ergebnis ignorierte und zum Dienst J ging -> und erst danach die Antwort an den Dienst WS zurückgab, während im Hintergrund weiterhin etwas anderes berechnet wurde.
Ohne ein solches Trace oder detaillierte Dokumentation des gesamten Prozesses ist es sehr schwer zu verstehen, was vor sich geht, wenn man zum ersten Mal den Code betrachtet, und der Code ist zudem über verschiedene Dienste verteilt und hinter einer Vielzahl von Beans und Schnittstellen verborgen. - Sammlung von Informationen über den Ausführungsbaum zur späteren verzögerten Analyse. In jedem Ausführungsstadium können im Trace Informationen hinzugefügt werden, die zu diesem Zeitpunkt verfügbar sind, um anschließend herauszufinden, welche Eingangsdaten zu einem solchen Szenario geführt haben. Zum Beispiel:
- Benutzer-ID
- Berechtigungen
- Art der gewählten Methode
- Log oder Ausführungsfehler
- Die Umwandlung von Traces in eine Teilmenge von Metriken und die anschließende Analyse in Form von Metriken.
Was die Trace-Logging-Funktionalität bietet. Span
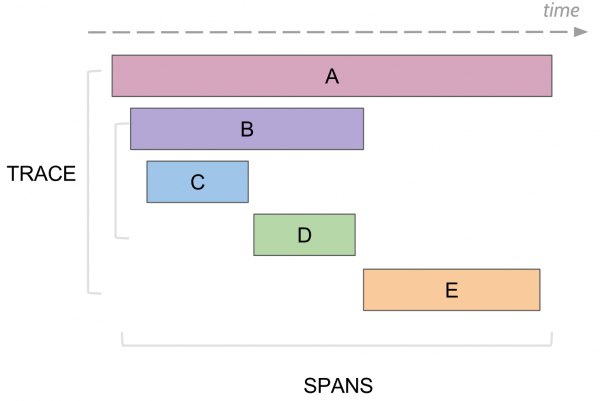
In der Trace-Analyse gibt es das Konzept des Span, das einem einzelnen Log in der Konsole entspricht. Ein Span hat folgende Eigenschaften:
- Name, normalerweise der Name der ausgeführten Methode
- Name des Dienstes, in dem der Span generiert wurde
- Eindeutige eigene ID
- Irgendeine Meta-Information in Form von Key/Value, die darin protokolliert wurde. Zum Beispiel, Parameter der Methode oder ob die Methode mit einem Fehler beendet wurde oder nicht
- Die Start- und Endzeit der Ausführung dieses Spans
- ID des übergeordneten Spans
Jeder Span wird an den Collector gesendet, um in eine Datenbank gespeichert zu werden, für eine spätere Ansicht, sobald er seine Ausführung abgeschlossen hat. Später kann ein Baum aller Spans erstellt werden, indem sie nach der ID des Elternteils verbunden werden. Bei der Analyse kann man beispielsweise alle Spans in einem bestimmten Dienst finden, die länger als eine bestimmte Zeit in Anspruch genommen haben. Weiterhin kann man zu einem spezifischen Span gehen und die gesamte Hierarchie über und unter diesem Span sehen.
Opentrace, Jaeger und wie wir dies für unsere Projekte umgesetzt haben
Es gibt einen gemeinsamen Standard , der beschreibt, wie und was gesammelt werden sollte, ohne die Trace-Implementierung an eine spezifische Programmiersprache zu binden. Zum Beispiel wird in Java die gesamte Arbeit mit Traces über die gemeinsame API von Opentrace durchgeführt, und darunter kann sich beispielsweise Jaeger oder eine leere Standardimplementierung verbergen, die nichts tut.
Wir verwenden als Implementierung von Opentrace. Es besteht aus mehreren Komponenten:
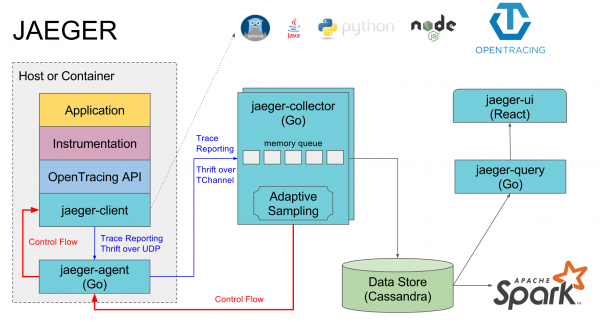
- Jaeger-Agent — ein lokaler Agent, der normalerweise auf jedem Rechner läuft, und in ihn protokollieren die Dienste auf dem lokalen Standardport. Wenn es keinen Agenten gibt, sind die Traces aller Dienste auf diesem Rechner normalerweise deaktiviert.
- Jaeger-Collector — dorthin senden alle Agenten die gesammelten Traces, und er speichert sie in der gewählten Datenbank.
- Datenbank — bevorzugt verwenden sie Cassandra, aber wir nutzen Elasticsearch. Es gibt auch Implementierungen für einige andere Datenbanken und eine In-Memory-Implementierung, die nichts auf der Festplatte speichert.
- Jaeger-Query — dies ist ein Dienst, der in die Datenbank geht und die bereits gesammelten Traces für die Analyse zurückgibt.
- Jaeger-UI — dies ist eine Weboberfläche zum Suchen und Betrachten von Traces, die auf Jaeger-Query zugreift.
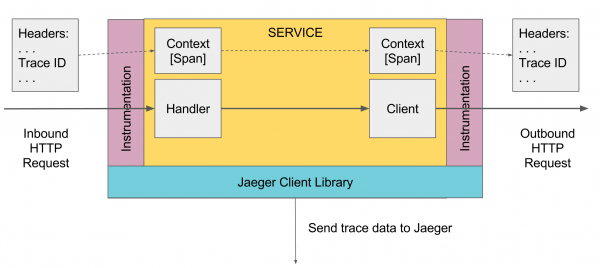
Als separate Komponente kann man die Opentrace Jaeger-Implementierung für spezifische Sprachen anführen, durch die Spans an den Jaeger-Agenten gesendet werden.
Es geht darum, das Interface io.opentracing.Tracer zu implementieren, nach dem alle Traces über ihn an den echten Agenten gesendet werden.
Außerdem kann für Spring-Komponenten die und die Implementierung von Jaeger verwendet werden, die automatisch die Tracing-Konfiguration für alles vornimmt, was durch diese Komponenten geht, wie z.B. HTTP-Anfragen an Controller, Datenbankabfragen über JDBC usw.
Logging von Traces in Java
An oberster Stelle sollte der erste Span erzeugt werden, was automatisch durch den Spring-Controller beim Empfang einer Anfrage geschehen kann, oder manuell, falls dies nicht der Fall ist. Danach wird er durch den Scope weitergegeben. Wenn eine Methode weiter unten einen Span hinzufügen möchte, nimmt sie den aktuellen activeSpan aus dem Scope, erstellt einen neuen Span und gibt an, dass der erhaltene activeSpan der Elternteil ist, wodurch der neue Span aktiv wird. Bei Aufrufen von externen Services wird der aktuelle aktive Span übergeben, und diese Services erstellen neue Spans, die mit diesem Span verknüpft sind.
Die gesamte Arbeit erfolgt über die Instanz von Tracer, die man über das DI-Mechanismus oder über GlobalTracer.get() als globale Variable erhalten kann, falls das DI-Mechanismus nicht funktioniert. Standardmäßig wird, wenn der Tracer nicht initialisiert wurde, der NoopTracer zurückgegeben, der nichts macht.
Anschließend wird der aktuelle Scope durch ScopeManager aus dem Tracer abgerufen, ein neuer Scope wird basierend auf dem aktuellen erstellt, mit Verknüpfung zum neuen Span, und daraufhin wird der erstellte Scope geschlossen, wodurch der neu erzeugte Span beendet und der vorherige Scope wieder aktiv wird. Scope ist an den Thread gebunden, deshalb sollte man bei der mehrschichtigen Programmierung nicht vergessen, den aktiven Span in einen anderen Thread zu übertragen, um den Scope des anderen Threads mit diesem Span zu aktivieren.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Dinge tun.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // SCHRITT 2 OBEN: den Span im Callback reaktivieren, indem true an
            // startActive() übergeben wird, falls der Span beendet werden muss.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Für die Mehrfadenprogrammierung gibt es auch den TracedExecutorService und ähnliche Wrapper, die den aktuellen Span automatisch im Thread bei der Ausführung asynchroner Aufgaben weitergeben:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Für externe HTTP-Anfragen gibt es
HttpClient httpClient = new TracingHttpClientBuilder().build();Die Probleme, mit denen wir konfrontiert waren
- Beans und DI funktionieren nicht immer, wenn der Tracer nicht in einem Service oder einer Komponente verwendet wird, dann Kann der Tracer möglicherweise nicht funktionieren und man muss GlobalTracer.get() verwenden.
- Annotationen funktionieren nicht, wenn dies keine Komponente oder ein Service ist, oder wenn der Methodenaufruf aus einer benachbarten Methode derselben Klasse erfolgt. Man muss vorsichtig sein, prüfen, was funktioniert, und manuelle Trace-Erstellung verwenden, wenn @Traced nicht funktioniert. Außerdem kann man einen zusätzlichen Compiler für Java-Annotationen hinzufügen, dann sollten sie überall funktionieren.
- In älteren Spring- und Spring-Boot-Versionen funktioniert die Autokonfiguration von OpenTracing Spring Cloud aufgrund von Bugs in DI nicht richtig, daher, wenn man möchte, dass die Traces in den Spring-Komponenten automatisch funktionieren, kann man es ähnlich wie bei
- In Groovy funktioniert try with resources nicht, man muss unbedingt try finally verwenden.
- Jeder Service muss seinen eigenen spring.application.name haben, unter dem die Traces protokolliert werden. Zudem braucht man einen separaten Namen für Produktion und Test, um sie nicht zu vermischen.
- Wenn man GlobalTracer und Tomcat verwendet, haben alle Services, die in diesem Tomcat ausgeführt werden, einen einzigen GlobalTracer, deshalb haben sie alle denselben Servicenamen.
- Beim Hinzufügen von Traces zu einer Methode muss man sicherstellen, dass sie nicht in einer Schleife mehrfach aufgerufen wird. Man sollte einen gemeinsamen Trace für alle Aufrufe hinzufügen, der die Gesamtdauer protokolliert. Andernfalls entsteht eine übermäßige Last.
- Einmal haben wir im Jaeger-UI zu große Anfragen für eine große Anzahl von Traces gestellt und da wir nicht auf die Antwort warteten, haben wir es erneut getan. Infolgedessen begann jaeger-query viel Speicher zu verbrauchen und verlangsamte Elastic. Ein Neustart von jaeger-query half.
Sampling, Speicherung und Anzeige von Traces
Es gibt drei Typen :
- Const, der alle Traces sendet und speichert.
- Probabilistic, der Traces mit einer bestimmten Wahrscheinlichkeit filtert.
- Ratelimiting, das die Anzahl der Traces pro Sekunde einschränkt. Diese Parameter können entweder auf dem Client, dem jaeger-agent oder im Collector konfiguriert werden. Momentan verwenden wir in unserem Stack von Validierern const 1, da die Anfragen nicht sehr zahlreich sind, aber sie eine längere Zeit in Anspruch nehmen. Wenn dies in Zukunft zu einer übermäßigen Belastung des Systems führt, kann eine Beschränkung vorgenommen werden.
Wenn Cassandra verwendet wird, speichert sie standardmäßig Traces nur für zwei Tage. Bei uns werden und Traces werden über einen längeren Zeitraum gespeichert und nicht gelöscht. Für jeden Tag wird ein separater Index erstellt, zum Beispiel jaeger-service-2019-03-04. In Zukunft muss eine automatische Bereinigung alter Traces eingerichtet werden.
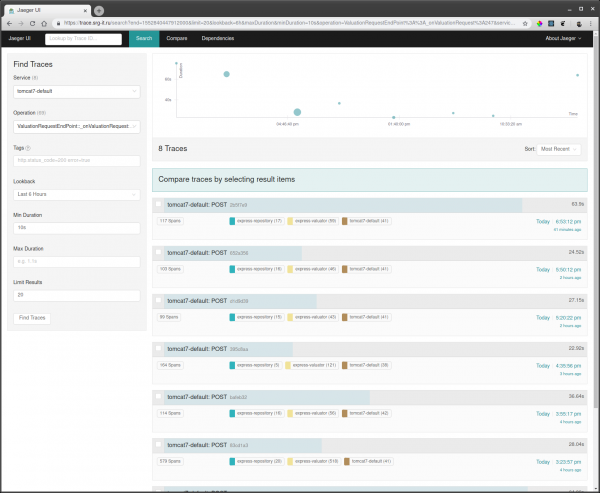
Um Traces anzusehen, muss man:
- Den Service auswählen, nach dem die Traces gefiltert werden sollen, zum Beispiel tomcat7-default für den Service, der in Tomcat läuft und keinen eigenen Namen haben kann.
- Dann die Operation, den zeitlichen Rahmen und die minimale Verweildauer der Operation auswählen, zum Beispiel ab 10 Sekunden, um nur lange Ausführungen zu erfassen.

- In einen der Traces wechseln und sehen, was dort gestockt hat.

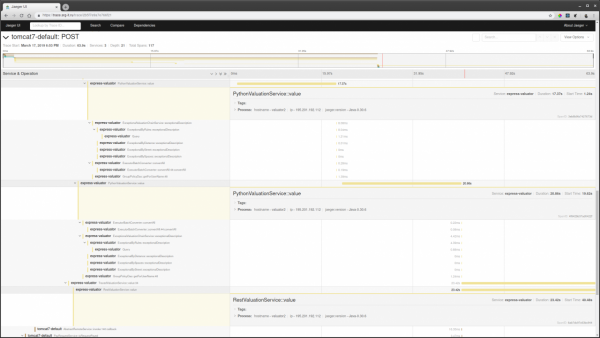
Wenn eine bestimmte ID der Anfrage bekannt ist, kann der Trace über diese ID durch Tagsuche gefunden werden, wenn diese ID im Span des Traces protokolliert wird.
Dokumentation
- Dokumentation von OpenTracing
- Dokumentation von Jaeger
- Jaeger Java-Integration
- Spring OpenTracing-Integration
Artikel
- Jaeger OpenTracing und Microservices in einem realen Projekt mit PHP und Golang
- Evolving Distributed Tracing bei Uber Engineering
- Jaeger Agent auf Bare Metal betreiben
Videos
- Wie wir Jaeger und Prometheus verwendet haben, um blitzschnelle Benutzeranfragen zu liefern – Bryan Boreham
- Intro: Jaeger – Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, “Eine kleine Geschichte eines großen Sieges: OpenTracing, AWS und Jaeger”
Quelle: habr.com
