

Dziiiiiiiin! Es ist 3 Uhr morgens, Sie haben einen wunderbaren Traum und plötzlich - das Telefon klingelt. In dieser Woche sind Sie im Dienst, und offenbar ist etwas passiert. Das automatisierte System fordert Sie auf, herauszufinden, was los ist. Das ist ein wichtiger Aspekt der Verwaltung moderner Computersysteme, aber lassen Sie uns sehen, wie man Benachrichtigungen benutzerfreundlicher macht.
Lernen Sie die Philosophie des Monitorings kennen, die aus mehreren Jahrzehnten meiner Dienste in verschiedenen Monitoring-Teams hervorgegangen ist. Sie wurde stark von der wahren Bibel von Rob Evashuk beeinflusst. (Meine Philosophie der Benachrichtigungen), die in das Buch über , und das Buch von John Allspaw (Überlegungen zur Alarmierung).
, und — danke für die Hilfe beim Bearbeiten des Beitrags.
Was ist CASE?
Ich wollte ein schönes Akronym entwickeln, wie bei oder . Ich nenne es die CASE-Methode. Sie beschreibt vier Punkte, auf die Sie bei der Arbeit mit automatisiertem Monitoring achten sollten:
- (Bezug zum Kontext)
- (praktischer Nutzen)
- (Fokus auf Symptome)
- (Bewertung)
Wenn Sie CASE verwenden, gehen Sie mit Benachrichtigungen gesund unbesorgt um und wecken die Leute nachts nicht auf. Es ist notwendig, das Monitoring regelmäßig auf Nützlichkeit und Effektivität zu bewerten. Wenn eine Person eine Benachrichtigung erhält, hat sie bessere mentale Modelle und mehr Vertrauen.
Um es leichter zu merken, stellen Sie sich vor, dass Sie einen CASE [also einen Fall, einen Grund — Anm. des Übersetzers], benötigen, um jede Benachrichtigung zu rechtfertigen. :sunglasses:
Und warum das alles?
. Aus vielen Gründen. Und CASE wird sie nicht alle beseitigen. Aber damit werden Sie nachts von qualitativ besseren Benachrichtigungen geweckt. Diese Methode umfasst verschiedene organisatorische Prozesse, die ebenfalls dabei helfen werden.
Der Reiz der RED- und USE-Methoden liegt darin, dass wir damit nicht nur wissen, wie wir arbeiten, sondern auch, dass wir gemeinsam in einer Sprache reden. Ich hoffe, dass es mit der CASE-Methode einfacher wird, über Benachrichtigungen zu diskutieren, die unsere Systeme schützen, aber unseren Kollegen keine Ruhe lassen.
Es geht darum, in der Organisation eine Kultur zu schaffen, in der Benachrichtigungen mit einem gesunden Gleichmut betrachtet werden. Benachrichtigungen können aus einem bestimmten Grund erstellt werden, aber das bedeutet nicht, dass sie später nicht an Wert verlieren. Warum haben wir diese Benachrichtigung eingestellt? Wurden ihre Kriterien schon lange überprüft? Mit CASE können Antworten auf diese Fragen gefunden werden.
Kontextbasiert – Bezugnahme auf den Kontext
3 Uhr morgens ist nicht die beste Zeit, um Nachrichten zu lesen, die viele komplizierte Wörter enthalten. Um effektiv zu reagieren, sind Informationen erforderlich. Idealerweise handelt es sich um Informationen zu einem bestimmten Problem, bei dem der Kontext sofort ersichtlich ist, und die Benachrichtigungen sollten so eingestellt werden, dass dies möglich ist. Es handelt sich um "Beobachtung" und "Orientierung" aus Für diese Einstellung bedarf es keiner besonderen Zeit, da es noch teurer ist, die Person ständig abzulenken. Lassen Sie uns gegenseitig respektieren.
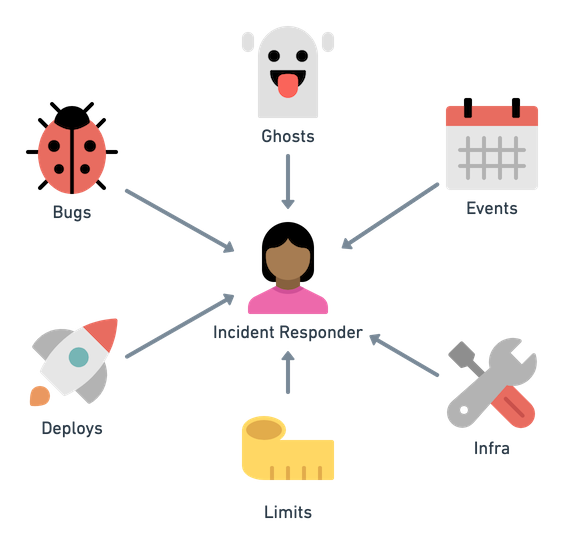
Probleme haben viele Quellen. Besonders Geister.
Wie kann man dem Diensthabenden helfen? Zunächst sieht der Diensthabende die Benachrichtigung, daher basiert er alle Hypothesen darauf. Dann schaut er sich die Anweisungen und Dashboards an, aber gibt es dort immer Daten zu der spezifischen Benachrichtigung und nicht nur allgemeine Informationen? Olspo empfiehlt zu "denken, wie man die Benachrichtigung interpretieren oder darauf reagieren kann" (Folie 29).Eine gute Benachrichtigung ist auf den Diensthabenden ausgerichtet und nicht einfach nur nach einem Schwellenwert eingestellt.
Deshalb hier Ideen, wie man den Kontext von Benachrichtigungen verbessern kann:
- Zeigen Sie dem Benutzer etwas Nützliches und Spezielles, nicht einfach nur allgemeine Anweisungen oder ein Dashboard. Früher haben wir mit den Kollegen Dashboards verwendet, die auf spezifische Benachrichtigungen für Untersuchungen ausgerichtet waren. Das hilft, wenn das Problem bekannt ist, und verwirrt in anderen Fällen. Hier muss das Gleichgewicht gefunden werden.
- Erzählen Sie die Geschichte der Benachrichtigung: Ist sie neu? Schlägt sie oft an? Ist sie saisonabhängig?
- Zeigen Sie kürzliche Änderungen im Systemzustand. Hat sich kürzlich etwas geändert? (Zum Beispiel ein Deployment oder das Ein- bzw. Ausschalten von Funktionen.)
- Zeigen Sie Beziehungen auf und geben Sie Informationen für ein mentales Modell: Die Abhängigkeiten des Systems sollten klar erkennbar sein, idealerweise mit Angaben zur Funktionsfähigkeit.
- Stellen Sie eine schnelle Verbindung zwischen dem Benutzer und dem Team her: Sieht er die aktuellen Vorfälle oder kann er herausfinden, wer sonst im Unternehmen die Benachrichtigung erhalten hat? Die Software aktiviert?
Idealerweise gibt das Incident-Management-Programm Ratschläge, wie der Kontext der Benachrichtigung bei der Untersuchung von Vorfällen verbessert werden kann. Hier gibt es immer Raum für Verbesserungen!
Handlungsfähig - praktische Wertschöpfung
Muss der Bereitschaftsdienst auf die Benachrichtigung reagieren? Wenn nichts zu tun ist oder unklar ist, was zu tun ist, warum wurde dann geweckt? Vermeiden Sie Benachrichtigungen, die den Bereitschaftsdienst stören und keine Maßnahmen erfordern.
Was tun? Was muss gemacht werden?
Früher, als die Systeme einfach und die Teams klein waren, richteten wir das Monitoring ein, um einfach auf dem Laufenden zu bleiben. Eine Benachrichtigung, dass die Last auf dem Cluster gestiegen ist, gibt uns Kontext, falls der Dienst später Probleme hat. In großem Maßstab werden solche Benachrichtigungen nur verwirren, da unsere Systeme immer in einem Zustand unterschiedlicher Schweregrade von Degradation arbeiten. Das führt schnell zu und natürlich zum Verlust der Sensibilität. Daher ignoriert oder filtert der Bereitschaftsdienst solche Benachrichtigungen und reagiert nicht immer so, wie es nötig wäre. Lassen Sie sich nicht in diese Falle locken! Richten Sie nicht alle Benachrichtigungen ein, um sie später in einen vergrabenen Ordner im Postfach zu senden.
So sieht eine Benachrichtigung mit praktischem Wert aus:
- Die Benachrichtigung erfordert eine Aktion und informiert nicht nur über Neuigkeiten.
- Diese Aktion ist schwer oder riskant zu automatisieren. Wenn die Aktion automatisiert werden kann, dann automatisieren Sie sie, hören Sie auf, die Leute zu belästigen!
- Die Benachrichtigung enthält dringende Empfehlungen in Form von (SLA) oder (RTO). Dann kann der Bereitschaftsdienst das Incident-Management-Programm in der Organisation aktivieren.
Ich möchte klarstellen: Ich sage nicht, dass Benachrichtigungen nur für die wichtigsten SLOs (Service-Level-Objectives) für die API kommen sollten. Das Monitoring von SLOs wird ständig aufgeteilt und erfordert einen einheitlichen Ansatz für alle Dienste. Es ist klar, dass Sie die wichtigsten SLOs für die Kunden, die Ihnen Geld bezahlen, verfolgen werden. Aber auch die SLOs der Infrastruktur, wie beispielsweise bei Datenbanken, müssen überwacht werden. Bald werden Sie sich um interne Kunden kümmern und diese unterstützen müssen. Und so weiter bis ins Unendliche.
Symptomorientiert - Fokus auf Symptome
Egal, ob es Ihnen gefällt oder nicht, Sie arbeiten in einem verteilten System (Kawadsch). Infolgedessen verwenden Sie verschiedene Taktiken, um die Dienste zu isolieren und sie vor Ausfällen zu schützen (Treynor et al.) 3. Und obwohl ein langwieriger Garbage Collection-Prozess oder eine stockende Datenbankabfrage auf Probleme hinweisen, sollten Sie diese nicht hastig beheben, solange die Benutzer in der nächsten Zeit keine Schwierigkeiten haben werden.
Dies sind wichtige Signale, und sie können praktischen Wert haben, aber wenn sie die Benutzer nicht stören, ist es nicht so dringend, dass es den Bereitschaftsdienst ablenken sollte. Benachrichtigungen basierend auf Ursachen sind Momentaufnahmen unserer mentalen Modelle über Systemausfälle. Es ist besser, wichtige Symptome zu verfolgen, als zu versuchen, alle möglichen Ursachen für einen Ausfall aufzulisten.
Damit Benachrichtigungen praktischen Wert haben, konzentrieren Sie sich auf , die für die Benutzer wichtig sind. Ewatschuk nennt dies "Monitoring für Benutzer". Denken Sie daran, dass diese Philosophie in der gesamten Organisation angewendet werden muss. Wenn ein Dienst irgendwo in der Infrastruktur dringende Probleme hat, wird sich das zuständige Team darum kümmern. Den Schutz der Systeme vor solchen Ausfällen zu gewährleisten, ist eine völlig andere Frage (Treynor et al., Abschnitt über Strategien zur Minimierung kritischer Abhängigkeiten).
Die Symptome sind nicht so wechselhaft
Richard Cook erinnert daran, dass komplexe Systeme eine Menge Mängel, Schwächen und Probleme aufweisen. Der Versuch, alle möglichen Ursachen aufzulisten, ist eine Sisyphusarbeit. Sie versuchen, Probleme zu beschreiben, während sie sich ständig ändern. Cindy Shridharan ist der Meinung, dass "Systeme nicht unbedingt jede Sekunde in einem perfekten Zustand sein müssen" und dass es besser ist, einen menschlicheren Ansatz zu nutzen ( ("Beobachtung verteilter Systeme"), 7).
Vermeiden Sie Benachrichtigungen über den Vorfall
Normalerweise werden Benachrichtigungen für Ursachen eingerichtet, um Vorfälle zu beheben. Und diese begrenzten Benachrichtigungen über den Vorfall selbst schaffen ein falsches Gefühl der Sicherheit, denn das System findet jedes Mal neue Möglichkeiten, auszufallen.
Täuschen Sie sich nicht mit Ursachenbenachrichtigungen. Besser ist es, darüber nachzudenken:
- Warum hat die symptomatische Benachrichtigung das Problem nicht bemerkt?
- Wäre es nützlich, den Kontext für den Benutzer zu verbessern?
- Wie können die Überwachungstools verbessert werden, um Diagnosen schneller zu stellen, anstatt nur Benachrichtigungen über das Geschehene zu sammeln?
Überwachungstools für die Diagnostik helfen nur, wenn Sie sie als Mittel betrachten, um vom Symptom zur Lösung zu gelangen. Ohne dieses Feedback werden Sie einfach mit verspäteten Benachrichtigungen und Diagrammen über vergangene Ausfälle überflutet – und es wird kein Wort über zukünftige Ausfälle verloren. Für die Organisation ist das eine großartige Gelegenheit, von der Defensive in die Offensive zu wechseln. Und die Entwickler und Produktmanager werden die gleichen Erwartungen und klaren Ziele haben. Der Fall – CASE (:wink:) – ist für jede Benachrichtigung klar.
Ursachenbasierte Benachrichtigungen sind in moderaten Mengen akzeptabel.
Manchmal lässt unser System kaum eine Wahl bezüglich benachrichtigung basierter Ursachen. Und manchmal wissen die Bereitschaftsteams sehr gut, dass ein Symptom zwangsläufig zu einem Ausfall führen wird, was es von praktischer Wert macht. Vielleicht sind Sie sich einfach nicht sicher, was passiert, und richten die Benachrichtigungen vorsichtshalber ein. Hoffen wir, dass dies vorübergehend erforderlich ist, bis wir das System ändern, um die Leistungsprobleme anzugehen.
Denken Sie an die anderen Komponenten von CASE, wenn Sie mit solchen Situationen umgehen. Wenn es vorübergehend ist, bedeutet das nicht, dass man nicht nachdenken sollte.
Evaluated – Bewertung
Jede Änderung im System (neuer Code, neue Infrastruktur, was auch immer neu ist) erweitert die Palette der Fehler (Cook, 3). Funktioniert diese Benachrichtigung genau so, wie erwartet? Klare und aktuelle mentale Modelle von Systemen sowie Erfahrungen im Umgang mit bestimmten Benachrichtigungen zur Unterstützung sind zentrale Merkmale Fehler in Systemen entwickeln sich ständig weiter, und wir müssen mit ihnen Schritt halten.
Es ist notwendig, die Qualität jeder Benachrichtigung ständig zu bewerten, damit sie wie erwartet funktioniert. Liebe Führungskräfte! Es wird Ihren Teams viel leichter fallen, wenn Sie ihnen dabei helfen, diesen Prozess zu etablieren! Hier sind einige Ideen zur Bewertung:
- Verwenden Sie , oder andere Methoden zur Testung von Benachrichtigungen. Das Team kann dies selbstständig tun, ohne ein schwerfälliges Incident-Management-System in Anspruch zu nehmen!
- Aktivieren Sie die Datensammlung über alle mit Vorfällen verbundenen Benachrichtigungen im Vorfallmanagement-Programm. Markieren Sie hilfreiche, schädliche, unangemessene, unverständliche usw. Verwenden Sie sie als Feedback.
- Die richtigen Benachrichtigungen lösen selten aus und sind sorgfältig geprüft. Stellen Sie sicher, dass alle Links funktionieren, auf den richtigen Kontext hinweisen usw.
- Wenn eine Benachrichtigung nie oder zu häufig auslöst, stimmt etwas nicht damit. Reparieren oder löschen Sie sie. Seien Sie vorsichtig mit übermäßiger Passivität oder Aktivität!
- Richten Sie Zeitstempel mit Ablaufdatum für Benachrichtigungen ein. Wenn das Ablaufdatum abgelaufen ist, bewerten Sie die Benachrichtigung nach der CASE-Methode und aktualisieren Sie den Zeitstempel. Überprüfen Sie regelmäßig das Ablaufdatum, wie bei Lebensmitteln.
- Vereinfachen Sie den Prozess zur Verbesserung der Benachrichtigungen. Verwenden Sie Monitoring in Form von Code und speichern Sie die Benachrichtigungen in einem Git-Repository. Pull-Requests helfen, das Team einzubeziehen, und Sie haben eine Historie vergangener Benachrichtigungen. Und Sie werden weniger Angst haben, Benachrichtigungen zu ändern oder um Erlaubnis von denen, die dafür verantwortlich sind, zu fragen.
- Schaffen Sie Feedback für Benachrichtigungen, selbst wenn es nur ein ist, damit die Diensthabenden Benachrichtigungen als nutzlos oder aufdringlich markieren. Bauen Sie einen Link oder einen Aufruf zum Handeln direkt in die Benachrichtigung ein und überprüfen Sie regelmäßig das Feedback.
- Setzen Sie in Ihrem Team die Regel fest, dass die Diensthabenden daran arbeiten sollen, den Dienst zu vereinfachen, wenn wenig zu tun ist. Lassen Sie alles nach Ihnen ein wenig besser sein, als es zuvor war.
Fazit
Ich glaube, dass die CASE-Methode Entwicklern und Organisationen hilft, die Konfiguration und den Versand automatisierter Benachrichtigungen zu diskutieren. Ein Entwickler kann mit der Bewertung von Benachrichtigungen nach der CASE-Methode beginnen, und dann kann die gesamte Organisation mit anderen Entwicklern, dem Management und Vorfallmanagement-Programmen beitreten, um die Benachrichtigungen in gutem Zustand zu halten. Dafür sind keine besonderen Werkzeuge oder komplizierten Prozesse erforderlich.
Die gesamte Branche sollte über den menschlichen Faktor während des Dienstes nachdenken, ohne die erstklassige Kundenbetreuung zu beeinträchtigen. All diese Tools und Praktiken können und sollten verbessert werden. Ich hoffe, die CASE-Methode hilft dabei.
Genießen Sie verbesserte Benachrichtigungen!
Quelle: habr.com
