

Das Thema der Ausfallsicherheit in Datenspeichersystemen ist immer von Bedeutung, da in unserem Zeitalter der universellen Virtualisierung und Ressourcenkonsolidierung ein Ausfall der Speicherlösungen nicht nur zu einem gewöhnlichen Vorfall führt, sondern zu längeren Ausfallzeiten der Dienste. Daher verfügen moderne Speicherlösungen über viele redundant ausgelegte Komponenten (bis hin zu Controllern). Aber ist dieser Schutz ausreichend?
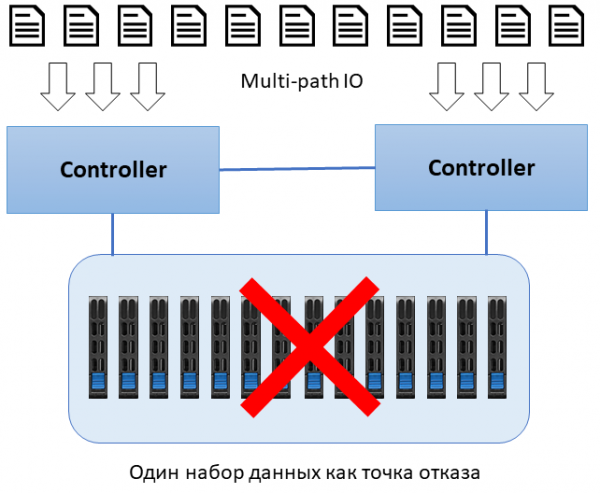
Allerdings erwähnen sämtliche Anbieter, wenn sie die Merkmale ihrer Speicherlösungen auflisten, unweigerlich die hohe Ausfallsicherheit ihrer Lösungen und fügen unbedingt den Begriff „ohne einzelne Ausfallstelle“ hinzu. Werfen wir einen genaueren Blick auf ein typisches Datenspeichersystem. Um Ausfallzeiten beim Service zu vermeiden, werden in Speicherlösungen Netzteile, Kühlmodule, Ein-/Ausgangsporten, Speicher (wir meinen RAID) und selbstverständlich auch Controller redundantly ausgelegt. Wenn man sich diese Architektur näher ansieht, kann man mindestens zwei potenzielle Ausfallstellen bemerken, über die bescheiden geschwiegen wird:
- Das Vorhandensein eines einzigen Backplanes
- Das Vorhandensein einer einzigen Datenkopie
Ein Backplane ist ein technisch anspruchsvolles Gerät, das bei der Herstellung unbedingt strengen Tests unterzogen wird. Daher gibt es äußerst selten Fälle, in denen es vollständig ausfällt. Selbst bei partiellen Problemen, wie einem defekten Speichersteckplatz, ist ein Austausch mit vollständiger Abschaltung der Speicherung erforderlich.
Das Erstellen mehrerer Datenkopien scheint auf den ersten Blick ebenfalls kein Problem zu sein. So ist beispielsweise die Funktion „Klon“ in Speicherlösungen, die es ermöglicht, in bestimmten Intervallen eine vollständige Datensicherung anzufertigen, recht verbreitet. Bei Problemen mit demselben Backplane ist jedoch die Kopie ebenso unerreichbar wie das Original.
Eine durchaus offensichtliche Lösung zur Überwindung der genannten Nachteile besteht darin, die Daten auf ein anderes Speichersystem zu replizieren. Wenn man die voraussichtliche Verdopplung der Kosten für die Hardware außer Acht lässt (wir gehen schließlich davon aus, dass diejenigen, die eine solche Entscheidung treffen, realistisch denken und diesen Fakt im Voraus akzeptieren), bleiben auch mögliche Kosten für die Organisation der Replikation in Form von Lizenzen sowie zusätzlicher Software und Hardware. Und vor allem – es muss irgendwie sichergestellt werden, dass die replizierten Daten konsistent bleiben. Das heißt, man muss einen Virtualisierer für das Speichersystem / vSAN / etc. einrichten, was ebenfalls Geld und Zeit erfordert.
Bei der Erstellung ihrer eigenen Hochverfügbarkeits-Systeme wurde das Ziel gesetzt, die oben genannten Nachteile zu beseitigen. So entstand die Auslegung der Technologie Shared Nothing, was in freier Übersetzung „ohne gemeinsame Geräte“ bedeutet.
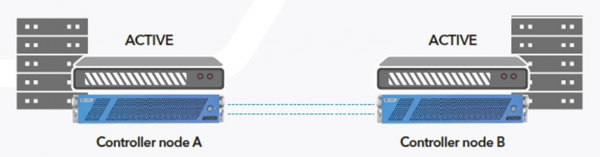
Konzept Die Architektur besteht aus der Verwendung von zwei unabhängigen Knoten (Kontrollern), von denen jeder über seinen eigenen Datensatz verfügt. Zwischen den Knoten erfolgt eine synchronisierte Replikation über das InfiniBand 56G, die für die Software, die auf dem Speichersystem arbeitet, völlig transparent ist. Dadurch ist die Verwendung von Virtualisierern, Software-Agenten usw. nicht erforderlich.
Physisch kann die Zweiknotenlösung von AccelStor in zwei Modellen realisiert werden:
- – auf Basis von Twin-Servern im 2U-Gehäuse, wenn moderate Leistung und eine Kapazität von bis zu 22TB benötigt werden;
- – auf Basis separater 2U-Server, wenn hohe Leistung und große Kapazität (bis zu 57TB) erforderlich sind.
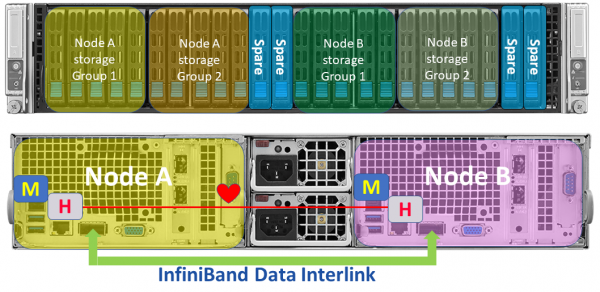
Das Modell H510 auf Basis des Twin-Servers
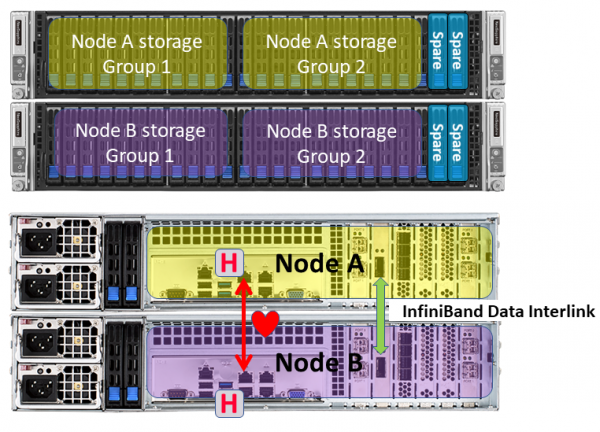
Das Modell H710 auf Basis separater Server
Die Verwendung unterschiedlicher Formfaktoren resultiert aus der Notwendigkeit, eine unterschiedliche Anzahl von SSDs zu verwenden, um das vorgegebene Volumen und die Leistung zu erreichen. Zudem ist die Twin-Plattform kostengünstiger und ermöglicht es, erschwinglichere Lösungen anzubieten, auch wenn sie einen gewissen „Nachteil“ in Form eines gemeinsamen Backplanes mit sich bringt. Alles andere, einschließlich der Funktionsweise, ist bei beiden Modellen vollständig identisch.
Der Datensatz jeder Knoten hat zwei Gruppen , plus 2 Hot-Spare. Jede Gruppe kann den Ausfall eines SSD verkraften. Alle eingehenden Schreibanfragen werden von der Knoten gemäß der FlexiRemap rekonfiguriert in aufeinanderfolgende Ketten mit 4KB-Blöcken, die dann im für sie optimalen Modus (sequential writing) auf SSDs geschrieben werden. Das Hostsystem erhält die Bestätigung des Schreibens erst nach der physischen Platzierung der Daten auf der SSD, d.h. ohne Caching im RAM. Infolgedessen wird eine beeindruckende Leistung von bis zu 600K IOPS beim Schreiben und über 1M IOPS beim Lesen (Modell H710) erreicht.
Wie bereits erwähnt, erfolgt die Synchronisierung von Datensätzen in Echtzeit über die InfiniBand 56G-Schnittstelle, die über eine hohe Bandbreite und niedrige Latenzen verfügt. Um den Kommunikationskanal bei der Übertragung kleiner Pakete maximal effizient zu nutzen. Da der Kommunikationskanal einzeln ist, wird für die zusätzliche Überprüfung des Pulses eine dedizierte 1GbE-Verbindung verwendet. Über diese wird nur der Heartbeat übertragen, daher gibt es keine Anforderungen an die Geschwindigkeit.
Im Falle einer Kapazitätserweiterung des Systems (bis zu 400+ TB) durch werden sie ebenfalls paarweise angeschlossen, um das Konzept der „keine Einzelpunkt-Fehlertoleranz“ einzuhalten.
Für zusätzlichen Datenschutz (neben den bereits vorhandenen zwei Kopien von AccelStor) wird ein spezieller Algorithmus für den Fall eines Ausfalls einer SSD verwendet. Wenn eine SSD ausfällt, beginnt der Knoten, die Daten auf eines der Hot-Spare-Laufwerke wiederherzustellen. Die FlexiRemap-Gruppe, die sich im Zustand Degraded befindet, wechselt in den Nur-Lese-Modus. Dies geschieht, um Störungen bei Schreibvorgängen und der Wiederherstellung auf das Ersatzlaufwerk auszuschließen, was letztendlich den Wiederherstellungsprozess beschleunigt und die Zeit, in der das System potenziell anfällig ist, verkürzt. Nach Abschluss des Rebuilds wechselt der Knoten wieder in den normalen Lese-Schreib-Modus.
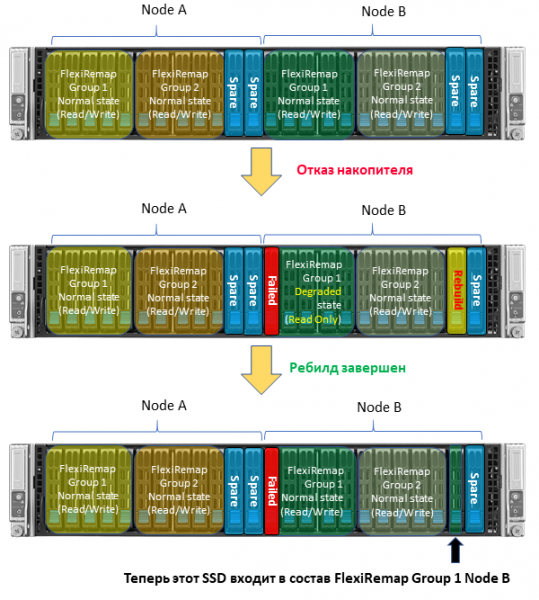
Natürlich, wie bei anderen Systemen, sinkt die Gesamtleistung während des Rebuilds (da eine der FlexiRemap-Gruppen nicht für Schreibvorgänge aktiv ist). Aber der Wiederherstellungsprozess selbst erfolgt äußerst schnell, was die Systeme von AccelStor vorteilhaft von den Lösungen anderer Anbieter abhebt.
Ein weiteres nützliches Merkmal der Nothing Shared-Technologie ist der Betrieb der Knoten im sogenannten true active-active Modus. Im Gegensatz zur „klassischen“ Architektur, in der ein bestimmtes Volume/Pools nur von einem Controller verwaltet wird, während der zweite lediglich Ein- und Ausgabeoperationen ausführt, ist dies in den Systemen Jeder Knoten arbeitet mit seinem eigenen Datensatz und überträgt keine Anfragen an den "Nachbarn". Dadurch wird die Gesamtleistung des Systems durch die parallele Verarbeitung von Eingabe-/Ausgabeanfragen durch die Knoten und den Zugriff auf Speicher erhöht. Außerdem gibt es praktisch kein Konzept wie Failover, da es einfach nicht notwendig ist, die Kontrolle über Volumes an einen anderen Knoten im Falle eines Ausfalls zu übertragen.
Wenn man die Nothing Shared-Technologie der Architektur mit einer vollständigen Duplizierung von Speicherlösungen vergleicht, wird sie auf den ersten Blick in Bezug auf Flexibilität etwas hinter einer vollständigen Umsetzung von Disaster Recovery zurückbleiben. Dies gilt insbesondere für die Organisation der Kommunikationslinie zwischen den Speichersystemen. So ist es im H710-Modell möglich, die Knoten über Entfernungen von bis zu 100 m mithilfe nicht ganz billiger aktiver optischer InfiniBand-Kabel zu verteilen. Doch selbst im Vergleich zu einer herkömmlichen Umsetzung der synchronen Replikation bei anderen Anbietern über den verfügbaren FibreChannel, selbst über größere Entfernungen, erweist sich die Lösung von AccelStor als kostengünstiger und einfacher in der Installation/Betrieb, da es nicht notwendig ist, Virtualisierer für Speicherlösungen zu installieren und/oder eine Integration mit Software durchzuführen (was nicht immer grundsätzlich möglich ist). Zudem sollte nicht vergessen werden, dass die Lösungen von AccelStor All-Flash-Arrays mit einer Leistung bieten, die höher ist als die von „klassischen“ Speichersystemen mit nur SSDs.
Mit der Nothing Shared-Technologie von AccelStor ist es tatsächlich möglich, eine Verfügbarkeit des Speichersystems auf dem Niveau von 99,9999 % zu einem durchaus angemessenen Preis zu erreichen. Zusammen mit der hohen Zuverlässigkeit der Lösung, auch durch die Verwendung von zwei Kopien der Daten, und der beeindruckenden Leistung aufgrund proprietärer Algorithmen , Lösungen von sind hervorragende Kandidaten für Schlüsselpositionen beim Aufbau eines modernen Rechenzentrums.
Quelle: habr.com
