

Hallo, Habra!
Wir erinnern daran, dass wir nach dem Buch über ein ebenso interessantes Werk über die Bibliothek .
Das Community erkundet erst die Grenzen der Möglichkeiten dieses leistungsstarken Instruments. Kürzlich erschien ein Artikel, mit dessen Übersetzung wir Sie bekannt machen möchten. Der Autor berichtet aus eigener Erfahrung, wie man mit Kafka Streams ein verteiltes Datenspeicher erstellt. Viel Spaß beim Lesen!
Die Apache-Bibliothek wird weltweit in Unternehmen für die verteilte Stream-Verarbeitung über Apache Kafka eingesetzt. Ein oft unterschätzter Aspekt dieses Frameworks ist, dass es ermöglicht, einen lokalen Zustand zu speichern, der auf der Stream-Verarbeitung basiert.
In diesem Artikel erkläre ich, wie es uns in unserem Unternehmen gelungen ist, diese Funktion gewinnbringend bei der Entwicklung eines Produkts zur Sicherheit von Cloud-Anwendungen zu nutzen. Mit Kafka Streams haben wir Mikrodienste mit gemeinsamem Zustand erstellt, die uns als ausfallsichere und hochverfügbare Informationsquelle über den Zustand der Objekte im System dienen. Dies ist ein Fortschritt in Bezug auf Zuverlässigkeit und Wartungsfreundlichkeit.
Wenn Sie an einem alternativen Ansatz interessiert sind, der es ermöglicht, eine zentrale Datenbank zur Unterstützung des formalen Zustands Ihrer Objekte zu verwenden – lesen Sie weiter, das wird interessant...
Warum wir der Meinung sind, dass es an der Zeit war, unsere Ansätze zum Umgang mit gemeinsamem Zustand zu ändern
Wir mussten den Zustand verschiedener Objekte im Hinblick auf Agentenberichte aufrechterhalten (z.B.: Wurde die Website angegriffen?). Vor dem Wechsel zu Kafka Streams waren wir oft auf eine zentrale Datenbank (+ Service API) zur Verwaltung des Zustands angewiesen. Dieser Ansatz hat seine Nachteile: In wird die Aufrechterhaltung von Konsistenz und Synchronisation zur echten Herausforderung. Die Datenbank kann zum Engpass werden oder sich in befinden und unter Unvorhersehbarkeiten leiden.
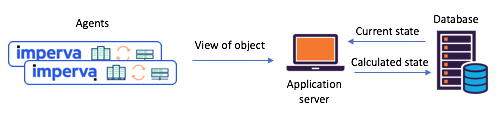
Abbildung 1: Ein typisches Szenario mit Zustandsteilung, das vor dem Wechsel zu
Kafka und Kafka Streams vorkam: Agenten berichten ihre Ansichten über die API, der aktualisierte Zustand wird über eine zentrale Datenbank berechnet.
Lernen Sie Kafka Streams kennen – es ist jetzt einfach, Mikrodienste mit gemeinsamem Zustand zu erstellen.
Vor etwa einem Jahr haben wir beschlossen, unsere Arbeitsabläufe mit gemeinsamem Zustand gründlich zu überarbeiten, um einige Probleme zu lösen. Sofort haben wir Kafka Streams ausprobiert – bekannt dafür, wie skalierbar, hochverfügbar und fehlertolerant sie ist, und welchen reichen Streaming-Funktionsumfang sie bietet (unter anderem auch Berechnungen mit Zustandsbewahrung). Genau das, was wir benötigten, ganz zu schweigen von der Reife und Zuverlässigkeit des Nachrichtenaustauschs, die sich in Kafka entwickelt hat.
Jeder unserer entwickelten Microservices zur Zustandsbewahrung basierte auf einer Instanz von Kafka Streams mit einer recht einfachen Topologie. Diese bestand aus 1) einer Quelle 2) einem Prozessor mit persistentem Key-Value-Speicher 3) einem Strom:
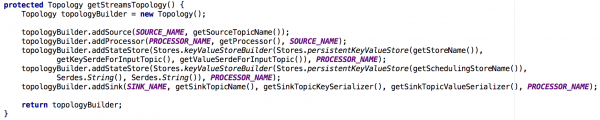
Abbildung 2: Die standardmäßige Topologie unserer Stream-Instanzen für die Microservices mit Zustandsbewahrung. Beachten Sie, dass es hier auch einen Speicher gibt, der Metadaten zur Planung enthält.
Mit diesem neuen Ansatz erstellen Agenten Nachrichten, die in das ursprüngliche Thema eingespeist werden, während Verbraucher – sagen wir, der Dienst für E-Mail-Benachrichtigungen – den berechneten gemeinsamen Zustand über den Strom (Ausgangsthema) empfangen.
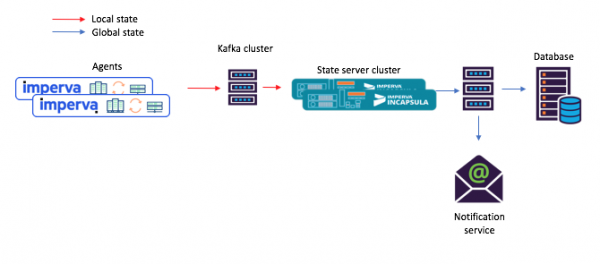
Abbildung 3: Ein neues Beispiel für einen Aufgabestrom für das Szenario mit gemeinsamen Microservices: 1) der Agent erzeugt eine Nachricht, die in das ursprüngliche Kafka-Thema gelangt; 2) der Microservice mit gemeinsamem Zustand (der Kafka Streams verwendet) verarbeitet sie und schreibt den berechneten Zustand in das Endthema von Kafka; anschließend 3) empfangen die Verbraucher den neuen Zustand.
Hey, und dieser eingebaute Key-Value-Speicher ist wirklich sehr nützlich!
Wie oben erwähnt, enthält unsere Topologie mit gemeinsamem Zustand einen Key-Value-Speicher. Wir haben mehrere Verwendungsmöglichkeiten gefunden, und zwei davon sind unten beschrieben.
Option #1: Verwendung des Key-Value-Speichers bei Berechnungen
Unser erstes Schlüssel-Wert-Speicher enthielt Hilfsdaten, die wir für unsere Berechnungen benötigten. Beispielsweise wurde in einigen Fällen der geteilte Zustand nach dem Prinzip der "Mehrheit der Stimmen" bestimmt. Im Speicher konnten wir alle letzten Berichte der Agenten über den Zustand eines bestimmten Objekts aufbewahren. Anschließend konnten wir, nachdem wir einen neuen Bericht von einem der Agenten erhalten hatten, diesen speichern, die Berichte aller anderen Agenten über den Zustand desselben Objekts aus dem Speicher abrufen und die Berechnung wiederholen.
In der Abbildung 4 unten wird gezeigt, wie wir den Zugriff auf den Schlüssel-Wert-Speicher für die verarbeitende Methode des Prozessors geöffnet haben, sodass anschließend eine neue Nachricht verarbeitet werden konnte.
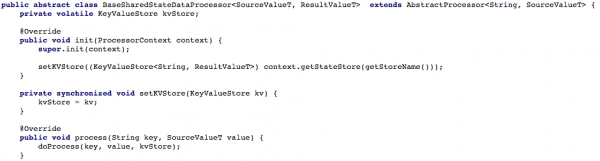
Abbildung 4: Zugriff auf den Schlüssel-Wert-Speicher für die verarbeitende Methode des Prozessors öffnen (nachdem in jedem Szenario, das mit dem geteilten Zustand arbeitet, die Methode implementiert werden musste. doProcess)
Variante #2: Erstellen einer CRUD-API über Kafka Streams
Nachdem wir unseren grundlegenden Aufgabenstrom eingerichtet hatten, fingen wir an, eine RESTful CRUD-API für unsere Mikrodienste mit geteiltem Zustand zu schreiben. Wir wollten es ermöglichen, den Zustand einiger oder aller Objekte abzurufen sowie den Zustand eines Objekts festzulegen oder zu löschen (dies ist nützlich für die Unterstützung der Backend-Seite).
Um alle API Get State zu unterstützen, haben wir jedes Mal, wenn wir den Zustand bei der Verarbeitung neu berechnen mussten, diesen langfristig im integrierten Schlüssel-Wert-Speicher abgelegt. In diesem Fall ist es ausreichend, eine solche API mit einer einzelnen Instanz von Kafka Streams zu implementieren, wie im folgenden Listing gezeigt:
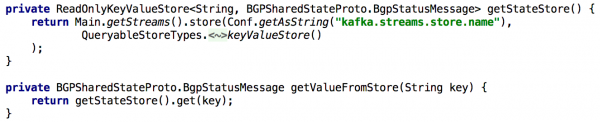
Abbildung 5: Verwendung des integrierten Schlüssel-Wert-Speichers zur Abfrage des vorcomputierten Zustands eines Objekts
Die Aktualisierung des Zustands eines Objekts über die API ist ebenfalls nicht schwer zu realisieren. Prinzipiell muss man dafür nur einen Kafka-Producer erstellen und damit einen Eintrag vornehmen, der den neuen Zustand enthält. So wird sichergestellt, dass alle über die API generierten Nachrichten genau so verarbeitet werden, wie die von anderen Produzenten (z. B. Agenten) eintreffenden Nachrichten.
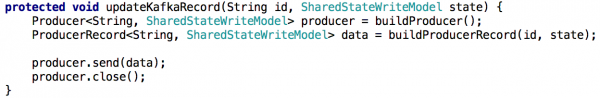
Abbildung 6: Den Zustand eines Objekts kann man mit einem Kafka-Producer festlegen
Eine kleine Komplikation: Kafka hat viele Partitionen
Anschließend wollten wir die mit der Verarbeitung verbundene Last verteilen und die Verfügbarkeit verbessern, indem wir für jedes Szenario einen Cluster von Mikrodiensten mit gemeinsamem Zustand bereitstellen. Die Einrichtung fiel uns leicht: nachdem wir alle Instanzen konfiguriert hatten, damit sie mit derselben Anwendungs-ID (und denselben Bootservern) arbeiten, geschah praktisch alles andere automatisch. Wir haben auch festgelegt, dass jedes Ausgangsthema aus mehreren Partitionen bestehen sollte, sodass jeder Instanz ein Teilmenge dieser Partitionen zugewiesen werden konnte.
Ich möchte auch erwähnen, dass es hier üblich ist, ein Backup des Zustandspeichers zu erstellen, um beispielsweise im Falle einer Wiederherstellung nach einem Ausfall dieses Backup auf eine andere Instanz zu übertragen. Für jeden Zustandsspeicher in Kafka Streams wird ein replizierbares Thema mit einem Änderungsprotokoll erstellt (in dem lokale Aktualisierungen verfolgt werden). Auf diese Weise schützt Kafka ständig den Zustandsspeicher. Daher kann der Zustandsspeicher von Kafka Streams im Falle eines Ausfalls einer bestimmten Instanz schnell auf einer anderen Instanz wiederhergestellt werden, wo die entsprechenden Partitionen hinübergehen. Unsere Tests haben gezeigt, dass dies in wenigen Sekunden geschieht, selbst wenn Millionen von Datensätzen im Speicher sind.
Der Übergang von einem Mikrodienst mit gemeinsamem Zustand zu einem Cluster von Mikrodiensten gestaltet sich nicht so trivial, wenn es darum geht, die Get State API zu implementieren. In der neuen Situation enthält der Zustandsspeicher jedes Mikrodienstes nur einen Teil des Gesamtbildes (die Objekte, deren Schlüssel auf eine bestimmte Partition abgebildet sind). Wir mussten bestimmen, auf welcher Instanz sich der Zustand des benötigten Objekts befand, und dies geschah anhand der Metadatenströme, wie unten gezeigt:
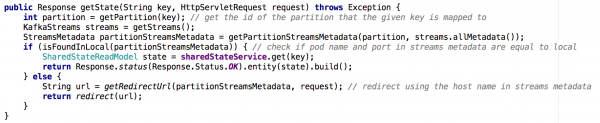
Abbildung 7: Mithilfe von Metadatenströmen bestimmen wir, von welcher Instanz wir den Zustand des benötigten Objekts anfordern; ein solcher Ansatz wurde mit der GET ALL API angewendet.
Wichtigste Ergebnisse
Zustandsspeicher in Kafka Streams können de facto als verteilte Datenbank dienen,
- die ständig in Kafka repliziert wird.
- Auf solch einem System lässt sich leicht eine CRUD API aufbauen.
- Die Verarbeitung mehrerer Partitionen gestaltet sich etwas komplexer.
- Es ist auch möglich, einen oder mehrere Statusspeicher in die Streaming-Topologie hinzuzufügen, um Hilfsdaten zu speichern. Diese Option kann verwendet werden für:
- Langfristige Speicherung von Daten, die für Berechnungen bei der Stream-Verarbeitung erforderlich sind
- Langfristige Speicherung von Daten, die bei der nächsten Initialisierung der Streaming-Instanz nützlich sein könnten
- vieles mehr…
Dank dieser und anderer Vorteile eignet sich Kafka Streams hervorragend zur Unterstützung des globalen Status in einem verteilten System wie dem unseren. Kafka Streams hat sich in der Produktion als äußerst zuverlässig erwiesen (seit ihrer Bereitstellung haben wir praktisch keine Nachrichten verloren), und wir sind zuversichtlich, dass dies nicht die einzigen Möglichkeiten sind!
Quelle: habr.com
