

Logs sind ein wichtiger Bestandteil des Systems, der es ermöglicht zu verstehen, ob es wie erwartet funktioniert (oder nicht). In einer Mikroservice-Architektur wird die Arbeit mit Logs zu einer eigenen Disziplin innerhalb einer speziellen Olympiade. Man muss gleich eine ganze Reihe von Fragen klären:
- wie man Logs aus der Anwendung schreibt;
- wo man Logs schreibt;
- wie man Logs für Speicherung und Verarbeitung überträgt;
- wie man Logs verarbeitet und speichert.
Die Anwendung beliebter Containerisierungstechnologien fügt zusätzlichen Sand auf das Feld der Lösungsvarianten hinzu.
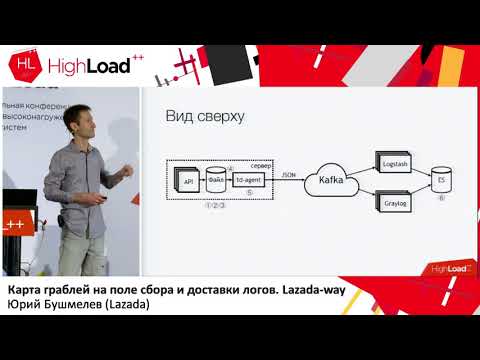
Darum geht es in dem Vortrag von Yuri Bushmelev mit dem Titel „Karte der Stolpen auf dem Feld der Log-Sammlung und -Übertragung“
Für Interessierte bitte weiterlesen.
Mein Name ist Yuri Bushmelev. Ich arbeite bei Lazada. Heute werde ich darüber sprechen, wie wir unsere Logs gemacht haben, wie wir sie gesammelt haben und was wir dort schreiben.
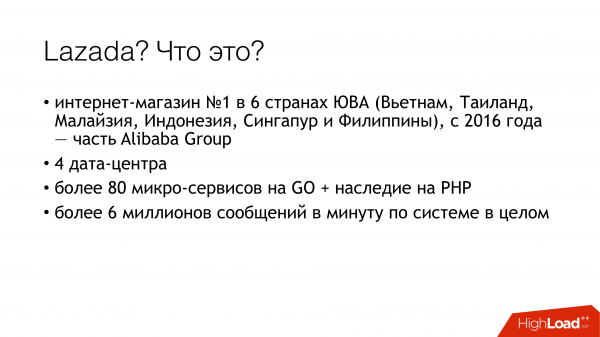
Woher kommen wir? Wer sind wir? Lazada ist der größte Online-Shop in sechs Ländern Südostasiens. Alle diese Länder sind auf unsere Rechenzentren verteilt. Derzeit haben wir insgesamt 4 Rechenzentren. Warum ist das wichtig? Weil einige Entscheidungen dadurch bedingt waren, dass zwischen den Zentren eine sehr schwache Verbindung besteht. Wir haben eine Mikroservice-Architektur. Ich war überrascht, dass wir bereits 80 Mikroservices haben. Als ich die Aufgabe mit den Logs begonnen habe, waren es nur 20. Außerdem haben wir einen ziemlich großen Teil von PHP-legacy, mit dem wir ebenfalls leben und uns arrangieren müssen. Dies generiert derzeit über 6 Millionen Nachrichten pro Minute im gesamten System. Im Folgenden werde ich zeigen, wie wir damit leben und warum das so ist.
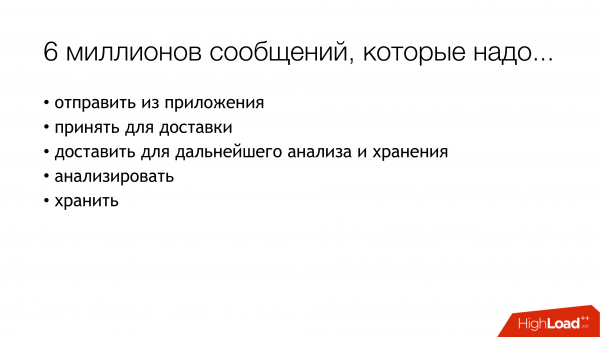
Mit diesen 6 Millionen Nachrichten müssen wir irgendwie umgehen. Was sollen wir mit ihnen tun? 6 Millionen Nachrichten, die wir müssen:
- aus der Anwendung senden
- für die Übertragung annehmen
- zur Analyse und Speicherung liefern.
- die
- irgendwie speichern.
Als drei Millionen Nachrichten erschienen, sah ich ungefähr so aus. Denn wir fingen mit ein paar Cent an. Es ist klar, dass dort Anwendungsprotokolle geschrieben werden. Zum Beispiel konnte ich mich nicht mit der Datenbank verbinden, konnte mich mit der Datenbank verbinden, aber konnte nicht alles lesen. Aber darüber hinaus schreibt jeder unserer Mikrodienste auch ein Zugriffsprotokoll. Jede Anfrage, die an den Mikrodienst gesendet wird, landet im Protokoll. Warum machen wir das? Die Entwickler möchten die Möglichkeit zum Tracing haben. In jedem Zugriffsprotokoll gibt es ein Feld traceid, anhand dessen eine spezielle Schnittstelle die gesamte Kette aufrollt und das Tracing schön darstellt. Das Tracing zeigt, wie die Anfrage durchlief, und hilft unseren Entwicklern, schneller mit unbekannten Problemen umzugehen.
Wie lebt man damit? Jetzt werde ich kurz die Möglichkeiten skizzieren – wie dieses Problem überhaupt gelöst wird. Wie löst man die Aufgabe der Sammlung, Übertragung und Speicherung von Protokollen?
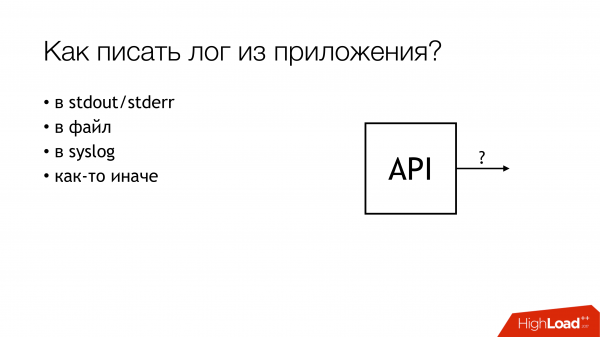
Wie schreibt man aus der Anwendung? Es ist klar, dass es verschiedene Möglichkeiten gibt. Insbesondere gibt es Best Practices, wie uns angesagte Leute erzählen. Es gibt Old School in zwei Varianten, wie es uns die Alten erzählt haben. Es gibt auch andere Wege.
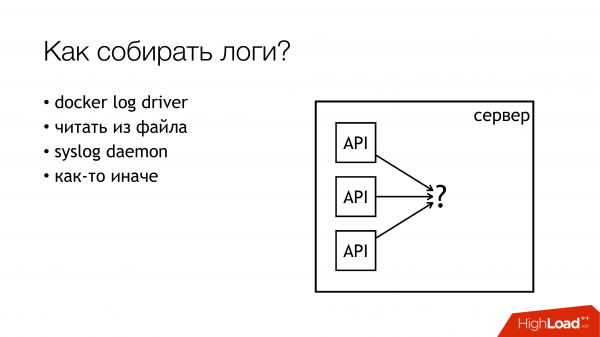
Die Situation mit der Protokollsammlung ist ungefähr die gleiche. Die Lösungsoptionen für diesen speziellen Teil sind nicht so zahlreich. Es gibt zwar mehr, aber es sind noch nicht so viele.
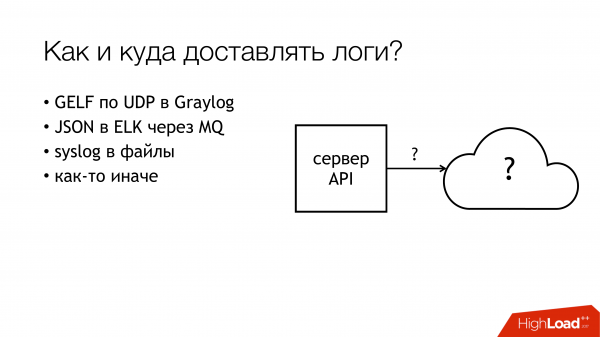
Aber bei der Lieferung und anschließenden Analyse – die Anzahl der Variationen beginnt zu explodieren. Ich werde jetzt nicht jede Option beschreiben. Ich denke, die Hauptvarianten sind vielen bekannt, die sich mit dem Thema beschäftigt haben.
Ich werde zeigen, wie wir es bei Lazada gemacht haben und wie das Ganze begonnen hat.
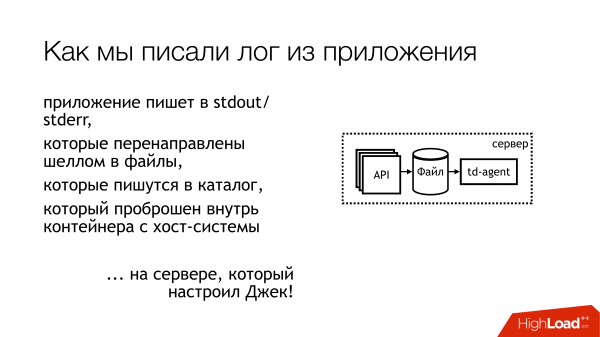
Vor einem Jahr kam ich zu Lazada und wurde zu einem Projekt über Protokolle geschickt. Es war ungefähr so. Das Protokoll aus der Anwendung wurde in stdout und stderr geschrieben. Alle haben es nach dem neuesten Stand gemacht. Aber dann haben die Entwickler es aus den Standardströmen entfernt, und dann sollten die Infrastruktur-Spezialisten es irgendwie regeln. Zwischen den Infrastruktur-Spezialisten und den Entwicklern gibt es noch die Release-Manager, die sagten: „Ähm… gut, lassen Sie uns das einfach mit Shell in eine Datei packen und fertig“. Und da alles in einem Container ist, wurde es direkt im Container verpackt, das Verzeichnis hinein gemappt und dort abgelegt. Ich denke, es ist für alle ziemlich klar, was daraus geworden ist.
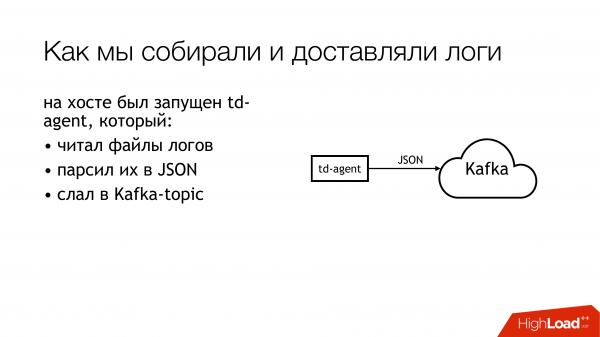
Schauen wir uns das Ganze etwas weiter an. Wie wir diese Protokolle geliefert haben. Irgendjemand hat td-agent gewählt, das eigentlich fluentd ist, aber nicht ganz fluentd. Ich habe die Beziehung dieser beiden Projekte nicht ganz verstanden, aber sie scheinen doch dasselbe zu sein. Und dieser fluentd, geschrieben in Ruby, las Logdateien, analysierte sie nach irgendwelchen regulären Ausdrücken in JSON. Dann sendete er sie an Kafka. Zudem hatten wir für jede API 4 separate Topics in Kafka. Warum 4? Weil es live gibt, es gibt staging, und weil es stdout und stderr gibt. Die Entwickler erzeugen sie, und die Infrastrukturleute müssen sie in Kafka erstellen. Zudem wurde Kafka von einer anderen Abteilung verwaltet. Daher musste ein Ticket erstellt werden, damit sie dort 4 Topics für jede API anlegten. Alle haben das darüber vergessen. Es war insgesamt Chaos und Durcheinander.
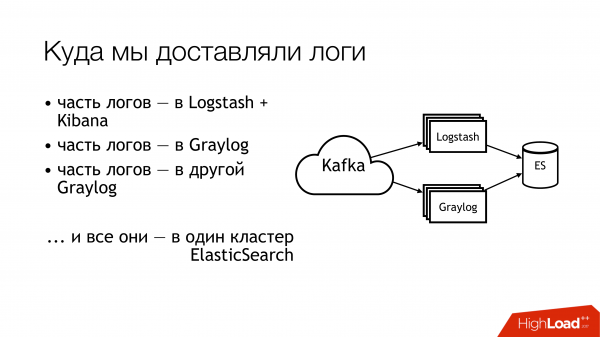
Was haben wir dann damit gemacht? Wir haben es in Kafka geschickt. Dann ging die Hälfte der Protokolle zu Logstash. Die andere Hälfte der Protokolle wurde aufgeteilt. Ein Teil ging zu einem Graylog, ein Teil zu einem anderen Graylog. Am Ende landete das Ganze in einem einzigen Elasticsearch-Cluster. Das heißt, dieses ganze Durcheinander fiel letztendlich dort hinein. So sollte man das nicht machen!
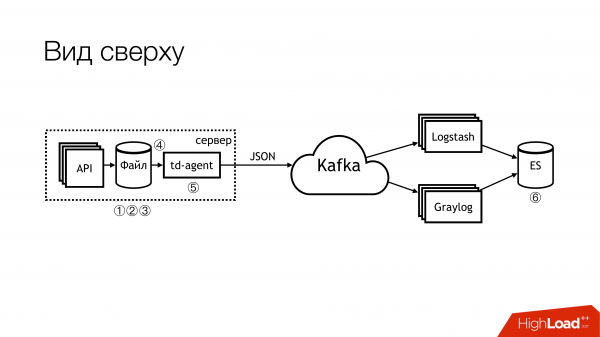
So sieht das aus, wenn man es von oben betrachtet. So sollte man das nicht machen! Hier sind gleich die problematischen Stellen mit Zahlen markiert. Es gibt tatsächlich mehr, aber 6 sind die wirklich problematischen, mit denen man etwas machen muss. Darüber werde ich jetzt gesondert sprechen.
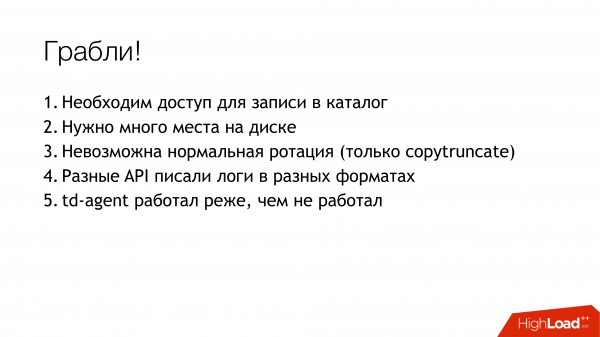
Hier (1,2,3) schreiben wir Dateien und daher gibt es direkt hier drei Stolpersteine.
Erstens (1) – wir müssen sie irgendwo schreiben. Man möchte nicht immer der API die Möglichkeit geben, direkt in eine Datei zu schreiben. Es wäre wünschenswert, dass die API in einem Container isoliert ist, noch besser wäre es, wenn sie read-only wäre. Ich bin Sysadmin, daher habe ich eine etwas alternative Sicht auf diese Dinge.
Der zweite Punkt (2,3) ist, dass wir viele Anfragen an die API erhalten. Die API schreibt viele Daten in eine Datei. Die Dateien wachsen. Wir müssen sie rotieren. Denn sonst hast du keine Festplatten, die das alles ausgleichen können. Ihre Rotation ist problematisch, weil sie durch ein Shell-Redirect in ein Verzeichnis erfolgen. Wir können sie nicht rotieren. Man kann der Anwendung nicht sagen, sie solle die Deskriptoren neu öffnen. Denn die Entwickler schauen dich an wie einen Idioten: "Welche Deskriptoren? Wir schreiben im stdout!" Die Infrastruktur-Teams haben copytruncate in logrotate implementiert, das einfach eine Kopie der Datei erstellt und das Original truncatet. Entsprechend ist der Speicherplatz auf der Festplatte normalerweise zwischen diesen Kopiervorgängen erschöpft.
(4) Wir hatten verschiedene Formate in unterschiedlichen APIs. Sie unterschieden sich ein wenig, aber es mussten verschiedene Regexp geschrieben werden. Da alles mit Puppet verwaltet wurde, gab es dort ein großes Bündel von Klassen mit ihren eigenen Eigenheiten. Zusätzlich konnte td-agent die meiste Zeit viel Speicher verbrauchen, träge werden und einfach so tun, als würde er arbeiten, während er in Wirklichkeit nichts tat. Von außen war es unmöglich zu erkennen, dass er nichts machte. Im besten Fall stürzte er ab, und jemand würde ihn später wieder hochfahren. Genauer gesagt, es kam ein Alert, und jemand musste manuell intervenieren.
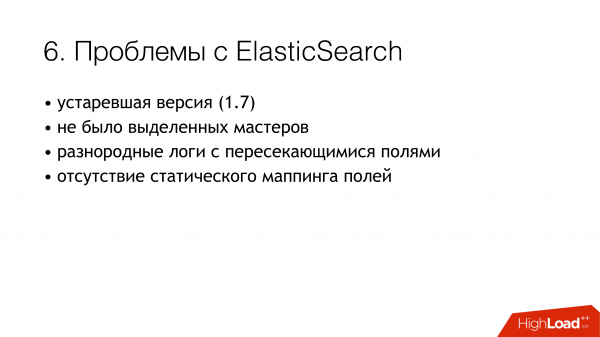
(6) Der größte Schrecken war Elasticsearch. Denn das war eine alte Version. Zu dem Zeitpunkt hatten wir keine dedizierten Master. Wir hatten heterogene Logs, bei denen die Felder überlappen konnten. Verschiedene Logs verschiedener Anwendungen konnten mit denselben Feldnamen erstellt werden, aber die Daten darin konnten unterschiedlich sein. Das heißt, ein Log kommt mit einem Integer im Feld, zum Beispiel level. Ein anderes Log kommt mit einem String im Feld level. In Ermangelung einer statischen Zuordnung entsteht eine ganz besondere Situation. Wenn nach der Rotation des Index in Elasticsearch zuerst eine Nachricht mit einem String eintrifft, läuft alles gut. Wenn jedoch zuerst eine mit einem Integer eintrifft, werden alle nachfolgenden Nachrichten, die mit einem String eintreffen, einfach verworfen. Denn der Feldtyp stimmt nicht überein.
Wir begannen, uns diese Fragen zu stellen. Wir entschieden uns, keine Schuldigen zu suchen.
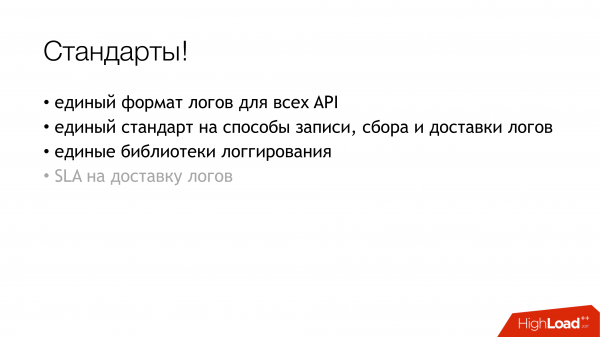
Aber wir müssen etwas tun! Offensichtlich müssen Standards festgelegt werden. Einige Standards hatten wir bereits. Einige haben wir etwas später eingeführt. Glücklicherweise wurde zu diesem Zeitpunkt ein einheitliches Format für Protokolle für alle APIs genehmigt. Es ist direkt in den Standards für die Interaktion der Dienste festgelegt. Dementsprechend müssen diejenigen, die Protokolle empfangen möchten, diese in diesem Format schreiben. Wenn jemand Protokolle nicht in diesem Format schreibt, können wir nichts garantieren.
Darüber hinaus möchte ich einen einheitlichen Standard für die Art und Weise der Aufzeichnung, Lieferung und Sammlung von Protokollen etablieren. Wo genau sie geschrieben werden sollen und wie sie geliefert werden. Die ideale Situation wäre, wenn in den Projekten dieselbe Bibliothek verwendet wird. Es gibt eine separate Protokollierungsbibliothek für Go, eine andere für PHP. Alle, die wir haben, sollten diese verwenden. Momentan würde ich sagen, dass wir das zu etwa 80 % erreichen. Aber einige wagen sich weiterhin auf das dünne Eis.
Und da (auf der Folie) beginnt gerade erst der 'SLA für die Lieferung von Protokollen' durchzuschimmern. Es gibt ihn noch nicht, aber wir arbeiten daran. Denn es ist sehr praktisch, wenn die Infrastruktur sagt, dass wenn Sie in einem bestimmten Format an einem bestimmten Ort schreiben und nicht mehr als N Nachrichten pro Sekunde, wir sie mit einer bestimmten Wahrscheinlichkeit dorthin liefern. Das nimmt viel Kopfschmerzen ab. Wenn es einen SLA gibt, ist das einfach großartig!
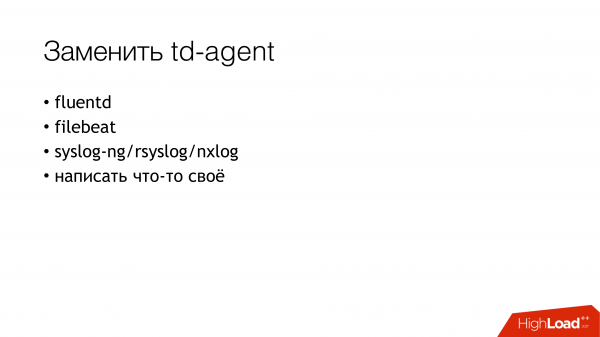
Wie haben wir das Problem zu lösen begonnen? Das Hauptproblem war der td-agent. Es war unklar, wo unsere Protokolle hingehen. Werden sie geliefert? Werden sie gesammelt? Wo sind sie überhaupt? Daher wurde als erster Punkt beschlossen, den td-agent zu ersetzen. Die Varianten, womit man ihn ersetzen könnte, habe ich hier kurz skizziert.
Fluentd. Erstens habe ich bei meiner vorherigen Arbeit damit gearbeitet, und es ist dort auch gelegentlich abgestürzt. Zweitens ist es dasselbe, nur spezifischer.
Filebeat. Worin war es für uns praktisch? Weil es in Go geschrieben ist und wir große Expertise in Go haben. Dementsprechend könnten wir, falls nötig, es anpassen. Aus diesem Grund haben wir es nicht gewählt. Um keinen Anreiz zu haben, es für uns umzuschreiben.
Eine offensichtliche Lösung für den Systemadministrator bleibt eine Vielzahl von Systemprotokollen in dieser Menge (syslog-ng/rsyslog/nxlog).
Oder etwas Eigenes schreiben, aber das haben wir verworfen, ebenso wie filebeat. Wenn man etwas schreiben muss, dann besser etwas, das nützlich für das Geschäft ist. Für die Lieferung von Protokollen ist es besser, etwas Fertiges zu nehmen.
Daher beschränkte sich die Wahl im Wesentlichen auf die Entscheidung zwischen syslog-ng und rsyslog. Ich habe mich für rsyslog entschieden, einfach weil wir in Puppet bereits Klassen für rsyslog hatten, und ich keinen offensichtlichen Unterschied zwischen den beiden gefunden habe. Hier syslog, da syslog. Ja, bei manchen ist die Dokumentation schlechter, bei anderen besser. Der eine kann das, der andere eben anders.
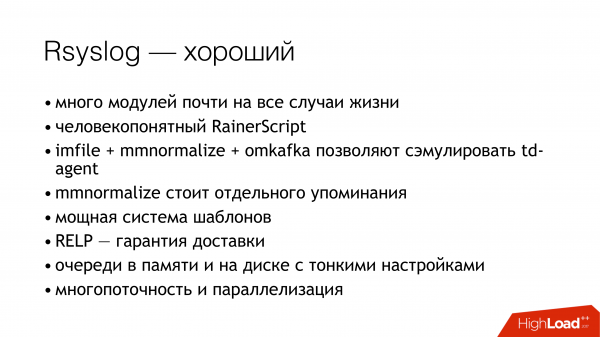
Und ein bisschen über rsyslog. Erstens ist es großartig, weil es viele Module hat. Es hat eine menschenverständliche RainerScript (moderne Konfigurationssprache). Ein großartiger Bonus ist, dass wir sein Verhalten mit den Standardmitteln simulieren konnten, und für die Anwendungen hat sich nichts geändert. Das heißt, wir ersetzen td-agent durch rsyslog, und alles andere bleibt vorerst unberührt. Und sofort haben wir eine funktionierende Zustellung. Außerdem ist mmnormalize ein großartiges Feature in rsyslog. Es ermöglicht das Parsen von Logs, jedoch nicht mit Grok und regexp. Es erstellt einen abstrakten Syntaxbaum. Es parst Logs ähnlich, wie ein Compiler Quellcode parst. Das ermöglicht eine sehr schnelle Verarbeitung, benötigt wenig CPU und ist generell eine echt großartige Sache. Es gibt viele andere Vorteile. Ich werde nicht darauf eingehen.
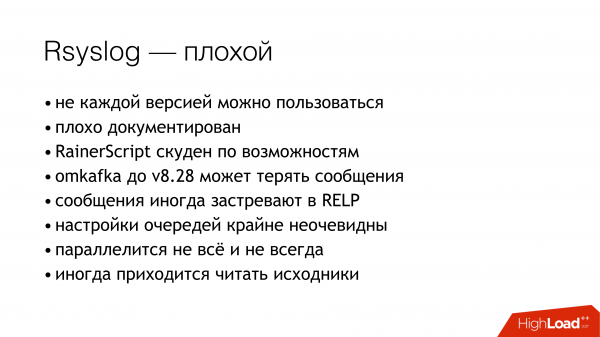
rsyslog hat auch viele Nachteile. Diese sind ungefähr die gleichen wie die Vorteile. Die größten Probleme sind, dass man wissen muss, wie man es konfiguriert, und dass man die richtige Version auswählen muss.
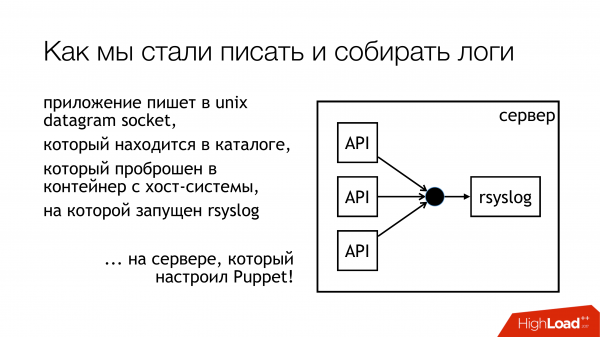
Wir haben beschlossen, dass wir Logs in einen Unix-Socket schreiben werden. Allerdings nicht in /dev/log, da wir dort ein Durcheinander aus Systemprotokollen haben, da journald in diesem Pipeline ist. Daher schreiben wir in einen benutzerdefinierten Socket. Wir hängen ihn an ein separates Ruleset. Wir werden nichts durcheinanderbringen. Es wird alles transparent und verständlich sein. So haben wir es eigentlich gemacht. Das Verzeichnis mit diesen Sockets ist standardisiert und wird in alle Container durchgereicht. Die Container können den benötigten Socket sehen, öffnen und darauf schreiben.
Warum nicht in eine Datei? Weil alle gelesen haben , der versucht hat, eine Datei in Docker weiterzuleiten, und festgestellt hat, dass sich nach dem Neustart von rsyslog der Dateideskriptor ändert und Docker diese Datei verliert. Es hält etwas anderes offen, aber nicht den Socket, in den geschrieben wird. Wir haben beschlossen, dieses Problem zu umgehen, und außerdem die Blockierungsproblematik zu umgehen.
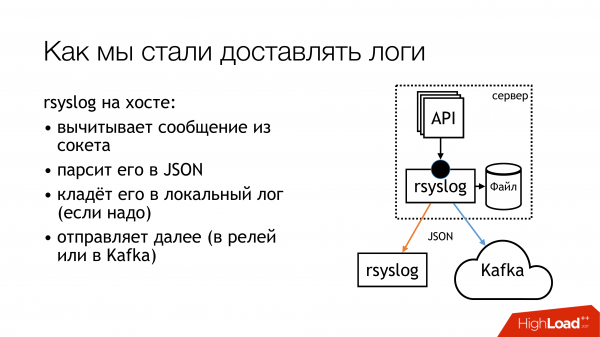
Rsyslog führt die auf der Folie angegebenen Aktionen durch und sendet Logs entweder an einen Relay oder an Kafka. Kafka entspricht der alten Methode. Der Relay ist der Versuch, rsyslog rein für die Log-Zustellung zu verwenden. Ohne Message Queue, mit den Standardmitteln von rsyslog. Prinzipiell funktioniert das.
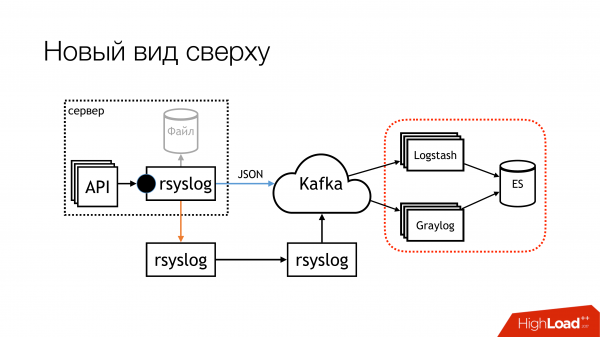
Es gibt jedoch Feinheiten, wie man sie später in diesen Teil (Logstash/Graylog/ES) einfügt. Dieser Teil (rsyslog-rsyslog) wird zwischen den Rechenzentren verwendet. Hier gibt es eine komprimierte TCP-Verbindung, die Bandbreite spart und somit die Wahrscheinlichkeit erhöht, dass wir Protokolle aus einem anderen Rechenzentrum in Situationen erhalten, in denen die Verbindung überlastet ist. Denn wir haben Indonesien, wo alles schlecht läuft. Dort ist das ein ständiges Problem.
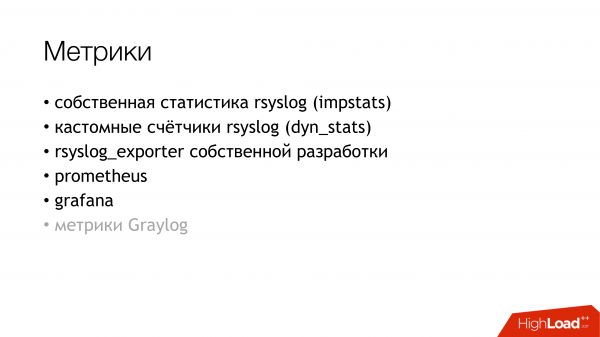
Wir haben uns überlegt, wie wir eigentlich überwachen können, mit welcher Wahrscheinlichkeit die Protokolle, die wir aus der Anwendung aufgezeichnet haben, das andere Ende erreichen. Wir haben uns entschieden, Metriken einzuführen. Rsyslog hat sein eigenes Statistikmodul, das einige Zähler enthält. Zum Beispiel kann es Ihnen die Größe der Warteschlange anzeigen oder wie viele Nachrichten in einer bestimmten Aktion angekommen sind. Daraus kann man bereits etwas ziehen. Außerdem gibt es benutzerdefinierte Zähler, die man einstellen kann, und diese zeigen beispielsweise die Anzahl der Nachrichten an, die eine bestimmte API aufgezeichnet hat. Danach habe ich den rsyslog_exporter in Python geschrieben und wir haben alles an Prometheus gesendet und Grafiken erstellt. Wir hätten gerne die Metriken von Graylog gehabt, aber bisher hatten wir nicht die Zeit, sie einzurichten.
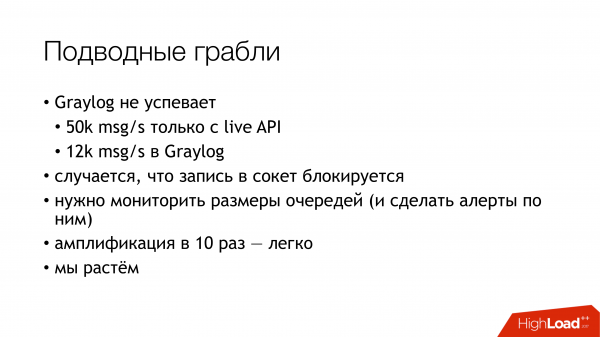
Was waren die Probleme? Die Probleme bestanden darin, dass wir herausfanden (überraschenderweise!), dass unsere Live-APIs 50.000 Nachrichten pro Sekunde schreiben. Das sind nur die Live-APIs ohne Staging. Graylog zeigt uns jedoch nur 12.000 Nachrichten pro Sekunde. Und es stellte sich die vernünftige Frage, wo die restlichen Nachrichten geblieben sind? Daraus schlossen wir, dass Graylog einfach überfordert ist. Wir haben uns das angesehen und festgestellt, dass Graylog mit Elasticsearch diesen Datenstrom nicht bewältigen kann.
Darüber hinaus gab es weitere Erkenntnisse, die wir im Prozess gewonnen haben.
Das Schreiben in den Socket wird blockiert. Wie ist das passiert? Als ich rsyslog für die Lieferung verwendete, brach irgendwann der Kanal zwischen den Rechenzentren zusammen. Die Lieferung stoppte an einem Punkt, die Lieferung an einem anderen Punkt. Das alles führte zu dem Server mit den APIs, die in den rsyslog-Socket schreiben. Dort füllte sich die Warteschlange. Dann füllte sich die Warteschlange für das Schreiben in den Unix-Socket, die standardmäßig 128 Pakete beträgt. Der nächste write() im Programm wird blockiert. Als wir uns die Bibliothek ansahen, die wir in den Go-Anwendungen verwenden, stand dort, dass das Schreiben in den Socket im nicht-blockierenden Modus erfolgt. Wir waren uns sicher, dass nichts blockiert ist. Denn wir haben gelesen. , die darüber geschrieben hat. Aber es gibt einen Punkt. Um diesen Aufruf herum gab es eine endlose Schleife, in der ständig versucht wurde, eine Nachricht in den Socket zu stecken. Das haben wir nicht bemerkt. Wir mussten die Bibliothek umschreiben. Seitdem hat sie sich mehrere Male geändert, aber jetzt haben wir alle Blockierungen in allen Subsystemen beseitigt. Daher kann rsyslog gestoppt werden, und es wird nichts abstürzen.
Wir müssen die Größe der Warteschlangen überwachen, um nicht auf diese Probleme zu stoßen. Erstens können wir überwachen, wann wir anfangen, Nachrichten zu verlieren. Zweitens können wir überwachen, dass wir im Allgemeinen Probleme mit der Zustellung haben.
Und ein weiteres unangenehmes Problem – die Amplitudierung um das Zehnfache in einer Mikroservices-Architektur – ist sehr einfach. Wir haben nicht so viele eingehende Anfragen, aber aufgrund des Graphen, über den diese Nachrichten weiterlaufen, und aufgrund der Access-Logs erhöhen wir tatsächlich die Last der Logs ungefähr um das Zehnfache. Leider habe ich nicht die genauen Zahlen gezählt, aber Mikroservices sind wie sie sind. Das muss man im Hinterkopf behalten. Dementsprechend ist das Log-Sammlungssystem derzeit das am stärksten belastete in Lazada.
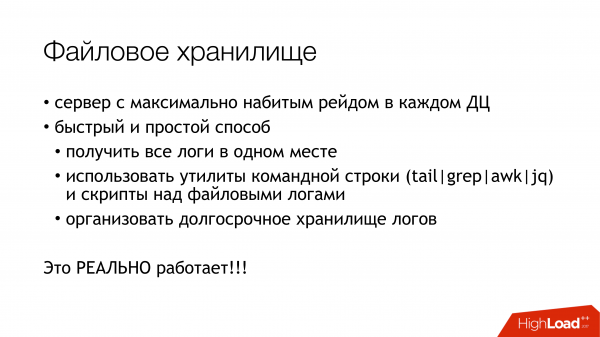
Wie löst man das Problem mit Elasticsearch? Wenn man schnell die Logs an einem Ort haben möchte, um nicht auf allen Maschinen suchen zu müssen, verwendet man eine Dateispeicherlösung. Das funktioniert garantiert. Es kann von jedem Server eingerichtet werden. Man muss nur Festplatten anschließen und syslog installieren. Danach hat man garantiert alle Logs an einem Ort. Dann kann man in Ruhe Elasticsearch, Graylog oder etwas anderes einrichten. Aber man hat bereits alle Logs, und man kann sie so lange speichern, wie der Speicherplatz reicht.
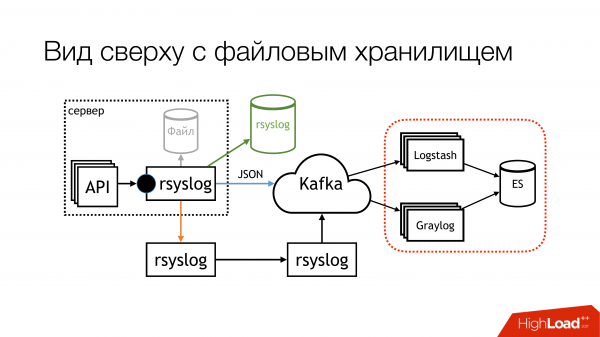
Zum Zeitpunkt meines Vortrags sah das Schema so aus. Wir haben fast aufgehört, in Dateien zu schreiben. Jetzt werden wir wahrscheinlich die Reste abschalten. Auf den lokalen Maschinen, auf denen die APIs laufen, werden wir nicht mehr in Dateien schreiben. Erstens gibt es einen Dateispeicher, der sehr gut funktioniert. Zweitens geht der Speicherplatz auf diesen Maschinen ständig zur Neige, man muss ihn ständig überwachen.
Dieser Teil mit Logstash und Graylog, der ist wirklich belastend. Daher müssen wir ihn loswerden. Wir müssen etwas auswählen.
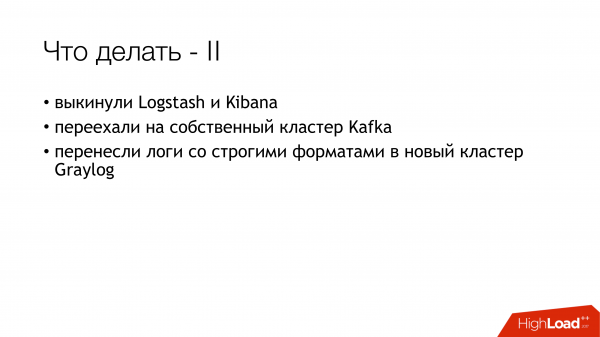
Wir haben beschlossen, Logstash und Kibana abzulehnen. Denn wir haben eine Sicherheitsabteilung. Was hat das damit zu tun? Der Zusammenhang ist, dass Kibana ohne X-Pack und ohne Shield keine Zugriffsbeschränkungen für Logs ermöglicht. Deshalb haben wir Graylog genommen. Das gefällt mir nicht, aber es funktioniert. Wir haben neue Hardware gekauft, frisches Graylog installiert und alle Logs mit strengen Formaten in ein separates Graylog übertragen. Wir haben das Problem mit verschiedenen Typen derselben Felder organisatorisch gelöst.
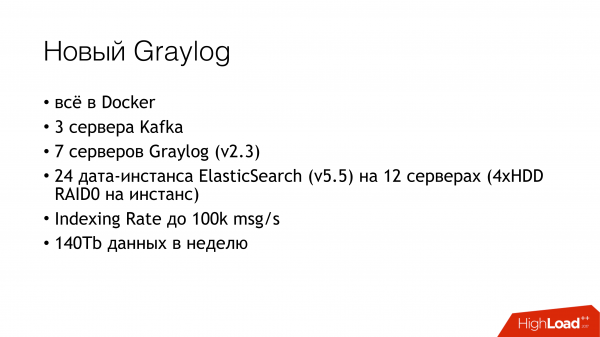
Was genau in das neue Graylog einfließt. Wir haben einfach alles in Docker aufgezeichnet. Wir haben eine Menge Server genommen, drei Instanzen Kafka ausgerollt, 7 Server Graylog in Version 2.3 (weil wir Elasticsearch in Version 5 wollten). All dies haben wir mit HDD-RAIDs hochgezogen. Wir sahen eine Indexierungsrate von bis zu 100.000 Nachrichten pro Sekunde. Wir sahen die Zahl von 140 Terabyte Daten pro Woche.
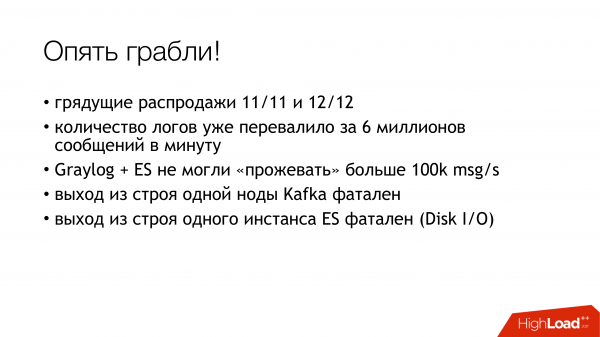
Und wieder die gleichen Probleme! Bei uns stehen zwei Verkaufsaktionen bevor. Wir sind über 6 Millionen Nachrichten umgezogen. Unser Graylog hat Schwierigkeiten, mitzuhalten. Irgendwie müssen wir wieder überleben.
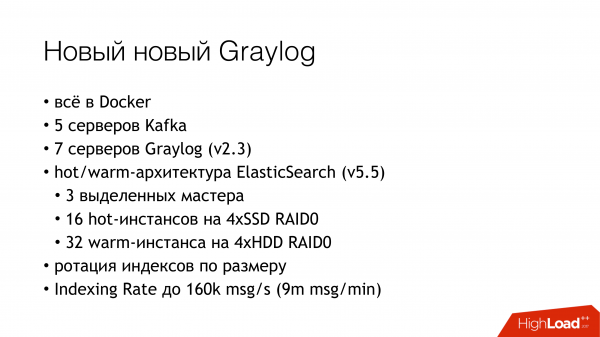
So haben wir überlebt. Wir haben noch ein paar Server und SSDs hinzugefügt. Momentan leben wir auf diese Weise. Jetzt verarbeiten wir bereits 160.000 Nachrichten pro Sekunde. Wir sind noch nicht an die Grenze gestoßen, daher ist es noch unklar, wie viel wir wirklich aus diesem System herausziehen können.
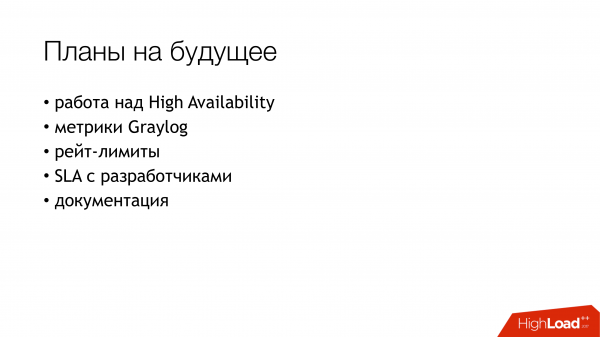
Das sind unsere Zukunftspläne. Darunter ist wahrscheinlich das Wichtigste die Hochverfügbarkeit. Die haben wir bisher nicht. Einige Maschinen sind identisch konfiguriert, aber es läuft alles über eine Maschine. Wir müssen Zeit investieren, um das Failover zwischen ihnen einzurichten.
Metriken von Graylog sammeln.
Ein Rate-Limit einrichten, damit uns eine verrückte API nicht die Bandbreite und alles andere kaputt macht.
Und schließlich irgendein SLA mit den Entwicklern unterzeichnen, dass wir bis zu einem bestimmten Punkt unterstützen können. Wenn Sie mehr schreiben, tut es uns leid.
Und Dokumentation schreiben.
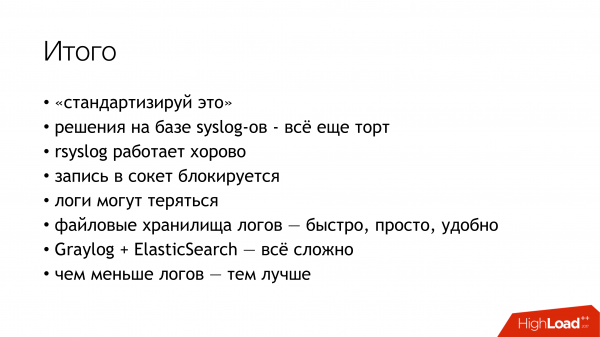
Kurz gesagt, die Ergebnisse von allem, was wir durchgemacht haben. Erstens Standards. Zweitens, syslog — ein Kuchen. Drittens, rsyslog funktioniert genau so, wie auf der Folie dargestellt. Und lassen Sie uns zu den Fragen übergehen.
Fragen.
Frage: Warum haben wir uns entschieden, doch nicht… (filebeat?)
Antwort: Wir müssen in eine Datei schreiben. Das wollte ich wirklich nicht. Wenn deine API Tausende von Nachrichten pro Sekunde schreibt, ist es trotzdem nicht möglich, das einmal pro Stunde zu rotieren. Man kann in ein Pipe schreiben. Worauf die Entwickler mich fragten: „Was passiert, wenn der Prozess, in den wir schreiben, abstürzt?“ Ich wusste nicht, was ich ihnen antworten sollte, und sagte: „Nun gut, lass uns das nicht machen.“
Frage: Warum schreiben Sie die Logs nicht einfach in HDFS?
Antwort: Das ist die nächste Phase. Wir haben am Anfang darüber nachgedacht, aber da wir derzeit keine Ressourcen dafür haben, bleibt es als langfristige Lösung offen.
Frage: Das Spaltenformat wäre geeigneter.
Antwort: Ich verstehe alles. Wir sind mit beiden Händen dafür.
Frage: Sie schreiben in rsyslog. Dort kann man sowohl TCP als auch UDP verwenden. Aber wenn UDP, wie garantieren Sie dann die Lieferung?
Antwort: Es gibt zwei Punkte. Erstens sage ich sofort allen, dass wir die Lieferung der Logs nicht garantieren. Denn wenn Entwickler kommen und sagen: 'Lass uns dort finanzielle Daten schreiben, und ihr speichert sie irgendwo für den Fall, dass etwas passiert', antworten wir: 'Ausgezeichnet! Lass uns sicherstellen, dass ihr mit dem Schreiben in den Socket blockiert und das in Transaktionen macht, damit ihr uns das garantiert in den Socket legt und sicherstellt, dass wir es von der anderen Seite erhalten.' Und in diesem Moment verlieren alle sofort das Interesse. Wenn du nicht garantieren willst, dass in den Socket geschrieben wird, warum sollten wir dann die Lieferung garantieren? Wir geben unser Bestes. Wir versuchen wirklich, so viel und so gut wie möglich zu liefern, aber wir geben keine 100 % Garantie. Deshalb sollten dort keine finanziellen Daten geschrieben werden. Dafür gibt es Datenbanken mit Transaktionen.
Frage: Wenn das API eine Nachricht in das Log generiert und die Kontrolle an Mikrodienste übergibt, sind Sie nicht auf das Problem gestoßen, dass Nachrichten von verschiedenen Mikrodiensten in falscher Reihenfolge eintreffen? Das führt zu Verwirrung.
Antwort: Es ist normal, dass sie in unterschiedlicher Reihenfolge ankommen. Darauf muss man vorbereitet sein. Denn jede Netzwerkübertragung garantiert Ihnen keine Reihenfolge, oder man muss speziell Ressourcen dafür aufwenden. Wenn wir Dateispeicher betrachten, speichert jedes API die Logs in seiner eigenen Datei. Genauer gesagt, rsyslog organisiert sie in Verzeichnissen. Jedes API hat dort seine Logs, wo man hingehen und nachsehen kann, und dann können sie sie nach dem Zeitstempel im Log vergleichen. Wenn sie in Graylog schauen, werden sie dort nach dem Zeitstempel sortiert. Dort wird alles gut sein.
Frage: Der Zeitstempel kann sich um Millisekunden unterscheiden.
Antwort: Der Zeitstempel wird vom API selbst generiert. Das ist eigentlich der ganze Punkt. Wir haben NTP. Das API generiert den Zeitstempel bereits in der Nachricht. Das fügt nicht rsyslog hinzu.
Frage: Es ist nicht ganz klar, wie die Interaktion zwischen den Rechenzentren erfolgt. Innerhalb eines Rechenzentrums ist klar, wie die Protokolle gesammelt und verarbeitet werden. Wie findet die Interaktion zwischen den Rechenzentren statt? Oder jedes Rechenzentrum lebt sein eigenes Leben?
Antwort: Fast. Jedes Land befindet sich in einem bestimmten Rechenzentrum. Derzeit haben wir keine Verteilung, bei der ein Land in verschiedenen Rechenzentren untergebracht ist. Deshalb müssen sie nicht zusammengeführt werden. Innerhalb jedes Zentrums gibt es ein Log Relay. Das ist ein Rsyslog-Server. Tatsächlich gibt es zwei Management-Maschinen. Sie sind gleich konfiguriert. Aber bisher läuft der Datenverkehr nur über eine von ihnen. Sie aggregiert alle Protokolle. Sie hat eine Disk-Queue für alle Fälle. Sie komprimiert die Protokolle und sendet sie an das zentrale Rechenzentrum (in Singapur), wo sie dann nach Graylog weitergeleitet werden. Und in jedem Rechenzentrum gibt es einen eigenen Datei-Speicher. Falls die Verbindung verloren geht, haben wir alle Protokolle dort. Sie werden dort bleiben. Sie werden dort gespeichert.
Frage: Bekommen Sie in AusnahmefällenProtokolle von dort?
Antwort: Man kann dorthin (zum Dateispeicher) gehen und nachsehen.
Frage: Wie überwachen Sie, dass Sie keine Protokolle verlieren?
Antwort: Tatsächlich verlieren wir sie, und wir überwachen das. Die Überwachung haben wir vor einem Monat gestartet. In der Bibliothek, die das Go API verwendet, gibt es Metriken. Sie kann zählen, wie oft sie nicht in den Socket schreiben konnte. Derzeit gibt es dort eine ausgeklügelte Heuristik. Es gibt einen Puffer. Er versucht, Nachrichten aus dem Puffer in den Socket zu schreiben. Wenn der Puffer überläuft, beginnt er, diese zu verwerfen. Und zählt, wie viele er verworfen hat. Wenn die Zähler anfangen, sich zu füllen, erfahren wir davon. Sie werden jetzt auch in Prometheus angezeigt, und in Grafana kann man die Grafiken ansehen. Man kann Benachrichtigungen einrichten. Aber es ist noch unklar, an wen sie gesendet werden sollen.
Frage: In Elasticsearch speichern Sie die Protokolle mit Sicherung. Wie viele Replikate haben Sie?
Antwort: Eine Replik.
Frage: Ist das nur eine Replik?
Antwort: Das ist ein Master und eine Replik. Die Daten werden in zwei Exemplaren gespeichert.
Frage: Haben Sie die Größe des Rsyslog-Puffers irgendwie angepasst?
Antwort: Wir schreiben Datagramme in einen benutzerdefinierten Unix-Socket. Dies setzt uns sofort eine Grenze von 128 Kilobyte. Wir können nicht mehr als das hinein schreiben. Das haben wir im Standard festgelegt. Wer in die Speicher schreiben möchte, der schreibt 128 Kilobyte. Die Bibliotheken kürzen das sowieso und setzen ein Flag, dass die Nachricht gekürzt wurde. In unserem Nachrichtensystem gibt es ein spezielles Feld, das anzeigt, ob es beim Schreiben gekürzt wurde oder nicht. So haben wir die Möglichkeit, auch diesen Punkt nachzuvollziehen.
Frage: Schreiben Sie defekten JSON?
Antwort: Defekter JSON wird entweder während des Relays abgewiesen, weil das Paket zu groß ist, oder wird von Graylog abgewiesen, weil es den JSON nicht parsen kann. Aber hier gibt es Feinheiten, die behoben werden müssen, und diese hängen größtenteils von rsyslog ab. Ich habe bereits einige Issues dazu eingetragen, an denen noch gearbeitet werden muss.
Frage: Warum Kafka? Haben Sie RabbitMQ ausprobiert? Funktioniert Graylog bei solchen Lasten nicht?
Antwort: Bei uns funktioniert Graylog nicht. Aber Graylog funktioniert bei uns. Es ist wirklich problematisch. Es ist eine spezielle Sache. Und eigentlich brauchen wir es nicht. Ich würde es vorziehen, direkt aus rsyslog in Elasticsearch zu schreiben und dann Kibana zu betrachten. Aber ich muss die Angelegenheit mit den Sicherheitsleuten klären. Das wäre eine mögliche Entwicklung für uns, wenn wir Graylog ausmisten und Kibana verwenden. Logstash macht keinen Sinn, weil ich alles genau so mit rsyslog machen kann. Und es hat ein Modul zum Schreiben in Elasticsearch. Mit Graylog versuchen wir irgendwie zu leben. Wir haben es sogar ein wenig optimiert. Aber da gibt es noch Verbesserungsbedarf.
Bezüglich Kafka. So hat es sich historisch ergeben. Als ich kam, war sie bereits vorhanden und es wurden bereits Protokolle geschrieben. Wir haben einfach unseren Cluster hochgefahren und die Logs dorthin verschoben. Wir managen ihn, wir wissen, wie es ihm geht. Bezüglich RabbitMQ... funktioniert es bei uns nicht mit RabbitMQ. Aber mit RabbitMQ läuft es gut. Es ist in der Produktion und es gab Probleme damit. Kurz vor dem Sale haben wir es angepasst und jetzt funktioniert es einwandfrei. Aber davor war ich nicht bereit, es in die Produktion zu bringen. Ein weiterer Punkt ist, dass Graylog die Version AMQP 0.9 lesen kann, während rsyslog die Version AMQP 1.0 schreiben kann. Es gibt keine Lösung, die beides kann. Entweder das eine oder das andere. Daher verwenden wir momentan nur Kafka. Aber auch da gibt es einige Nuancen. Denn omkafka der rsyslog-Version, die wir verwenden, könnte den gesamten Nachrichtenpuffer verlieren, den sie aus rsyslog abgegriffen hat. Bis jetzt kommen wir damit klar.
Frage: Verwenden Sie Kafka, weil es bereits vorhanden war? Wird es für keine anderen Zwecke verwendet?
Antwort: Die vorhandene Kafka wird vom Data Science-Team genutzt. Das ist ein ganz separates Projekt, über das ich leider nichts sagen kann. Ich bin nicht informiert. Es war in der Verantwortung des Data Science-Teams. Als die Logs eingerichtet wurden, beschlossen sie, es zu verwenden, um nicht auch noch ein eigenes aufsetzen zu müssen. Jetzt haben wir Graylog aktualisiert und die Kompatibilität verloren, weil dort eine alte Kafka-Version läuft. Wir mussten unsere eigene aufsetzen. Außerdem haben wir uns von diesen vier Topics für jede API befreit. Wir haben ein großes Topic für alles Live und ein weiteres großes Topic für alles Staging und schießen einfach alles dort hinein. Graylog sammelt das alles parallel ein.
Frage: Warum ist dieser Aufwand mit den Sockets notwendig? Haben Sie versucht, den log-Treiber syslog für Container zu verwenden?
Antwort: Zu der Zeit, als wir uns mit dieser Frage beschäftigten, war unsere Beziehung zu Docker angespannt. Es war Docker 1.0 oder 0.9. Docker selbst war seltsam. Außerdem, wenn man auch noch Logs einfüttern muss... Ich habe ein unbegründetes Gefühl, dass er alle Logs durch sich selbst, durch den Docker-Daemon, schleust. Wenn eine unserer APIs verrückt spielt, dann sind die anderen APIs darauf angewiesen, dass sie stdout und stderr nicht senden können. Ich weiß nicht, wohin das führen wird. Ich habe das Gefühl, dass wir den syslog-Treiber von Docker an dieser Stelle besser nicht verwenden sollten. Unsere Abteilung für funktionale Tests hat einen eigenen kleinen Graylog-Cluster für Logs. Sie verwenden die Log-Treiber von Docker und es scheint bei ihnen zu funktionieren. Aber sie schreiben GELF direkt in Graylog. Als wir all dies in Angriff nahmen, mussten wir sicherstellen, dass es einfach funktioniert. Vielleicht, wenn irgendwann jemand kommt und sagt, dass es seit hundert Jahren einwandfrei läuft, werden wir es ausprobieren.
Frage: Ihr macht die Zustellung zwischen den Rechenzentren mit rsyslog. Warum nicht mit Kafka?
Antwort: Wir machen es tatsächlich beides, und zwar aus zwei Gründen. Wenn die Verbindung völlig kaputt ist, kommen selbst unsere komprimierten Logs nicht hindurch. Kafka ermöglicht es einfach, sie im Prozess zu verlieren. Mit dieser Methode vermeiden wir das Verhaken dieser Logs. In diesem Fall verwenden wir einfach direkt Kafka. Wenn unsere Verbindung gut ist und wir sie entlasten möchten, dann verwenden wir rsyslog. Aber tatsächlich kann man ihn so konfigurieren, dass er das, was nicht durchkommt, selbst wegwirft. Momentan verwenden wir an einigen Stellen die Zustellung von rsyslog direkt, an anderen Stellen Kafka.
Quelle: habr.com
