

Die Definition von DevOps ist sehr komplex, weshalb es immer wieder notwendig ist, die Diskussion darüber neu zu beginnen. Allein auf Habr gibt es tausende von Veröffentlichungen zu diesem Thema. Aber wenn Sie dies lesen, wissen Sie wahrscheinlich, was DevOps ist. Denn ich weiß es nicht. Hallo, ich heiße Alexander Titov (@), und wir werden einfach über DevOps sprechen und ich werde meine Erfahrungen teilen.
Ich habe lange überlegt, wie ich meine Erzählung nützlich gestalten kann, daher wird es hier viele Fragen geben – die, die ich mir selbst stelle, und die, die ich unseren Kunden stelle. Indem ich auf diese Fragen antworte, wird das Verständnis besser. Ich werde erzählen, warum DevOps aus meiner Sicht notwendig ist, was es ist, wiederum aus meiner Perspektive, und wie man erkennt, dass man sich auf dem Weg zu DevOps befindet, wiederum aus meiner Sicht. Der letzte Punkt wird durch Fragen erfolgen. Indem Sie sich diese selbst stellen, können Sie verstehen, ob Ihr Unternehmen auf dem Weg zu DevOps ist oder ob es dabei Probleme gibt.
Eine Zeit lang war ich auf den Wellen von Fusionen und Übernahmen unterwegs. Zunächst arbeitete ich in einem kleinen Startup namens Qik, das dann von einer etwas größeren Firma namens Skype übernommen wurde, die später von einer noch größeren Firma, Microsoft, gekauft wurde. In diesem Moment bekam ich Einblicke, wie sich die Vorstellung von DevOps in Unternehmen unterschiedlicher Größenordnungen transformiert. Danach wurde es für mich interessant, DevOps aus Marktsicht zu betrachten, und wir gründeten mit Kollegen die Firma Express 42. Bereits seit 6 Jahren navigieren wir auf diesem Markt.
Nebenbei bin ich einer der Organisatoren der Community DevOps Moscow und Organisator von DevOps-Days 2017, die 2018 jedoch nicht organisiert wurden. Express 42 arbeitet mit vielen Firmen zusammen. Wir etablieren dort DevOps, beobachten, wie das geschieht, ziehen Schlussfolgerungen, analysieren und teilen unsere Ergebnisse mit allen, schulen Menschen in DevOps-Praktiken. Kurz gesagt, wir fördern in dieser Hinsicht unsere Erfahrungen und unsere Expertise.
Warum DevOps
Die erste Frage, die alle und immer verfolgt – warum? Viele glauben, dass DevOps einfach Automatisierung oder eine ähnliche Sache ist, die bereits in jedem Unternehmen vorhanden war.
— Wir hatten Continuous Integration – das heißt, wir hatten bereits DevOps, und warum brauchen wir diesen ganzen Kram? Da drüben amüsiert man sich, während uns die Arbeit im Weg steht!
Nach 9 Jahren der Entwicklung der Gemeinschaft und Methodik ist bereits klar geworden, dass es sich dabei nicht um Marketingflitter handelt, aber es ist trotzdem nicht ganz klar, wozu es notwendig ist. Wie bei jedem Werkzeug und Prozess hat DevOps bestimmte Ziele, die es letztendlich erreicht.
Das alles hängt damit zusammen, dass sich die Welt verändert. Sie entfernt sich von dem unternehmerischen Ansatz, bei dem Unternehmen gemäß einer bestimmten Strategie, wie unser Petersburger Klassiker sang, von Punkt A nach Punkt B aufbrechen, unterstützt von einer dafür aufgebauten Struktur.
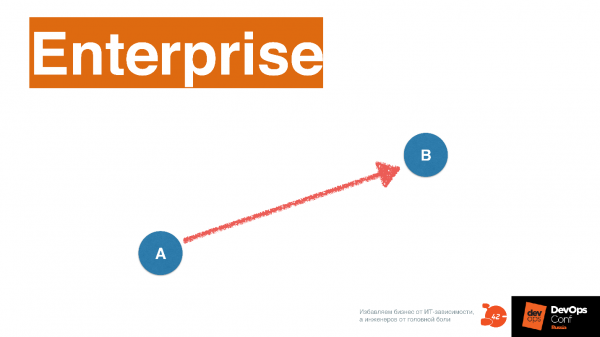
Im Grunde sollte alles im IT-Bereich auf diesem Ansatz basieren. Hier wird IT ausschließlich zur Automatisierung von Prozessen eingesetzt.
Automatisierung ändert sich nicht oft, denn wenn ein Unternehmen auf den gewohnten Pfaden voranschreitet – was soll man da ändern? Es funktioniert – also nicht anfassen. Derzeit ändern sich die Ansätze in der Welt, und der, der als Agile bezeichnet wird, besagt, dass das endgültige Ziel B nicht sofort sichtbar ist.
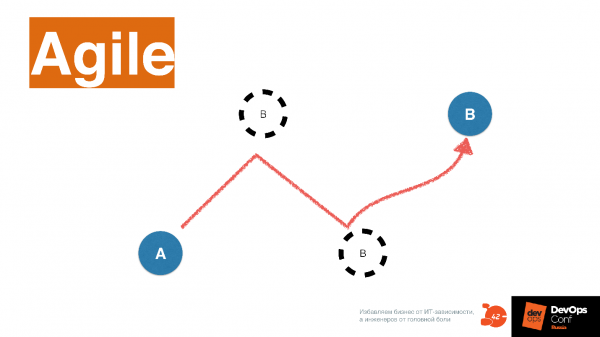
Wenn ein Unternehmen den Markt durchläuft und mit dem Kunden arbeitet, erforscht es ständig den Markt und ändert das endgültige Ziel B. Je häufiger ein Unternehmen seine Richtung ändert, desto erfolgreicher ist es letztendlich, da es mehr Marktsegmente auswählt.
Eine interessante Firma zeigt diese Strategie, von der ich kürzlich erfahren habe. One Box Shave – ein Lieferdienst für Rasierer und Rasurartikel im Abonnement in einer Box. Sie können ihre „Box“ für verschiedene Kunden individuell anpassen. Das erledigt eine spezielle Software, die dann die Bestellung an eine koreanische Fabrik sendet, die das Produkt herstellt.
Dieses Produkt wurde von der Firma Unilever für 1 Milliarde Dollar gekauft. Jetzt konkurriert es mit Gillette und hat einen signifikanten Marktanteil in den USA gewonnen. One Box Shave sagt:
— 4 Klingen? Sind Sie im Ernst? Warum brauchen Sie das – das verbessert die Rasurqualität nicht. Ein speziell ausgewählter Rasiercreme, Duft und ein qualitativ hochwertiger Rasierer mit zwei Klingen lösen viel mehr Fragen als diese lächerlichen 4 Klingen von Gillette! Gehen wir bald auf 10 über?
So verändert sich die Welt. Unilever behauptet, dass sie ein großartiges IT-System haben, das dies ermöglicht. Am Ende sieht das aus wie das Konzept Time-to-market, über das bereits viele gesprochen haben.
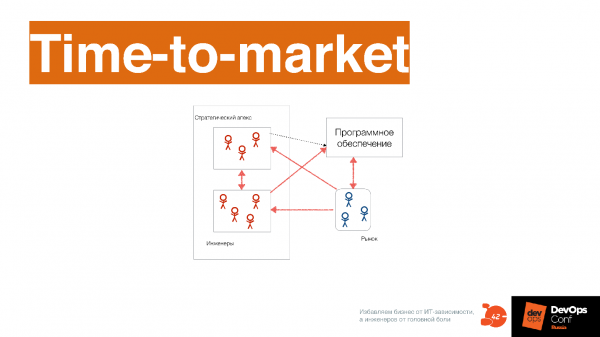
Die Bedeutung von Time-to-market liegt nicht darin, wie oft wir deployments durchführen. Man kann häufig deployen, doch die Release-Zyklen können dabei lang sein. Wenn man dreißig monatliche Release-Zyklen übereinanderlegt und um eine Woche verschiebt, scheint es, als ob das Unternehmen einmal pro Woche deployt. Aber von der Idee bis zur endgültigen Umsetzung vergehen 3 Monate.
Time-to-market bedeutet, die Zeit von der Idee bis zur endgültigen Umsetzung zu minimieren.
In diesem Fall interagiert die Software mit dem Markt. So interagiert die Website von One Box Shave mit dem Kunden. Sie haben keine Verkäufer – nur die Website, auf der die Besucher klicken und Wünsche hinterlassen. Daher muss die Website ständig neue Inhalte bereitstellen und aktualisiert werden, um den Wünschen gerecht zu werden. Zum Beispiel rasieren sich die Menschen in Südkorea anders als in Russland und sie bevorzugen im Duft nicht den Geruch von Kiefer, sondern zum Beispiel den von Vanille-Möhren.
Da der Inhalt der Website schnell geändert werden muss, verändert sich auch die Softwareentwicklung erheblich. Durch die Software müssen wir herausfinden, was der Kunde will. Früher haben wir das auf indirektem Weg erfahren, zum Beispiel über das Business-Management. Dann entwarfen wir und legten die Anforderungen in das IT-System, und alles lief glatt. Heute ist es anders – die Software wird von allen, die an dem Prozess beteiligt sind, einschließlich der Ingenieure, entworfen, da sie durch technische Spezifikationen erfahren, wie der Markt funktioniert, und auch ihre Einsichten mit dem Geschäft teilen.
Zum Beispiel haben wir bei der Firma Qik plötzlich erfahren, dass die Leute es sehr mögen, Kontaktlisten auf den Server hochzuladen, und sie haben uns eine App gegeben. Zuvor hatten wir darüber nicht nachgedacht. In einem klassischen Unternehmen hätte man wahrscheinlich gesagt, das sei ein Bug, weil in der Spezifikation nicht steht, dass es gut funktionieren sollte, und es wurde schließlich improvisiert. Man hätte die Funktion abgeschaltet und gesagt: "Das braucht keiner, das Wichtigste ist, dass die Grundfunktionen funktionieren." Aber ein technologieorientiertes Unternehmen sieht darin eine Chance und beginnt, die Software entsprechend zu ändern.
Im Jahr 1968 formulierte der weitsichtige Melvin Conway die folgende Idee.
Eine Organisation, die ein System erstellt, ist durch das Design eingeschränkt, das die Kommunikationsstruktur dieser Organisation widerspiegelt.
Wenn wir ins Detail gehen, um Systeme eines anderen Typs zu produzieren, benötigen wir zusätzlich eine Kommunikationsstruktur innerhalb des Unternehmens, die ebenfalls anders ist. Wenn Sie eine hierarchische Kommunikationsstruktur haben, wird dies es Ihnen nicht ermöglichen, Systeme zu schaffen, die eine sehr hohe Time-to-Market-Rate bieten können.
Lesen kann man . Es ist wichtig für das Verständnis der Kultur oder Philosophie von DevOps, da das Einzige, was sich grundlegend in DevOps ändert, die Kommunikationsstruktur zwischen den Teams ist..
Aus der Sicht des Prozesses liefen vor DevOps alle Phasen: Analyse, Entwicklung, Test, Betrieb, linear.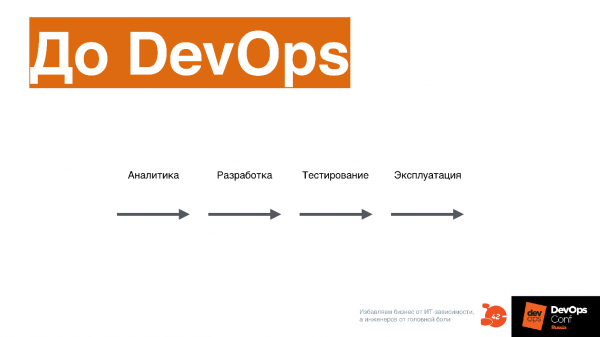
Im Fall von DevOps laufen all diese Prozesse gleichzeitig.
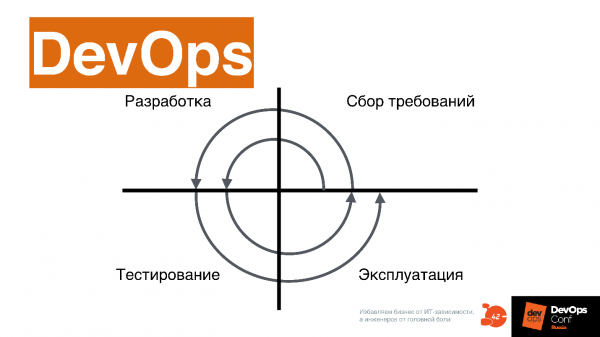
Time-to-Market kann nur so erfüllt werden. Für Menschen, die im alten Prozess gearbeitet haben, wirkt das etwas futuristisch und im Grunde auch unpraktisch.
Warum ist DevOps notwendig?
Für die Entwicklung digitaler Produkte. Wenn Ihr Unternehmen kein digitales Produkt hat, ist DevOps nicht nötig – das ist sehr wichtig.
DevOps überwindet die Geschwindigkeitsgrenzen des sequentiellen Softwareproduktionsplans. In ihm laufen alle Prozesse gleichzeitig.
Die Komplexität nimmt zu. Wenn DevOps-Evangelisten erzählen, dass es mit ihm einfacher wird, Software zu veröffentlichen – das ist Unsinn.
Mit DevOps wird alles nur komplizierter.
Auf der Konferenz am Stand von Avito konnte man sehen, was es bedeutet, einen Docker-Container zu deployen – eine unmögliche Aufgabe. Die Komplexität wird übermenschlich, man muss viele Bälle gleichzeitig jonglieren.
DevOps verändert vollständig den Prozess und die Organisation im Unternehmen – genauer gesagt, ändert nicht DevOps, sondern das digitale Produkt. Um zu DevOps zu gelangen, muss dieser Prozess jedoch vollständig geändert werden.
Fragen für den Spezialisten
Und was ist mit Ihnen? Fragen, die Sie sich stellen können, während Sie im Unternehmen arbeiten und sich als Spezialist weiterentwickeln.
Haben Sie eine Strategie zur Erstellung eines digitalen Produkts? Wenn ja – schon gut. Das bedeutet, dass Ihr Unternehmen in Richtung DevOps geht.
Erstellt Ihr Unternehmen bereits ein digitales Produkt? Das bedeutet, dass Sie noch eine Stufe höher steigen können, interessantere Dinge tun – aus der Sicht von DevOps, um genau zu sein. Nur aus dieser Perspektive spreche ich.
Ist Ihr Unternehmen einer der Marktführer in der Nische mit einem digitalen Produkt? Spotify, Yandex, Uber – Unternehmen, die sich derzeit an der Spitze des technologischen Fortschritts befinden.
Stellen Sie sich diese Fragen, und wenn alle Antworten negativ sind, sollten Sie vielleicht nicht in diesem Unternehmen DevOps praktizieren. Wenn Ihnen jedoch das Thema DevOps wirklich interessiert, sollten Sie vielleicht… in ein anderes Unternehmen wechseln? Wenn Ihr Unternehmen DevOps umsetzen möchte, Sie aber auf alle Fragen mit „Nein“ geantwortet haben, ähnelt es diesem wunderbaren Nashorn, das sich nie verändern wird.
Organisation
Wie ich bereits gesagt habe, verändert sich die Organisation in einem Unternehmen gemäß dem Conway-Gesetz. Ich beginne mit dem, was DevOps daran hindert, intern im Unternehmen einzudringen, und zwar aus organisatorischer Sicht.
Das Problem der „Silos“
Das englische Wort „Silo“ wird hier auf Russisch als „колодец“ übersetzt. Der Sinn dieses Problems ist, dass es keinen Informationsaustausch zwischen den Teams gibt.Jedes Team gräbt seine Expertise tief, ohne eine gemeinsame Karte zu erstellen, auf der man sich orientieren kann.
Das erinnert an jemanden, der gerade in Moskau angekommen ist und noch nicht weiß, wie man sich mit der U-Bahn-karte orientiert. Muskoviten wissen normalerweise sehr gut Bescheid über ihren Stadtteil, und in ganz Moskau orientieren sie sich mit der U-Bahn-Karte. Wenn Sie zum ersten Mal nach Moskau kommen, haben Sie diese Fähigkeit nicht und sind einfach orientierungslos.
DevOps schlägt vor, diesen Moment der Desorientierung zu überwinden und allen Abteilungen gemeinsam eine gemeinsame Interaktionskarte zu erstellen.
Zwei Faktoren stehen dem entgegen.
Folge der Corporate Governance. Sie ist aus separaten hierarchischen „Silos“ aufgebaut. Zum Beispiel gibt es bestimmte KPIs in Unternehmen, die dieses System unterstützen. Andererseits stehen die Gedanken des Menschen dem im Wege, der Schwierigkeiten hat, über seine Expertise hinauszublicken und sich im gesamten System zurechtzufinden. Das ist einfach unbequem. Stellen Sie sich vor, Sie befinden sich am Flughafen von Bangkok – dort ist es schnell schwierig, sich zurechtzufinden. Auch in DevOps ist es kompliziert, den Überblick zu behalten, und deshalb sagen die Leute, dass man einen Führer finden muss, um dorthin zu gelangen.
Aber das Wichtigste ist, dass das Problem der „Silos“ für einen Ingenieur, der den Geist von DevOps verinnerlicht hat, Fowlers Bücher gelesen hat und viele andere Bücher, darin besteht, dass „Silos“ nicht erlauben, „offensichtliche“ Dinge zu tun.Wir treffen uns oft nach DevOps Moscow, reden miteinander und die Leute beklagen sich:
— Wir wollten einfach nur CI starten, aber es stellte sich heraus, dass das Management das nicht braucht.
Das geschieht genau aus dem Grund, dass CI und Continuous Delivery Prozess an der Grenze vieler Fachgebiete liegen. Wenn das Problem der 'Brunnen' auf organisatorischer Ebene nicht überwunden wird, wird es nicht möglich sein, weiterzukommen, egal was Sie tun und wie traurig das auch sein mag.
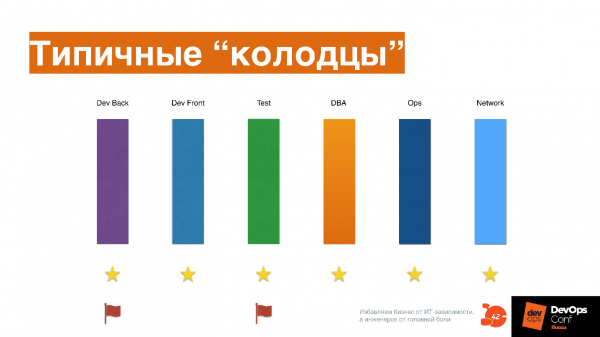
Jeder Teilnehmer des Prozesses im Unternehmen: Backend- und Frontend-Entwickler, Test, DBA, Betrieb, Netzwerk, arbeitet in seiner eigenen Richtung, während niemand außer dem Manager eine gemeinsame Übersicht hat, der sie auf eine Art überwacht und nach der Methode "teile und herrsche" verwaltet.
Die Leute kämpfen um irgendwelche Sternchen oder Fähnchen, jeder bearbeitet sein eigenes Fachgebiet.
Letztendlich, wenn die Aufgabe auftaucht, all dies zusammenzufügen und eine gemeinsame Pipeline zu erstellen, und um Sternchen und Fähnchen braucht man nicht mehr zu kämpfen, stellt sich die Frage – was soll man überhaupt tun? Man muss irgendwie einen Konsens finden, aber niemand hat uns in der Schule dazu gelehrt. Wir sind schon seit der Schule daran gewöhnt: Acht Klasse – wow! – im Vergleich zur Siebten! Hier ist es ganz ähnlich.
Ist das auch in Ihrem Unternehmen so?
Um das zu überprüfen, kann man sich folgende Fragen stellen.
Nutzen die Teams gemeinsame Werkzeuge, tragen sie zur Änderung dieser gemeinsamen Werkzeuge bei?
Wie oft werden die Teams umgebildet – wechseln Spezialisten aus einem Team in ein anderes? In der DevOps-Umgebung wird das normal, denn manchmal kann eine Person einfach nicht verstehen, was ein anderes Fachgebiet tut. Sie wechselt in eine andere Abteilung, arbeitet dort zwei Wochen, um sich eine Orientierungs- und Interaktionskarte mit dieser Abteilung zu erstellen.
Kann ein Komitee zur Änderung gegründet und etwas geändert werden? Oder ist dafür eine starke Hand der obersten Führungsebene und eine Anweisung erforderlich? Kürzlich habe ich auf Facebook geschrieben, wie eine wenig bekannte Bank durch Anweisungen Werkzeuge einführt: Sie haben eine Anweisung geschrieben, setzen es ein Jahr um und schauen, was passiert. Das ist natürlich langwierig und traurig.
Wie wichtig ist es für Manager, persönliche Erfolge unabhängig von den Erfolgen des Unternehmens zu erzielen?
Wenn Sie diese Fragen für sich selbst beantworten, wird klarer, ob Sie ein solches Problem im Unternehmen haben.
Infrastruktur als Code
Nachdem dieses Problem überwunden ist, ist die erste wichtige Praxis, ohne die es schwierig ist, im DevOps weiterzukommen – das ist Infrastruktur als Code.
Meistens wird Infrastructure as Code so verstanden:
— Lass uns alles mit bash automatisieren, uns mit Skripten eindecken, damit die Administratoren weniger manuelle Arbeit haben!
Aber das ist nicht so.
Infrastructure as Code bedeutet, dass Sie die IT-Systeme, mit denen Sie arbeiten, in Form von Code beschreiben, um ständig ihren Zustand zu verstehen.
Gemeinsam mit anderen Teams erstellen Sie eine Karte in Form von Code, die allen verständlich ist und nach der man navigieren kann. Es spielt keine Rolle, womit das gemacht wird – ob mit Chef, Ansible, Salt oder YAML-Dateien in Kubernetes – es macht keinen Unterschied.
Auf der Konferenz erzählte ein Kollege von 2GIS, wie sie ihr internes Tool für Kubernetes entwickelt haben, das die Struktur einzelner Systeme beschreibt. Um 500 Systeme zu beschreiben, benötigten sie ein separates Werkzeug, das diese Beschreibung generiert. Wenn man diese Beschreibung hat, kann jeder sich gegenseitig abgleichen, Änderungen überwachen, wie man sie verändern und verbessern kann und was fehlt.
Sie müssen zustimmen, dass separate bash-Skripte normalerweise nicht zu diesem Verständnis führen. In einer der Firmen, in denen ich gearbeitet habe, gab es sogar den Begriff „write only“-Skript – wenn das Skript geschrieben ist, kann man es nicht mehr lesen. Ich glaube, das ist Ihnen auch bekannt.
Infrastructure as Code ist Code, der den aktuellen Zustand der Infrastruktur beschreibt. An diesem Code arbeiten gemeinsam viele Produkt-, Infrastruktur- und Serviceteams, und das Wichtigste ist, dass alle verstehen müssen, wie dieser Code überhaupt funktioniert.
Der Code wird entsprechend den besten Praktiken für die Arbeit mit Code gepflegt: gemeinsame Entwicklung, Code-Reviews, XP-Programmierung, Tests, Pull-Requests, CI für Infrastructure as Code – das alles ist wertvoll und kann verwendet werden.
Der Code wird zur gemeinsamen Sprache für alle Ingenieure.
Änderungen an der Infrastruktur im Code nehmen nicht viel Zeit in Anspruch. Ja, auch im Infrastrukturcode kann es technische Schulden geben. Normalerweise stoßen Teams nach anderthalb Jahren auf diese, nachdem sie angefangen haben, „Infrastructure as Code“ in Form von vielen Skripten oder sogar Ansible einzuführen, das sie wie Spaghetticode schreiben und dazu noch bash-Skripte hineinschieben!
Wichtig: Wenn Sie diesen Mist noch nicht ausprobiert haben, merken Sie sich, dass Ansible – nicht bashBitte lesen Sie die Dokumentation sorgfältig und erfahren Sie, was darüber gesagt wird.
Infrastructure as Code bedeutet, den Infrastrukturcode in separate Schichten zu unterteilen.
In unserem Unternehmen unterscheiden wir 3 grundlegende Schichten, die sehr klar und einfach verständlich sind, aber es können auch mehr sein. Sie können Ihren Infrastrukturcode überprüfen und feststellen, ob Sie diese Bedingung erfüllen oder nicht. Wenn keine Schichten erkennbar sind, sollten Sie sich Zeit nehmen, um ein wenig zu refaktorisieren.
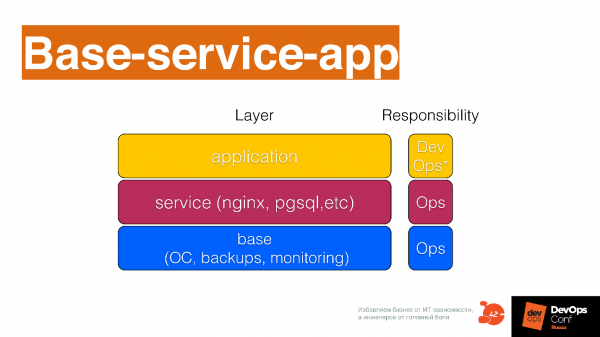
Basis-Schicht — das sind die Einstellungen für das Betriebssystem, Backups und andere Low-Level-Dinge, wie zum Beispiel, wie Kubernetes auf Basisniveau bereitgestellt wird.
Service-Ebene — das sind die Dienste, die Sie den Entwicklern anbieten: Logging als Dienst, Monitoring als Dienst, Datenbank als Dienst, Lastenausgleich als Dienst, Warteschlange als Dienst, Continuous Delivery als Dienst – viele Dienste, die verschiedene Teams der Entwicklung zur Verfügung stellen können. All dies muss in Ihrer Konfigurationsverwaltung als separate Module beschrieben werden.
Schicht, in der Anwendungen erstellt werden und beschrieben wird, wie sie auf den beiden vorhergehenden Schichten bereitgestellt werden.
Kontrollfragen
Haben Sie in Ihrem Unternehmen ein gemeinsames Infrastruktur-Repository? Überwachen Sie die technische Schuld in der Infrastruktur? Setzen Sie Entwicklungspraktiken im Infrastruktur-Repository ein? Ist Ihre Infrastruktur in Schichten unterteilt? Sie können sich an dem Schema Base-service-APP orientieren. Wie schwierig ist es, eine Änderung vorzunehmen?
Wenn Sie festgestellt haben, dass Änderungen eineinhalb Tage in Anspruch genommen haben, bedeutet das, dass Sie technische Schulden haben, mit denen Sie sich befassen sollten. Sie sind auf die Stolpersteine der technischen Schulden im Infrastrukturcode gestoßen. Ich erinnere mich an viele Geschichten, in denen man, um einen bestimmten CCTL zu ändern, die Hälfte des Infrastrukturcodes neu schreiben musste, weil Kreativität und der Wunsch, alles zu automatisieren, dazu geführt haben, dass überall alles zugeschraubt wurde, alle Handgriffe entfernt wurden und Refaktorisierung notwendig ist.
Kontinuierliche Lieferung
Lassen Sie uns das Debit mit dem Kredit abgleichen. Zunächst erscheint eine Beschreibung der Infrastruktur, die ziemlich einfach sein kann. Es ist nicht erforderlich, alles im Detail zu beschreiben, aber eine grundlegende Beschreibung ist erforderlich, damit Sie damit arbeiten können. Andernfalls ist es unklar, auf welcher Grundlage Sie die kontinuierliche Lieferung durchführen können. All diese Praktiken entfallen gleichzeitig, wenn Sie zu DevOps kommen, aber Sie müssen mit dem Verständnis beginnen, was Sie haben und wie Sie es verwalten. Dies ist die Praxis der Infrastruktur als Code.
Nachdem verständlich wurde, was Sie haben und wie Sie damit umgehen, beginnen Sie zu überlegen, wie der Entwicklercode so schnell wie möglich in die Produktion gebracht werden kann. Ich meine zusammen mit dem Entwickler - denken wir an das Problem der „Brunnen“, das heißt, es sind nicht einzelne Personen, die das erdenken, sondern das Team.
Als wir Ivan Evtuchovich das erste Buch sahen Jez Humble und die Gruppe von Autoren „Continuous Delivery“, das 2009 veröffentlicht wurde, dachten wir lange darüber nach, wie wir seinen Titel ins Russische übersetzen können. Wir wollten es als „Ständig liefern“ übersetzen, aber leider übersetzten wir es als „Kontinuierliche Lieferung“. Ich glaube, dass in unserem Titel etwas Russisches steckt, mit Schwung.
Ständig liefern bedeutet
Der Code, der im Produktrepository liegt, kann jederzeit in die Produktion gebracht werden. Er kann ungenutzt bleiben, ist aber immer bereit dafür. Daher schreiben Sie immer Code mit einem schwer zu erklärenden Gefühl der gewissenhaften Besorgnis im Hinterkopf. Dieses Gefühl tritt häufig auf, wenn Sie Infrastrukturcode ausrollen. Dieses Gefühl der Besorgnis sollte vorhanden sein - es fördert Denkprozesse, die es ermöglichen, Code ein wenig anders zu schreiben. Das sollte in den Regeln innerhalb der Entwicklung verankert werden.
Um ständig zu liefern, benötigen Sie ein Artefaktformat, das durch die Infrastrukturplattform geht. Wenn Sie unterschiedliche Formate von „Abfällen der Lebensführung“ durch die Infrastrukturplattform werfen, wird sie nicht mehr einheitlich, es wird schwierig, sie zu unterstützen, und es entsteht ein technisches Schuldenproblem. Das Artefaktformat muss angeglichen werden - das ist auch eine kollektive Aufgabe: Alle müssen sich zusammenfinden, ihre Köpfe zusammenstecken und dieses Format erarbeiten.
Das Artefakt verbessert sich kontinuierlich und ändert sich gemäß der Produktionsumgebung während des Durchlaufs durch die Lieferpipeline. Wenn das Artefakt durch die Pipeline bewegt wird, begegnet es ständig einigen unangenehmen Dingen, die dem ähneln, mit denen es im Produktionsumfeld konfrontiert wird. Während in der klassischen Softwareentwicklung dies ein Systemadministrator übernimmt, der das Deployment durchführt, geschieht dies im DevOps-Prozess kontinuierlich: Hier wurde es durch einige Tests gedreht, dort wurde es in einen Kubernetes-Cluster eingefügt, der mehr oder weniger der Produktionsumgebung ähnelt, und hier wurde plötzlich ein Lasttest gestartet.
Das erinnert an das Spiel Pac-Man – das Artefakt durchläuft eine Art Geschichte. Dabei ist es wichtig zu überwachen, ob der Code tatsächlich die Geschichte durchläuft und ob sie mit Ihrer Produktionsumgebung verbunden ist. Geschichten aus der Produktion können in den Continuous Delivery-Prozess integriert werden: Es gab zum Beispiel einen Vorfall, als etwas ausgefallen ist, also lassen Sie uns dieses Szenario einfach in das System programmieren. Jedes Mal wird der Code auch dieses Szenario durchlaufen, und Sie werden das nächste Mal nicht mit diesem Problem konfrontiert. Sie werden viel früher davon erfahren, bevor es zu Ihrem Kunden kommt.
Verschiedene Deployment-Strategien. Zum Beispiel verwenden Sie A/B-Tests oder Canary-Deployments, um den Code auf verschiedene Arten bei unterschiedlichen Kunden zu testen, Informationen darüber zu erhalten, wie der Code funktioniert, und das viel früher, als wenn er an 100 Millionen Benutzer freigegeben wird.
„Stetige Lieferung“ sieht so aus.
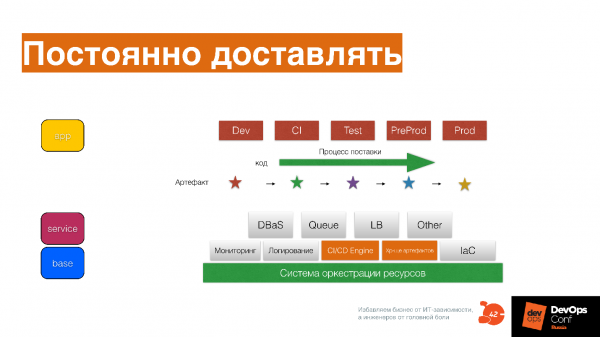
Der Prozess der Lieferung Dev, CI, Test, PreProd, Prod ist keine separate Umgebung, sondern Stufen oder Stationen mit nicht brennbaren Summen, durch die Ihr Artefakt läuft.
Wenn Sie Code für Infrastruktur haben, der als Basisdienst-App beschrieben ist, hilft er nicht alle Szenarien zu vergessen,, und sie ebenfalls in Form von Code für dieses Artefakt zu dokumentieren, das Artefakt voranzubringen und es unterwegs zu ändern.
Fragen zur Selbstüberprüfung
Dauert es von der Beschreibung des Features bis zur Veröffentlichung in der Produktion in 95 % der Fälle weniger als eine Woche? Steigt die Qualität des Artefakts in jeder Phase der Pipeline? Gibt es eine Geschichte, durch die es läuft? Verwenden Sie verschiedene Deployment-Strategien?
Wenn alle Antworten ja sind, dann sind Sie unglaublich toll! Schreiben Sie Ihre Antworten in die Kommentare – ich würde mich freuen).
Feedback
Dies ist die schwierigste Praxis von allen. Auf der Konferenz DevOpsConf war ein Kollege von Infobip, der darüber sprach, etwas verwirrt in seinen Worten, denn es ist wirklich eine sehr komplexe Praxis, bei der man alles überwachen muss!
Vor langer Zeit, als ich bei Qik arbeitete und wir festgestellt haben, dass wir alles überwachen müssen. Wir haben das getan und in Zabbix hatten wir 150.000 Items, die ständig überwacht werden. Das war beängstigend, der technische Direktor hat sich nur am Kopf gekratzt:
— Leute, warum quält ihr den Server mit undefinierbaren Dingen?
Aber dann geschah ein Vorfall, der zeigte, dass dies tatsächlich eine sehr coole Strategie ist.
Einer der Dienste begann ständig abzustürzen. Interessanterweise ist er anfangs nicht abgestürzt, da dort kein Code hinzugefügt wurde, denn es war ein Basisbroker, in dem praktisch keine Business-Funktionalitäten waren – er übertrug einfach Nachrichten zwischen einzelnen Diensten. Der Dienst hatte sich vier Monate lang nicht geändert und begann plötzlich mit einem „Segmentation fault“ abzustürzen.
Wir waren schockiert, öffneten unsere Grafiken in Zabbix, und es stellte sich heraus, dass vor anderthalb Wochen das Verhalten der Anfragen im API-Dienst, der diesen Broker verwendet, sich stark geändert hatte. Danach sahen wir, dass sich die Häufigkeit des Sendens eines bestimmten Nachrichtentyps geändert hatte. Später haben wir festgestellt, dass es sich um die Android-Clients handelte. Wir fragten:
— Leute, was ist vor anderthalb Wochen passiert?
Als Antwort erhielten wir eine interessante Geschichte, dass sie das UI umgestaltet hatten. Kaum jemand würde sofort sagen, dass er die HTTP-Bibliothek gewechselt hat. Für Android-Clients ist es wie wenn man die Seife im Bad wechselt – sie erinnern sich einfach nicht daran. Letztendlich haben wir nach 40 Minuten Gespräch herausgefunden, dass sie tatsächlich die HTTP-Bibliothek gewechselt hatten und sich die Standard-Timings geändert hatten. Das führte dazu, dass sich das Verhalten des Traffics auf dem API-Server änderte, was zu der Situation führte, die eine Kollision innerhalb des Brokers verursachte, und er begann abzustürzen.
Ohne tiefgehende Überwachung ist das überhaupt nicht zu erkennen.. Wenn es in der Organisation jedoch noch das Problem der "Brunnen" gibt, bei dem jeder die Verantwortung auf den anderen schiebt, kann das jahrelang bestehen bleiben. Sie starten einfach den Server neu, weil das Problem nicht gelöst werden kann. Wenn Sie alle Ereignisse, die Sie haben, überwachen, verfolgen und analysieren und das Monitoring als ein Test-Tool verwenden – indem Sie Code schreiben und sofort angeben, wie er überwacht werden soll, auch in Form von Code (wir haben bereits Infrastruktur als Code), wird alles so klar wie der Handballen. Sogar solch komplexe Probleme sind leicht nachzuvollziehen.
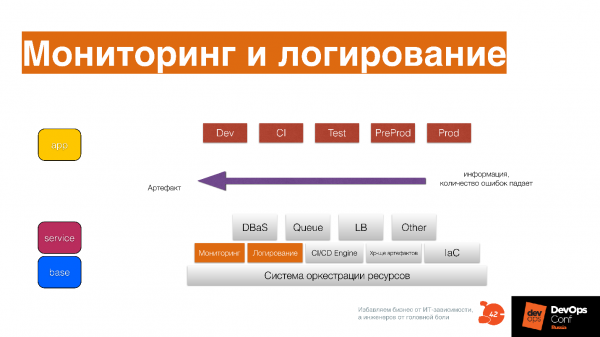
Sammeln Sie alle Informationen darüber, was mit dem Artefakt in jeder Phase des Lieferprozesses geschieht – nicht in der Produktion.
Laden Sie das Monitoring in CI, und dort werden bereits einige grundlegende Dinge sichtbar sein. Außerdem werden Sie diese auch im Test, im PredProd und im Lasttest sehen. Sammeln Sie Informationen in allen Phasen, nicht nur Metriken, Statistiken, sondern auch Logs: wie die Anwendung ausgerollt wurde, Anomalien – sammeln Sie alles.
Andernfalls wird es schwierig sein, sich zurechtzufinden. Ich habe bereits gesagt, dass DevOps eine größere Komplexität mit sich bringt. Um mit dieser Komplexität umzugehen, benötigt man eine angemessene Analytik..
Fragen zur Selbstkontrolle
Ist Ihr Monitoring und Logging ein Entwicklungswerkzeug für Sie? Denken Ihre Entwickler, einschließlich Ihnen, beim Schreiben von Code darüber nach, wie er überwacht werden kann?
Erfahren Sie von Problemen durch Kunden? Verstehen Sie den Kunden besser durch das Monitoring und Logging? Verstehen Sie das System besser durch das Monitoring und Logging? Ändern Sie das System einfach, weil Sie gesehen haben, dass der Trend im System steigt und Sie verstehen, dass in 3 Wochen alles zusammenbricht?
Wenn Sie diese drei Komponenten haben, können Sie über die infrastrukturelle Plattform in Ihrem Unternehmen nachdenken.
Infrastrukturelle Plattform
Es geht nicht darum, dass dies eine Sammlung von voneinander unabhängigen Werkzeugen ist, die in jedem Unternehmen vorhanden sind.
Der Sinn einer infrastrukturellen Plattform besteht darin, dass alle Teams diese Werkzeuge nutzen und gemeinsam weiterentwickeln.
Es ist klar, dass es separate Teams gibt, die für die Entwicklung einzelner Teile der infrastrukturellen Plattform verantwortlich sind. Aber die Verantwortung für die Entwicklung, Funktionsfähigkeit und Förderung der infrastrukturellen Plattform trägt jeder Ingenieur. Auf interner Ebene wird dies zu einem gemeinsamen Werkzeug..
Alle Teams entwickeln eine Infrastrukturplattform und behandeln sie sorgfältig wie ihre eigene IDE.. In Ihrer IDE installieren Sie verschiedene Plugins, um alles schön und schnell zu gestalten, und konfigurieren Tastenkombinationen. Wenn Sie Sublime, Atom oder Visual Studio Code öffnen, fallen sofort Fehler im Code auf und Sie merken, dass es überhaupt unmöglich ist zu arbeiten. Sofort wird Ihnen schlecht und Sie laufen los, um Ihre IDE zu reparieren.
Behandeln Sie Ihre Infrastrukturplattform genauso. Wenn Sie merken, dass etwas nicht stimmt, stellen Sie eine Anfrage, wenn Sie es nicht selbst reparieren können. Wenn es jedoch etwas Einfaches ist – beheben Sie es selbst, senden Sie eine Pull-Request – die Kollegen prüfen, fügen hinzu. Dies ist ein etwas anderer Ansatz im Ingenieurwesen für den Kopf des Entwicklers.
Die Infrastrukturplattform sorgt dafür, dass Artefakte von der Entwicklung zum Kunden mit ständig steigender Qualität übertragen werden.. In der IP ist eine Reihe von Geschichten programmiert, die mit dem Code in Produktion passieren. Über die Jahre der Entwicklung werden diese Geschichten sehr zahlreich, einige davon sind einzigartig und beziehen sich nur auf Sie – sie sind nicht googlbar.
In diesem Moment wird die Infrastrukturplattform zu Ihrem Wettbewerbsvorteil., weil darin Dinge eingebaut sind, die kein Werkzeug des Wettbewerbers hat. Je tiefer Ihre IP ist, desto größer ist Ihr Wettbewerbsvorteil in Bezug auf die Time-to-market. Hier tritt das Problem des Vendor Lock-inauf: Sie können sich eine fremde Plattform nehmen, aber wenn Sie auf die Erfahrung anderer zurückgreifen, werden Sie nicht verstehen, inwieweit diese relevant für Sie ist. Ja, nicht jedes Unternehmen kann eine Plattform wie Amazon aufbauen. Das ist eine schwierige Grenze, wo die Erfahrung des Unternehmens für seine Position auf dem Markt relevant ist, und den Vendor Lock-in sollte man dort nicht herunterlassen. Darüber muss man auch nachdenken.
Diagramm
Das ist das grundlegende Schema einer Infrastrukturplattform, das Ihnen helfen wird, alle Praktiken und Prozesse in einem DevOps-Unternehmen zu etablieren.
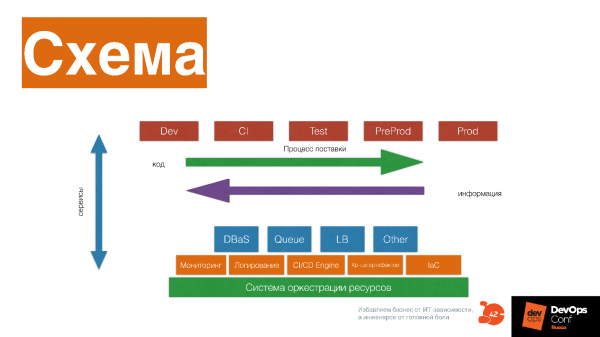
Lassen Sie uns betrachten, woraus sie besteht.
Ein System zur Orchestrierung von Ressourcen, das CPU, Speicher, Festplatten für Anwendungen und andere Dienste bereitstellt. Darüber hinaus gibt es niedrigere Dienste: Überwachung, Protokollierung, CI/CD-Engine, Artefakt-Speicher, Infrastruktur als Code-Systeme.
Höhere Dienste.: Datenbank als Dienst, Warteschlangen als Dienst, Load Balancer als Dienst, Bildgrößenänderung als Dienst, Big Data Fabrik als Dienst. Darüber hinaus — pipeline, die ständig modifizierten Code an Ihren Kunden liefert.
Sie erhalten Informationen darüber, wie Ihre Software beim Kunden funktioniert, ändern, liefern diesen Code erneut, erhalten Informationen — und entwickeln damit ständig sowohl die Infrastrukturplattform als auch Ihre Software weiter.
In dem Diagramm besteht die Delivery-Pipeline aus mehreren Phasen. Aber das ist ein grundlegendes Schema, das als Beispiel dient — es muss nicht eins zu eins wiederholt werden. Die Phasen interagieren mit Diensten, als wären es Dienste — jeder Baustein der Plattform erzählt seine eigene Geschichte: wie Ressourcen zugewiesen werden, wie die Anwendung gestartet wird, mit Ressourcen arbeitet, überwacht wird und sich ändert.
Es ist wichtig zu verstehen, dass jeder Teil der Plattform eine Geschichte erzählt, und sich zu fragen — welche Geschichte erzählt dieser Baustein, vielleicht sollte man ihn wegwerfen und durch einen externen Dienst ersetzen. Zum Beispiel, könnte man anstelle des Bausteins Okmeter verwenden? Möglicherweise haben die Leute diese Expertise bereits viel mehr entwickelt als wir. Aber vielleicht auch nicht — vielleicht haben wir eine einzigartige Expertise, und wir müssen Prometheus einsetzen und das weiterentwickeln.
Plattformerstellung
Das ist ein komplexer Kommunikationsprozess. Wenn Sie grundlegende Praktiken haben, initiieren Sie die Kommunikation zwischen verschiedenen Ingenieuren und Spezialisten, die Anforderungen und Standards entwickeln und diese ständig für verschiedene Werkzeuge und Ansätze anpassen. Hier ist die Kultur wichtig, die in DevOps vorhanden ist.
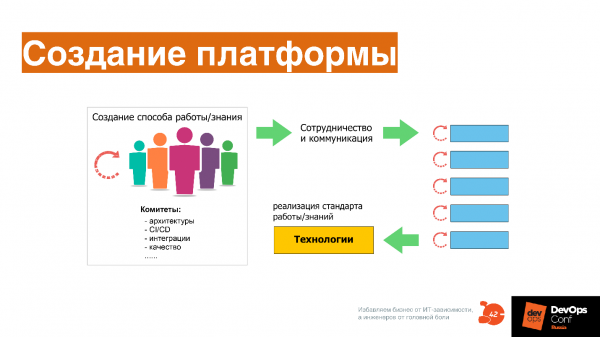
Mit der Kultur ist alles sehr einfach — es sind Zusammenarbeit und Kommunikation, das heißt, der Wunsch, gemeinsam im selben Bereich zu arbeiten, der Wunsch, ein Werkzeug gemeinsam zu beherrschen. Es gibt hier keine Raketenwissenschaft — alles ist sehr einfach, banal. Zum Beispiel leben wir alle im Treppenhaus und halten es sauber — so sieht diese Kultur aus.
Und wie sieht es bei Ihnen aus?
Wieder Fragen, die Sie sich stellen können.
Wurde die Infrastrukturplattform выделена? Wer ist für ihre Entwicklung verantwortlich? Verstehen Sie die Wettbewerbsvorteile Ihrer Infrastrukturplattform?
Diese Fragen sollte man sich ständig stellen. Wenn etwas an externe Dienste ausgelagert werden kann, sollte man es auslagern. Wenn ein externer Dienst beginnt, Ihre Bewegungen zu blockieren, muss man ein System in sich selbst aufbauen.
Also, DevOps...
... es ist ein komplexes System, das Folgendes enthalten sollte:
- Ein digitales Produkt.
- Geschäftsmodelle, die dieses digitale Produkt weiterentwickeln.
- Entwicklungsteams, die Code schreiben.
- Continuous Delivery-Praktiken.
- Plattformen als Dienst.
- Infrastruktur als Dienst.
- Infrastruktur als Code.
- Einzelne Praktiken zur Sicherstellung der Zuverlässigkeit, die in DevOps verankert sind.
- Eine Feedback-Praxis, die all dies beschreibt.
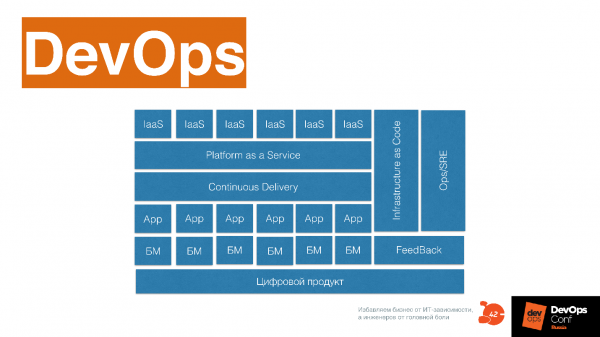
Man kann dieses Schema nutzen und darin das markieren, was es in Ihrem Unternehmen bereits in irgendeiner Form gibt: hat sich entwickelt oder muss noch entwickelt werden.
In ein paar Wochen findet statt . im Rahmen von RIT++. Kommen Sie zur Konferenz, wo Sie viele spannende Vorträge über Continuous Delivery, Infrastruktur als Code und DevOps-Transformation erwarten. , der letzte Stichtag für die Preise ist der 20. Mai
Quelle: habr.com
