

Ich heiße Sergey, ich komme von der Firma ITSumma und ich möchte Ihnen erzählen, wie wir an die Sicherung in Kubernetes herangehen. In letzter Zeit beschäftige ich mich viel mit Beratung im Bereich der Implementierung verschiedener DevOps-Lösungen für unterschiedliche Teams, insbesondere arbeite ich eng an Projekten mit K8s. Auf der Uptime Day 4-Konferenz, die sich mit der Sicherung in komplexen Architekturen befasste, hielt ich einen Vortrag über die Sicherung von "Cubes" und hier ist eine freie Zusammenfassung davon. Ich möchte nur vorweg warnen, dass es sich nicht um eine unmittelbare Handlungsanleitung handelt, sondern eher um eine Zusammenfassung von Überlegungen zu diesem Thema.
Im Grunde sind Überwachung und Sicherung zwei Hauptinstrumente zur Steigerung der Ausfallsicherheit eines Projekts. Aber in Kubernetes wird alles selbst balanciert, sagen Sie, alles wird automatisch skaliert, und wenn etwas passiert – wird es von selbst hochgefahren... Das bedeutet, dass ich bei einer ersten oberflächlichen Untersuchung des Themas bei der Frage, wie jeder an die Sicherung von K8s herangeht, die Antwort "Wozu?" aus dem Internet erhielt. Viele glauben, dass Kubernetes eine magische Sache ist, die alle Infrastrukturprobleme löst und dafür sorgt, dass ein Projekt niemals ausfällt. Aber... die Welt ist nicht das, was sie scheint.
Wie sind wir früher an den Prozess der Sicherung herangegangen? Wir hatten identische Plattformen für die Bereitstellung – entweder virtuelle Maschinen oder physische Server, auf die wir drei grundlegende Praktiken anwendeten:
- Synchronisation von Code und Statischen Inhalten
- Synchronisation von Konfigurationen
- Datenbank-Replikation
Und voilà: jederzeit schalten wir auf die Sicherungsplattform um, alle sind glücklich, wir stehen auf und gehen auseinander.
Was wird uns angeboten, um die ständige Verfügbarkeit unserer Kubernetes-Anwendung zu erhöhen? Das erste, was die inoffizielle Dokumentation erwähnt, ist, eine Vielzahl von Maschinen einzusetzen und viele Master-Instanzen zu erstellen – deren Anzahl muss die Bedingungen für das Erreichen eines Quorums im Cluster erfüllen, und auf jedem Master sollte etcd, API, MC, Scheduler... aktiv sein. Und es scheint, als ob alles wunderbar wäre: Wenn mehrere Arbeitsknoten oder Master ausfallen, wird unser Cluster neu balanciert und die Anwendung bleibt aktiv. Es sieht wieder einmal nach Magie aus! Aber oft befindet sich unser Cluster in einem einzigen Rechenzentrum, und das kann bestimmte Fragen aufwerfen. Was, wenn ein Bagger kommt und ein Kabel ausgräbt, ein Blitz einschlägt oder eine universelle Flut kommt? Alles ist dann verloren, unser Cluster ist nicht mehr da. Wie gehen wir mit der Hochverfügbarkeit unter Berücksichtigung dieser Problematik um?
Zunächst einmal müssen Sie einen weiteren Cluster im Hot-Standby haben, auf den Sie jederzeit umschalten können. Dabei sollten aus Sicht von Kubernetes die Infrastrukturen vollständig identisch sein. Das bedeutet, dass alle nicht standardmäßigen Plugins für die Arbeit mit dem Dateisystem, individuelle Lösungen für den Ingress usw. auf Ihren beiden (oder drei, oder zehn – hier kommt es darauf an, wie viel Geld und Kapazität die Admins haben) Clustern identisch sein müssen. Es ist wichtig, zwei Sets von Anwendungen (Deployments, StatefulSets, DaemonSets, CronJobs usw.) klar zu definieren: Welche davon können dauerhaft im Standby betrieben werden und welche sollten besser erst beim tatsächlichen Umschalten gestartet werden.
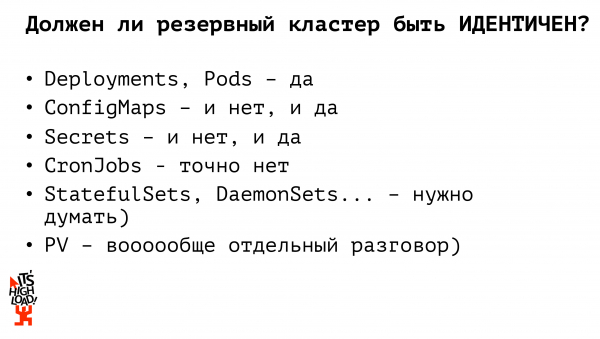
Sollte unser Backup-Cluster also vollständig identisch mit unserem Produktionscluster sein? Nein. Während wir früher in monolithischen Projekten mit physischer Infrastruktur weitgehend identische Umgebungen aufrechterhielten, sollte das im Zusammenhang mit Kubernetes meiner Meinung nach nicht erforderlich sein. Lassen Sie uns erörtern, warum.
Zum Beispiel beginnen wir mit den grundlegenden Kubernetes-Entitäten – Deployments – diese sollten identisch sein. Apps sollten gestartet werden, die jederzeit die Verarbeitung des Traffics übernehmen können und es unserem Projekt ermöglichen, weiterzumachen. Wenn wir über Konfigurationsdateien sprechen, müssen wir prüfen, ob sie identisch sein sollten oder nicht. Das heißt, wenn wir, kluge Leute, keine verbotenen Substanzen konsumieren und die Datenbank nicht in K8s halten, sollten unsere ConfigMaps die Zugangseinstellungen zur Produktionsdatenbank enthalten (der Prozess der Sicherung dieser Datenbank erfolgt separat). Um also den Zugang zur Backup-Datenbank zu gewährleisten, müssen wir eine separate Konfigurationsdatei (ConfigMap) haben. Das Gleiche gilt für Secrets: Passwörter für den Zugang zur Datenbank, API-Keys; zu jedem Zeitpunkt kann entweder das Produktionssecret oder das Backup secret aktiv sein. Insgesamt haben wir also bereits zwei Kubernetes-Entitäten, deren Backup-Versionen nicht identisch mit den Produktionsversionen sein dürfen. Die nächste Entität, auf die wir eingehen sollten, ist der CronJob. CronJobs in der Backup-Umgebung dürfen in keinem Fall identisch mit dem Satz der CronJobs im Produktionscluster sein! Wenn wir einen Backup-Cluster hochfahren und ihn vollständig mit allen aktivierten CronJobs starten, erhalten die Leute beispielsweise gleichzeitig zwei E-Mails statt einer. Oder eine Daten-Synchronisation mit externen Quellen wird zweimal durchgeführt, und entsprechend beginnen wir zu leiden, zu weinen, zu schreien und uns zu streiten.
Wie schlagen uns die Leute aus dem Internet vor, den Backup-Cluster zu organisieren? Die zweitbeliebteste Antwort nach "Warum?" ist die Verwendung von Kubernetes Federation.
Was ist das? Das ist, sagen wir mal, ein großer Meta-Cluster. Wenn wir die Architektur von Kubernetes betrachten – wo wir einen Master und mehrere Nodes haben – dann haben wir in Bezug auf die Föderation ebenfalls einen Master und mehrere Nodes, wobei jede Node ein eigener Cluster ist. Das bedeutet, wir arbeiten mit den gleichen Entitäten und mit den gleichen Primitiven, wie bei einem einzelnen Kubernetes, nur dass wir nicht mit unseren physischen Maschinen, sondern mit ganzen Clustern arbeiten. Innerhalb der Föderation findet eine vollständige Synchronisierung der föderativen Ressourcen von den Eltern zu den Nachkommen statt. Zum Beispiel, wenn wir ein Deployment über die Föderation starten – wird es in jedem unserer untergeordneten Cluster bereitgestellt. Wenn wir einen beliebigen ConfigMap oder Secret nehmen und ihn über die Föderation ausrollen – wird es sich über alle unsere untergeordneten Cluster verteilen; dabei ermöglicht die Föderation, unsere Ressourcen bei den Nachkommen zu individualisieren. Das heißt, wir nehmen einen beliebigen ConfigMap, deployen ihn über die Föderation und wenn wir dann etwas an bestimmten Clustern anpassen müssen, gehen wir in den spezifischen Cluster und dieses Änderung wird nicht synchronisiert.
Kubernetes Federation ist ein relativ neues Werkzeug, das jedoch nicht den vollständigen Satz an Ressourcen unterstützt, den K8s selbst bereitstellt: Zum Zeitpunkt der Veröffentlichung einer der ersten Versionen der Dokumentation wurde nur die Unterstützung von ConfigMaps, Deployment mit ReplicaSet und Ingress erwähnt. Secrets wurden nicht unterstützt, und die Arbeit mit Volumes war ebenfalls nicht möglich. Ein zu begrenzter Satz. Besonders wenn wir gerne experimentieren, zum Beispiel über Custom Resource Definitions unsere eigenen Ressourcen an Kubernetes weitergeben möchten, können wir diese nicht in die Federation einfügen. Es ist also wie… eine sehr ähnliche, aber dennoch ungenaue Lösung, die uns manchmal dazu bringt, uns selbst ins Bein zu schießen. Auf der anderen Seite ermöglicht die Federation eine flexible Verwaltung unseres ReplicaSets. Zum Beispiel möchten wir, dass 10 Replikate unserer Anwendung laufen, und standardmäßig wird die Federation diese Zahl proportional auf die Anzahl der Cluster aufteilen. Und das Ganze lässt sich auch konfigurieren! Man kann angeben, dass auf dem Produktionscluster 6 Replikate unserer Anwendung gehalten werden sollen, während auf dem Backup-Cluster, zur Ressourcenschonung oder für unsere eigenen Experimentierfreuden, nur 4 Replikate unserer Anwendung laufen sollen. Das ist ebenfalls ziemlich praktisch. Aber mit der Federation müssen wir neue Lösungen einsetzen, etwas im laufenden Betrieb deployen und uns gezwungen sehen, ein wenig mehr nachzudenken…
Kann man den Prozess der Kubernetes-Reservierung einfacher angehen? Welche Werkzeuge haben wir überhaupt zur Verfügung?
Zunächst einmal haben wir immer ein gewisses CI/CD-System, das bedeutet, wir gehen nicht manuell auf die Server und führen create/apply aus. Das System generiert YAML-Dateien für unsere Container.
Zweitens gibt es mehrere Cluster, und wir haben entweder ein oder mehrere (wenn wir schlau sind) Registries, die wir ebenfalls reserviert haben. Und es gibt ein wunderbares Tool namens kubectl, das mit mehreren Clustern gleichzeitig arbeiten kann.
Also: Meiner Meinung nach ist die einfachste und verlässlichste Lösung für den Aufbau eines Backup-Clusters ein primitiver paralleler Deployment-Prozess. Es gibt eine Art Pipeline im CI/CD-System; zunächst bauen wir unsere Container, testen sie und rollen die Anwendungen mit kubectl auf mehrere unabhängige Cluster aus. Wir können gleichzeitig Releases auf mehrere Cluster bereitstellen. Dementsprechend lösen wir die Bereitstellung der Konfigurationen auch in diesem Schritt. Man kann im Voraus einen Satz von Konfigurationen für unser Produktionscluster und einen Satz von Konfigurationen für das Backup-Cluster festlegen und im CI/CD-System die Produktionsumgebung im Produktionscluster und die Backup-Umgebung im Backup-Cluster bereitstellen. Im Vergleich zur Föderation muss man nach der Bestimmung der föderativen Ressource nicht zu jedem untergeordneten Cluster gehen und etwas neu definieren. Wir haben das im Voraus erledigt. Wie großartig wir sind.
Aber… es gibt… ich habe schon geschrieben, es gibt den "Ursprung allen Übels", aber tatsächlich sind es zwei. Erstens, das Dateisystem. Es gibt irgendein PV, oder wir nutzen einen externen Speicher. Wenn wir Dateien innerhalb des Clusters speichern, müssen wir nach den alten Praktiken vorgehen, die aus der Zeit der physischen Infrastrukturen stammen: zum Beispiel mit lsync synchronisieren. Oder mit einem anderen, von Ihnen bevorzugten Hack. Wir rollen alles auf andere Maschinen aus und leben weiter.
Zweitens und tatsächlich der wichtigere Stolperstein — die Datenbank. Wenn wir kluge Menschen sind und die Datenbank nicht in Kubernetes halten, dann ist der Prozess der Datensicherung nach dem alten Schema — Master-Slave-Replikation, dann umschalten, die Replikation nachholen und gut leben. Aber wenn wir unsere DB innerhalb des Clusters halten, gibt es viele fertige Lösungen zur Organisation derselben Master-Slave-Replikation, viele Lösungen, um eine DB innerhalb von Kubernetes zu betreiben.
Über die Sicherung von Datenbanken wurden bereits Milliarden von Vorträgen gehalten und Milliarden Artikel geschrieben, hier braucht es eigentlich nichts Neues. Insgesamt, folgen Sie Ihrem Traum, leben Sie wie Sie möchten, erfinden Sie sich auch irgendwelche komplexen Hacks, aber denken Sie unbedingt darüber nach, wie Sie all das sichern werden.
Und jetzt, wie der Prozess des Wechsels zu einer Backup-Plattform im Falle eines Brandes grundsätzlich bei uns ablaufen wird. Erstens deployen wir parallel stateless Anwendungen. Sie beeinflussen nicht die Geschäftslogik unserer Anwendungen, unseres Projekts, wir können ständig zwei Sätze von laufenden Applikationen halten und sie können anfangen, Traffic zu empfangen. Es ist sehr wichtig, im Prozess des Wechsels zu einer Backup-Plattform unbedingt zu prüfen — müssen die Konfigurationen neu definiert werden? Zum Beispiel haben wir ein Produktionscluster in Kubernetes, ein Backup-Cluster in Kubernetes, eine externe Master-Datenbank, eine Backup-Master-Datenbank. Wir haben vier Optionen, wie diese Anwendungen in der Produktion beginnen können, miteinander zu interagieren. Die Datenbank kann umschalten, und es stellt sich heraus, dass wir den Traffic im Produktionscluster auf die neue Datenbank umschalten müssen, oder unser Cluster kann ausfallen — und wir sind auf die Backup-Plattform umgestiegen, arbeiten aber weiterhin mit der Produktionsdatenbank, und die dritte Option ist, wenn dies ausgefallen ist und das ausgefallen ist, und wir beide Anwendungen umschalten, die Konfiguration neu definieren, damit die neuen Anwendungen bereits mit der neuen Datenbank arbeiten.
Was kann man also aus alldem ableiten?
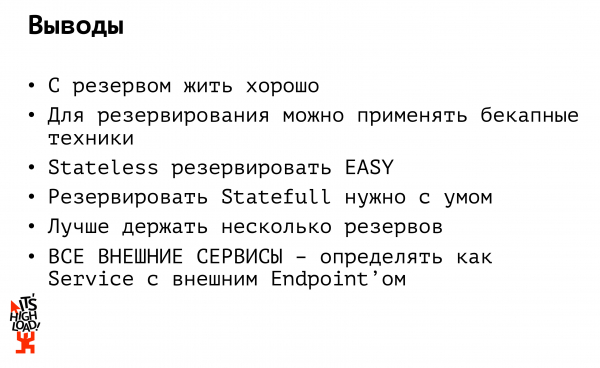
Erste Erkenntnis: Mit einem Backup lässt es sich gut leben. Aber es ist teuer. Idealerweise sollte man nicht nur mit einem Backup leben. Im Idealfall sollte man mit mehreren Backups leben. Erstens sollte das Backup mindestens nicht in einem Rechenzentrum sein und zweitens mindestens bei einem anderen Anbieter. Oft gab es das — und das habe ich persönlich erlebt. Einige Projekte kann ich leider nicht nennen, als genau dann der Brand im Rechenzentrum passierte… Ich dachte: Wir schalten auf das Backup um! Und die Backup-Server standen in demselben Rack…
Oder stellen Sie sich vor, dass Amazon in Russland gesperrt wurde (das kam vor). Und alles: Was nützt es, dass unser Backup bei einem anderen Amazon liegt? Es ist auch nicht erreichbar. Deshalb wiederhole ich: Halten Sie das Backup mindestens in einem anderen Rechenzentrum, und idealerweise — bei einem anderen Anbieter.
Zweite Ausgabe: Wenn Sie in Kubernetes eine Anwendung haben, die mit externen Quellen kommuniziert (das kann eine Datenbank oder eine externe API sein), definieren Sie sie unbedingt als Dienst mit einem externen Endpunkt, damit Sie beim Wechseln nicht 15 Ihrer Anwendungen neu bereitstellen müssen, die auf dieselbe Datenbank zugreifen. Definieren Sie die Datenbank als separaten Dienst und greifen Sie auf sie zu, als ob sie sich innerhalb des Clusters befände: Wenn Ihre Datenbank abstürzt, ändern Sie an einer Stelle die IP und leben weiterhin glücklich.
Und zum Schluss: Ich liebe "Kubernetes" genauso wie die Experimente damit. Ich teile auch gerne die Ergebnisse dieser Experimente und meine persönlichen Erfahrungen. Deshalb habe ich eine Reihe von Webinaren über K8s aufgezeichnet, willkommen auf für weitere Informationen.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish