

Vorgeschichte
Es kam dazu, dass der Server von einem Ransomware-Virus angegriffen wurde, der "zufälligerweise" teilweise die .ibd-Dateien (Rohdaten-Dateien von InnoDB-Tabellen) unberührt ließ, aber vollständig die .fpm-Dateien (Strukturdaten) verschlüsselte. Dabei konnte die .idb in folgende Kategorien unterteilt werden:
- die über Standardmittel und Guides wiederhergestellt werden können. Für solche Fälle gibt es hervorragende ;
- teilweise verschlüsselte Tabellen. Hauptsächlich handelt es sich dabei um große Tabellen, für die (wie ich verstanden habe) die Angreifer nicht genügend RAM für die vollständige Verschlüsselung hatten;
- und komplett verschlüsselte Tabellen, die nicht wiederhergestellt werden können.
Es gelang zu bestimmen, zu welchem der Varianten die Tabellen gehören, indem einfach die Datei in einem beliebigen Texteditor mit der benötigten Kodierung (in meinem Fall UTF8) geöffnet und nach textlichen Feldern gesucht wurde, beispielsweise:
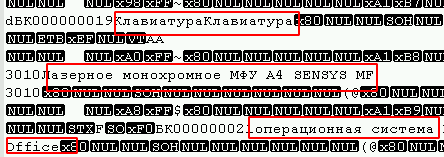
Außerdem kann man am Anfang der Datei eine große Anzahl von Null-Bytes beobachten, wobei Viren, die einen Blockverschlüsselungsalgorithmus verwenden (am weitesten verbreitet), in der Regel auch von ihnen betroffen sind.

In meinem Fall hinterließen die Angreifer am Ende jeder verschlüsselten Datei eine Zeichenfolge aus 4 Bytes (1, 0, 0, 0), was die Aufgabe vereinfachte. Um nicht infizierte Dateien zu finden, genügte dieses Skript:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
So konnte ich die Dateien des ersten Typs finden. Der zweite Typ erfordert eine lange manuelle Arbeit, aber die gefundenen Dateien waren bereits ausreichend. Alles wäre gut, aber es ist wichtig zu wissen die absolut genaue Struktur und (wie es der Zufall will) trat der Fall auf, dass ich mit einer häufig wechselnden Tabelle arbeiten musste. Niemand erinnerte sich, ob sich der Feldtyp geändert hatte oder ob eine neue Spalte hinzugefügt wurde.
Leider konnten die Davy Jones' Locker in diesem Fall nicht helfen, weshalb dieser Artikel verfasst wird.
Kommen wir zum Wesentlichen.
Es gibt eine Tabellenstruktur, die drei Monate alt ist und nicht mit der aktuellen übereinstimmt (möglicherweise nur in einem Feld, vielleicht auch mehr). Die Struktur der Tabelle lautet:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME,
    `description` TEXT,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME,
    `date_finish` DATETIME,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME,
    `sendstatus` TINYINT (4)
);
Dabei muss man entnehmen:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Für die Wiederherstellung wird eine byteweise Analyse der .ibd-Datei verwendet, gefolgt von der Umwandlung in ein lesbareres Format. Da es zur Auffindung der benötigten Informationen ausreicht, solche Datentypen wie int und datetime zu analysieren, werden in diesem Artikel nur diese beschrieben, jedoch werde ich gelegentlich auch auf andere Datentypen verweisen, die in ähnlichen Situationen hilfreich sein können.
Problem 1: In den Feldern mit den Typen DATETIME und TEXT gab es NULL-Werte, und diese werden in der Datei einfach übersprungen, weshalb es in meinem Fall nicht möglich war, die Struktur zur Wiederherstellung zu bestimmen. In den neuen Spalten war der Standardwert null, und Teile der Transaktion könnten aufgrund der Einstellung innodb_flush_log_at_trx_commit = 0 verloren gegangen sein, daher wäre es erforderlich gewesen, zusätzliche Zeit für die Bestimmung der Struktur aufzuwenden.
Problem 2: Es sollte berücksichtigt werden, dass durch DELETE gelöschte Zeilen dennoch in der ibd-Datei vorhanden sind, aber beim ALTER TABLE ihre Struktur nicht aktualisiert wird. Infolgedessen kann die Datenstruktur vom Anfang der Datei bis zu ihrem Ende variieren. Wenn Sie häufig OPTIMIZE TABLE verwenden, dürften Sie mit einem solchen Problem kaum konfrontiert werden.
Bitte beachten Sie, die Version des DBMS beeinflusst die Art und Weise, wie Daten gespeichert werden, und dieses Beispiel könnte für andere Hauptversionen nicht funktionieren. In meinem Fall wurde die Windows-Version von MariaDB 10.1.24 verwendet. Auch wenn Sie in MariaDB mit InnoDB-Tabellen arbeiten, sind sie tatsächlich , was die Anwendbarkeit der Methode mit InnoDB MySQL ausschließt.
Dateianalyse
In Python zeigt der Datentyp die Daten in Unicode anstelle der üblichen Zahlenanordnung. Auch wenn die Datei auf diese Weise betrachtet werden kann, ist es zur Vereinfachung möglich, die Bytes in numerische Werte umzuwandeln, indem man das Byte-Array in ein gewöhnliches Array (list(example_byte_array)) umwandelt. In jedem Fall werden beide Methoden zur Analyse nützlich sein.
Nach der Ansicht mehrerer ibd-Dateien können folgende gefunden werden:
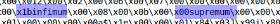
Wenn man die Datei nach diesen Schlüsselwörtern unterteilt, erhält man überwiegend gleichmäßige Datenblöcke. Wir werden infimum als Trennzeichen verwenden.
table = table.split("infimum".encode())Eine interessante Beobachtung: Für Tabellen mit einer kleinen Datenmenge gibt es zwischen infimum und supremum einen Zeiger auf die Anzahl der Zeilen im Block.
 — Testtabelle mit 1 Zeile
 — Testtabelle mit 2 Zeilen
Das Array von Zeichenfolgen table[0] kann übersprungen werden. Bei der Durchsicht konnte ich keine rohen Datensätze der Tabellen entdecken. Wahrscheinlich dient dieser Block der Speicherung von Indizes und Schlüsseln.
Beginnend mit table[1] und umgewandelt in ein numerisches Array, lassen sich bereits einige Muster erkennen, nämlich:
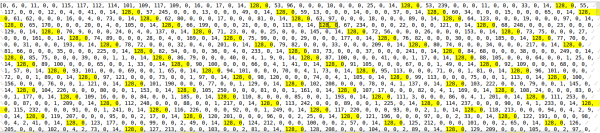
Dies sind int-Werte, die in der Zeichenkette gespeichert sind. Das erste Byte zeigt an, ob die Zahl positiv oder negativ ist. In meinem Fall sind alle Zahlen positiv. Aus den restlichen 3 Bytes kann die Zahl mit folgender Funktion bestimmt werden. Skript:
def find_int(val: str):  # Beispiel '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Zum Beispiel, 128, 0, 0, 1 = 1, oder 128, 0, 75, 108 = 19308.
In der Tabelle gab es einen Primärschlüssel mit Autoinkrement, und auch hier kann dieser gefunden werden.
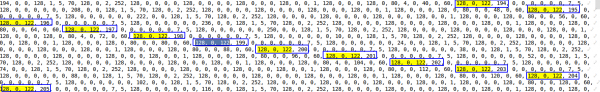
Bei der Zuordnung der Daten aus den Testtabellen wurde festgestellt, dass das Objekt DATETIME aus 5 Bytes besteht und mit 153 beginnt (was wahrscheinlich auf jährliche Intervalle hinweist). Da der Bereich für DATETIME von '1000-01-01' bis '9999-12-31' reicht, denke ich, dass die Anzahl der Bytes variieren kann, aber in meinem Fall fallen die Daten in den Zeitraum von 2016 bis 2019, daher halten wir 5 Bytes für ausreichend.
Um die Uhrzeit ohne Sekunden zu bestimmen, wurden folgende Funktionen geschrieben. Skript:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Für Jahr und Monat konnte ich keine funktionierende Funktion schreiben, daher musste ich es hardcoden. Skript:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Ich bin mir sicher, dass man mit genügend Zeit dieses Missverständnis klären kann.
Als nächstes eine Funktion, die ein datetime-Objekt aus einem String zurückgibt. Skript:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Es konnten häufig wiederkehrende Werte aus int, int, datetime, datetime gefunden werden. 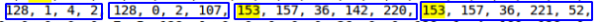 , es scheint, das ist genau das, was gebraucht wird. Zudem wiederholt sich diese Sequenz nicht zweimal in der Zeile.
Verwenden Sie reguläre Ausdrücke, um die erforderlichen Daten zu finden:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Bitte beachten Sie, dass bei der Suche mit diesem Ausdruck NULL-Werte in den erforderlichen Feldern nicht erkannt werden können, was in meinem Fall jedoch nicht kritisch ist. Anschließend durchlaufen wir die gefundenen Ergebnisse. Skript:
result = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
Im Grunde genommen sind die Daten aus dem Array result die Informationen, die wir benötigen. ###PS.###
Ich verstehe, dass dieser Ansatz nicht für alle geeignet ist, aber das Hauptziel des Artikels ist es eher, zum Handeln anzuregen, als alle Ihre Probleme zu lösen. Ich denke, die sinnvollste Lösung wäre es, den Quellcode selbst zu studieren. , aber aufgrund von Zeitbeschränkungen erschien mir die aktuelle Methode als die schnellste.
In manchen Fällen können Sie durch die Analyse der Datei eine ungefähre Struktur erkennen und diese mithilfe einer der oben genannten Standards wiederherstellen. Das wird viel richtiger sein und weniger Probleme verursachen.
Quelle: habr.com
