

Einleitung
Guten Tag. Seit einem halben Jahr läuft bei uns ein Skript (genauer gesagt, eine Sammlung von Skripten), das Berichte über den Status von virtuellen Maschinen (und nicht nur) generiert. Ich habe mich entschieden, meine Erfahrungen bei der Erstellung und den Code selbst zu teilen. Ich rechne mit Kritik und hoffe, dass das Material für jemanden nützlich sein kann.
Bedarfsermittlung
Wir haben viele virtuelle Maschinen (etwa 1500 VMs verteilt auf 3 vCenter). Häufig werden neue erstellt und alte gelöscht. Um Ordnung zu schaffen, wurden mehrere benutzerdefinierte Felder im vCenter hinzugefügt, um die VMs nach Subsystemen zu klassifizieren, anzugeben, ob sie Testmaschinen sind, sowie anzugeben, von wem und wann sie erstellt wurden. Der menschliche Faktor führte dazu, dass mehr als die Hälfte der Maschinen mit unvollständigen Feldern blieben, was die Arbeit erschwerte. Alle sechs Monate wurde jemand frustriert und begann, diese Daten zu aktualisieren, aber das Ergebnis war nach anderthalb Wochen schon wieder veraltet.
Ich möchte klarstellen, dass alle verstehen, dass Anträge zur Erstellung von Maschinen vorliegen müssen, ein Prozess zu deren Erstellung existiert usw. und so fort. Und gleichzeitig halten sich alle strikt an diesen Prozess und alles bleibt ordentlich. Bei uns ist das leider nicht der Fall, aber das ist nicht das Thema des Artikels 🙂
Im Allgemeinen wurde die Entscheidung getroffen, die Überprüfung der Richtigkeit der ausgefüllten Felder zu automatisieren.
Wir entschieden, dass eine tägliche E-Mail mit einer Liste der falsch ausgefüllten Maschinen an alle verantwortlichen Ingenieure und deren Vorgesetzte ein guter Anfang sein würde.
Zu diesem Zeitpunkt hatte einer der Kollegen bereits ein PowerShell-Skript implementiert, das täglich nach Zeitplan Informationen über alle Maschinen sämtlicher vCenters sammelte und 3 CSV-Dokumente (jeweils für sein eigenes vCenter) erstellte, die auf ein gemeinsames Laufwerk abgelegt wurden. Es wurde beschlossen, dieses Skript als Grundlage zu verwenden und die Überprüfungen mithilfe der Programmiersprache R zu ergänzen, mit der wir einige Erfahrungen hatten.
Im Laufe der Weiterentwicklung wuchs die Lösung um E-Mail-Benachrichtigungen, eine Datenbank mit einer Haupt- und einer Historientabelle (darüber später) sowie um die Analyse von vSphere-Protokollen zur Suche nach den tatsächlichen Erstellern von VMs und dem Zeitpunkt ihrer Erstellung.
Für die Entwicklung wurden die IDE RStudio Desktop und PowerShell ISE verwendet.
Das Skript wird von einer normalen Windows-VM aus gestartet.
Beschreibung der allgemeinen Logik.
Die allgemeine Logik der Skripte sieht wie folgt aus.
- Wir sammeln Daten zu virtuellen Maschinen mit einem PowerShell-Skript, das wir über R aufrufen, und fassen die Ergebnisse in einer einzigen CSV-Datei zusammen. Die gegenseitige Interaktion zwischen den Sprachen erfolgt analog. (Man hätte die Daten direkt von R an PowerShell in Form von Variablen übergeben können, aber das ist kompliziert, und mit den Zwischenergebnissen in CSV-Dateien lässt sich leichter debuggen und man kann die Ergebnisse einfacher mit anderen teilen).
- Mit R erstellen wir zulässige Parameter für die Felder, deren Werte wir überprüfen. — Wir erstellen ein Word-Dokument, das diese Feldwerte enthält, um sie in ein Informationsschreiben einzufügen, das die Fragen der Kollegen beantwortet: "Wie soll ich das denn ausfüllen?"
- Wir laden die Daten aller VMs aus einer CSV-Datei mit R, erstellen einen DataFrame, entfernen unnötige Felder und erstellen ein Informationsdokument im XLSX-Format, das eine Zusammenfassung aller VMs enthält, das wir auf eine gemeinsame Ressource hochladen.
- Auf den DataFrame aller VMs wenden wir alle Überprüfungen der Korrektheit der ausgefüllten Felder an und erstellen eine Tabelle, die nur die VMs mit falsch ausgefüllten Feldern (und nur diesen Feldern) enthält.
- Die erhaltene Liste der VMs senden wir an ein anderes PowerShell-Skript, das die Protokolle von vCenter auf Ereignisse zur Erstellung von VMs überprüft. Dies ermöglicht es, die voraussichtliche Erstellungszeit der VMs und die vermutlichen Ersteller anzugeben. Dies für den Fall, dass sich niemand outet, wem die Maschine gehört. Dieses Skript arbeitet nicht schnell, insbesondere wenn es viele Protokolle gibt, daher betrachten wir nur die letzten 2 Wochen und verwenden außerdem einen Workflow, der es ermöglicht, Informationen zu mehreren VMs gleichzeitig zu suchen. Im Beispielskript sind detaillierte Kommentare zu diesem Mechanismus enthalten. Das Ergebnis fassen wir in einer CSV-Datei zusammen, die wir erneut in R hochladen.
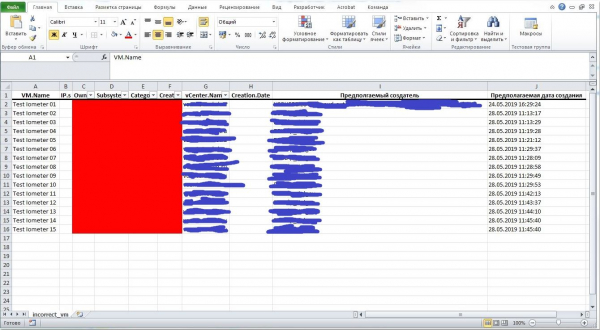
- Wir erstellen ein schön formatiertes XLSX-Dokument, in dem die falsch ausgefüllten Felder rot hervorgehoben sind, einige Spalten gefiltert sind und zusätzliche Spalten mit den vermutlichen Erstellern und der Erstellungszeit der VMs angegeben sind.
- Wir erstellen eine E-Mail, in die wir ein Dokument einfügen, das die zulässigen Werte für die Felder beschreibt, sowie eine Tabelle mit falsch ausgefüllten VMs. Im Text geben wir die Gesamtzahl der falsch erstellten VMs an, einen Link zur allgemeinen Ressource und ein motivierendes Bild. Wenn keine falsch ausgefüllten VMs vorhanden sind, senden wir eine andere E-Mail mit einem fröhlicheren motivierenden Bild.
- Wir speichern die Daten aller VMs in einer SQL Server-Datenbank unter Berücksichtigung des implementierten Mechanismus der Historientabellen (ein sehr interessantes Mechanismus – dazu später mehr).
Eigentlich die Skripte
Die Hauptdatei mit dem Code in R
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Überprüfen der Richtigkeit der ausgefüllten Felder
full_df <- fullXslx_df %>%
mutate(
# Zuerst entfernen wir alle überflüssigen Leerzeichen und Tabulatoren, dann berücksichtigen wir das Trennzeichen Komma, dann überprüfen wir das Vorhandensein in den zulässigen Werten,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Überprüfen der Existenz der Datei mit allen VMs und löschen, wenn vorhanden.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Erstellen der xslx-Datei mit dem Bericht ####
# Allgemeine Daten auf ein separates Blatt
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Erstellen der xslx-Datei mit falsch ausgefüllten Feldern ####
# Erstellen df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Überprüfen der Existenz der Datei mit allen VMs und löschen, wenn vorhanden.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Speichern der Liste der VMs mit nicht ausgefüllten Feldern in csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Filtern für die Einfügung in die E-Mail
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Zählen der Zeilen
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Überprüfen der Existenz der Datei mit den Erstellern und löschen, wenn vorhanden.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Ausführen des PowerShell-Skripts, das die Ersteller der gefundenen VMs sucht. Als Ausgabe erhalten wir csv.
system(paste0("powershell -File ", getCreatorsPath))
# Lesen der Datei mit den Erstellern
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Filtern für die Einfügung in die E-Mail, Hinzufügen von Daten aus der Tabelle mit den Erstellern
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Vorgesehener Ersteller` = CreatedBy,
`VorgesehDatum der Erstellung` = CreatedOn)
# Erstellen des E-Mail-Textes
emailBody <- paste0(
'<html>
<h3>Guten Tag, liebe Kollegen.</h3>
<p>Die vollständigen aktuellen Informationen zu den virtuellen Maschinen finden Sie im Laufwerk H: hier:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Im Anhang finden Sie die Liste der VMs mit <strong>unzureichend ausgefüllten</strong> Feldern. Insgesamt gibt es <strong>', numberOfRows,'</strong>.</p>
<p>In der Tabelle sind 2 zusätzliche Spalten hinzugekommen. <strong>Voraussichtlicher Ersteller</strong> und <strong>Voraussichtliches Erstellungsdatum</strong>, die aus den vCenter-Protokollen der letzten 2 Wochen stammen</p>
<p>Die Maschinen-Ersteller werden gebeten, die Daten zu präzisieren und die Felder korrekt auszufüllen. Die Regeln zum Ausfüllen der Felder sind ebenfalls im Anhang enthalten</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Überprüfen, ob die Datei existiert
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Eine schöne Tabelle mit Formaten usw. erstellen
source(file = "email.R", local = T, encoding = "utf-8")
#### Erstellung einer E-Mail mit schlecht beschrifteten Maschinen ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "VMs mit unzureichend ausgefüllten Feldern",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### Danach folgt der Block, falls keine Probleme mit den VMs vorliegen ####
} else {
# Erstellen des E-Mail-Inhalts
emailBody <- paste0(
'<html>
<h3>Guten Tag, sehr geehrte Kollegen</h3>
<p>Die vollständigen aktuellen Informationen zu den virtuellen Maschinen finden Sie im Laufwerk H: hier:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Aktuell sind alle Felder der VMs korrekt ausgefüllt</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Erstellung einer E-Mail ohne schlecht ausgefüllte VMs ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Zusammenfassende Informationen",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Daten in die Datenbank schreiben #####
source(file = "DB.R", local = T, encoding = "utf-8")
Skript zur Abfrage der VM-Liste in PowerShell
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
PowerShell-Skript, das aus den Logs die Ersteller der virtuellen Maschinen und die Daten ihrer Erstellung extrahiert
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Besonderes Augenmerk verdient die Bibliothek , die es ermöglicht hat, den Anhang der E-Mail anschaulich formatiert (wie es das Management mag) zu gestalten, und nicht einfach als CSV-Tabelle.
Erstellung eines schönen xlsx-Dokuments mit der Liste der falsch ausgefüllten Maschinen
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
Am Ende sieht es ungefähr so aus:
Es gab auch einen interessanten Punkt bei der Einstellung des Windows-Planers. Es war schwierig, die richtigen Berechtigungs- und Einstellungsmöglichkeiten zu finden, damit alles wie gewünscht läuft. Am Ende wurde eine R-Bibliothek gefunden, die selbst ein Aufgabenelement zur Ausführung des R-Skripts erstellt und sogar die Logdatei nicht vergisst. Danach kann man die Aufgabe manuell anpassen.
Ein Stück R-Code mit zwei Beispielen, das eine Aufgabe im Windows-Planer erstellt.
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## Starten des Skripts in 62 Sekunden
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## Starten des Skripts täglich um 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## Löschen der Aufgaben
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Anzeigen der Logs (letzte 4 Zeilen)
tail(readLines("all_vm.log"), sep ="n", n = 4)
Separat zur Datenbank
Nach der Einstellung des Skripts traten andere Fragen auf. Zum Beispiel wollte ich das Datum finden, an dem die VM gelöscht wurde, aber die Logs im vCenter waren bereits gelöscht. Da das Skript jeden Tag Dateien in einen Ordner legt und nicht aufräumt (wir reinigen manuell, wenn wir uns erinnern), kann man die alten Dateien durchsuchen und die erste Datei finden, in der diese VM nicht mehr vorhanden ist. Aber das ist nicht ideal.
Ich wollte eine historische Datenbank erstellen.
Dabei half die Funktionalität von MS SQL SERVER – system-versionierte temporale Tabellen. Diese werden normalerweise als zeitlich versionierte Tabellen übersetzt.
Man kann ausführlich lesen in .
Kurz gesagt – wir erstellen eine Tabelle, geben an, dass sie versioniert ist, und SQL Server erstellt zwei zusätzliche datetime-Spalten in dieser Tabelle (das Erstellungsdatum des Eintrags und das Ende der Lebensdauer des Eintrags) sowie eine zusätzliche Tabelle, in die die Änderungen geschrieben werden. Dadurch erhalten wir aktuelle Informationen und können durch einfache Abfragen, Beispiele finden wir in der Dokumentation, entweder den Lebenszyklus einer bestimmten virtuellen Maschine oder den Zustand aller VMs zu einem bestimmten Zeitpunkt sehen.
Aus Sicht der Leistung wird die Transaktion zum Schreiben in die Haupttabelle nicht abgeschlossen, solange die Transaktion zum Schreiben in die temporale Tabelle nicht abgeschlossen ist. Das heißt, bei Tabellen mit einer großen Anzahl von Schreiboperationen sollte diese Funktion mit Vorsicht eingeführt werden, aber in unserem Fall ist das eine wirklich coole Sache.
Damit der Mechanismus korrekt funktioniert, musste ich in R einen kleinen Codeabschnitt schreiben, der die neue Tabelle mit den Daten aller VMs mit der in der Datenbank gespeicherten verglich und nur geänderte Zeilen einfügte. Der Code ist nicht besonders kompliziert, verwendet die Bibliothek compareDF, aber ich werde ihn auch unten bringen.
Der Code in R zum Schreiben von Daten in die Datenbank
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
Insgesamt
Durch die Implementierung des Skripts wurde über mehrere Monate hinweg Ordnung geschaffen und aufrechterhalten. Gelegentlich tauchen falsch ausgefüllte VMs auf, aber das Skript dient als gutes Erinnerungshilfsmittel und nur selten taucht eine VM zwei Tage hintereinander in der Liste auf.
Es wurde auch eine Grundlage für die Analyse historischer Daten geschaffen.
Es ist klar, dass vieles davon nicht "in Eigenregie" umgesetzt werden kann, sondern spezialisierte Software erfordert, aber die Aufgabe war interessant und kann als fakultativ betrachtet werden.
R hat sich erneut als hervorragende universelle Sprache erwiesen, die nicht nur ideal zur Lösung statistischer Aufgaben geeignet ist, sondern auch als hervorragendes "Bindeglied" zwischen anderen Datenquellen fungiert.
Quelle: habr.com
