

Bild:
Für Aggregator-Websites im Bereich E-Commerce ist es von entscheidender Bedeutung, aktuelle Informationen bereitzustellen. Andernfalls entfällt ihr hauptsächlicher Vorteil – die Möglichkeit, die relevantesten Daten an einem Ort zu sehen.
Um diese Aufgabe zu lösen, ist es notwendig, die Technik des Web-Scrapings zu verwenden. Dabei wird spezielle Software – ein Crawler – erstellt, der die erforderlichen Websites aus einer Liste durchläuft, Informationen von ihnen extrahiert und auf der Aggregator-Website hochlädt.
Das Problem besteht darin, dass die Eigentümer der Websites, von denen die Aggregatoren Daten beziehen, oft nicht so einfach Zugang gewähren wollen. Das ist verständlich – wenn die Preisinformationen eines Online-Shops auf der Aggregator-Website angezeigt werden und höher sind als die der dort ebenfalls dargestellten Wettbewerber, verliert das Unternehmen Kunden.
Methoden zur Bekämpfung von Scraping
Daher wehren sich häufig die Eigentümer solcher Websites gegen das Scraping – das heißt, gegen das Herunterladen ihrer Daten. Sie können Anfragen erkennen, die von Bot-Crawlern gesendet werden, basierend auf der IP-Adresse. In der Regel verwenden solche Software sogenannte Server-IP-Adressen, die leicht zu identifizieren und zu blockieren sind.
Zusätzlich zur Blockierung von Anfragen wird häufig eine andere Methode verwendet – identifizierte Bots erhalten irrelevante Informationen angezeigt. Zum Beispiel werden die Preise für Produkte erhöht oder gesenkt, oder ihre Beschreibungen werden geändert.
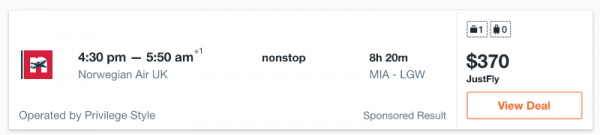
Ein häufiges Beispiel in diesem Zusammenhang sind die Preise für Flugtickets. Tatsächlich können Fluggesellschaften und Reisebüros oft unterschiedliche Ergebnisse für die gleichen Flüge je nach IP-Adresse anzeigen. Ein tatsächlicher Fall: Die Suche nach einem Flug von Miami nach London an demselben Datum mit einer IP-Adresse aus Osteuropa und Asien liefert unterschiedliche Ergebnisse.
Im Falle einer IP-Adresse in Osteuropa sieht der Preis wie folgt aus:
Und für eine IP-Adresse aus Asien so:
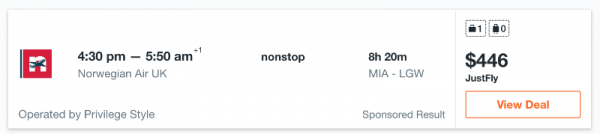
Wie zu sehen ist, unterscheidet sich der Preis für den gleichen Flug erheblich – die Differenz beträgt 76 USD, was wirklich viel ist. Für eine Aggregator-Website gibt es nichts Schlimmeres – wenn falsche Informationen angezeigt werden, werden die Nutzer sie nicht nutzen. Zudem wirkt sich negativ auf den Ruf des Projekts aus, wenn auf dem Aggregator für ein bestimmtes Produkt ein Preis angezeigt wird und dieser sich beim Wechsel zur Website des Verkäufers ändert.
Lösung: Verwendung von Residential Proxies
Um Probleme beim Scraping von Daten für deren Aggregation zu vermeiden, können residente Proxys verwendet werden. Server-IP-Adressen werden von Hosting-Anbietern bereitgestellt. Es ist recht einfach, die Zugehörigkeit einer Adresse zu einem bestimmten Anbieter zu erkennen – jede IP hat eine ASN-Nummer, die diese Informationen enthält.
Es gibt viele Dienste zur Analyse von ASN-Nummern. Oft werden sie in Antibot-Systeme integriert, die den Zugang für Crawler blockieren oder die bei Anfragen zurückgegebenen Daten manipulieren.
Residente IP-Adressen helfen, solche Systeme zu umgehen. Solche IPs werden von Internetanbietern an Wohnungsbesitzer vergeben, mit entsprechenden Notizen in allen zugehörigen Datenbanken. Es gibt spezielle Dienste für residente Proxys, die es ermöglichen, residente Adressen zu nutzen. – genau so ein Dienst.
Anfragen, die Crawler von Aggregator-Websites über residente IPs senden, erscheinen so, als kämen sie von normalen Nutzern aus einer bestimmten Region. Normale Besucher werden jedoch nicht blockiert – im Fall von Online-Shops sind das potenzielle Kunden.
Insgesamt ermöglicht die Nutzung von rotierenden Proxys von Infatica Aggregator-Websites, garantierte genaue Daten zu erhalten und Blockierungen sowie Schwierigkeiten beim Parsen zu vermeiden.
Weitere Artikel zum Thema Nutzung residenter Proxys für Unternehmen:
Quelle: habr.com
