

Anmerkung des Übersetzers.: Der Autor dieses Materials ist Cindy Sridharan, Ingenieurin bei imgix, einem Unternehmen, das sich mit API-Entwicklung und insbesondere mit dem Testen von Mikrodiensten beschäftigt. In diesem Material teilt sie ihre umfassende Sichtweise zu aktuellen Problemen im Bereich der verteilten Tracing, wo ihrer Meinung nach ein Mangel an wirklich effektiven Werkzeugen zur Lösung drängender Aufgaben besteht.
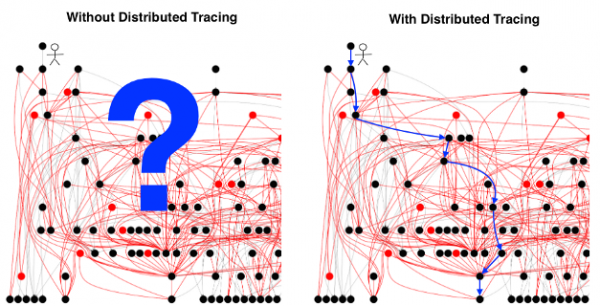
[Die Abbildung stammt aus zum verteilten Tracing.]
Es wird angenommen, dass schwierig zu implementieren ist und der Nutzen daraus ist. Die „Problematik“ des Tracings wird durch viele Gründe erklärt, wobei häufig die Mühe beim Einrichten jedes Systemkomponenten erwähnt wird, um die entsprechenden Header mit jeder Anfrage zu übertragen. Obwohl dieses Problem tatsächlich existiert, kann es keinesfalls als unüberwindbar bezeichnet werden. Es erklärt übrigens nicht, warum Entwickler Tracing (sogar das bereits funktionierende) nicht besonders mögen.
Die größte Schwierigkeit beim verteilten Tracing liegt nicht im Sammeln von Daten, nicht in der Standardisierung von Verbreitungs- und Darstellungformaten und nicht in der Bestimmung, wann, wo und wie die Auswahl durchgeführt werden soll. Ich versuche keineswegs, diese „Usability-Probleme“ als triviale Herausforderungen darzustellen – in der Tat gibt es bedeutende technische und (wenn wir wirklich Open Source-) ) politische Herausforderungen, die überwunden werden müssen, um diese Probleme als gelöst betrachten zu können.
Wenn man jedoch annimmt, dass all diese Probleme gelöst sind, ist es sehr wahrscheinlich, dass sich aus Sicht des Endbenutzererlebnissesnichts Wesentliches ändern wird. Das Tracing bringt möglicherweise weiterhin keinen praktischen Nutzen in den häufigsten Debugging-Szenarien – sogar nachdem es implementiert wurde.
Ein so untypisches Tracing
Das verteilte Tracing umfasst mehrere voneinander getrennte Komponenten:
- Ausstattung von Anwendungen und Middleware mit Überwachungswerkzeugen;
- Übertragung des verteilten Kontexts;
- Sammeln von Tracings;
- Speicherung von Tracings;
- deren Abruf und Visualisierung.
Viele Gespräche über verteiltes Tracing reduzieren sich darauf, es als eine Art unäre Operation zu betrachten, deren einziges Ziel die Unterstützung einer vollständigen Systemdiagnose ist. Dies hängt stark mit der historisch geprägten Auffassung von verteiltem Tracing zusammen. In , der veröffentlicht wurde, als der Quellcode von Zipkin geöffnet wurde, wurde erwähnt, dass es [Zipkin] Twitter schneller macht. Die ersten kommerziellen Angebote für Tracing wurden ebenfalls als .
Anmerkung des Übersetzers.beworben: Um den nachfolgenden Text besser zu verstehen, definieren wir zwei grundlegende Begriffe gemäß :
- Span – das grundlegende Element des verteilten Tracings. Es handelt sich um eine Beschreibung eines Arbeitsablaufs (z. B. eine Datenbankanfrage) mit einem Namen, Start- und Endzeit, Tags, Logs und Kontext.
- Spans enthalten normalerweise Verweise auf andere Spans, was es ermöglicht, mehrere Spans in Trace – die Visualisierung des Lebenszyklus einer Anfrage während ihrer Bewegung durch das verteilte System, zu kombinieren.
Traces enthalten unglaublich wertvolle Daten, die in Aufgaben wie: Testing in der Produktion, Durchführung von Notfallwiederherstellungstests, Testing mit Fehlerinjektionen usw. helfen können. Tatsächlich verwenden einige Unternehmen bereits Tracing zu solchen Zwecken. Beginnen wir damit, dass auch andere Anwendungen hat, abgesehen von der einfachen Übertragung von Spans in ein Speichersystem:
- Zum Beispiel nutzt Uber Tracing-Ergebnisse zur Trennung von Test- und Produktionstrafik.
- Facebook Daten von Traces zur Analyse des kritischen Pfades und zum Umschalten des Traffics während regelmäßiger Notfallwiederherstellungstests.
- Auch das soziale Netzwerk Jupyter-Notebooks, die Entwicklern ermöglichen, beliebige Anfragen zu den Tracing-Ergebnissen auszuführen.
- Befürworter (Lineage Driven Failure Injection) verteiltes Traces für Tests mit Fehlerinjektionen.
Keine der oben genannten Optionen gehört vollständig zum Szenario der Fehlerbehebung, bei dem ein Ingenieur versucht, ein Problem zu lösen, indem er sich den Trace ansieht.
Wenn es doch zum Fehlerbehebungsszenario kommt, bleibt das primäre Interface das Diagramm Traceview (obwohl einige es auch als "Gantt-Diagramm" oder "Kaskadendiagramm"). Unter Traceview mir alle Spans und begleitenden Metadaten, die zusammen das Trace bilden. Jedes Open-Source-Tracing-System sowie jede kommerzielle Tracing-Lösung bietet eine auf Traceview Benutzeroberfläche zur Visualisierung, Detaillierung und Filterung von Traces.
Das Problem mit allen Tracing-Systemen, mit denen ich bisher in Kontakt gekommen bin, besteht darin, dass die endgültige Visualisierung (Traceview) nahezu vollständig die Merkmale des Generierungsprozesses des Traces widerspiegelt. Selbst wenn alternative Visualisierungen angeboten werden: Heatmaps, Service-Topologien, Latency-Histogramme — letztendlich reduzieren sie sich alle auf Traceview.
Früher habe ich dass die meisten "Innovationen" im Bereich Tracing in Bezug auf UI/UX offensichtlich auf zusätzlicher Metadaten im Trace, die Einbettung von Informationen mit hoher Kardinalität (high-cardinality) oder die Möglichkeit, bestimmte Spans zu detaillieren oder Anfragen zwischen und innerhalb von Traces. Dabei nutzt Traceview als primäres Mittel zur Visualisierung bleibt. Solange dieser Zustand anhält, wird verteiltes Tracing (im besten Fall) den vierten Platz als Debugging-Werkzeug einnehmen, hinter Metriken, Logs und Stack Traces; im schlimmsten Fall wird es eine völlige Geld- und Zeitverschwendung sein.
Das Problem mit Traceview
Zweckbestimmung Traceview besteht darin, ein vollständiges Bild der Bewegung einer einzelnen Anfrage durch alle Komponenten eines verteilten Systems zu liefern, mit denen sie in Beziehung steht. Einige fortschrittlichere Tracing-Systeme erlauben es, einzelne Spans detailliert zu betrachten und eine zeitliche Aufschlüsselung innerhalb eines Prozesses (wenn Spans funktionale Grenzen haben) zu sehen.
Die grundlegende Voraussetzung für die Architektur von Mikrodiensten ist die Idee, dass die organisatorische Struktur mit den Bedürfnissen des Unternehmens wächst. Befürworter von Mikrodiensten sind der Ansicht, dass die Verteilung verschiedener Geschäftsaufgaben auf einzelne Dienste es kleinen, autonomen Entwicklerteams ermöglicht, den gesamten Lebenszyklus dieser Dienste zu kontrollieren, wodurch sie in der Lage sind, diese unabhängig zu erstellen, zu testen und bereitzustellen. Ein Nachteil dieser Verteilung ist jedoch der Verlust von Informationen darüber, wie jeder Dienst mit anderen interagiert. Unter diesen Umständen beansprucht verteiltes Tracking die Rolle eines unverzichtbaren Werkzeugs für Fehlerbehebung komplexe Interaktionen zwischen Diensten.
Wenn Sie tatsächlich , dann kann sich kein Mensch die vollständige Überblick verschaffen. Tatsächlich ist die Entwicklung eines Werkzeugs unter der Annahme, dass dies überhaupt möglich ist, etwas wie ein Antipattern (ein ineffektiver und unproduktiv Ansatz). Im Idealfall ist ein Werkzeug zur Fehlersuche erforderlich, das hilft, den Suchbereich einzugrenzen, damit die Ingenieure sich auf eine Teilmenge von Metriken (Diensten/Nutzern/Hosts usw.) konzentrieren können, die für das jeweilige Problemmuster relevant sind. Bei der Suche nach dem Grund für einen Ausfall müssen Ingenieure nicht verstehen, was in allen Diensten gleichzeitigpassiert ist, da diese Anforderung der Grundidee der Mikrodienste widersprechen würde.
Traceview hingegen stellt genau das dar. Ja, einige Tracking-Systeme bieten komprimierte Traceviews an, wenn die Anzahl der Spans im Trace so groß ist, dass sie nicht in einer einzigen Visualisierung dargestellt werden können. Aufgrund des großen Informationsgehalts selbst in einer solchen komprimierten Visualisierung sind die Ingenieure dennoch gezwungen, sie manuell zu filtern, um die Problemdienste einzugrenzen. Leider sind Maschinen in diesem Bereich deutlich schneller als Menschen, weniger fehleranfällig und ihre Ergebnisse sind reproduzierbarer. Ein weiterer Grund, warum ich die Methode des Traceviews für falsch halte, ist, dass sie sich schlecht für hypothesenbasierte Fehlersuche eignet. Grundsätzlich ist Fehlersuche
eine. iterativ Ein Prozess, der mit einer Hypothese beginnt, gefolgt von der Überprüfung verschiedener Beobachtungen und Fakten, die aus dem System in unterschiedlichen Vektoren gewonnen wurden, Schlussfolgerungen/Generalisierungen und einer weiteren Bewertung der Wahrheit der Hypothese.
Die Möglichkeit schnell und kostengünstig Hypothesen zu testen und das mentale Modell entsprechend zu verbessern ist ein Grundpfeiler der Fehlersuche. Jedes Debugging-Tool sollte interaktiv sein und den Suchraum einschränken oder im Falle eines falschen Hinweis dem Benutzer ermöglichen, zurückzukehren und sich auf einen anderen Bereich des Systems zu konzentrieren. Ein ideales Werkzeug würde dies vorwegnehmen, indem es sofort die Aufmerksamkeit des Benutzers auf potenziell problematische Bereiche lenkt.
Leider Traceview kann ein Werkzeug mit einer interaktiven Benutzeroberfläche nicht genannt werden. Das Beste, was man bei seiner Nutzung hoffen kann, ist, eine Quelle von erhöhten Verzögerungen zu finden und alle möglichen Tags und Logs zu überprüfen, die damit verbunden sind. Dies hilft dem Ingenieur nicht, Muster im Verkehr, wie die spezifische Verteilung von Verzögerungen, zu erkennen oder Korrelationen zwischen verschiedenen Messungen zu entdecken. kann helfen, einige dieser Probleme zu umgehen. Tatsächlich für erfolgreiche Analysen unter Verwendung von maschinellem Lernen, um anomale Spans zu identifizieren und eine Teilsammlung von Tags zu identifizieren, die mit anormalem Verhalten in Zusammenhang stehen können. Dennoch habe ich bisher keine überzeugenden Visualisierungen von Ergebnissen gesehen, die mit maschinellem Lernen oder Datenanalyse auf Spans angewendet wurden, die sich signifikant von Traceviews oder DAG (gerichtetem azyklischen Graphen) unterscheiden.
Spans sind zu niedrigschwellig
Das grundlegende Problem mit Traceview ist, dass Spans zu niedrigschwellige Primitiven sowohl für die Analyse von Verzögerungen (latency) als auch für die Ursachenanalyse sind. Es ist, als würde man einzelne CPU-Befehle analysieren, um eine Ausnahme zu beheben, obwohl es viel höherstufige Tools wie Backtrace gibt, mit denen es viel einfacher zu arbeiten ist.
Darüber hinaus wage ich zu behaupten: Im Idealfall brauchen wir gar kein vollständiges Bild während des Lebenszyklus der Anfrage, die von modernen Trace-Tools dargestellt wird. Stattdessen wird eine Form höherer Abstraktion benötigt, die Informationen darüber enthält, was schiefgelaufen ist (analog zu einem Backtrace), zusammen mit einigem Kontext. Anstatt den gesamten Trace zu betrachten, sehe ich es vor, nur den Teil, in dem etwas Interessantes oder Ungewöhnliches passiert. Derzeit erfolgt die Suche manuell: Ein Ingenieur erhält den Trace und analysiert selbstständig die Spans auf der Suche nach etwas Interessantem. Der Ansatz, bei dem Menschen auf Spans in einzelnen Traces starren, in der Hoffnung, verdächtige Aktivitäten zu entdecken, ist absolut nicht skalierbar (insbesondere wenn sie alle Metadaten, die in verschiedenen Spans kodiert sind, wie Span-ID, RPC-Methode, Span-Dauer, Protokolle, Tags usw. verstehen müssen).
Alternativen zu Traceview
Die Ergebnisse des Tracings sind am hilfreichsten, wenn sie so visualisiert werden können, dass sie eine nicht triviale Darstellung dessen bieten, was in den miteinander verbundenen Teilen des Systems passiert. Bis dies der Fall ist, bleibt der Debugging-Prozess weitgehend inert und hängt von der Fähigkeit des Benutzers ab, die richtigen Korrelationen zu erkennen, die richtigen Teile des Systems zu überprüfen oder Puzzlestücke zusammenzufügen – im Gegensatz zu einem Tool, das dem Benutzer hilft, diese Hypothesen zu formulieren.
Ich bin kein visueller Designer und kein UX-Experte, aber im nächsten Abschnitt möchte ich einige Ideen darüber teilen, wie solche Visualisierungen aussehen könnten.
Fokus auf spezifische Dienste
In einer Zeit, in der sich die Branche um die Konzepte serviceorientierte Visualisierungen am besten für solche Teams geeignet sind. Traces, insbesondere ohne Samples, sind eine Goldmine an Informationen über jede Komponente eines verteilten Systems. Diese Informationen können einem raffinierten Verarbeiter zugeführt werden, der den Benutzern
serviceorientierte Funde liefert. Sie können im Voraus identifiziert werden — noch bevor der Benutzer die Traces betrachtet: Erkenntnisse liefert. Sie können im Voraus identifiziert werden – noch bevor der Nutzer einen Blick auf die Traces wirft:
- Verzögerungsverteilung-Diagramme nur für auffällige Anfragen (auffällige Anfragen);
- Verzögerungsverteilung-Diagramme für Fälle, in denen die SLO-Ziele des Dienstes nicht erreicht werden;
- Die häufigsten, interessantesten und seltsamsten Tags in Anfragen, die am häufigsten wiederholt werden;
- Verzögerungsaufgliederung für Fälle, in denen Abhängigkeiten des Dienstes die festgelegten SLO-Ziele nicht erreichen;
- Verzögerungsaufgliederung nach verschiedenen nachgelagerten Diensten.
Auf einige dieser Fragen können die eingebetteten Metriken einfach keine Antwort geben, wodurch die Benutzer gezwungen sind, die Spans sorgfältig zu untersuchen. Letztendlich haben wir einen extrem benutzerfeindlichen Mechanismus.
In diesem Zusammenhang stellt sich die Frage: Wie steht es um die komplexen Wechselwirkungen zwischen verschiedenen Diensten, die von verschiedenen Teams überwacht werden? Ist das Traceview nicht das am besten geeignete Werkzeug, um eine solche Situation zu beleuchten?
Mobile Entwickler, Eigentümer von zustandslosen Diensten, Eigentümer von verwalteten zustandsbehafteten Diensten (wie Datenbanken) und Eigentümer von Plattformen könnten an einer anderen Darstellung des verteilten Systems interessiert sein; Traceview — es ist eine zu universelle Lösung für diese grundlegend unterschiedlichen Bedürfnisse. Selbst in einer sehr komplexen Microservices-Architektur benötigen die Dienstbesitzer nicht tiefgehende Kenntnisse über mehr als zwei bis drei Upstream- und Downstream-Dienste. Im Wesentlichen müssen die Benutzer in den meisten Szenarien lediglich Fragen bezüglich einer begrenzten Anzahl von Diensten beantworten..
Es ist, als würde man eine kleine Teilmenge von Diensten durch eine Lupe betrachten, um sie gründlich zu untersuchen. Dadurch kann der Benutzer relevantere Fragen zu den komplexen Wechselwirkungen zwischen diesen Diensten und ihren unmittelbaren Abhängigkeiten stellen. Es ist ähnlich wie ein Backtrace in der Welt der Dienste, wo ein Ingenieur weiß, was wie es läuft, und auch ein gewisses Verständnis für das Geschehen in den umliegenden Diensten hat, um zu verstehen, warum.
Der von mir verfolgte Ansatz ist das genaue Gegenteil des "Top-down"-Ansatzes, der auf Traceview basiert, bei dem die Analyse mit dem gesamten Trace beginnt und dann schrittweise bis zu einzelnen Spans sinkt. Im Gegensatz dazu beginnt der "Bottom-up"-Ansatz mit der Analyse eines kleinen Abschnitts, der nahe an der potenziellen Ursache des Vorfalls liegt, und erweitert dann bei Bedarf den Suchraum (gegebenenfalls unter Einbeziehung anderer Teams zur Analyse eines breiteren Spektrums von Diensten). Der zweite Ansatz ist besser geeignet, um anfängliche Hypothesen schnell zu überprüfen. Nach dem Erhalt konkreter Ergebnisse kann zu einer gezielteren und detaillierteren Analyse übergegangen werden.
Topologie aufbauen
Dienstbezogene Darstellungen können unglaublich nützlich sein, wenn der Benutzer weiß, welcher Dienst oder welche Dienstgruppe für die Erhöhung der Verzögerungen verantwortlich ist oder die Fehlerquelle darstellt. In einem komplexen System kann sich jedoch die Identifizierung des fehlerhaften Dienstes als nicht trivial erweisen, insbesondere wenn keine Fehlermeldungen von den Diensten eingegangen sind.
Der Aufbau einer Servicetopologie kann stark helfen, herauszufinden, welcher Dienst einen Anstieg der Fehlerrate oder eine Erhöhung der Verzögerung zeigt, die zu einer merklichen Verschlechterung der Dienstqualität führt. Wenn ich von Topologieaufbau spreche, meine ich nicht eine Dienstkarte, die jeden verfügbaren Dienst im System abbildet und bekannt ist für ihre . Eine solche Darstellung ist nicht besser als ein Traceview, das auf einem gerichteten azyklischen Graphen basiert. Vielmehr möchte ich eine dynamisch generierte Servicetopologie, die auf bestimmten Attributen basiert, wie Fehlerhäufigkeit, Antwortzeit oder einem beliebigen benutzerdefinierten Parameter, der hilft, die Situation mit bestimmten verdächtigen Diensten zu klären.
Lassen Sie uns ein Beispiel betrachten. Stellen wir uns eine hypothetische Nachrichtenwebsite vor. Der Dienst der Startseite (front page) tauscht Daten mit Redis, dem Empfehlungsdienst, dem Werbedienst und dem Videoservice aus. Der Videoservice bezieht Videos von S3, während die Metadaten aus DynamoDB stammen. Der Empfehlungsdienst erhält Metadaten aus DynamoDB, lädt Daten aus Redis und MySQL und sendet Nachrichten an Kafka. Der Werbedienst erhält Daten aus MySQL und sendet Nachrichten an Kafka.
Nachfolgend finden Sie eine schematische Darstellung dieser Topologie (viele kommerzielle Programme zum Tracing erstellen solche Topologien). Sie kann nützlich sein, wenn man die Abhängigkeiten der Dienste verstehen möchte. Während Fehlerbehebung, wenn ein gewisser Dienst (zum Beispiel der Videoservice) eine erhöhte Antwortzeit zeigt, ist eine solche Topologie nicht besonders hilfreich.
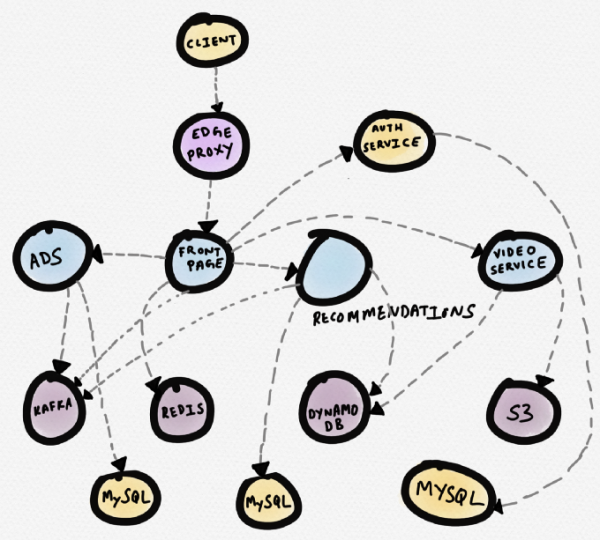
Schema der Dienste einer hypothetischen Nachrichten-Website
Eine besser geeignete Darstellung wäre das Diagramm, das weiter unten abgebildet ist. Darin ist der problematische Dienst (video) genau in der Mitte dargestellt. Der Benutzer bemerkt ihn sofort. Aus dieser Visualisierung wird deutlich, dass der Videoservice aufgrund einer erhöhten Antwortzeit von S3 anormal funktioniert, was sich auf die Ladegeschwindigkeit eines Teils der Hauptseite auswirkt.
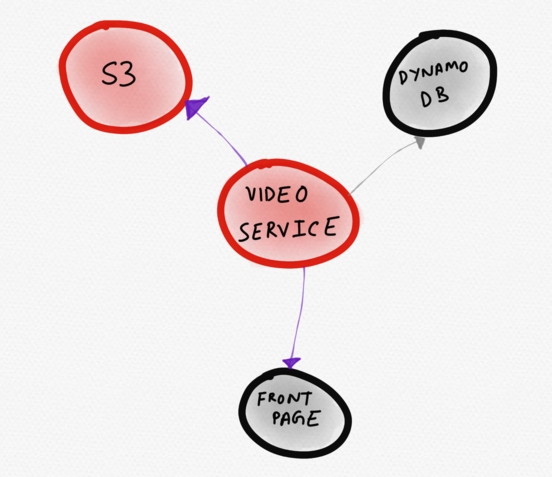
Dynamische Topologie, die nur „interessante“ Dienste anzeigt.
Dynamisch generierte topologische Diagramme können effizienter sein als statische Dienstkarten, insbesondere in elastischen, automatischen Skalierungsinfrastrukturen. Die Möglichkeit, Topologien von Diensten zu vergleichen und gegenüberzustellen, ermöglicht es dem Benutzer, relevantere Fragen zu stellen. Präzisere Fragen zum System führen mit höherer Wahrscheinlichkeit zu einem besseren Verständnis darüber, wie das System funktioniert.
Vergleichende Darstellung
Eine weitere nützliche Visualisierung wäre eine vergleichende Darstellung. Derzeit eignen sich Traces nicht besonders gut für den Seitenvergleich, daher werden normalerweise Spansverglichen. Die Hauptidee dieses Artikels besteht jedoch darin, dass Spans zu niedrigstufig sind, um die wertvollsten Informationen aus den Tracing-Ergebnissen zu extrahieren.
Der Vergleich von zwei Traces erfordert keine grundlegend neuen Visualisierungen. Tatsächlich genügt etwas wie ein Histogramm, das dieselben Informationen darstellt wie Traceview. Erstaunlicherweise kann sogar diese einfache Methode deutlich mehr Vorteile bringen, als es das bloße Studieren von zwei einzelnen Traces tun würde. Noch mächtiger wäre die Möglichkeit visualisieren Vergleich von Trace-Logs insgesamt. Es wäre äußerst hilfreich zu sehen, wie die kürzlich implementierte Änderung in der Datenbankkonfiguration mit aktiviertem GC (Garbage Collection) die Reaktionszeit des Downstream-Dienstes über mehrere Stunden beeinflusst. Wenn das, was ich hier beschreibe, Ähnlichkeiten mit einer A/B-Analyse der Auswirkungen von Infrastrukturänderungen aufweist, in vielen Diensten , dann liegen Sie nicht allzu weit von der Wahrheit entfernt.
Fazit
Ich bezweifle nicht die Nützlichkeit des Trace-Loggings selbst. Ich glaube fest daran, dass es keine andere Methode gibt, um so reichhaltige, kausale und kontextuelle Daten zu sammeln wie die, die in einem Trace enthalten sind. Ich bin jedoch auch der Meinung, dass alle Trace-Logging-Lösungen diese Daten äußerst ineffizient nutzen. Solange die Trace-Tools auf der Traceview-Darstellung festgelegt sind, werden sie in ihren Möglichkeiten eingeschränkt sein, die wertvollen Informationen, die aus den in den Traces enthaltenen Daten extrahiert werden können, optimal zu nutzen. Außerdem besteht das Risiko, dass sich eine völlig unfreundliche und unintuitive Benutzeroberfläche weiterentwickelt, die die Fähigkeit des Benutzers zur Fehlersuche in der Anwendung stark einschränkt.
Das Debugging komplexer Systeme, selbst mit den neuesten Werkzeugen, ist unglaublich schwierig. Die Werkzeuge müssen dem Entwickler helfen, Hypothesen zu formulieren und zu überprüfen, indem sie aktiv relevante Informationen bereitstellen, Ausreißer identifizieren und Besonderheiten in der Verteilung von Verzögerungen hervorheben. Damit das Trace-Logging zum bevorzugten Werkzeug der Entwickler für die Fehlersuche in der Produktion oder zur Lösung von Problemen, die verschiedene Dienste umfassen, wird, sind originelle Benutzeroberflächen und Visualisierungen erforderlich, die besser mit dem mentalen Modell von Entwicklern übereinstimmen, die diese Dienste erstellen und betreiben.
Es sind ernsthafte geistige Anstrengungen erforderlich, um ein System zu entwerfen, das verschiedene Signale in den Trace-Ergebnissen auf eine Weise darstellt, die für die Analyse und Schlussfolgerungen optimiert ist. Es ist notwendig zu überlegen, wie die Topologie des Systems während der Fehlersuche abstrahiert werden kann, um dem Benutzer zu helfen, blinde Flecken zu überwinden, ohne in einzelne Traces oder Spans schauen zu müssen.
Wir benötigen gute Möglichkeiten zur Abstraktion und zur Aufschlüsselung in Ebenen (insbesondere im UI). Solche, die gut in den hypothesenbasierten Debugging-Prozess eingebunden sind, wo man iterativ Fragen stellen und Hypothesen testen kann. Sie lösen nicht automatisch alle Probleme mit der Beobachtbarkeit, helfen jedoch den Benutzern, ihr Gespür zu verfeinern und fundiertere Fragen zu formulieren. Ich plädiere für einen überlegteren und innovativeren Ansatz im Bereich der Visualisierung. Hier besteht echte Aussicht, die Horizonte zu erweitern.
P.S. vom Übersetzer
Lesen Sie auch in unserem Blog:
- «»;
- «»;
- «».
Quelle: habr.com
