

Einführung
Es kam so, dass ich an meinem aktuellen Arbeitsplatz mit dieser Technologie vertraut gemacht wurde. Ich beginne mit einer kleinen Vorgeschichte. Bei einem weiteren Treffen wurde unserem Team mitgeteilt, dass wir eine Integration mit einem bekannten Systemerstellen müssen. Unter Integration verstand man, dass dieses bekannte System uns Anfragen über HTTP an einen bestimmten Endpunkt senden würde, während wir, so merkwürdig es auch klingt, Antworten in Form von SOAP-Nachrichten zurücksenden würden. Es scheint alles einfach und trivial zu sein. Daraus folgt, dass wir…
Aufgabe
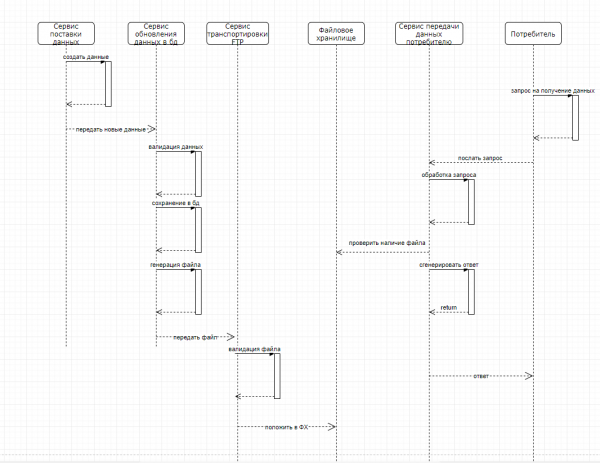
drei Dienste erstellen müssen. Der erste davon ist der Dienst zur Aktualisierung der Datenbank. Dieser Dienst aktualisiert die Daten in der Datenbank, wenn neue Daten aus einem externen System eintreffen, und generiert eine Datei im CSV-Format, um sie an das nächste System zu übergeben. Der Endpunkt des zweiten Dienstes — dem FTP-Transportdienst — wird aufgerufen, der die übergebene Datei erhält, sie validiert und sie über FTP in den Dateispeicher ablegt. Der dritte Dienst — der Datenübertragungsdienst an den Verbraucher — arbeitet asynchron mit den ersten beiden. Er nimmt eine Anfrage von einem externen System zur Verfügungstellung der oben erwähnten Datei entgegen, nimmt die vorbereitete Antwortdatei, modifiziert sie (aktualisiert die Felder id, description, linkToFile) und sendet die Antwort in Form einer SOAP-Nachricht. Insgesamt sieht das Bild folgendermaßen aus: Die ersten beiden Dienste beginnen ihre Arbeit nur, wenn Daten zur Aktualisierung eingegangen sind. Der dritte Dienst läuft ständig, da es viele Verbraucher von Informationen gibt — etwa 1000 Anfragen zur Datenbeschaffung pro Minute. Die Dienste sind konstant verfügbar und ihre Instanzen befinden sich in verschiedenen Umgebungen wie Test, Demo, Preprod und Prod. Im Folgenden wird das Schema der Funktionsweise dieser Dienste dargestellt. Ich möchte gleich klarstellen, dass einige Details vereinfacht wurden, um unnötige Komplexität zu vermeiden.
Technisches Tiefenverständnis
Bei der Planung der Aufgabenlösung entschieden wir uns zunächst, eine Anwendung in Java unter Verwendung des Spring-Frameworks, mit einem Lastenausgleich durch Nginx, einer PostgreSQL-Datenbank und anderen technischen und weniger technischen Werkzeugen zu erstellen. Da die Zeit, um die technische Lösung zu erarbeiten, es erlaubte, andere Ansätze zur Lösung dieser Aufgabe zu prüfen, fiel unser Blick auf die in bestimmten Kreisen angesagte Technologie Apache NIFI. Ich möchte gleich darauf hinweisen, dass diese Technologie uns die Möglichkeit gegeben hat, diese 3 Dienste zu erkennen. In diesem Artikel wird die Entwicklung des Dateiübertragungsdienstes und des Datentransferdienstes an den Verbraucher beschrieben. Wenn der Artikel gut ankommt, werde ich über den Dienst zur Aktualisierung der Daten in der Datenbank schreiben.
Was ist das?
NIFI ist eine verteilte Architektur zur schnellen parallelen Datenübertragung und -verarbeitung, mit einer großen Anzahl von Plugins für Datenquellen und -transformierungen, Konfigurationsversionierung und vielem mehr. Ein angenehmer Bonus ist, dass es sehr einfach zu bedienen ist. Triviale Prozesse wie getFile, sendHttpRequest und andere können als Quadrate dargestellt werden. Jedes Quadrat stellt einen bestimmten Prozess dar, dessen Interaktionen im Bild unten sichtbar sind. Eine detaillierte Dokumentation zur Interaktion und Einstellung von Prozessen ist verfasst , für diejenigen, die auf Russisch sind — . In der Dokumentation wird genau erklärt, wie man NIFI entpackt und startet sowie wie man Prozesse erstellt, die ebenfalls Quadrate sind.
Die Idee, einen Artikel zu schreiben, entstand nach langen Suchen und der Strukturierung der gesammelten Informationen in etwas Verständliches, sowie dem Wunsch, es zukünftigen Entwicklern etwas zu erleichtern.
Beispiel
Es wurde ein Beispiel betrachtet, wie Quadrate miteinander interagieren. Das Gesamtschema ist ganz einfach: Wir erhalten eine HTTP-Anfrage (theoretisch mit einer Datei im Anfragekörper. Zur Demonstration der Möglichkeiten von NIFI startet in diesem Beispiel die Anfrage den Prozess des Abrufs einer Datei aus einem lokalen Speicherort), dann senden wir zurück, dass die Anfrage empfangen wurde, während gleichzeitig der Prozess zum Abruf der Datei aus dem Speicherort und der anschließende Prozess des Transfers über FTP in den Speicherort gestartet wird. Es ist zu erklären, dass die Prozesse durch das sogenannte flowFile miteinander verbunden sind. Dies ist die grundlegende Entität in NIFI, die Attribute und Inhalte speichert. Der Inhalt sind die Daten, die als Datei im Fluss dargestellt werden. Das heißt grob gesagt, wenn Sie eine Datei aus einem Quadrat erhalten und sie an ein anderes weitergeben, besteht der Inhalt aus Ihrer Datei.
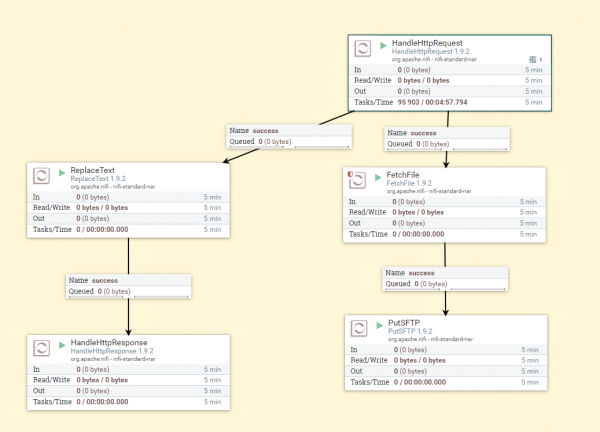
Wie Sie sehen können, zeigt dieses Bild den allgemeinen Prozess. HandleHttpRequest – empfängt Anfragen, ReplaceText – generiert den Antwortinhalt, HandleHttpResponse – gibt die Antwort zurück. FetchFile – erhält eine Datei aus dem Dateispeicher und überträgt sie an das Quadrat PutSftp – legt diese Datei an dem angegebenen Ort auf FTP ab. Jetzt schauen wir uns diesen Prozess genauer an.
In diesem Fall ist die Anfrage der Anfang von allem. Lassen Sie uns die Konfigurationsparameter betrachten.
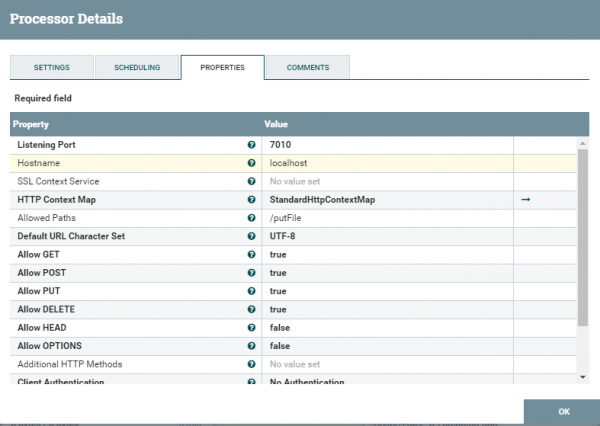
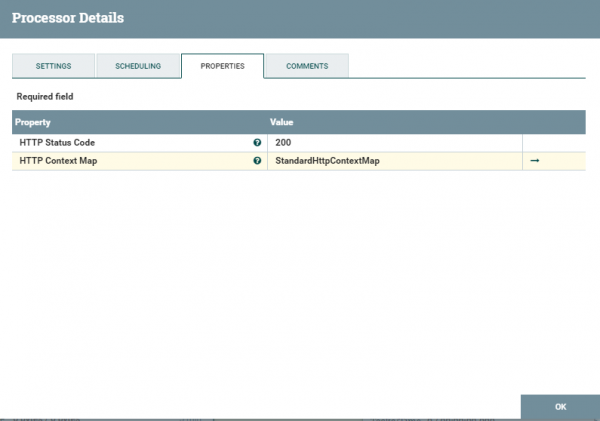
Hier ist alles ziemlich trivial, mit Ausnahme von StandartHttpContextMap – dies ist eine Art Dienst, der das Senden und Empfangen von Anfragen ermöglicht. Genauer und sogar mit Beispielen kann man schauen –
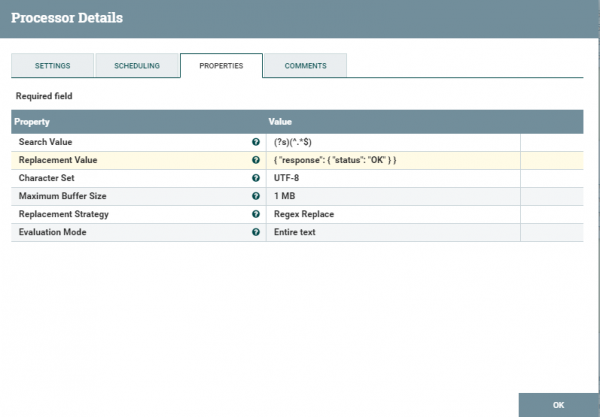
Als nächstes betrachten wir die Konfigurationsparameter des quadratischen ReplaceText. Hier ist es wichtig auf ReplacementValue zu achten – das ist der Inhalt, der dem Benutzer als Antwort zurückgegeben wird. In den Einstellungen kann das Log-Level geregelt werden, die Logs können betrachtet werden {wo nifi entpackt wurde}/nifi-1.9.2/logs, dort gibt es auch die Parameter failure/success – basierend auf diesen Parametern kann der Prozess insgesamt reguliert werden. Das heißt, im Falle einer erfolgreichen Textverarbeitung wird der Prozess zur Zustellung der Antwort an den Benutzer ausgelöst, und in einem anderen Fall protokollieren wir einfach den misslungenen Prozess.
In den Eigenschaften von HandleHttpResponse gibt es außer dem Status bei erfolgreicher Erstellung der Antwort nicht viel Interessantes.
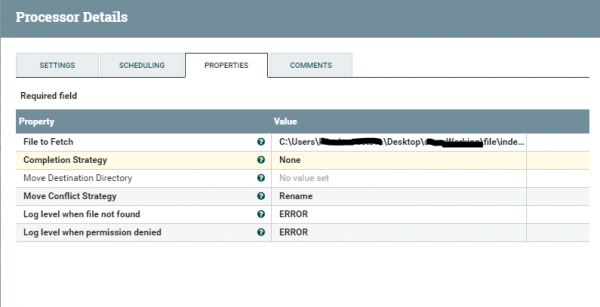
Mit der Anfrage und der Antwort sind wir jetzt durch – gehen wir weiter zum Abruf der Datei und deren Übertragung auf den FTP-Server. FetchFile – erhält die Datei aus dem im Setup angegebenen Pfad und leitet sie an den nächsten Prozess weiter.
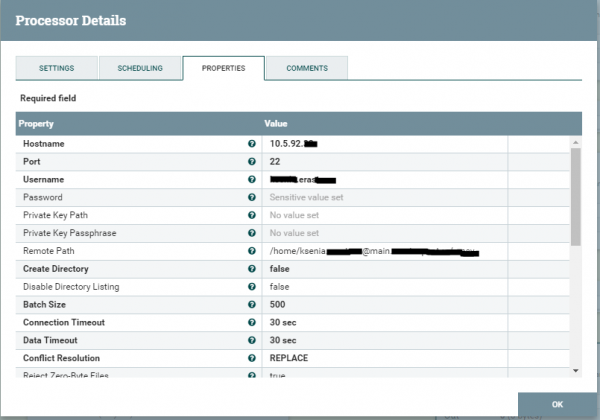
Der PutSftp-Block speichert die Datei im Dateispeicher. Die Konfigurationsparameter können wir unten sehen.
Es ist wichtig zu beachten, dass jeder Block ein separater Prozess ist, der gestartet werden muss. Wir haben das einfachste Beispiel betrachtet, das keine komplizierte Anpassung erfordert. Lassen Sie uns nun einen etwas komplizierteren Prozess betrachten, bei dem wir ein wenig in Groovy schreiben werden.
Ein komplexeres Beispiel
Der Datenübertragungsdienst an den Verbraucher ist etwas komplexer geworden, aufgrund des Modifikationsprozesses der SOAP-Nachricht. Der gesamte Prozess ist im Bild unten dargestellt.
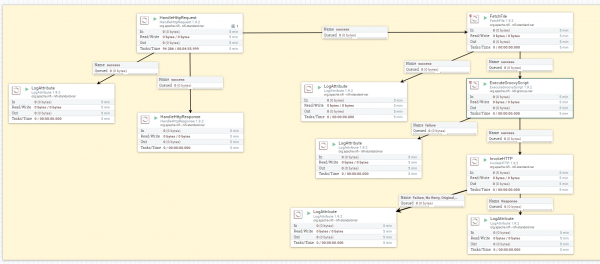
Hier ist die Idee ebenfalls nicht besonders kompliziert: Wir haben eine Anfrage vom Verbraucher erhalten, dass er Daten benötigt, haben eine Antwort gesendet, dass die Nachricht eingegangen ist, den Prozess zum Abrufen der Antwortdatei gestartet, diese mit einer bestimmten Logik bearbeitet und die Datei dann dem Verbraucher in Form einer SOAP-Nachricht auf dem Server übermittelt.
Ich denke, es ist nicht notwendig, die bereits gesehenen Blöcke erneut zu beschreiben – lassen Sie uns sofort zu neuen übergehen. Wenn Sie eine Datei bearbeiten müssen und einfache Blöcke wie ReplaceText nicht ausreichen, müssen Sie Ihr eigenes Skript schreiben. Dies kann mit dem Block ExecuteGroovyScript erfolgen. Die Einstellungen dafür sind unten dargestellt.
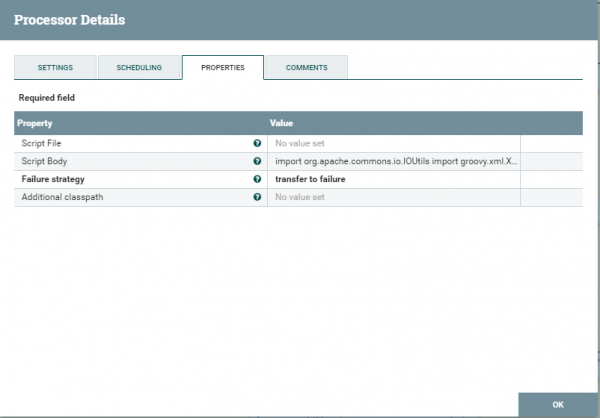
Es gibt zwei Möglichkeiten, ein Skript in dieses Quadrat zu laden. Die erste besteht darin, die Skriptdatei hochzuladen. Die zweite besteht darin, das Skript in `scriptBody` einzufügen. Soweit ich weiß, unterstützt das Quadrat `executeScript` mehrere Programmiersprachen — eine davon ist Groovy. Ich enttäusche die Java-Entwickler — Skripte können in solchen Quadraten nicht in Java geschrieben werden. Für diejenigen, die es wirklich möchten — es muss ein benutzerdefiniertes Quadrat erstellt und ins NIFI-System eingefügt werden. Dieser gesamte Vorgang ist mit ziemlich langwierigen Tänzen mit dem Tamburin verbunden, mit denen wir uns im Rahmen dieses Artikels nicht beschäftigen werden. Ich habe die Sprache Groovy gewählt. Unten ist ein Testskript dargestellt, das einfach die ID in der SOAP-Nachricht inkrementell aktualisiert. Es ist wichtig zu beachten: Sie nehmen die Datei aus `flowFile`, aktualisieren sie, und es ist nicht zu vergessen, dass sie die aktualisierte Datei wieder zurücklegen müssen. Außerdem ist zu beachten, dass nicht alle Bibliotheken eingebunden sind. Es kann sein, dass Sie eine der Bibliotheken importieren müssen. Ein weiterer Nachteil ist, dass das Skript in diesem Quadrat ziemlich schwer zu debuggen ist. Es gibt einen Weg, sich mit der JVM von NIFI zu verbinden und den Debugging-Prozess zu starten. Persönlich habe ich bei mir eine lokale Anwendung gestartet und den Empfang der Datei aus der Sitzung simuliert. Das Debugging habe ich ebenfalls lokal gemacht. Fehler, die beim Laden des Skripts auftreten, lassen sich relativ leicht googeln und werden von NIFI selbst im Log vermerkt.
import org.apache.commons.io.IOUtils
import groovy.xml.XmlUtil
import java.nio.charset.*
import groovy.xml.StreamingMarkupBuilder

def flowFile = session.get()
if (!flowFile) return
try {
    flowFile = session.write(flowFile, { inputStream, outputStream ->
        String result = IOUtils.toString(inputStream, "UTF-8");
        def recordIn = new XmlSlurper().parseText(result)
        def element = recordIn.depthFirst().find {
            it.name() == 'id'
        }

        def newId = Integer.parseInt(element.toString()) + 1
        def recordOut = new XmlSlurper().parseText(result)
        recordOut.Body.ClientMessage.RequestMessage.RequestContent.content.MessagePrimaryContent.ResponseBody.id = newId

        def res = new StreamingMarkupBuilder().bind { mkp.yield recordOut }.toString()
        outputStream.write(res.getBytes(StandardCharsets.UTF_8))
} as StreamCallback)
     session.transfer(flowFile, REL_SUCCESS)
}
catch(Exception e) {
    log.error("Error during processing of validate.groovy", e)
    session.transfer(flowFile, REL_FAILURE)
}
Damit endet die Anpassung des Quadrats. Die aktualisierte Datei wird dann an das Quadrat übergeben, das sich mit dem Versand der Datei an den Server beschäftigt. Unten sind die Einstellungen dieses Quadrats dargestellt.
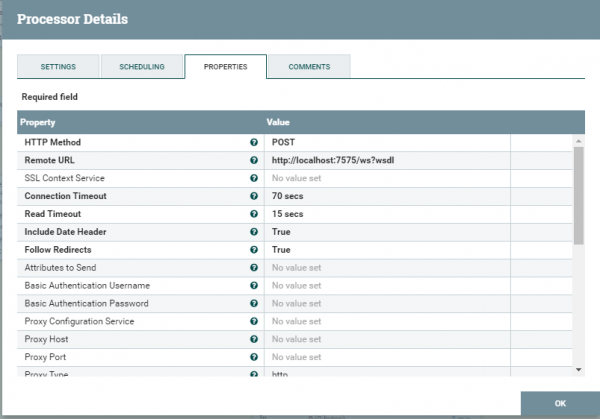
Wir beschreiben die Methode, mit der die SOAP-Nachricht übermittelt wird. Wir geben an, wohin. Außerdem muss angegeben werden, dass dies wirklich SOAP ist.
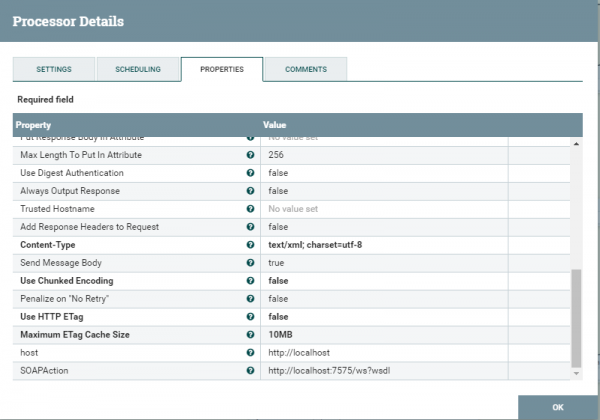
Wir fügen mehrere Eigenschaften wie Host und Action (soapAction) hinzu. Speichern, überprüfen. Ausführlichere Informationen zum Versenden von SOAP-Anfragen finden Sie hier.
Wir haben mehrere Einsatzmöglichkeiten von NIFI-Prozessen betrachtet. Wie sie interagieren und welchen echten Nutzen sie bringen. Die betrachteten Beispiele sind Testfälle und unterscheiden sich etwas von dem, was real im Einsatz ist. Ich hoffe, dieser Artikel wird für Entwickler von Nutzen sein. Vielen Dank für Ihre Aufmerksamkeit. Bei Fragen schreiben Sie mir bitte. Ich werde mich bemühen, zu antworten.
Quelle: habr.com
