

Dies ist ein Mythos, der im Bereich der Serverhardware weit verbreitet ist. In der Praxis sind hyperkonvergente Lösungen (alles in einem) jedoch für viele Zwecke erforderlich. Historisch gesehen wurden die ersten Architekturen von Amazon und Google für ihre eigenen Dienste entwickelt. Die Idee war damals, einen Rechenfarm aus identischen Knoten zu schaffen, von denen jeder eigene Festplatten hat. All dies wurde mit einer Art systembildenden Software (Hypervisor) verbunden und dann in virtuelle Maschinen unterteilt. Die Hauptaufgabe besteht darin, den Aufwand für die Wartung eines einzelnen Knotens auf ein Minimum zu reduzieren und Probleme beim Skalieren zu vermeiden: Man kauft einfach eine weitere tausend oder zwei solcher Server und schließt sie daneben an. In der Praxis sind dies jedoch Einzelfälle, und viel häufiger geht es um eine geringere Anzahl von Knoten und eine leicht andere Architektur.
Der Vorteil bleibt derselbe – unglaubliche Einfachheit beim Skalieren und Verwalten. Der Nachteil ist, dass verschiedene Aufgaben unterschiedlich Ressourcen verbrauchen, sodass es irgendwo viele lokale Festplatten, woanders wenig RAM und so weiter gibt. Das heißt, bei verschiedenen Arten von Aufgaben wird die Ressourcennutzung sinken.
Es stellte sich heraus, dass man für den Komfort der Einrichtung 10-15% mehr bezahlt. Das hat den Mythos aus der Überschrift hervorgerufen. Wir haben lange gesucht, wo diese Technologie optimal eingesetzt werden kann, und sie gefunden. Tatsache ist, dass Cisco keine eigenen Speicherlösungen hatte, aber den vollständigen Servermarkt wollte. Und so haben sie Cisco Hyperflex geschaffen – eine Lösung mit lokalen Speichern auf den Knoten.
Und damit hat sich plötzlich eine sehr gute Lösung für Backup-Rechenzentren (Disaster Recovery) ergeben. Warum und wie – das werde ich jetzt erklären. Und ich werde die Cluster-Tests zeigen.
Wo nötig
Hyperkonvergenz ist:
- Verschiebung der Festplatten in die Rechenknoten.
- Vollständige Integration des Storage-Subsystems mit dem Virtualisierungs-Subsystem.
- Verschiebung/Integration mit dem Netzwerk-Subsystem.
Solch eine Kombination ermöglicht die Umsetzung vieler Funktionen von Speichersystemen auf der Ebene der Virtualisierung und alles aus einem einzigen Verwaltungsfenster.
In unserem Unternehmen sind Projekte zur Planung von Backup-Rechenzentren sehr gefragt, und oft wird tatsächlich eine hyperkonvergente Lösung wegen der Vielzahl an Replikationsoptionen (bis hin zu Metro-Clustern) aus der Box gewählt.
Bei redundanten Rechenzentren handelt es sich in der Regel um einen entfernten Standort an einem anderen Ende der Stadt oder sogar in einer anderen Stadt. Es ermöglicht die Wiederherstellung kritischer Systeme im Falle eines teilweisen oder vollständigen Ausfalls des primären Rechenzentrums. Daten werden kontinuierlich von der Produktionsumgebung repliziert, und diese Replikation kann auf Anwendungsebene oder auf Ebene des Blockspeichers (SAN) erfolgen.
Deshalb werde ich jetzt über die Systemarchitektur und Tests sprechen, und danach über einige Szenarien für den praktischen Einsatz mit Daten zu Einsparungen.
Tests
Unser Exemplar besteht aus vier Servern, in jedem davon befinden sich 10 SSD-Laufwerke mit 960 GB. Es gibt eine dedizierte Festplatte zum Caching von Schreibvorgängen und zur Speicherung der Dienstvirtualmaschine. Die Lösung selbst ist die vierte Version. Die erste war offensichtlich unausgereift (laut Feedback), die zweite war noch etwas unausgereift, die dritte bereits ausreichend stabil, und diese kann man als Release nach Abschluss der öffentlichen Betatests bezeichnen. Während der Testphase habe ich keine Probleme festgestellt, alles funktioniert einwandfrei.
Änderungen in v4Eine Menge Bugs wurden behoben.
Ursprünglich konnte die Plattform nur mit dem Hypervisor VMware ESXi arbeiten und unterstützte nur eine geringe Anzahl von Knoten. Außerdem endete der Bereitstellungsprozess nicht immer erfolgreich, man musste einige Schritte neu starten, es gab Probleme beim Aktualisieren von älteren Versionen, die Daten im GUI wurden nicht immer korrekt angezeigt (obwohl ich auch jetzt nicht begeistert von der Darstellung der Leistungsdiagramme bin), manchmal traten Probleme mit der Virtualisierung auf.
Derzeit sind alle Kinderkrankheiten behoben. HyperFlex unterstützt sowohl ESXi als auch Hyper-V, außerdem ist Folgendes möglich:
- Erstellung eines ausgedehnten Clusters.
- Erstellung eines Clusters für Büros ohne Verwendung von Fabric Interconnect, von zwei bis vier Knoten (wir kaufen nur die Server).
- Möglichkeit zur Arbeit mit externen Speichersystemen.
- Unterstützung für Container und Kubernetes.
- Erstellung von Verfügbarkeitszonen.
- Integration mit VMware SRM, wenn die integrierte Funktionalität nicht ausreicht.
Die Architektur unterscheidet sich nicht wesentlich von den Lösungen der Hauptkonkurrenten, das Rad wurde nicht neu erfunden. Alles läuft auf der Virtualisierungsplattform VMware oder Hyper-V. Hardwareseitig kommt es auf Cisco UCS-Servern zum Einsatz, die intern entwickelt wurden. Es gibt diejenigen, die die Plattform wegen der relativen Komplexität der Ersteinrichtung, der Vielzahl an Knöpfen, des nicht-trivialen Systems von Vorlagen und Abhängigkeiten hassen, aber es gibt auch die, die ihre Zen-Erleuchtung erreicht haben, sich mit der Idee identifizieren und nicht mehr mit anderen Servern arbeiten wollen.
Wir betrachten hier die Lösung für VMware, da diese ursprünglich dafür entwickelt wurde und mehr Funktionalität bietet. Hyper-V wurde nachträglich angepasst, um mit den Konkurrenten Schritt zu halten und den Markterwartungen zu entsprechen.
Es gibt einen Cluster aus Servern, die mit Festplatten ausgestattet sind. Es sind Festplatten für die Datenspeicherung vorhanden (SSD oder HDD – je nach Vorliebe und Bedarf), und es gibt eine SSD-Festplatte für das Caching. Bei der Datenspeicherung auf dem Datenspeicher erfolgt die Sicherung der Daten auf der Cache-Ebene (dedizierte SSD-Festplatte und RAM der Service-VM). Parallel wird der Datenblock an die Knoten im Cluster gesendet (die Anzahl der Knoten hängt vom Replikationsfaktor des Clusters ab). Nach der Bestätigung aller Knoten über die erfolgreiche Speicherung wird die Bestätigung an den Hypervisor und weiter an die VM gesendet. Die gespeicherten Daten werden im Hintergrund dedupliziert, komprimiert und auf die Speichermedien geschrieben. Dabei wird immer ein großer Block an die Speichermedien sequenziell geschrieben, was die Belastung der Speichermedien reduziert.
Deduplizierung und Kompression sind ständig aktiviert und können nicht deaktiviert werden. Der Datenzugriff erfolgt direkt von den Speichermedien oder aus dem RAM-Cache. Wenn eine hybride Konfiguration verwendet wird, wird der Zugriff auch auf der SSD-Festplatte zwischengespeichert.
Die Daten sind nicht an den aktuellen Standort der virtuellen Maschine gebunden und werden gleichmäßig zwischen den Knoten verteilt. Dieser Ansatz ermöglicht es, alle Festplatten und Netzwerkinterfaces gleichmäßig zu belasten. Ein offensichtlicher Nachteil ergibt sich: Wir können die Leseverzögerung nicht auf ein Minimum reduzieren, da keine Garantie besteht, dass die Daten lokal verfügbar sind. Ich halte dies jedoch für ein geringfügiges Opfer im Vergleich zu den erhaltenen Vorteilen. Zumal die Netzwerklatenzen mittlerweile derart sind, dass sie den Gesamtergebnis kaum beeinflussen.
Die gesamte Logik der Funktionsweise des Speichersystems wird von einer speziellen Service-VM, dem Cisco HyperFlex Data Platform Controller, übernommen, die auf jeder Speicher-Node erstellt wird. In unserer Konfiguration wurden der Service-VM acht vCPU und 72 GB RAM zugewiesen, was nicht wenig ist. Ich erinnere daran, dass der Host über 28 physische Kerne und 512 GB RAM verfügt.
Die Service-VM hat direkten Zugriff auf die physischen Festplatten über das Durchreichen des SAS-Controllers in die VM. Die Kommunikation mit dem Hypervisor erfolgt über ein spezielles Modul namens IOVisor, das Eingabe- und Ausgabeoperationen abfängt, und über einen Agenten, der es ermöglicht, Befehle an die API des Hypervisors zu senden. Der Agent ist zuständig für die Arbeit mit HyperFlex-Snapshots und Klonen.
Im Hypervisor werden die Speicherressourcen als NFS- oder SMB-Freigabe eingebunden (je nach Typ des Hypervisors, erraten Sie, welcher wo ist). Unter der Haube handelt es sich um ein verteiltes Dateisystem, das die Funktionen eines vollwertigen Speichersystems ermöglicht: Thin Provisioning, Kompression und Deduplication, Snapshots mit der Technologie Redirect-on-Write, synchrone/asynchrone Replikation.
Die Service-VM bietet Zugang zu einer WEB-Oberfläche zur Verwaltung des HyperFlex-Systems. Es gibt eine Integration mit vCenter, und die meisten alltäglichen Aufgaben können daraus durchgeführt werden, aber Datastores lassen sich beispielsweise einfacher aus einer separaten Weboberfläche abschneiden, wenn Sie bereits auf die schnelle HTML5-Oberfläche umgestiegen sind, oder einen vollwertigen Flash-Client mit vollständiger Integration verwenden. In der Service-Weboberfläche kann die Leistung und der detaillierte Status des Systems eingesehen werden.
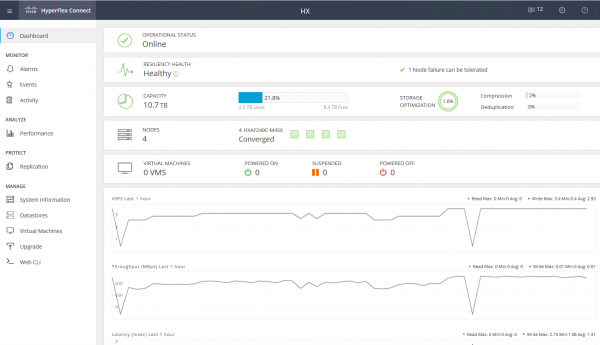
Es gibt auch eine andere Art von Nodes im Cluster – Compute-Nodes. Dies können Rack- oder Blade-Server ohne integrierte Festplatten sein. Auf diesen Servern können VMs ausgeführt werden, deren Daten auf Servern mit Festplatten gespeichert sind. Aus Sicht des Datenzugriffs gibt es keinen Unterschied zwischen den Typen von Nodes, da die Architektur eine Abstraktion vom physischen Standort der Daten vorsieht. Das maximale Verhältnis von Compute-Nodes zu Storage-Nodes beträgt 2:1.
Die Nutzung von Compute-Nodes erhöht die Flexibilität beim Skalieren der Clusterressourcen: Wir müssen keine Nodes mit Festplatten zusätzlich kaufen, wenn wir nur einen Bedarf an CPU/RAM haben. Außerdem können wir ein Blade-Gehäuse hinzufügen und dabei Kosten für die Unterbringung der Server im Rack sparen.
Somit haben wir eine hyperkonvergente Plattform mit folgenden Funktionen:
- Bis zu 64 Knoten im Cluster (bis zu 32 Speicherknoten).
- Die minimale Anzahl an Knoten im Cluster beträgt drei (zwei für den Edge-Cluster).
- Datenredundanzmechanismus: Spiegelung mit einer Replikationsfaktor von 2 und 3.
- Metro-Cluster.
- Asynchrone Replikation von VMs auf einen anderen HyperFlex-Cluster.
- Orchestrierung des VM-Umstiegs in ein entferntes Rechenzentrum.
- Native Snapshots mit Redirect-on-Write-Technologie.
- Bis zu 1 PB nützlicher Speicherplatz bei einem Replikationsfaktor von 3 und ohne Berücksichtigung der Deduplizierung. Den Replikationsfaktor 2 lassen wir außen vor, da dies keine Option für ernsthaften Vertrieb ist.
Ein weiterer großer Vorteil ist die Einfachheit der Verwaltung und Bereitstellung. Alle Komplexitäten der UCS-Serverkonfiguration übernimmt eine spezialisierte VM, die von Ingenieuren von Cisco vorbereitet wurde.
Konfiguration des Teststandes:
- 2 x Cisco UCS Fabric Interconnect 6248UP als Steuerungsknoten und Netzkomponenten (48 Ports, die im Ethernet-Modus 10G/FC 16G betrieben werden).
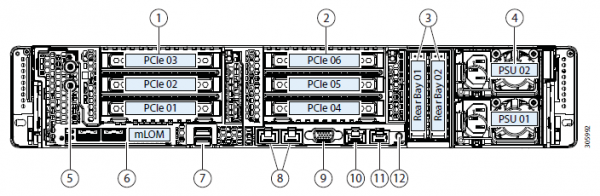
- Vier Server Cisco UCS HXAF240 M4.
Spezifikationen der Server:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Netzwerk
UCSC-MLOM-CSC-02 (VIC 1227). 2 Ports 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Durchgangscontroller
Speichermedien
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Weitere KonfigurationsmöglichkeitenNeben der gewählten Hardware stehen derzeit folgende Optionen zur Verfügung:
- HXAF240c M5.
- Ein oder zwei CPUs von Intel Silver 4110 bis Intel Platinum I8260Y. Zweite Generation verfügbar.
- 24 Speicherslots, Riegel von 16 GB RDIMM 2600 bis 128 GB LRDIMM 2933.
- Von 6 bis 23 Festplatten für Daten, eine Cache-Festplatte, eine Systemfestplatte und eine Startfestplatte.
Kapazitätslaufwerke
- HX-SD960G61X-EV 960GB 2.5 Zoll Enterprise Value 6G SATA SSD (1X Haltbarkeit) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 Zoll Enterprise Value 6G SATA SSD (1X Haltbarkeit) SAS 3.8 TB.
- Caching-Laufwerke
- HX-NVMEXPB-I375 375GB 2.5 Zoll Intel Optane-Laufwerk, Extreme Leistung & Haltbarkeit.
- HX-NVMEHW-H1600* 1.6TB 2.5 Zoll Ent. Perf. NVMe SSD (3X Haltbarkeit) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 Zoll Ent. Perf. 12G SAS SSD (10X Haltbarkeit) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 Zoll Ent. Perf. 12G SAS SED SSD (10X Haltbarkeit) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 Zoll Enterprise Performance 12G SAS SSD (3X Haltbarkeit).
System-/Protokolldatenlaufwerke
- HX-SD240GM1X-EV 240GB 2.5 Zoll Enterprise Value 6G SATA SSD (Upgrade erforderlich).
Startlaufwerke
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Netzwerkanbindung über 40G, 25G oder 10G Ethernet-Ports.
Als FI können HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G) verwendet werden.
Der Test
Für die Testung des Speichersystems habe ich HCIBench 2.2.1 verwendet. Dies ist ein kostenloses Tool, das die Automatisierung der Lastgenerierung aus mehreren virtuellen Maschinen ermöglicht. Die Last selbst wird mit dem üblichen fio erzeugt.
Unser Cluster besteht aus vier Knoten, Replikationsfaktor 3, alle Festplatten sind Flash.
Zur Testdurchführung habe ich vier Datenspeicher und acht virtuelle Maschinen erstellt. Für die Schreibtests wird angenommen, dass der Cache-Disk nicht überläuft.
Die Testergebnisse sind wie folgt:
100 % Lesen 100 % Zufällig
0 % Lesen 100 % Zufällig
Block/Tiefe der Warteschlange
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Fett markierte Werte zeigen an, nach denen es kein Leistungswachstum gibt, manchmal ist sogar eine Verschlechterung sichtbar. Dies hängt damit zusammen, dass wir an der Leistung des Netzwerks/Controllers/Festplatten stoßen.
- Sequentielles Lesen 4432 MB/s.
- Sequentielles Schreiben 804 MB/s.
- Bei einem Ausfall eines Controllers (Ausfall der virtuellen Maschine oder des Hosts) sinkt die Leistung um die Hälfte.
- Bei einem Ausfall der Speicherplatte sinkt die Leistung um ein Drittel. Der Rebuild der Festplatte benötigt 5 % der Ressourcen jedes Controllers.
Bei kleinen Blöcken stoßen wir auf die Leistung des Controllers (virtuelle Maschine), dessen CPU ist zu 100 % ausgelastet, bei größeren Blöcken stoßen wir auf die Portbandbreite. 10 Gbit/s sind nicht ausreichend, um das Potenzial eines All-Flash-Systems auszuschöpfen. Leider erlauben die Parameter des bereitgestellten Demostands nicht, dies auf 40 Gbit/s zu testen.
Eindruck von den Tests und der Architektur: Durch den Algorithmus, der die Daten zwischen allen Hosts verteilt, erhalten wir eine skalierbare vorhersagbare Leistung, dies ist jedoch auch eine Einschränkung beim Lesen, da man von lokalen Festplatten mehr herausholen könnte. Hier könnte ein leistungsstärkeres Netzwerk helfen, zum Beispiel verfügbare FI mit 40 Gbit/s.
Ebenfalls könnte eine einzige Festplatte für Caching und Deduplizierung eine Einschränkung darstellen; in diesem Stand können wir effektiv auf vier SSDs schreiben. Es wäre hervorragend, die Anzahl der Caching-Disk zu erhöhen und den Unterschied zu sehen.
Echtzeitnutzung
Für die Organisation eines Backup-Rechenzentrums kann man zwei Ansätze verwenden (die Platzierung von Backups an einem entfernten Standort wird nicht betrachtet):
- Active-Passiv. Alle Anwendungen werden im Hauptrechenzentrum gehostet. Die Replikation ist synchron oder asynchron. Im Falle eines Ausfalls des Hauptrechenzentrums müssen wir das Backup aktivieren. Dies kann manuell/mit Skripten oder Orchestrierungsanwendungen erfolgen. Hier erhalten wir ein RPO, das mit der Replikationsfrequenz vergleichbar ist, und das RTO hängt von der Reaktion und den Fähigkeiten des Administrators sowie von der Qualität der Ausarbeitung/Überprüfung des Failover-Plans ab.
- Active-Active. In diesem Fall gibt es nur synchrone Replikation, die Verfügbarkeit der Rechenzentren wird durch ein Quorum/Schiedsrichter bestimmt, der streng an einem dritten Standort untergebracht ist. RPO = 0, und RTO kann 0 erreichen (wenn die Anwendung dies zulässt) oder der Zeit für die Bearbeitung des Ausfalls eines Knotens im Virtualisierungscluster entsprechen. Auf der Virtualisierungsebene wird ein gestreckter (Metro) Cluster erstellt, der eine Active-Active Storage Area Network (SAN) erfordert.
In der Regel sehen wir bei Kunden bereits eine implementierte Architektur mit einer klassischen SAN im Hauptrechenzentrum, weshalb wir eine weitere für die Replikation entwerfen. Wie bereits erwähnt, bietet Cisco HyperFlex asynchrone Replikation und die Erstellung eines gestreckten Virtualisierungsclusters an. Dabei benötigen wir keine dedizierte SAN der Kategorie Midrange oder höher mit teuren Replikationsfunktionen und Active-Active-Datenzugriff auf zwei SAN.
Szenario 1: Wir haben ein Haupt- und ein Backup-Rechenzentrum, die Virtualisierungsplattform basiert auf VMware vSphere. Alle produktiven Systeme befinden sich im Hauptrechenzentrum, und die Replikation der virtuellen Maschinen erfolgt auf der Hypervisorebene, was es ermöglicht, die VMs im Backup-Rechenzentrum nicht eingeschaltet zu lassen. Datenbanken und spezielle Anwendungen replizieren wir mit integrierten Mitteln und halten die VMs eingeschaltet. Im Falle eines Ausfalls des Hauptrechenzentrums starten wir Systeme im Backup-Rechenzentrum. Wir gehen davon aus, dass wir etwa 100 virtuelle Maschinen haben. Solange das Hauptrechenzentrum aktiv ist, können wir im Backup-Rechenzentrum Testumgebungen und andere Systeme starten, die im Falle eines Failovers des Hauptrechenzentrums abgeschaltet werden können. Es ist auch möglich, dass wir eine bidirektionale Replikation verwenden. Aus Sicht der Hardware ändert sich nichts.
Im Falle der klassischen Architektur werden wir in jedem Rechenzentrum ein hybrides SAN mit FibreChannel-Zugang, Tiering, Deduplizierung und Kompression (aber nicht online), 8 Server pro Standort sowie 2 FibreChannel- und 10G-Ethernet-Switches einrichten. Für die Replikation und das Umschalten in der klassischen Architektur können wir VMware-Tools (Replication + SRM) oder externe Tools verwenden, die etwas günstiger und manchmal praktischer sind.
Das Diagramm zeigt das Schema.
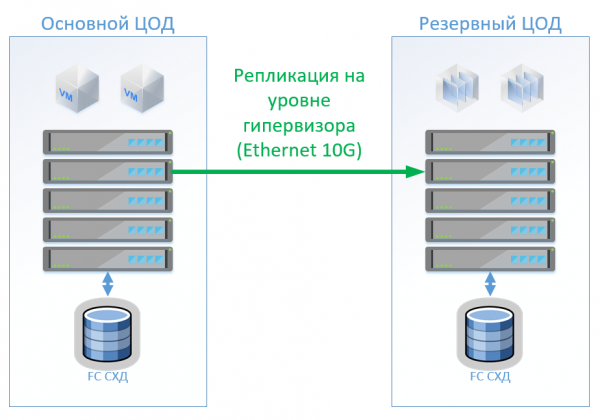
Im Falle der Nutzung von Cisco HyperFlex ergibt sich folgende Architektur:
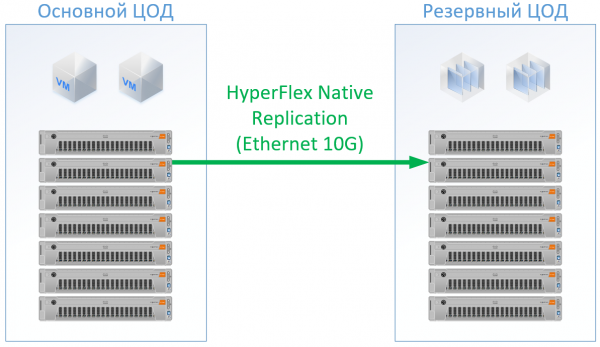
Für HyperFlex habe ich Server mit großen CPU-/RAM-Ressourcen verwendet, da ein Teil der Ressourcen für die VM des HyperFlex-Controllers benötigt wird. Bei CPU und RAM habe ich sogar etwas in der HyperFlex-Konfiguration überschüssige Ressourcen eingeplant, um nicht in Richtung Cisco zurückzustehen und die Ressourcen für die anderen VMs zu garantieren. So können wir auf die FibreChannel-Switches verzichten, und es sind keine Ethernet-Ports für jeden Server erforderlich; der lokale Traffic wird innerhalb des FI geschaltet.
Schließlich ergab sich folgende Konfiguration für jedes Rechenzentrum:
Die Server
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Speichersystem
Hybrides SAN mit FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet Switch 10G mit 12 Ports
—
SAN
2 x FC Switch 32/16Gb mit 24 Ports
2 x Cisco UCS FI 6332
Lizenzen
VMware Ent Plus
Replikation und/oder Orchestrierung des VM-Umschaltens
VMware Ent Plus
Für HyperFlex habe ich keine Lizenzen für die Replikationssoftware eingeplant, da dies bei uns standardmäßig verfügbar ist.
Für die klassische Architektur habe ich einen Anbieter ausgewählt, der sich als qualitativ hochwertig und kostengünstig etabliert hat. Für beide Varianten habe ich den spezifischen Standardrabatt angewendet und echte Preise erhalten.
Die Lösung auf Cisco HyperFlex war 13% günstiger.
Szenario 2: Schaffung von zwei aktiven Rechenzentren. In diesem Szenario entwerfen wir einen gestreckten Cluster auf VMware.
Die klassische Architektur besteht aus Virtualisierungsservern, SAN (FC-Protokoll) und zwei SANs, die in der Lage sind, auf dem zu lesen und zu schreiben, was zwischen ihnen gestreckt ist. Für jedes SAN planen wir die nützliche Kapazität für den Standort ein.
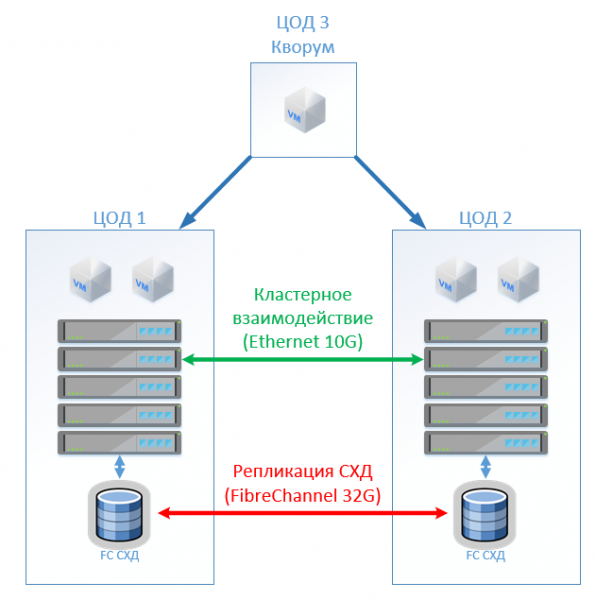
Bei HyperFlex erstellen wir einfach einen Stretch-Cluster mit der gleichen Anzahl an Knoten an beiden Standorten. In diesem Fall wird ein Replikationsfaktor von 2+2 verwendet.
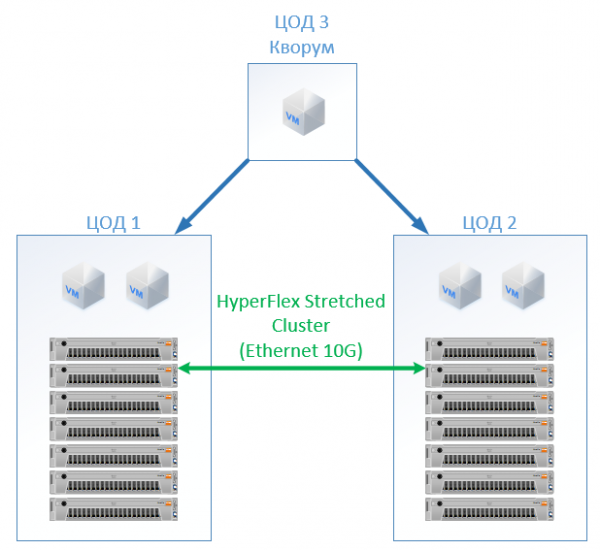
Es ergab sich folgende Konfiguration:
Klassische Architektur
HyperFlex
Die Server
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Speichersystem
2 x All-Flash SAN (150 TB SSD)
—
LAN
4 x Ethernet Switch 10G mit 24 Ports
—
SAN
4 x FC Switch 32/16Gb mit 24 Ports
4 x Cisco UCS FI 6332
Lizenzen
VMware Ent Plus
VMware Ent Plus
In allen Berechnungen habe ich die Netzwerkinfrastruktur, die Kosten für das Rechenzentrum usw. nicht berücksichtigt: Diese werden sowohl für die klassische Architektur als auch für die HyperFlex-Lösung gleich sein.
In Bezug auf die Kosten war HyperFlex um 5 % teurer. Hier ist zu beachten, dass die Ressourcen CPU/RAM bei Cisco unausgewogen waren, da ich die Kanäle der Speichercontroller gleichmäßig konfiguriert habe. Die Kosten sind etwas höher, aber nicht exorbitant, was eindeutig darauf hindeutet, dass Hyperkonvergenz nicht unbedingt ein "Spielzeug für Reiche" ist, sondern mit dem Standardansatz zum Aufbau eines Rechenzentrums konkurrieren kann. Dies könnte auch für diejenigen interessant sein, die bereits Cisco UCS-Server und die entsprechende Infrastruktur dafür haben.
Zu den Vorteilen gehören das Fehlen von Kosten für die Verwaltung von SAN und Speicherlösungen, Online-Kompression und Deduplizierung, ein einziger Zugangspunkt für den Support (Virtualisierung, Server, ebenfalls Speicherlösungen), Platzersparnis (aber nicht in allen Szenarien) und vereinfachte Betriebsführung.
In Bezug auf den Support erhalten Sie diesen von einem Anbieter – Cisco. Aufgrund meiner Erfahrungen mit Cisco UCS-Servern bin ich damit zufrieden, bei HyperFlex musste ich nicht eingreifen; alles funktionierte problemlos. Die Ingenieure antworten schnell und können nicht nur Standardprobleme lösen, sondern auch komplexe Grenzfälle. Manchmal wende ich mich mit Fragen an sie: "Kann man das so machen, das hier anbringen?" oder "Ich habe hier etwas konfiguriert, und es will nicht funktionieren. Helfen Sie mir!" – sie helfen mir geduldig, den richtigen Leitfaden zu finden und die richtigen Schritte aufzuzeigen; sie werden nicht einfach sagen: "Wir lösen nur Hardwareprobleme."
Links
- Meine E-Mail ist StGeneralov@croc.ru
Quelle: habr.com
