

Hallo, Habra!
Nach den Neujahrsfeierlichkeiten haben wir die katastrophensichere Cloud auf Basis von zwei Standorten neu gestartet. Heute erklären wir, wie das funktioniert und zeigen, was mit den virtuellen Maschinen der Kunden passiert, wenn einzelne Elemente des Clusters ausfallen und die gesamte Infrastruktur zusammenbricht (Spoiler: es geht ihnen gut).
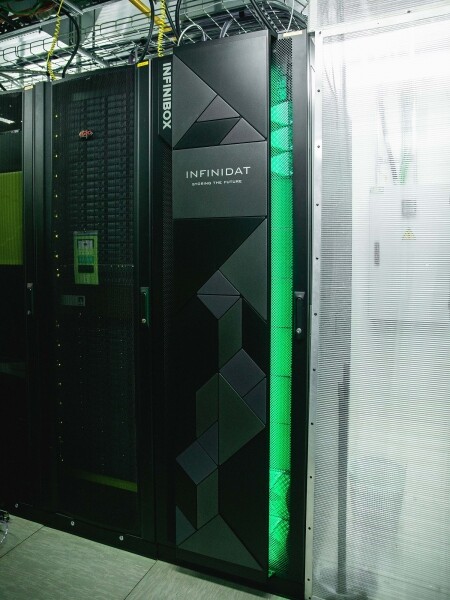
SAS der katastrophensicheren Cloud am Standort OST.
Was ist drin
Im Inneren des Clusters befinden sich Cisco UCS-Server mit dem Hypervisor VMware ESXi, zwei INFINIDAT InfiniBox F2240 SAN-Systeme, Netzwerkgeräte von Cisco Nexus sowie Brocade SAN-Switches. Das Cluster ist auf zwei Standorte verteilt – OST und NORD, d. h. in jedem Rechenzentrum ist die Ausrüstung identisch. Genau das macht es katastrophensicher.
Innerhalb eines Standorts sind auch die Hauptbestandteile dupliziert (Hosts, SAN-Switches, Netzwerke).
Die beiden Standorte sind durch reservierte Glasfaserstrecken verbunden.
Ein paar Worte zu SAN. Die erste Version der katastrophensicheren Cloud haben wir mit NetApp aufgebaut. Hier haben wir uns für INFINIDAT entschieden, und das sind die Gründe:
- Active-Active-Replikationsoption. Sie ermöglicht es der virtuellen Maschine, auch bei einem vollständigen Ausfall eines der SAN-Systeme betriebsfähig zu bleiben. Mehr zur Replikation später.
- Drei Festplattencontroller zur Erhöhung der Fehlertoleranz des Systems. Normalerweise sind es zwei.
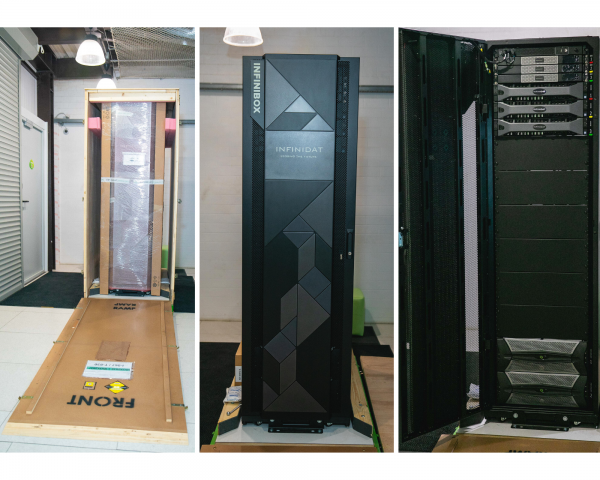
- Fertige Lösung. Uns wurde ein bereits montierter Rack geliefert, der nur noch ans Netzwerk angeschlossen und konfiguriert werden muss.
- Aufmerksamer technischer Support. Die Ingenieure von INFINIDAT analysieren ständig die Protokolle und Ereignisse des SAN, installieren neue Firmware-Versionen und helfen bei der Konfiguration.
Hier sind ein paar Fotos vom Auspacken:
Wie es funktioniert
Die Cloud ist bereits innerhalb ihrer eigenen Infrastruktur katastrophensicher. Sie schützt den Kunden vor einzelnen Hardware- und Softwareausfällen. Die katastrophensichere Lösung hilft, sich vor massiven Störungen innerhalb eines Standorts zu schützen: zum Beispiel beim Ausfall eines SAN-Systems (oder des SDS-Clusters, was häufig vorkommt 🙂), massiven Fehlern im Speichernetzwerk und anderem. Und das Wichtigste: Eine solche Cloud schützt, wenn ein ganzes Rechenzentrum aufgrund von Feuer, Stromausfall, Übernahme durch Dritte oder Alien-Invasion nicht mehr verfügbar ist.
In all diesen Fällen laufen die virtuellen Maschinen der Kunden weiter, und das ist der Grund.
Das Cluster-Schema ist so aufgebaut, dass jeder ESXi-Host mit Client-VMs auf eines der beiden SAN-Systeme zugreifen kann. Wenn das SAN am Standort OST ausfällt, bleiben die virtuellen Maschinen weiterhin in Betrieb: Die Hosts, auf denen sie laufen, werden auf die Daten des SAN am NORD zugreifen.
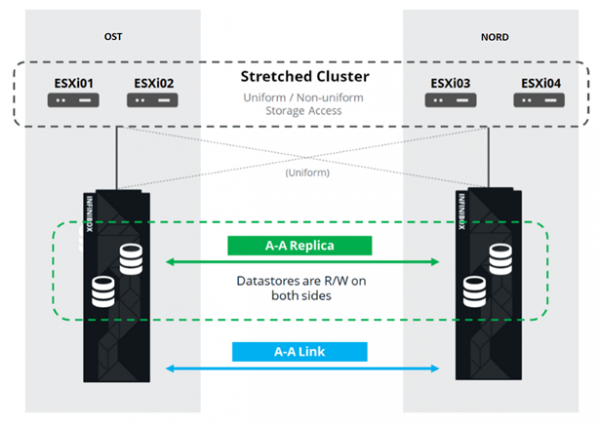
So sieht das Verbindungsdiagramm im Cluster aus.
Dies ist möglich, weil zwischen den SAN-Fabriken der beiden Standorte ein Inter-Switch Link eingerichtet wurde: Der SAN-Switch Fabric A OST ist mit dem SAN-Switch Fabric A NORD verbunden, ebenso wie die SAN-Switches Fabric B.
Damit all diese komplexen Verbindungen der SAN-Fabriken Sinn machen, ist zwischen den beiden SAN-Systemen eine Active-Active-Replikation eingerichtet: Informationen werden fast gleichzeitig auf das lokale und das entfernte SAN geschrieben, RPO=0. Das bedeutet, dass auf einem SAN das Original der Daten gespeichert ist, auf dem anderen die Replik. Die Daten werden auf der Ebene der SAN-Volumes repliziert, und darauf werden die VM-Daten (ihre Festplatten, die Konfigurationsdatei, die Swap-Datei usw.) gespeichert.
Der ESXi-Host sieht das Hauptvolume und seine Replik als ein einzelnes Speichergerät (Storage Device). Vom ESXi-Host zu jedem Speichergerät gibt es 24 Pfade:
12 Pfade verbinden es mit dem lokalen SAN (optimale Pfade), während die anderen 12 mit dem entfernten SAN (nicht optimale Pfade) verbunden sind. In einer regulären Situation greift ESXi mit den "optimalen" Pfaden auf die Daten des lokalen SAN zu. Fällt dieses SAN aus, verliert ESXi die optimalen Pfade und wechselt auf die "nicht optimalen". So sieht es im Diagramm aus.
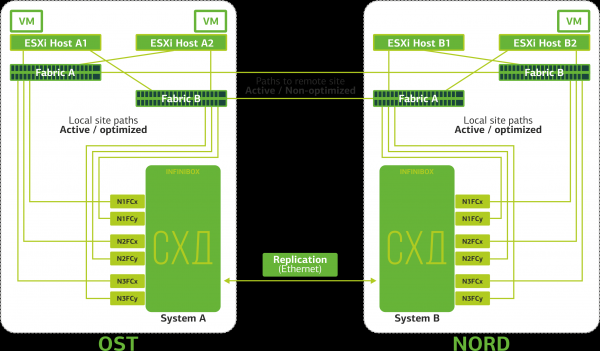
Schema des katastrophensicheren Clusters.
Alle Client-Netze sind über eine gemeinsame Netzwerkfabrik an beide Standorte angeschlossen. An jedem Standort arbeitet ein Provider Edge (PE), an dem die Netzwerke des Kunden terminiert werden. PE sind in einem gemeinsamen Cluster verbunden. Bei einem Ausfall des PE an einem Standort wird der gesamte Verkehr auf den zweiten Standort umgeleitet. Dadurch bleiben die virtuellen Maschinen am Standort, der ohne PE ist, für den Kunden über das Netzwerk zugänglich.
Lassen Sie uns nun untersuchen, was mit den virtuellen Maschinen des Kunden bei verschiedenen Ausfällen passiert. Wir beginnen mit den mildesten Situationen und enden mit dem kritischsten – dem Ausfall des gesamten Standorts. In den Beispielen wird der Hauptstandort OST sein und der Sicherungsstandort mit den Datenreplikaten NORD.
Was passiert mit der virtuellen Maschine des Kunden, wenn…
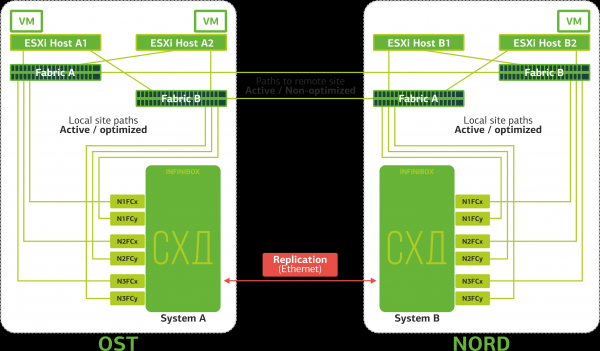
Der Replikationslink ausfällt. Die Replikation zwischen den SAN-Systemen der beiden Standorte wird unterbrochen.
ESXi wird nur mit lokalen Festplattenspeichergeräten (auf optimalen Pfaden) funktionieren.
Virtuelle Maschinen laufen weiterhin.
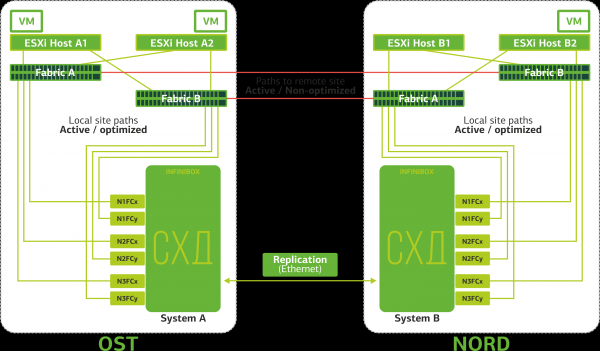
ISL (Inter-Switch-Link) wird unterbrochen. Der Fall ist unwahrscheinlich. Es sei denn, ein durchgeknallter Bagger gräbt mehrere optische Strecken auf einmal um, die auf unabhängigen Routen verlaufen und über verschiedene Einspeisepunkte auf die Standorte geleitet werden. Aber dennoch. In diesem Fall verlieren die ESXi-Hosts die Hälfte der Pfade und können nur auf ihre lokalen SANs zugreifen. Repliken werden gesammelt, aber die Hosts können nicht darauf zugreifen.
Die virtuellen Maschinen arbeiten normal.
Ein SAN-Switch an einer der Standorte fällt aus. Die ESXi-Hosts verlieren Teile der Pfade zu den SANs. In diesem Fall werden die Hosts am Standort, an dem der Switch ausgefallen ist, nur über einen eigenen HBA arbeiten.
Die virtuellen Maschinen laufen dabei weiterhin normal.
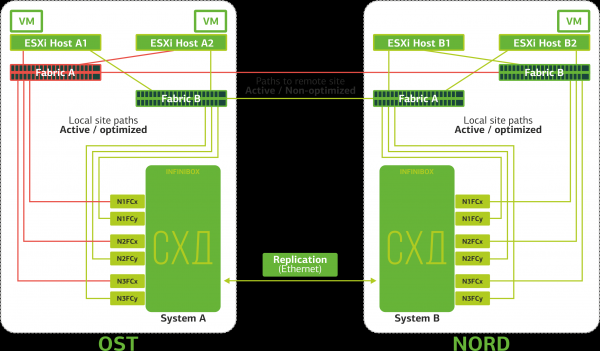
Alle SAN-Switches an einem der Standorte fallen aus. Angenommen, ein solcher Vorfall tritt am Standort OST auf. In diesem Fall verlieren die ESXi-Hosts an diesem Standort alle Pfade zu ihren Speichereinheiten. Der Standardmechanismus von VMware vSphere HA greift ein: Er startet alle virtuellen Maschinen am Standort OST im NORD spätestens nach 140 Sekunden neu.
Die virtuellen Maschinen, die auf den Hosts des Standorts NORD laufen, arbeiten normal.
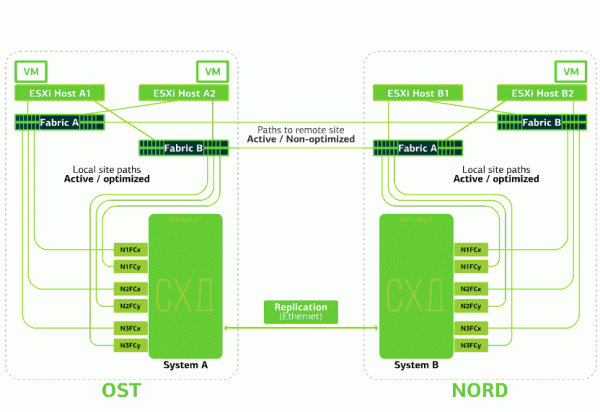
Ein ESXi-Host an einem Standort fällt aus. Hier greift erneut der Mechanismus von vSphere HA: Die virtuellen Maschinen des ausgefallenen Hosts werden auf anderen Hosts neu gestartet – am selben oder an einem anderen Standort. Die Neustartzeit der virtuellen Maschine beträgt bis zu 1 Minute.
Wenn alle ESXi-Hosts am Standort OST ausfallen, gibt es hier keine Optionen: Die VMs werden auf einem anderen Standort neu gestartet. Die Neustartzeit bleibt gleich.
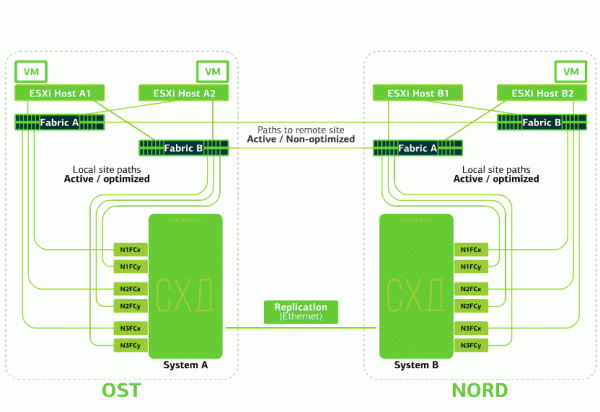
Ein SAN fällt an einem Standort aus. Nehmen wir an, das SAN hat am Standort OST versagt. Dann wechseln die ESXi-Hosts am Standort OST auf den Betrieb mit den Repliken des SAN in NORD. Nach der Wiederherstellung des ausgefallenen SAN wird eine erzwungene Replikation durchgeführt, und die ESXi-Hosts am OST werden wieder auf das lokale SAN zugreifen.
Die virtuellen Maschinen laufen in der gesamten Zeit normal.
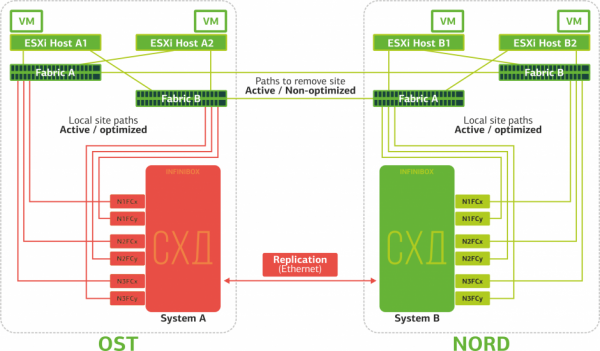
Einer der Standorte fällt aus. In diesem Fall werden alle virtuellen Maschinen über den Mechanismus von vSphere HA auf dem Backup-Standort neu gestartet. Die Neustartzeit der VMs beträgt 140 Sekunden. Dabei bleiben alle Netzwerkeinstellungen der virtuellen Maschine erhalten, und sie bleibt über das Netzwerk für den Kunden verfügbar.
Um sicherzustellen, dass der Neustart der Maschinen auf dem Backup-Gelände problemlos verläuft, ist jede Fläche nur zur Hälfte belegt. Die andere Hälfte ist als Reserve für den Umzug aller virtuellen Maschinen von der zweiten, betroffenen Fläche vorgesehen.
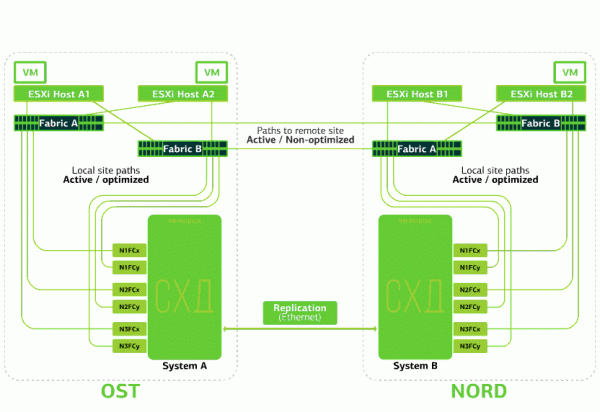
Vor solchen Ausfällen schützt die katastrophensichere Cloud, die auf zwei Rechenzentren basiert.
Dieser Komfort ist nicht billig, da neben den Hauptressourcen auch eine Reserve auf der zweiten Fläche benötigt wird. Daher werden in einer solchen Cloud geschäftskritische Dienste platziert, deren längere Ausfallzeiten erhebliche finanzielle und reputationsbezogene Verluste mit sich bringen, oder wenn an das Informationssystem Anforderungen an die Katastrophensicherheit von Regulierungsbehörden oder internen Vorschriften des Unternehmens gestellt werden.
Quellen:
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish