

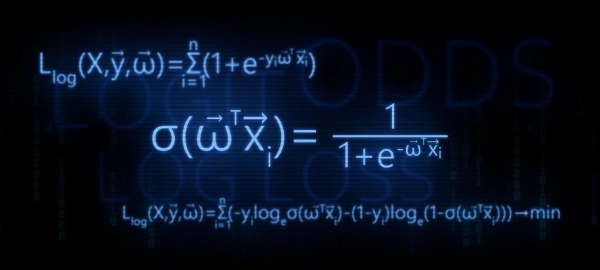
In diesem Artikel werden wir die theoretischen Grundlagen der Transformation der linearen Regression in der inversen Logit-Transformation (auch als logistische Reaktionsfunktion bezeichnet) analysieren.Dann werden wir, unter Nutzung des Arsenal des Maximum-Likelihood-Verfahrens,entsprechend dem Modell der logistischen Regression, die Verlustfunktion Logistic Loss, oder anders gesagt, wir werden die Funktion definieren, mit der in der logistischen Regression die Parameter des Gewichtungsvektors angepasst werden.  .
Artikelübersicht:
- Wir werden die lineare Abhängigkeit zwischen zwei Variablen wiederholen.
- Die Notwendigkeit der Transformation aufzeigen. der linearen Regression
 in der logistischen Reaktionsfunktion
- Wir werden die Transformationen durchführen und ableiten. der logistischen Reaktionsfunktion
- Wir werden versuchen zu verstehen, warum die Methode der kleinsten Quadrate bei der Parameterschätzung ungeeignet ist. Funktionen Logistic Loss
- Verwenden Sie Maximum-Likelihood-Verfahren zur Bestimmung der Parameterschätzfunktion. :
5.1. Fall 1: Funktion Logistic Loss für Objekte mit Klassenbezeichnungen. 0 und 1:
5.2. Fall 2: Funktion Logistic Loss für Objekte mit Klassenbezeichnungen. -1 und +1:
 in der logistischen Reaktionsfunktion

 Funktionen Logistic Loss
 :


Der Artikel ist reich an einfachen Beispielen, bei denen alle Berechnungen leicht mündlich oder schriftlich durchgeführt werden können; in einigen Fällen kann ein Taschenrechner erforderlich sein. Also macht euch bereit 🙂
Dieser Artikel richtet sich hauptsächlich an Data Scientists mit grundlegenden Kenntnissen in den Grundlagen des maschinellen Lernens.
Im Artikel wird auch Code für das Zeichnen von Diagrammen und Berechnungen bereitgestellt. Der gesamte Code ist in der Sprache python 2.7geschrieben. Ich möchte im Voraus auf die „Neuheit“ der verwendeten Version hinweisen – dies ist eine der Voraussetzungen für den Abschluss eines bekannten Kurses von Yandex auf einer ebenso bekannten Online-Bildungsplattform. Coursera, und, wie man annehmen kann, ist das Material inspiriert von diesem Kurs vorbereitet worden.
01. Lineare Abhängigkeit
Es ist sehr vernünftig, die Frage zu stellen – was haben lineare Abhängigkeit und logistische Regression gemeinsam?
Ganz einfach! Die logistische Regression ist eines der Modelle, die zu den linearen Klassifikatoren gehören. Einfach gesagt, besteht die Aufgabe eines linearen Klassifikators darin, Zielwerte  aus Variablen (Regressoren) vorherzusagen.
 Dabei wird angenommen, dass die Abhängigkeit zwischen den Merkmalen
 und den Zielwerten besteht.
 linear. Daher stammt auch der Name des Klassifikators – linear. Wenn man es sehr grob zusammenfassen möchte, dann basiert das Modell der logistischen Regression auf der Annahme einer linearen Abhängigkeit zwischen den Merkmalen.
 und den Zielwerten besteht.
 Hier ist sie – die Verbindung.
Im Studio das erste Beispiel, das richtig über die lineare Abhängigkeit der untersuchten Größen handelt. Bei der Vorbereitung des Artikels bin ich auf ein Beispiel gestoßen, das vielen schon bekannt ist – die Abhängigkeit des elektrischen Stroms von der Spannung. ('Angewandte Regressionsanalyse', N. Draper, H. Smith)Das werden wir hier ebenfalls betrachten.
Entsprechend der nach dem Ohmschen Gesetz:

 — Stromstärke,
 — Spannung,
 — Widerstand.
Wüssten wir nicht das Ohmsche Gesetz, könnten wir die Abhängigkeit empirisch ermitteln, indem wir  variieren und
 messen und dabei
 konstant halten. Dann würden wir sehen, dass das Diagramm der Abhängigkeit
 ab
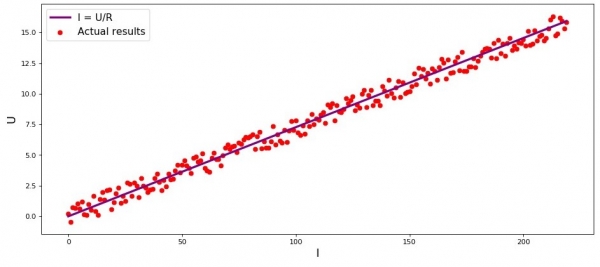
 eine mehr oder weniger gerade Linie zeigt, die durch den Ursprung verläuft. Wir sagen „mehr oder weniger“, da die Abhängigkeit tatsächlich genau ist, unsere Messungen jedoch kleine Fehler enthalten könnten und die Punkte im Diagramm möglicherweise nicht genau auf der Linie liegen, sondern zufällig um sie herum verteilt sind.
Diagramm 1 «Abhängigkeit  ab
 »
Code zum Zeichnen des Diagramms
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Tatsächliche Ergebnisse')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Notwendigkeit von Transformationen in der linearen Regression
Betrachten wir ein weiteres Beispiel. Stellen wir uns vor, wir arbeiten in einer Bank und haben die Aufgabe, die Wahrscheinlichkeit der Rückzahlung eines Kredits durch den Kreditnehmer in Abhängigkeit von bestimmten Faktoren zu ermitteln. Zur Vereinfachung des Problems betrachten wir nur zwei Faktoren: das monatliche Gehalt des Kreditnehmers und die monatliche Rückzahlungsrate des Kredits.
Das Problem ist sehr hypothetisch, aber an diesem Beispiel können wir verstehen, warum es für seine Lösung nicht ausreicht, der linearen Regression, und erfahren, welche Transformationen mit der Funktion durchgeführt werden müssen.
Kehren wir zu unserem Beispiel zurück. Es ist klar, dass je höher das Gehalt, desto mehr kann der Kreditnehmer monatlich zur Tilgung des Darlehens aufbringen. Für einen bestimmten Gehaltsbereich wird dieser Zusammenhang durchaus linear sein. Nehmen wir beispielsweise einen Gehaltsbereich von 60.000 R bis 200.000 R an und gehen wir davon aus, dass in diesem Gehaltsbereich die Abhängigkeit der Höhe der monatlichen Rate vom Gehalt linear ist. Angenommen, für den angegebenen Gehaltsbereich wurde festgestellt, dass das Verhältnis von Gehalt zu Zahlung nicht unter 3 fallen darf und der Kreditnehmer noch 5.000 R zur Verfügung haben sollte. Nur in diesem Fall werden wir Annehmen, dass der Kreditnehmer das Darlehen an die Bank zurückzahlen wird. Dann hat die Gleichung der linearen Regression die folgende Form:

wo  ,
 ,
 ,
 — Gehalt
 des Kreditnehmers,
 — Zahlung des Darlehens
 des Kreditnehmers.
Indem wir das Gehalt und die Zahlung des Darlehens mit festen Parametern in die Gleichung einsetzen,  kann eine Entscheidung über die Gewährung oder Ablehnung des Darlehens getroffen werden.
Um vorzugreifen, sei bemerkt, dass bei den festgelegten Parametern  die Funktion der linearen Regression, die in der logistischen Antwortfunktion verwendet wird, hohe Werte liefern wird, die die Berechnung der Rückzahlungswahrscheinlichkeiten erschweren. Daher wird vorgeschlagen, unsere Koeffizienten, sagen wir, um 25.000 zu reduzieren. Diese Transformation der Koeffizienten wird die Entscheidung über die Kreditausreichung nicht ändern. Merken wir uns diesen Punkt für die Zukunft; nun, um es noch klarer zu machen, worum es geht, betrachten wir die Situation mit drei potenziellen Kreditnehmern.
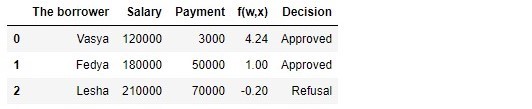
Tabelle 1 „Potenzielle Kreditnehmer“
Code zur Erstellung der Tabelle
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Der Kreditnehmer':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Gehalt':np.array([120000,180000,210000]),
       'Zahlung':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Gehalt']*w_1 + df['Zahlung']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Genehmigt'
        decision.append(dec)
    else:
        dec = 'Ablehnung'
        decision.append(dec)

df['Entscheidung'] = decision

df[['Der Kreditnehmer', 'Gehalt', 'Zahlung', 'f(w,x)', 'Entscheidung']]
Laut den Daten der Tabelle möchte Vasya bei einem Gehalt von 120.000 R einen Kredit aufnehmen, den er mit 3.000 R monatlich tilgen möchte. Wir haben festgestellt, dass das Gehalt von Vasya dreimal höher sein muss als die Zahlung, und dass ihm noch 5.000 R zur Verfügung stehen sollten. Dieses Kriterium erfüllt Vasya:  . Es bleiben sogar 106.000 R. Trotz der Tatsache, dass wir bei der Berechnung
 die Koeffizienten
 um das 25.000-fache verringert haben, bleibt das Ergebnis dasselbe – der Kredit kann genehmigt werden. Fedya wird auch einen Kredit erhalten, während Lesha, obwohl er am meisten verdient, seine Wünsche zurückschrauben muss.
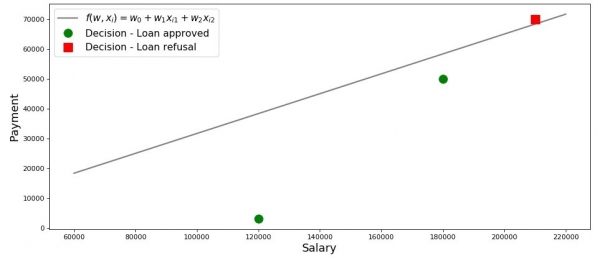
Lass uns in diesem Fall ein Diagramm zeichnen.
Diagramm 2 „Klassifizierung der Kreditnehmer“
Code zum Zeichnen des Diagramms
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Entscheidung - Kredit genehmigt')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Entscheidung - Kredit abgelehnt')
plt.xlabel('Gehalt', size = 16)
plt.ylabel('Zahlung', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Also, unsere Linie, die gemäß der Funktion  , trennt „schlechte“ Kreditnehmer von „guten“. Die Kreditnehmer, deren Wünsche nicht mit den Möglichkeiten übereinstimmen, befinden sich über der Linie (Lesha), während die, die gemäß den Parametern unseres Modells in der Lage sind, den Kredit zurückzuzahlen, sich unter der Linie befinden (Vasya und Fedya). Anders ausgedrückt – unsere Linie teilt die Kreditnehmer in zwei Klassen. Wir bezeichnen sie wie folgt: zur Klasse
 gehören die Kreditnehmer, die wahrscheinlich den Kredit zurückzahlen werden, zur Klasse
 oder
 gehören die Kreditnehmer, die wahrscheinlich den Kredit nicht zurückzahlen können.
Fassen wir die Ergebnisse aus diesem einfachen Beispiel zusammen. Nehmen wir einen Punkt  und setzen die Koordinaten des Punktes in die entsprechende Gleichung der Linie ein
 , betrachten wir drei Optionen:
- Wenn sich der Punkt unter der Linie befindet und wir ihn der Klasse zuordnen, dann wird der Wert der Funktion positiv aus sein. bis Das bedeutet, wir können annehmen, dass die Wahrscheinlichkeit der Rückzahlung des Kredits im Bereich von liegt. Je größer der Funktionswert, desto höher die Wahrscheinlichkeit.
- Wenn sich der Punkt über der Linie befindet und wir ihn der Klasse oder zuordnen, dann wird der Funktionswert negativ aus bis . Dann betrachten wir die Wahrscheinlichkeit der Rückzahlung der Schuld im Bereich von , und je größer der Betrag des Funktionswertes ist, desto höher ist unser Vertrauen.
- Der Punkt liegt auf der Linie, an der Grenze zwischen den beiden Klassen. In diesem Fall wird der Funktionswert gleich sein und die Wahrscheinlichkeit der Rückzahlung des Kredits beträgt .
 zuordnen, dann wird der Wert der Funktion
 positiv aus sein.
 bis
 Das bedeutet, wir können annehmen, dass die Wahrscheinlichkeit der Rückzahlung des Kredits im Bereich von
 liegt. Je größer der Funktionswert, desto höher die Wahrscheinlichkeit.
 oder
 zuordnen, dann wird der Funktionswert negativ aus
 bis
 . Dann betrachten wir die Wahrscheinlichkeit der Rückzahlung der Schuld im Bereich von
 , und je größer der Betrag des Funktionswertes ist, desto höher ist unser Vertrauen.
 gleich
 sein und die Wahrscheinlichkeit der Rückzahlung des Kredits beträgt
 .
Nun stellen wir uns vor, dass wir nicht zwei Faktoren, sondern Dutzende haben, und nicht drei Kreditnehmer, sondern Tausende. Dann haben wir anstelle einer Linie. m-metrisch Ebene und Koeffizienten  werden nicht aus der Luft gegriffen, sondern nach allen Regeln abgeleitet, basierend auf den gesammelten Daten über Kreditnehmer, die Kredite zurückgezahlt oder nicht zurückgezahlt haben. Und tatsächlich, beachten Sie, wir wählen jetzt Kreditnehmer aus, basierend auf bereits bekannten Koeffizienten
 . Tatsächlich besteht die Aufgabe des Modells der logistischen Regression darin, die Parameter zu bestimmen
 , bei denen der Wert der Verlustfunktion Logistic Loss minimal streben wird. Doch wie der Vektor berechnet wird,
 , erfahren wir noch im fünften Abschnitt des Artikels. Doch bevor wir zu unserem Banker und seinen drei Kunden zurückkehren,
wissen wir dank der Funktion  , wem wir einen Kredit gewähren können und wem nicht. Aber mit solchen Informationen kann man nicht zum Direktor gehen, denn man wollte von uns die Wahrscheinlichkeit der Rückzahlung des Kredits durch jeden Kreditnehmer haben. Was tun? Die Antwort ist einfach — wir müssen die Funktion
 , deren Werte im Bereich
 liegen, in eine Funktion umwandeln, deren Werte im Bereich
 liegen. Und eine solche Funktion existiert, sie wird genannt logistische Regressionsfunktion oder logit-Transformation. Lernen Sie kennen:

Schauen wir uns Schritt für Schritt an, wie die logistische Regressionsfunktionentsteht. Wir werden beachten, dass wir rückwärts gehen werden, d.h. wir nehmen an, dass uns der Wert der Wahrscheinlichkeit bekannt ist, der im Bereich von  bis
 liegt, und danach werden wir diesen Wert über das gesamte Zahlenfeld von
 bis
 .
03 entfalten. Wir leiten die logistische Regressionsfunktion ein.
Schritt 1. Wir konvertieren die Wahrscheinlichkeiten in den Bereich

Während der Transformation der Funktion  in der logistischen Reaktionsfunktion
 lassen wir unseren Kreditanalytiker in Ruhe, und stattdessen besuchen wir Wettbüros. Nein, natürlich werden wir keine Wetten abschließen, alles was uns dort interessiert, ist die Bedeutung des Ausdrucks, zum Beispiel die Chance von 4 zu 1. Die Chancen, die allen Wettspielern bekannt sind, sind das Verhältnis von "Erfolgen" zu "Misserfolgen". Aus der Sicht der Wahrscheinlichkeiten ist die Chance die Wahrscheinlichkeit des Eintretens eines Ereignisses geteilt durch die Wahrscheinlichkeit, dass das Ereignis nicht eintritt. Schreiben wir die Formel für die Wahrscheinlichkeit des Eintretens eines Ereignisses auf
 :

 — Wahrscheinlichkeit des Eintretens des Ereignisses,
 — Wahrscheinlichkeit des NICHT-Eintretens des Ereignisses
Zum Beispiel, wenn die Wahrscheinlichkeit, dass das junge, starke und flinke Pferd mit dem Namen „Wetterchen“ das alte, schlaffe Weibchen mit dem Namen „Matilda“ bei einem Rennen überholt, gleich ist  , dann betragen die Chancen für „Wetterchen“
 zu

 und umgekehrt, wissen wir die Chancen, fällt es uns leicht, die Wahrscheinlichkeit zu berechnen
 :

So haben wir gelernt, die Wahrscheinlichkeit in Chancen „zu übersetzen“, die Werte von  bis
 . Lassen Sie uns einen weiteren Schritt machen und lernen, die Wahrscheinlichkeit auf die gesamte Zahlengerade von
 bis
 .
Schritt 2. Lassen Sie uns die Wahrscheinlichkeitswerte in den Bereich

Dieser Schritt ist sehr einfach – wir logarithmieren die Chancen zur Basis der Eulerschen Zahl  und erhalten:

Jetzt wissen wir, dass wenn  , dann ist es sehr einfach, den Wert zu berechnen
 , und mehr noch, er sollte positiv sein:
 . Das trifft zu.
Aus Neugier werden wir überprüfen, dass wenn  , dann erwarten wir, einen negativen Wert zu sehen
 . Überprüfen wir:
 . Alles korrekt.
Jetzt wissen wir, wie wir den Wahrscheinlichkeitswert von  bis
 auf die gesamte Zahlengerade von
 bis
 . Im nächsten Schritt machen wir alles umgekehrt.
Bis dahin beachten wir, dass gemäß den Regeln des Logarithmierens, wenn wir den Funktionswert kennen  , können wir die Chancen berechnen:

Diese Methode zur Bestimmung der Chancen wird uns im nächsten Schritt nützlich sein.
Schritt 3. Lassen Sie uns die Formel zur Bestimmung

Also haben wir gelernt, dass wir, wenn wir wissen  , die Werte der Funktion finden können
 . Aber tatsächlich brauchen wir alles genau umgekehrt – wenn wir den Wert kennen
 , um
 zu finden. Dazu gehen wir auf das Konzept der inversen Funktion der Chancen zurück, gemäß dem:

In diesem Artikel werden wir die genannte Formel nicht ableiten, aber wir werden sie mit den Zahlen aus dem obigen Beispiel überprüfen. Wir wissen, dass bei Chancen von 4 zu 1 ( ), die Wahrscheinlichkeit des Eintretens eines Ereignisses 0,8 beträgt (
 ). Lassen Sie uns substituieren:
 . Das stimmt mit unseren vorherigen Berechnungen überein. Gehen wir weiter.
Im letzten Schritt haben wir abgeleitet, dass  , was bedeutet, dass wir in der inversen Funktion der Chancen substituieren können. Wir erhalten:

Teilen wir sowohl den Zähler als auch den Nenner durch  , dann:

Um sicherzustellen, dass wir uns nicht geirrt haben, machen wir eine weitere kleine Überprüfung. In Schritt 2 haben wir für  festgelegt, dass
 . Dann, indem wir den Wert
 in die logistische Reaktionsfunktion einsetzen, erwarten wir, dass wir
 . Wir setzen ein und erhalten:

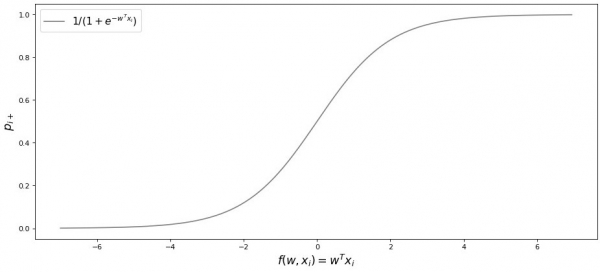
Herzlichen Glückwunsch, geschätzter Leser, wir haben gerade die logistische Reaktionsfunktion entwickelt und getestet. Lassen Sie uns das Diagramm der Funktion betrachten.
Diagramm 3 „Logistische Reaktionsfunktion“
Code zum Zeichnen des Diagramms
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
In der Literatur kann man diese Funktion auch unter dem Namen antreffen Sigmoidfunktion. Der Grafik ist gut zu entnehmen, dass die wesentliche Änderung der Wahrscheinlichkeit, dass ein Objekt einer Klasse angehört, in einem relativ kleinen Bereich erfolgt  , irgendwo von
 bis
 .
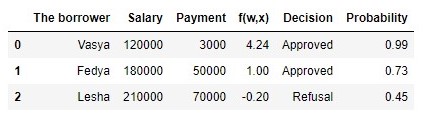
Ich schlage vor, zu unserem Kreditanalytiker zurückzukehren und ihm bei der Berechnung der Rückzahlungswahrscheinlichkeit zu helfen, sonst läuft er Gefahr, ohne Bonus dazustehen 🙂
Tabelle 2 „Potenzielle Kreditnehmer“
Code zur Erstellung der Tabelle
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probability'] = proba

df[['Der Kreditnehmer', 'Gehalt', 'Zahlung', 'f(w,x)', 'Entscheidung', 'Wahrscheinlichkeit']]
So haben wir die Wahrscheinlichkeit der Rückzahlung des Kredits ermittelt. Im Großen und Ganzen scheint das der Wahrheit zu entsprechen.
Tatsächlich liegt die Wahrscheinlichkeit, dass Wassja mit einem Gehalt von 120.000 R seine monatlichen Zahlungen von 3.000 R an die Bank leisten kann, nahe bei 100 %. Übrigens müssen wir verstehen, dass die Bank auch Lesha einen Kredit gewähren kann, wenn die Politik der Bank zum Beispiel die Kreditvergabe an Kunden mit einer Wahrscheinlichkeit der Kreditrückzahlung von mehr als, sagen wir, 0,3 vorsieht. In diesem Fall bildet die Bank einfach einen größeren Rückhalt für mögliche Verluste.
Es sollte auch angemerkt werden, dass das Verhältnis von Gehalt zu Zahlung von mindestens 3 und mit einem Puffer von 5.000 R willkürlich gewählt wurde. Daher konnten wir den Gewichtungsvektor nicht in seiner ursprünglichen Form verwenden  . Wir mussten die Koeffizienten stark reduzieren, und in dem Fall haben wir jeden Koeffizienten durch 25.000 geteilt, das heißt, im Grunde haben wir das Ergebnis angeglichen. Aber das wurde bewusst gemacht, um das Verständnis des Materials zu Beginn zu vereinfachen. In der Realität müssen wir jedoch nicht erfinden und anpassen, sondern sie finden. Genau in den nächsten Abschnitten des Artikels werden wir die Gleichungen herleiten, mit denen die Parameter bestimmt werden.
 .
04. Methode der kleinsten Quadrate zur Bestimmung des Gewichtungsvektors in der logistischen Reaktionsfunktion
 in der logistischen Reaktionsfunktion
Uns ist bereits eine solche Methode zur Anpassung des Gewichtungsvektors bekannt  , wie die Methode der kleinsten Quadrate (MNLK) Und warum sollten wir ihn dann nicht in den Aufgaben der binären Klassifikation verwenden? Tatsächlich gibt es nichts, was dagegen spricht, ihn zu nutzen. OLS, aber diese Methode in Klassifikationsaufgaben liefert weniger genaue Ergebnisse als Logistic Loss. Dafür gibt es eine theoretische Grundlage. Lassen Sie uns zunächst ein einfaches Beispiel ansehen.
Angenommen, unsere Modelle (die MSE und Logistic Loss) haben bereits mit der Anpassung des Gewichtungsvektors begonnen  und wir haben die Berechnung in einem bestimmten Schritt gestoppt. Es spielt keine Rolle, ob in der Mitte, am Ende oder am Anfang; wichtig ist, dass wir bereits einige Werte des Gewichtungsvektors haben und annehmen, dass in diesem Schritt die Gewichtungsvektoren
 beider Modelle keine Unterschiede aufweisen. Nehmen wir also die erhaltenen Gewichte und setzen sie ein in der logistischen Reaktionsfunktion (
 ) für ein beliebiges Objekt, das zur Klasse gehört
 . Wir untersuchen zwei Fälle: einmal, wenn unser Modell gemäß dem angepassten Gewichtungsvektor stark falsch liegt, und umgekehrt — wenn das Modell sich sehr sicher ist, dass das Objekt zur Klasse gehört
 . Lassen Sie uns anschauen, welche Strafzahlungen bei der Verwendung von OLS und Logistic Loss.
Code zur Berechnung der Strafen abhängig von der verwendeten Verlustfunktion
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Fall mit grobem Fehler — das Modell weist das Objekt mit einer Wahrscheinlichkeit von 0,01 der Klasse zu.  Die Strafe bei der Verwendung von
beträgt: OLS Fall mit starker Sicherheit

beträgt: Logistic Loss Fall mit starker Sicherheit

mit einer Wahrscheinlichkeit von 0,99. — das Modell weist das Objekt mit einer Wahrscheinlichkeit von 0,01 der Klasse zu.  Dieses Beispiel veranschaulicht gut, dass bei grobem Fehler die Verlustfunktion
beträgt: OLS Fall mit starker Sicherheit

beträgt: Logistic Loss Fall mit starker Sicherheit

Log Loss das Modell wesentlich stärker bestraft als . Lassen Sie uns nun herausfinden, welche theoretischen Voraussetzungen für die Verwendung der Verlustfunktion MSEin Klassifikationsaufgaben gelten. das Modell wesentlich stärker bestraft als 05. Maximum-Likelihood-Methode und logistische Regression
Wie zu Beginn versprochen, strotzt der Artikel vor einfachen Beispielen. Im Studio ein weiteres Beispiel und alte Bekannte — die Bankkreditnehmer: Wassja, Fedja und Lesja.
Vorsichtshalber, bevor wir das Beispiel weiterentwickeln, erinnere ich daran, dass wir im wirklichen Leben mit einem Trainingsdatensatz von Tausenden oder Millionen von Objekten mit Dutzenden oder Hunderten von Merkmalen zu tun haben. Hier wurden die Zahlen jedoch so gewählt, dass sie leicht im Kopf eines angehenden Data Scientists verankert werden können.
Um auf Nummer sicher zu gehen, erinnere ich daran, dass wir im Leben mit einem Trainingsdatensatz aus tausenden oder Millionen von Objekten mit Dutzenden oder Hunderten von Merkmalen arbeiten. Die Zahlen wurden hier jedoch so gewählt, dass sie leicht im Kopf eines beginnenden Data Scientists bleiben.
Kehren wir zu unserem Beispiel zurück. Stellen wir uns vor, der Bankdirektor beschloss, Kredite an alle Bedürftigen zu vergeben, obwohl der Algorithmus angezeigt hatte, dass er es Alex nicht gewähren sollte. Und so verging genügend Zeit, und wir erfuhren, wer von den drei Protagonisten den Kredit zurückgezahlt hat und wer nicht. Wie zu erwarten war, haben Wanja und Fedja den Kredit zurückgezahlt, Alex jedoch nicht. Stellen wir uns nun vor, dieses Ergebnis wird für uns zu einer neuen Trainingsdatenreihe, während wir gleichzeitig so tun, als ob alle Daten zu den Faktoren, die die Wahrscheinlichkeit der Rückzahlung des Kredits beeinflussen (Einkommen des Kreditnehmers, Höhe der monatlichen Zahlung), verschwunden wären. Dann können wir intuitiv annehmen, dass jeder dritte Kreditnehmer dem Kreditgeber den Kredit nicht zurückzahlt, oder anders gesagt, dass die Wahrscheinlichkeit, dass der nächste Kreditnehmer den Kredit zurückzahlt, niedrig ist.  . Dieser intuitive Annahme liegt eine theoretische Bestätigung zugrunde, die sich auf die Maximum-Likelihood-Methode, die in der Literatur oft als Maximum-Likelihood-Prinzip.
bezeichnet wird. Zunächst lassen Sie uns mit dem Begriff vertraut machen.
Die Wahrscheinlichkeit der Stichprobe ist die Wahrscheinlichkeit, genau diese Stichprobe, genau diese Beobachtungen / Ergebnisse zu erhalten, d.h. das Produkt der Wahrscheinlichkeiten für jedes der Ergebnisse der Stichprobe (zum Beispiel, dass Wanja, Fedja und Alex gleichzeitig den Kredit zurückgezahlt oder nicht zurückgezahlt haben).
Die Likelihood-Funktion verknüpft die Wahrscheinlichkeit der Stichprobe mit den Werten der Verteilungsparameter.
In unserem Fall stellt die Trainingsprobe ein verallgemeinertes Bernoulli-Schema dar, bei dem die Zufallsvariable nur zwei Werte annimmt:  oder
 . Daher kann die Wahrscheinlichkeit der Stichprobe als Funktion der Likelihood des Parameters formuliert werden.
 folgendermaßen ausführen:


Die obige Darstellung kann wie folgt interpretiert werden. Die gemeinsame Wahrscheinlichkeit, dass Wanja und Fedja den Kredit zurückzahlen, ist gleich  , die Wahrscheinlichkeit, dass Alex den Kredit NICHT zurückzahlt, ist gleich
 (da tatsächlich keine Rückzahlung des Kredits stattfand), daher ist die gemeinsame Wahrscheinlichkeit aller drei Ereignisse gleich
 .
Die Maximum-Likelihood-Methode ist eine Methode zur Schätzung eines unbekannten Parameters durch Maximierung der Likelihood-Funktion. In unserem Fall muss der Wert gefunden werden,  , für den
 maximal ist.
Woher stammt eigentlich die Idee, den Wert eines unbekannten Parameters zu suchen, bei dem die Likelihood-Funktion ihr Maximum erreicht? Die Wurzeln der Idee stammen aus der Vorstellung, dass die Stichprobe die einzige verfügbare Informationsquelle über die Grundgesamtheit ist. Alles, was wir über die Grundgesamtheit wissen, ist in der Stichprobe enthalten. Daher können wir nur sagen, dass die Stichprobe die genaueste Darstellung der Grundgesamtheit ist, die uns zur Verfügung steht. Folglich müssen wir einen Parameter finden, bei dem die gegebene Stichprobe am wahrscheinlichsten ist.
Offensichtlich handelt es sich um eine Optimierungsaufgabe, bei der ein Extrempunkt der Funktion gefunden werden muss. Um einen Extrempunkt zu finden, muss die Bedingung erster Ordnung betrachtet werden, das heißt, die Ableitung der Funktion wird gleich null gesetzt und die Gleichung nach dem gesuchten Parameter gelöst. Der Versuch, die Ableitung eines Produkts vieler Faktoren zu finden, kann jedoch langwierig sein; um dies zu vermeiden, gibt es eine spezielle Methode – den Übergang zum Logarithmus. Likelihood-Funktion. Warum ist ein solcher Übergang möglich? Beachten wir, dass wir nicht das Extremum der Funktion selbst suchen, , sondern den Extrempunkt, also den Wert des unbekannten Parameters,
 , für den
 der das Maximum erreicht. Bei der Umstellung auf den Logarithmus bleibt der Extrempunkt unverändert (auch wenn das Extremum selbst anders sein wird), da der Logarithmus eine monotone Funktion ist.
Lassen Sie uns gemäß dem Vorstehenden unser Beispiel mit den Krediten von Wanja, Fedja und Lesha weiterentwickeln. Zunächst wechseln wir zu dem Logarithmus der Likelihood-Funktion.:

Jetzt können wir den Ausdruck leicht nach  :

differenzieren. Und schließlich betrachten wir die Bedingung erster Ordnung – wir setzen die Ableitung der Funktion gleich null:

Somit wurde unsere intuitive Schätzung der Wahrscheinlichkeit der Kredittilgung  theoretisch untermauert.
Wunderbar, was sollen wir jetzt mit diesen Informationen tun? Wenn wir annehmen, dass jeder dritte Kreditnehmer das Geld nicht an die Bank zurückzahlt, wird die Bank unweigerlich bankrottgehen. So ist es, aber wenn wir die Wahrscheinlichkeit der Rückzahlung des Kredits als gleich betrachten  Wir haben die Faktoren, die die Rückzahlung des Kredits beeinflussen, nicht berücksichtigt: das Gehalt des Kreditnehmers und die Höhe der monatlichen Zahlung. Erinnern wir uns, dass wir zuvor die Wahrscheinlichkeit der Rückzahlung des Kredits für jeden Kunden unter Berücksichtigung dieser Faktoren berechnet haben. Es ist logisch, dass sich auch die Wahrscheinlichkeiten von der konstanten Wahrscheinlichkeit unterscheiden.
 .
Lassen Sie uns die Wahrscheinlichkeit der Stichproben bestimmen:
Code zur Berechnung der Wahrscheinlichkeiten der Stichproben
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Wahrscheinlichkeit der Stichprobe bei konstantem Wert p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Wahrscheinlichkeit der Stichprobe bei berechnetem Wert p:', round(likelihood(y,p_log_response),3)
Wahrscheinlichkeit der Stichprobe bei konstantem Wert  :

Wahrscheinlichkeit der Stichprobe bei Berechnung der Rückzahlungswahrscheinlichkeit unter Berücksichtigung der Faktoren  :


Die Wahrscheinlichkeit der Stichprobe, die mit berücksichtigten Faktoren berechnet wurde, war höher als die Wahrscheinlichkeit bei konstantem Wert. Was bedeutet das? Es bedeutet, dass das Wissen über die Faktoren es ermöglicht hat, die Rückzahlungswahrscheinlichkeit für jeden Kunden genauer zu bestimmen. Daher wäre es bei der Vergabe eines neuen Kredits richtiger, das im letzten Abschnitt 3 des Artikels vorgestellte Modell zur Bewertung der Rückzahlungswahrscheinlichkeit zu verwenden.
Aber wenn wir die Wahrscheinlichkeit maximieren müssen, die Funktion der Wahrscheinlichkeit der Stichprobe,, warum nicht einen Algorithmus verwenden, der Wahrscheinlichkeiten für Wanja, Fedya und Lesha beispielsweise gleich 0,99, 0,99 und 0,01 ausgibt? Möglicherweise wird sich ein solcher Algorithmus auf der Trainingsstichprobe gut bewähren, da er den Wert der Wahrscheinlichkeit der Stichprobe näherbringen könnte.  , aber erstens wird ein solcher Algorithmus wahrscheinlich Schwierigkeiten mit der Generalisierungsfähigkeit haben, zweitens wird dieser Algorithmus sicherlich nicht linear sein. Und wenn die Methoden zur Bekämpfung von Überanpassung (also eine schwache Generalisierungsfähigkeit) offensichtlich nicht Teil dieses Artikels sind, dann lassen Sie uns den zweiten Punkt näher betrachten. Dazu genügt es, eine einfache Frage zu beantworten. Kann die Wahrscheinlichkeit der Rückzahlung eines Kredits durch Wassja und Fedja unter Berücksichtigung der uns bekannten Faktoren gleich sein? Nach gesunden Menschenverstand kann die Antwort natürlich nein, kann sie nicht. So wird Wassja 2,5% seines Gehalts pro Monat für die Rückzahlung des Kredits aufwenden, während Fedja fast 27,8% aufbringen wird. Auch auf Grafik 2 „Klassifikation der Kunden“ sehen wir, dass Wassja deutlich weiter von der Linie entfernt ist, die die Klassen trennt, als Fedja. Und schließlich wissen wir, dass die Funktion
 für Wassja und Fedja unterschiedliche Werte annimmt: 4,24 für Wassja und 1,0 für Fedja. Wenn Fedja zum Beispiel ein Vielfaches mehr verdienen oder einen kleineren Kredit beantragen würde, dann wären die Rückzahlungswahrscheinlichkeiten für Wassja und Fedja ähnlich. Mit anderen Worten, eine lineare Abhängigkeit lässt sich nicht täuschen. Und hätten wir tatsächlich die Koeffizienten
 , und nicht aus der Luft gegriffen, könnten wir mit Zuversicht behaupten, dass unsere Werte
 am besten die Wahrscheinlichkeit der Rückzahlung des Kredits durch jeden Kreditnehmer einschätzen, aber da wir vereinbart haben, dass die Bestimmung der Koeffizienten
 nach allen Regeln durchgeführt wurde, werden wir auch so verfahren – unsere Koeffizienten ermöglichen es uns, die Wahrscheinlichkeit besser einzuschätzen 🙂
Aber wir sind abgeschweift. In diesem Abschnitt müssen wir klären, wie der Gewichtungsvektor  , der notwendig ist, um die Wahrscheinlichkeit der Rückzahlung des Kredits durch jeden Kreditnehmer zu bewerten, definiert wird.
Zusammenfassend fassen wir zusammen, mit welchem Arsenal wir auf die Suche nach den Koeffizienten gehen  :
1. Wir nehmen an, dass die Abhängigkeit zwischen der Zielvariable (der prognostizierten Größe) und dem Faktor, der das Ergebnis beeinflusst – linear ist. Aus diesem Grund wird verwendet, die Funktion der linearen Regression vom Typ  , dessen Linie die Objekte (Kunden) in Klassen einteilt
 und
 oder
 (Kunden, die den Kredit zurückzahlen können und solche, die dies nicht können). In unserem Fall hat die Gleichung die Form
 .
2. Wir verwenden die Funktion der inversen Logit-Transformation vom Typ  um die Wahrscheinlichkeit der Zugehörigkeit eines Objekts zur Klasse zu bestimmen
 .
3. Wir betrachten unsere Trainingsstichprobe als eine Umsetzung der Verallgemeinerung Bernoulli-Schemata, das heißt, für jedes Objekt wird eine Zufallsgröße generiert, die mit einer Wahrscheinlichkeit  (eigen für jedes Objekt) den Wert 1 annimmt und mit einer Wahrscheinlichkeit
 – 0.
4. Wir wissen, dass wir maximieren müssen die Funktion der Wahrscheinlichkeit der Stichprobe, , unter Berücksichtigung der angenommenen Faktoren, damit die vorhandene Stichprobe am glaubwürdigsten wird. Mit anderen Worten, wir müssen Parameter finden, bei denen die Stichprobe am glaubwürdigsten ist. In unserem Fall ist der gesuchte Parameter die Wahrscheinlichkeit der Kreditrückzahlung  , die ihrerseits von unbekannten Koeffizienten abhängt
 . Das bedeutet, wir müssen einen solchen Gewichtungsvektor finden
 , bei dem die Glaubwürdigkeit der Stichprobe maximal ist.
5. Wir wissen, dass zur Maximierung der Glaubwürdigkeitsfunktion der Stichprobe kann man verwenden Maximum-Likelihood-Verfahren. Und wir kennen alle Tricks, um mit dieser Methode zu arbeiten.
So ergibt sich eine mehrstufige Vorgehensweise 🙂
Und jetzt erinnern wir uns, dass wir zu Beginn des Artikels zwei Arten von Verlustfunktionen ableiten wollten Logistic Loss , abhängig davon, wie die Klassen der Objekte benannt sind. Es hat sich so ergeben, dass in Klassifikationsaufgaben mit zwei Klassen die Klassen als  und
 oder
 bezeichnet werden. Je nach Benennung ergibt sich die entsprechende Verlustfunktion.
Fall 1. Klassifikation von Objekten in und
 und

Früher, bei der Bestimmung der Glaubwürdigkeit der Stichprobe, bei der die Wahrscheinlichkeit der Rückzahlung der Schulden durch den Kreditnehmer aus Faktoren und vorgegebenen Koeffizienten berechnet wurde  , haben wir die Formel angewendet:

Tatsächlich  — ist das der Wert der logistischen Reaktionsfunktion
 für einen gegebenen Gewichtungsvektor

Dann steht uns nichts im Wege, die Glaubwürdigkeitsfunktion der Stichprobe so zu schreiben:

Es kommt vor, dass es manchmal einigen angehenden Analysten schwerfällt, sofort zu verstehen, wie diese Funktion funktioniert. Lassen Sie uns 4 kurze Beispiele betrachten, die alles klarstellen werden:
1. Wenn  (d.h. gemäß der Trainingsstichprobe gehört das Objekt zur Klasse +1), und unser Algorithmus
 bestimmt die Wahrscheinlichkeit, dass das Objekt zur Klasse
 gleich 0.9 gehört, dann wird dieser Teil der Glaubwürdigkeit der Stichprobe so berechnet:

2. Wenn  , und
 , dann wird die Berechnung so aussehen:

3. Wenn  , und
 , dann wird die Berechnung so aussehen:

4. Wenn  , und
 , dann wird die Berechnung so aussehen:

Offensichtlich wird die Glaubwürdigkeitsfunktion in den Fällen 1 und 3 oder im Allgemeinen maximiert — bei richtig erratenen Werten der Wahrscheinlichkeiten, dass das Objekt zur Klasse gehört  .
In Anbetracht dessen, dass bei der Bestimmung der Wahrscheinlichkeit, dass das Objekt zur Klasse gehört  Uns sind nur die Koeffizienten nicht bekannt
 , die wir suchen werden. Wie oben erwähnt, handelt es sich um ein Optimierungsproblem, bei dem wir zunächst die Ableitung der Likelihood-Funktion nach dem Gewichtungsvektor finden müssen
 . Es macht jedoch Sinn, die Aufgabe im Vorfeld zu vereinfachen: Wir suchen die Ableitung des Logarithmus Likelihood-Funktion.

Warum wir nach der Logarithmierung in der logistischen Fehlerfunktion, haben wir das Vorzeichen geändert von  auf
 . Das ist ganz einfach, da es in der Bewertung der Modellqualität üblich ist, den Funktionswert zu minimieren, haben wir die rechte Seite des Ausdrucks mit
 multipliziert und anstelle von Maximierung minimieren wir nun die Funktion.
Tatsächlich wurde hier gerade vor Ihren Augen die Verlustfunktion mühsam abgeleitet - Logistic Loss für die Trainingsdaten mit zwei Klassen:  und
 .
Um die Koeffizienten zu finden, müssen wir nur die Ableitung finden der logistischen Fehlerfunktion und anschließend, unter Verwendung numerischer Optimierungsmethoden wie Gradientensenkung oder stochastische Gradientensenkung, die optimalsten Koeffizienten ermitteln  . Aber da der Umfang des Artikels bereits nicht unerheblich ist, wird vorgeschlagen, die Differenzierung selbst durchzuführen oder vielleicht wird dies das Thema des nächsten Artikels mit mehr Arithmetik ohne so viele ausführliche Beispiele sein.
Fall 2. Klassifizierung von Objekten in und
 und

Der Ansatz hier wird derselbe sein wie bei den Klassen  und
 , aber der Weg zur Ableitung der Verlustfunktion Logistic Loss, wird verzweigter sein. Lass uns anfangen. Für die Likelihood-Funktion verwenden wir den Operator „wenn…, dann…“. Das heißt, wenn
 das Objekt zur Klasse
 gehört, verwenden wir zur Berechnung der Wahrscheinlichkeit der Auswahl die Wahrscheinlichkeit
 , wenn das Objekt zur Klasse
 gehört, setzen wir in die Likelihood ein
 . So sieht die Likelihood-Funktion aus:

Um es anschaulich zu machen, betrachten wir 4 Fälle:
1. Wenn  und
 , dann wird die Wahrscheinlichkeit der Auswahl „einfließen“

2. Wenn  und
 , dann wird die Wahrscheinlichkeit der Auswahl „einfließen“

3. Wenn  und
 , dann wird die Wahrscheinlichkeit der Auswahl „einfließen“

4. Wenn  und
 , dann wird die Wahrscheinlichkeit der Auswahl „einfließen“

Offensichtlich wird im Fall 1 und 3, wenn die Wahrscheinlichkeiten korrekt vom Algorithmus bestimmt wurden, die Likelihood-Funktion maximiert, und genau das wollten wir erreichen. Dieser Ansatz ist jedoch recht umständlich, und wir werden eine kompaktere Darstellung betrachten. Zunächst logarithmieren wir die Likelihood-Funktion und ändern das Vorzeichen, da wir sie jetzt minimieren werden.

Setzen wir anstelle von  den Ausdruck ein
 :

Vereinfachen wir den rechten Summanden unter dem Logarithmus mit einfachen arithmetischen Methoden und erhalten:

Jetzt ist es an der Zeit, den Operator loszuwerden „wenn…, dann…“. Beachten Sie, dass wenn das Objekt  zur Klasse
 gehört, dann im Ausdruck unter dem Logarithmus, im Nenner,
 in die Potenz
 , wenn das Objekt zur Klasse
 gehoben wird, dann wird $e$ in die Potenz
 . Folglich kann die Darstellung der Potenz vereinfacht werden — beide Fälle können in einem kombiniert werden:
 . Dann die Funktion des logistischen Fehlers nimmt die Form an:

Entsprechend den Regeln der Logarithmierung kehren wir den Bruch um und bringen das Zeichen " " (Minus) aus dem Logarithmus heraus und erhalten:

Vor Ihnen steht die Verlustfunktion logistic Loss, die in Trainingsdatensätzen mit Objekten, die zu Klassen gehören, Anwendung findet:  und
 .
Nun, an dieser Stelle verabschiede ich mich und wir beenden den Artikel.
Die vorherige Arbeit des Autors — „Wir bringen die lineare Regressionsgleichung in eine Matrixdarstellung“
Hilfsmaterialien
1. Literatur
1) Angewandte Regressionsanalyse / N. Draper, G. Smith – 2. Aufl. – Moskau: Finanzen und Statistik, 1986 (Übersetzung aus dem Englischen)
2) Wahrscheinlichkeitstheorie und mathematische Statistik / V.E. Gmurmаn – 9. Aufl. – Moskau: Hochschule, 2003
3) Wahrscheinlichkeitstheorie / N.I. Tschernowa – Nowosibirsk: Staatliche Universität Nowosibirsk, 2007
4) Geschäftsanalyse: Von Daten zu Wissen / Paklin N.B., Oreschkow W.I. – 2. Aufl. – Sankt Petersburg: Piter, 2013
5) Data Science Wissenschaft der Daten von Grund auf / Joel Grass – Sankt Petersburg: BHV Petersburg, 2017
6) Praktische Statistik für Data Science Spezialisten / P. Bruce, E. Bruce – Sankt Petersburg: BHV Petersburg, 2018
2. Vorlesungen, Kurse (Videos)
1)
2)
3)
4)
5)
3. Internetquellen
1)
2)
3)
4)
5)
6)
7)
8)
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish