

In den ersten beiden Artikeln habe ich die Frage der Automatisierung angesprochen und ihren Rahmen skizziert. Im zweiten Artikel habe ich einen Einschub zur Netzwerkvirtualisierung gemacht, als ersten Schritt zur Automatisierung der Dienstkonfiguration.
Jetzt ist es an der Zeit, das Schema des physischen Netzwerks zu skizzieren.
Wenn Sie nicht mit den Geräten in Rechenzentrumsnetzwerken vertraut sind, empfehle ich Ihnen dringend, mit der .
Alle Ausgaben:
Die in dieser Serie beschriebenen Praktiken sollten auf Netzwerke jeder Art, jeder Größe und mit jeder Vielfalt von Anbietern anwendbar sein (nicht). Allerdings kann kein universelles Beispiel für die Anwendung dieser Ansätze beschrieben werden. Daher werde ich mich auf die moderne Architektur des DC-Netzwerks konzentrieren: .
Die DC-Verbindung wird mit MPLS L3VPN hergestellt.
Über dem physischen Netzwerk arbeitet ein Overlay-Netzwerk vom Host aus (das kann VXLAN von OpenStack oder Tungsten Fabric oder etwas anderes sein, was nur grundlegende IP-Konnektivität vom Netzwerk erfordert).
In diesem Fall ergibt sich ein relativ einfaches Automatisierungsszenario, da wir viele Geräte haben, die auf dieselbe Weise konfiguriert werden.
Wir wählen ein sphärisches DC im Vakuum:
- Ein Entwurf für überall.
- Zwei Anbieter, die zwei Netzwerkebenen bilden.
- Ein DC sieht dem anderen zum Verwechseln ähnlich.
Inhalt
- Physische Topologie
- Routing
- IP-Plan
- Labor
- Fazit
- Nützliche Links
Lassen Sie unseren Dienstanbieter LAN_DC, zum Beispiel, Schulungsvideos zum Überleben in steckengebliebenen Aufzügen hosten.
In Metropolen ist dies äußerst beliebt, daher sind viele physische Maschinen erforderlich.
Zuerst werde ich das Netzwerk ungefähr so beschreiben, wie ich es mir wünschen würde. Und dann vereinfache ich es für das Labor.
Physische Topologie
Standorte
LAN_DC wird 6 DCs haben:
- Russland (RU):
- Moskau (msk)
- Kasan (kzn)
- Spanien (SP):
- Barcelona (bcn)
- Málaga (mlg)
- China (CN):
- Shanghai (sha)
- Xi'an (sia)

Intra-DC
In allen DCs identische Netzwerke für die interne Verbindung, basierend auf der Clos-Topologie.
Was Clos-Netzwerke sind und warum gerade sie — in einem separaten .
In jedem DC gibt es 10 Racks mit Maschinen, die nummeriert werden wie A, B, C Und so weiter.
In jedem Rack sind 30 Maschinen. Diese werden uns nicht interessieren.
Außerdem steht in jedem Rack ein Switch, an den alle Maschinen angeschlossen sind — das ist Top of the Rack Switch — ToR oder in den Begriffen der Clos-Fabrik bezeichnet man ihn als Leaf.

Allgemeines Schema der Fabrik.
Wir werden sie nennen XXX-leafY
In den Artikeln werde ich mir erlauben, die Begriffe Leaf und ToR recht frei als Synonyme zu verwenden. Es ist jedoch wichtig, daran zu denken, dass dem nicht so ist.
ToR ist ein Rack-Switch, an den Maschinen angeschlossen sind.
Leaf ist die Rolle eines Geräts im physischen Netzwerk oder ein Switch der ersten Ebene in Bezug auf die Klosetopo.
Das heißt, Leaf != ToR.
So kann ein Leaf beispielsweise ein EndofRaw-Switch sein.
Im Rahmen dieses Artikels werden wir sie allerdings dennoch als Synonyme betrachten.
Jeder ToR-Switch ist wiederum mit vier übergeordneten Aggregations-Switches verbunden — Spine. Für die Spine sind reservierte Racks im DC vorgesehen. Benennen werden wir ähnlich: XXX-spineY.
In diesem Rack wird auch die Netzwerkhardware für die Konnektivität zwischen den DCs stehen — 2 Router mit MPLS an Bord. Aber im Grunde sind das die gleichen ToRs. Das heißt, aus der Sicht der Spine-Switches macht es keinen Unterschied, ob es sich um einen normalen ToR mit angeschlossenen Maschinen oder um einen Router für DCI handelt — es spielt keine Rolle, was weitergeleitet wird.
Solche speziellen ToRs werden Edge-leafgenannt. Wir werden sie benennen XXX-edgeY.
So wird es aussehen.
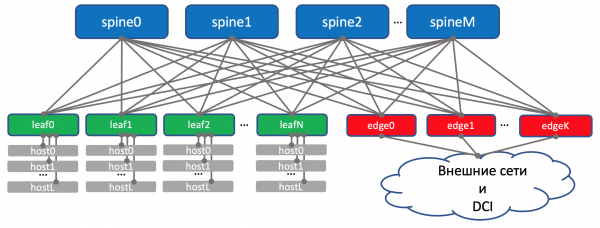
In der obigen Abbildung habe ich edge und leaf tatsächlich auf einer Ebene platziert. haben uns daran gewöhnt, den Uplink (daher auch der Begriff) als die Links nach oben zu betrachten. Hier scheint der 'Uplink' DCI jedoch nach unten zu gehen, was die gewohnte Logik für einige etwas bricht. Bei großen Netzwerken, bei denen die Rechenzentren weiter in kleinere Einheiten aufgeteilt werden — POD‘s (Point Of Delivery), werden separate Edge-POD‘s für DCI und den Zugang zu externen Netzwerken выделены.
Um die Wahrnehmung zu vereinfachen, werde ich dennoch Edge über Spine zeichnen, wobei wir im Hinterkopf behalten werden, dass es auf den Spine keinen Intellekt gibt und keine Unterschiede bei der Arbeit mit normalen Leaf und Edge-leaf (obwohl es hier Nuancen geben kann, aber insgesamt ist es so).
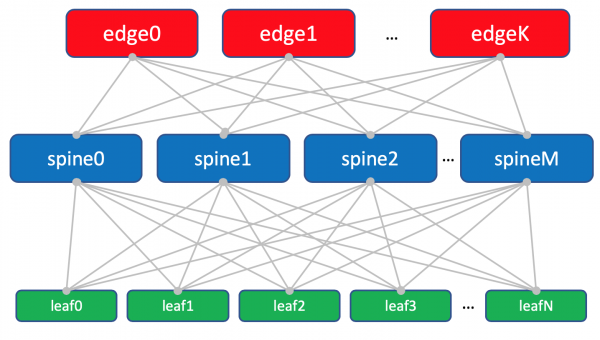
Schema der Fabrik mit Edge-leafs.
Die Dreifaltigkeit Leaf, Spine und Edge bildet ein Underlay-Netzwerk oder Fabrik.
Die Aufgabe der Netzwerkfabrik (aka Underlay), wie wir bereits festgestellt haben, ist sehr einfach — die IP-Konnektivität zwischen Maschinen sowohl innerhalb eines DCs als auch dazwischen sicherzustellen. Deshalb wird das Netzwerk auch als Fabrik bezeichnet, ähnlich wie die Vermittlungsfabrik innerhalb modularer Netzwerkboxen, über die man ausführlicher in
SDM14 .
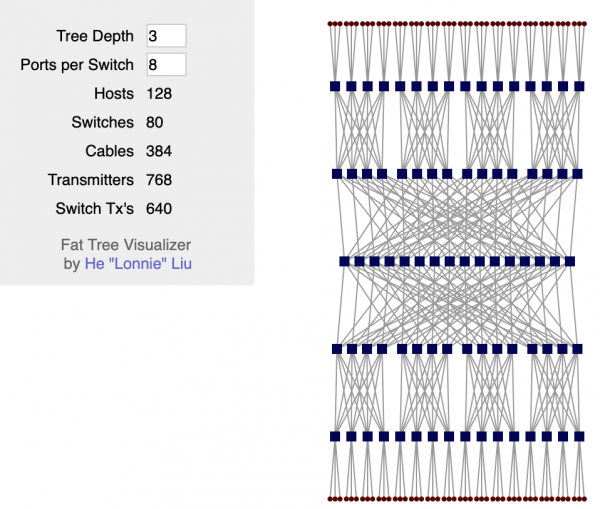
Eine solche Topologie wird im Allgemeinen als Fabrik bezeichnet, weil 'fabric' auf Deutsch 'Gewebe' bedeutet. Und da kann man kaum widersprechen:
Die Fabrik ist vollständig L3. Keine VLANs, keine Broadcasts — so bemerkenswerte Programmierer haben wir im LAN_DC, die Anwendungen schreiben können, die in der L3-Paradigme leben, während virtuelle Maschinen keine Live-Migration mit IP-Adresse benötigen.
Und noch einmal: Die Antwort auf die Frage, warum Fabrik und warum L3, ist in einer separaten .
DCI — Data Center Interconnect (Inter-DC)
DCI wird mit Hilfe von Edge-Leaf organisiert, das heißt, sie sind unser Ausgangspunkt zur Hauptleitung.
Zur Vereinfachung nehmen wir an, dass die DCs durch direkte Links verbunden sind.
Wir lassen die externe Konnektivität außer Betracht.
Mir ist bewusst, dass ich jedes Mal, wenn ich ein Element entferne, das Netzwerk erheblich vereinfache. Bei der Automatisierung unseres abstrakten Netzwerks wird alles gut laufen, aber im realen wird es Bastellösungen geben.
Das ist so. Und dennoch besteht die Aufgabe dieser Reihe darin, nachdenkend und an Ansätzen zu arbeiten, und nicht heroisch erfundene Probleme zu lösen.
Auf den Edge-Leaves wird das Underlay in VPNs gelegt und über das MPLS-Medium übertragen (diese direkten Links).
So ergibt sich ein solches hochrangiges Schema.

Routing
Für die Routing innerhalb des DCs werden wir BGP verwenden.
Über das MPLS-Medium OSPF+LDP.
Für DCI, also zur Organisation der Konnektivität im Underlay — BGP L3VPN über MPLS.
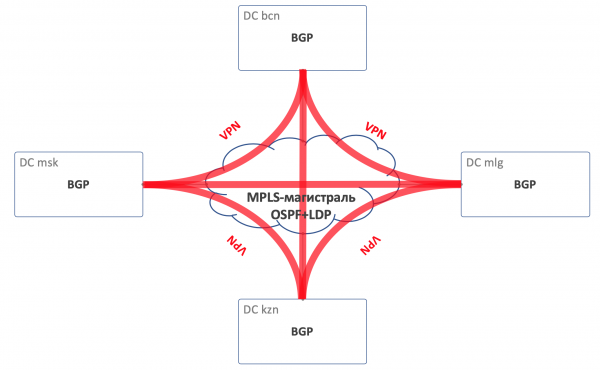
Allgemeines Routing-Schema
In der Fabrik gibt es kein OSPF und kein ISIS (ein in der Russischen Föderation verbotener Routing-Protokoll).
Das bedeutet, dass es keine automatisierte Entdeckung und Berechnung der kürzesten Pfade geben wird — nur manuelle (in Wirklichkeit automatisierte — wir sprechen hier über Automatisierung) Konfiguration des Protokolls, der Nachbarschaften und Politiken.
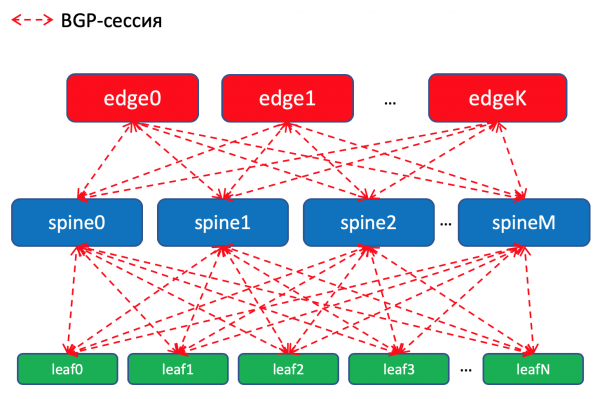
BGP-Routing-Schema innerhalb des DCs
Warum BGP?
Zu diesem Thema gibt es von Facebook und Arista, wo beschrieben wird, wie man sehr große Rechenzentrumsnetzwerke unter Verwendung von BGP aufbaut. Es liest sich fast wie ein Roman, ich empfehle es sehr für einen gemütlichen Abend.
Außerdem gibt es ein ganzes Kapitel in meinem Artikel darüber. Worauf ich Sie auch .
Aber kurz gesagt, keine IGPs sind für große Rechenzentrumsnetze geeignet, wo es sich um tausende Netzwerkgeräte handelt.
Darüber hinaus wird die Verwendung von BGP überall die Notwendigkeit verringern, mehrere verschiedene Protokolle zu unterstützen und zwischen ihnen zu synchronisieren.
Hand aufs Herz, in unserer Fabrik, die mit hoher Wahrscheinlichkeit nicht schnell wachsen wird, wäre es für uns ausreichend, OSPF zu verwenden. Das sind tatsächlich die Probleme von Megaskalierern und Cloud-Titanen. Lassen Sie uns nur für einige Ausgaben fantasieren, dass wir das brauchen, und BGP verwenden, wie es Peter Lapukhov hinterlassen hat.
Routing-Politiken
Auf den Leaf-Switches importieren wir die Präfixe von den Underlay-Interfaces mit den Netzwerken in BGP.
Wir werden eine BGP-Sitzung zwischen jeder Leaf-Spine-Paar haben, in dem diese Underlay-Präfixe über das Netzwerk an- und abgekündigt werden.
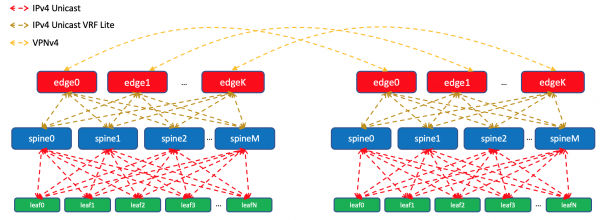
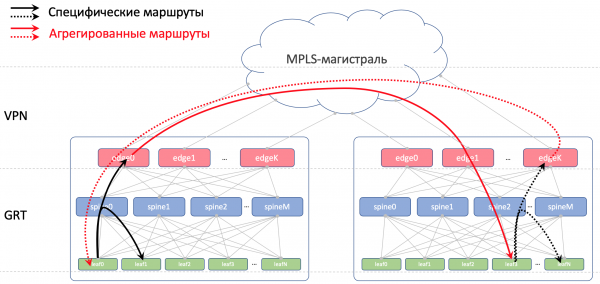
Innerhalb eines Rechenzentrums werden wir die Besonderheiten verbreiten, die wir auf den ToR importiert haben. Auf den Edge-Leaves werden wir sie aggregieren und in entfernte Rechenzentren ankündigen und zu den ToRs bringen. Das heißt, jeder ToR wird genau wissen, wie man zu einem anderen ToR in diesem Rechenzentrum gelangt und wo der Zugangspunkt ist, um zu einem ToR in einem anderen Rechenzentrum zu gelangen.
Im DCI werden die Routen als VPNv4 übertragen. Dafür wird das Edge-Leaf-Interface zur Fabrik in VRF platziert, nennen wir es UNDERLAY, und die Nachbarschaft zum Spine auf dem Edge-Leaf wird innerhalb des VRF etabliert, während zwischen den Edge-Leaves im VPNv4-Familie kommuniziert wird.
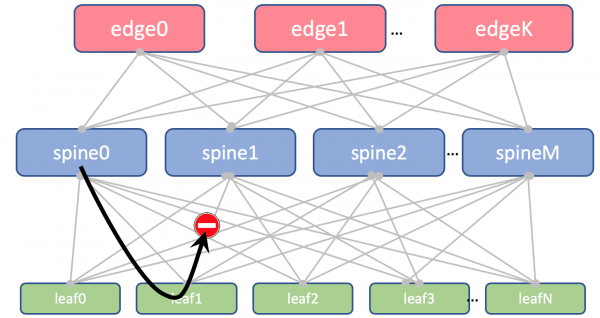
Außerdem werden wir es verbieten, Routen, die von den Spines erhalten wurden, zurück auf sie zu reroutieren.
Auf Leaf und Spine werden wir keine Loopbacks importieren. Sie werden nur benötigt, um die Router-ID zu bestimmen.
Aber auf den Edge-Leaves importieren wir sie in das globale BGP. Zwischen den Loopback-Adressen werden die Edge-Leaves eine BGP-Sitzung in der IPv4 VPN-Familie untereinander aufbauen.
Zwischen den EDGE-Geräten wird unser Backbone auf OSPF+LDP verteilt. Alles in einer Zone. Eine extrem einfache Konfiguration.
So sieht es mit dem Routing aus.
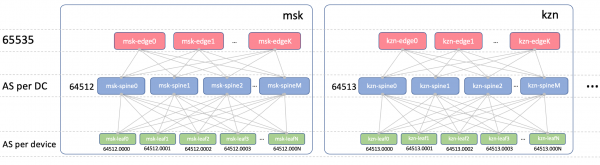
BGP ASN
Edge-Leaf ASN
Auf den Edge-Leaves wird es eine ASN in allen Rechenzentren geben. Dies ist wichtig, damit zwischen den Edge-Leaves iBGP besteht und wir nicht auf die Nuancen von eBGP stoßen. Lassen Sie uns 65535 verwenden. In der Realität könnte das eine Nummer eines öffentlichen AS sein.
Spine ASN
Auf Spine haben wir eine ASN pro Rechenzentrum. Wir beginnen hier mit der allerersten Nummer aus dem Bereich der privaten AS — 64512, 64513 und so weiter.
Warum ASN im Rechenzentrum?
Wir zerlegen diese Frage in zwei:
- Warum gleiche ASN auf allen Spines eines Rechenzentrums?
- Warum unterschiedliche in verschiedenen Rechenzentren?
Warum gleiche ASN auf allen Spines eines Rechenzentrums?
So wird der AS-Pfad der Underlay-Route auf dem Edge-Leaf aussehen:
[leafX_ASN, spine_ASN, edge_ASN]
Wenn versucht wird, ihn zurück auf das Spine anzukündigen, wird es ihn zurückweisen, da sein AS (Spine_AS) bereits auf der Liste steht.
Wir sind jedoch im Rechenzentrum vollkommen zufrieden damit, dass die Underlay-Routen, die bis zum Edge-Point hochgestiegen sind, nicht wieder nach unten gehen können. Alle Kommunikationen zwischen Hosts innerhalb des Rechenzentrums sollten innerhalb der Spine-Ebene stattfinden.
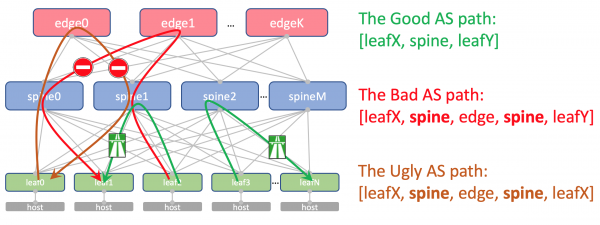
Die aggregierten Routen anderer Rechenzentren werden in jedem Fall ungehindert bis zu den ToR switchen — in ihrem AS-Path wird nur ASN 65535 stehen — die Nummer des AS der Edge-Leafs, da sie genau dafür erstellt wurden.
Warum unterschiedlich in verschiedenen Rechenzentren
Theoretisch könnte es nötig sein, Loopbacks zwischen irgendwelchen Dienst-Virtual-Machines zwischen den Rechenzentren zu ziehen.
Zum Beispiel wird auf dem Host ein Route Reflector oder (Virtual Network Gateway), das sich über BGP mit dem ToR verbindet und sein Loopback ankündigt, welches aus allen Rechenzentren erreichbar sein sollte.
So würde sein AS-Path aussehen:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Und hier darf es keine wiederholenden ASNs geben.
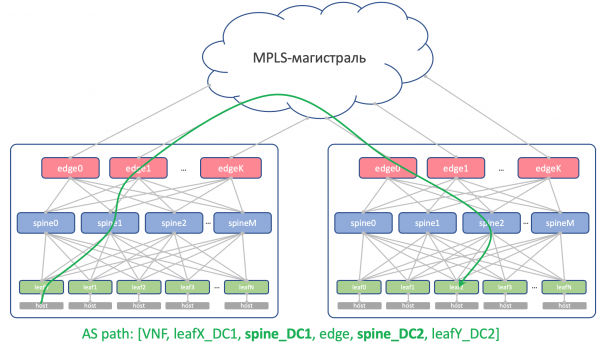
Das bedeutet, dass Spine_DC1 und Spine_DC2 unterschiedlich sein müssen, ebenso wie leafX_DC1 und leafY_DC2, was wir genau anstreben.
Wie Sie wahrscheinlich wissen, gibt es Hacks, die es ermöglichen, Routen mit wiederholenden ASNs trotz des Mechanismus zur Verhinderung von Schleifen zu akzeptieren (allowas-in auf Cisco). Und das hat sogar durchaus legitime Anwendungen. Aber es ist eine potenzielle Lücke in der Netzwerkintegrität. Ich persönlich bin schon ein paar Mal darauf gestoßen.
Wenn wir die Möglichkeit haben, gefährliche Dinge zu vermeiden, werden wir das tun.
Leaf ASN
Wir werden für jeden Leaf-Switch innerhalb des gesamten Netzwerks eine individuelle ASN haben.
Wir machen das aus den oben genannten Gründen: AS-Path ohne Schleifen, BGP-Konfiguration ohne Hintertüren.
Damit die Routen zwischen den Leaf-Switches ungehindert fließen, muss der AS-Path folgendermaßen aussehen:
[leafX_ASN, spine_ASN, leafY_ASN]
wobei leafX_ASN und leafY_ASN voneinander klar unterschieden sein sollten.
Das ist auch für die Situation mit der Ankündigung des VNF-Loopbacks zwischen den Rechenzentren erforderlich:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Wir werden eine 4-Byte-ASN verwenden und sie basierend auf der ASN des Spines und der Nummer des Leaf-Switches generieren, und zwar so: Spine_ASN.0000X.
So sieht das Bild mit ASN aus.
IP-Plan
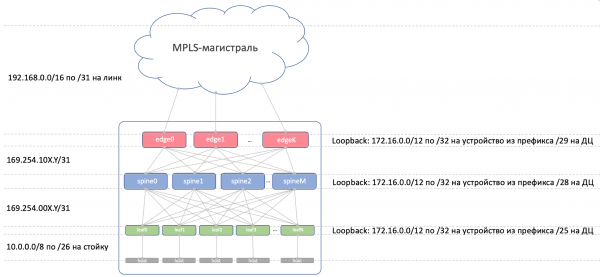
Grundsätzlich müssen wir Adressen für die folgenden Anschlüsse reservieren:
- Die Adressen des Underlay-Netzes zwischen ToR und Maschine. Sie sollten innerhalb des gesamten Netzwerks einzigartig sein, damit jede Maschine mit jeder anderen kommunizieren kann. Besonders geeignet 10/8. Für jedes Rack ein /26 mit Puffer. Wir werden jeweils /19 für das Rechenzentrum und /17 für die Region reservieren.
- Die Verbindungsadressen zwischen Leaf/Tor und Spine.
Sie sollten algorithmisch zugewiesen werden, das heißt, sie werden aus den Namen der Geräte berechnet, die angeschlossen werden müssen.
Lassen Sie uns… 169.254.0.0/16.
Nämlich 169.254.00X.Y/31X — Nummer Spine, Y — P2P-Netzwerk /31.
Dies ermöglicht den Betrieb von bis zu 128 Racks und bis zu 10 Spine in einem Rechenzentrum. Die Verbindungsadressen können (und werden) zwischen Rechenzentren wiederverwendet. - Den Spine - Edge-Leaf organisieren wir in Subnetzen 169.254.10X.Y/31, wo ebenfalls X — Nummer Spine, Y — P2P-Netzwerk /31.
- Die Verbindungsadressen von Edge-Leaf zum MPLS-Kern. Hier ist die Situation etwas anders — der Verbindungspunkt aller Teile in einen großen Keks, deshalb können die gleichen Adressen nicht wiederverwendet werden — es muss das nächste freie Subnetz ausgewählt werden. Daher nehmen wir als Grundlage 192.168.0.0/16 und werden freie Adressen daraus auswühlen.
- Loopback-Adressen. Wir geben ihnen den gesamten Bereich 172.16.0.0/12.
- Leaf — nach /25 im Rechenzentrum — die gleichen 128 Racks. Wir weisen nach /23 für die Region zu.
- Spine — nach /28 im Rechenzentrum — bis zu 16 Spine. Wir weisen nach /26 für die Region zu.
- Edge-Leaf — nach /29 im Rechenzentrum — bis zu 8 Kästen. Wir weisen nach /27 für die Region zu.
Wenn uns im Rechenzentrum die zugewiesenen Bereiche nicht ausreichen (was sie nicht tun werden — wir streben ja Hyper-Skalierung an), weisen wir einfach den nächsten Block zu.
So sieht die IP-Adressierung aus.
Loopback-Adressen:
Präfix
Rolle des Geräts
Region
Rechenzentrum
172.16.0.0/23
edge
172.16.0.0/27
ru
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
ru
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
ru
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Präfix
Region
Rechenzentrum
10.0.0.0/17
ru
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Labor
Zwei Anbieter. Ein Netzwerk. ADSMs.
Juniper + Arista. Ubuntu. Die gute alte Eva.
Die Anzahl der Ressourcen auf unserer virtuellen Maschine im Miran ist dennoch begrenzt, deshalb werden wir für die Praxis ein so stark vereinfachtes Netzwerk verwenden.
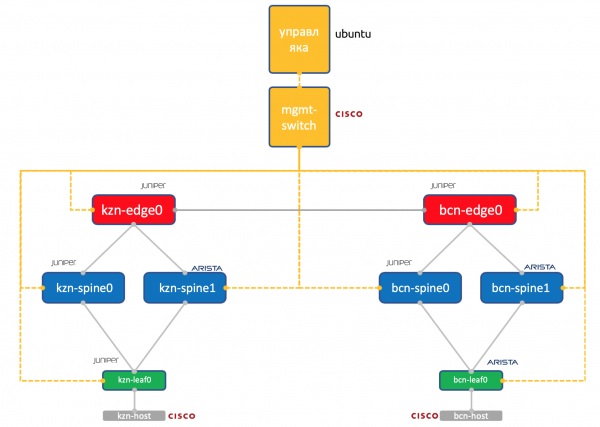
Zwei Rechenzentren: Kasan und Barcelona.
- Je zwei Spines in jedem: Juniper und Arista.
- Je einen Tor (Leaf) in jedem — Juniper und Arista, mit einem angeschlossenen Host (wir nehmen dafür den leichten Cisco IOL).
- Je eine Edge-Leaf-Node (vorerst nur Juniper).
- Ein Cisco-Switch, um sie alle zu beherrschen.
- Neben den Netzwerkgeräten wird eine Verwaltungsvirtualmaschine betrieben. Unter Ubuntu.
Sie hat Zugriff auf alle Geräte, darauf werden IPAM/DCIM-Systeme, ein Bündel von Python-Skripten, Ansible und alles andere, was wir benötigen könnten, laufen.
aller Netzwerkgeräte, die wir versuchen zu automatisieren.
Fazit
Ist das so üblich? Unter jedem Artikel eine kurze Zusammenfassung machen?
Also haben wir gewählt Clos-Netzwerk innerhalb des Rechenzentrums, da wir großen East-West-Traffic erwarten und ECMP wollen.
Das Netzwerk wurde in physikalisch (Underlay) und virtuell (Overlay) unterteilt. Dabei beginnt das Overlay beim Host — damit haben wir die Anforderungen an das Underlay vereinfacht.
Wir haben BGP als das Routing-Protokoll für unterirdische Netzwerke aufgrund seiner Skalierbarkeit und Flexibilität der Richtlinien gewählt.
Wir werden separate Knoten für die DCI-Organisation – Edge-Leaf – haben.
Auf der Backbone wird OSPF+LDP verwendet.
DCI wird auf Basis von MPLS L3VPN implementiert.
Für die P2P-Links werden die IP-Adressen algorithmisch basierend auf den Gerätenamen berechnet.
Loopbacks werden je nach Rolle der Geräte und ihrer Lage nacheinander zugewiesen.
Unterirdische Präfixe – nur auf Leaf-Switches nacheinander basierend auf ihrer Lage.
Angenommen, dass wir im Moment noch keine Hardware installiert haben.
Daher werden unsere nächsten Schritte sein, sie in den Systemen (IPAM, Inventar) zu erfassen, den Zugriff zu organisieren, die Konfiguration zu generieren und diese bereitzustellen.
Im nächsten Artikel werden wir uns mit Netbox – einem System zur Inventarisierung und Verwaltung des IP-Raums im Rechenzentrum – beschäftigen.
Danke
- Andrej Glazkov aka @glazgoo für das Lektorat und die Korrekturen
- Alexander Klimenko aka @v00lk für das Lektorat und die Korrekturen
- Artem Tschernobaj für KDPW
Quelle: habr.com
