

Vorgeschichte
Es gibt eigene Verkaufsautomaten. Im Inneren befindet sich ein Raspberry Pi und etwas Verdrahtung auf einer separaten Platine. Angeschlossen sind ein Münz- und ein Geldscheineinzahlungsgerät sowie ein Bankterminal… Alles wird von einem selbstgeschriebenen Programm gesteuert. Die gesamte Historie der Betriebsabläufe wird auf einem Flash-Laufwerk (MicroSD) in ein Protokoll geschrieben, das dann über das Internet (mithilfe eines USB-Modems) auf einen Server übermittelt wird, wo es in einer Datenbank gespeichert wird. Informationen über Verkäufe werden in 1C hochgeladen; es gibt auch eine einfache Web-Oberfläche zur Überwachung usw.
Das bedeutet, dass das Protokoll lebensnotwendig ist – für die Buchhaltung (Umsatz, Verkäufe usw.), die Überwachung (sämtliche Ausfälle und andere außergewöhnliche Umstände); sozusagen sind das alle Informationen, die wir über diesen Automaten haben.
Problem
Die Flash-Laufwerke erweisen sich als sehr ung zuverlässige Geräte. Sie gehen mit beachtlicher Regelmäßigkeit kaputt. Dies führt sowohl zu Ausfallzeiten der Automaten als auch (wenn das Protokoll aus irgendwelchen Gründen nicht online übermittelt werden konnte) zu Datenverlusten.
Das ist bereits nicht die erste Erfahrung mit Flash-Laufwerken; zuvor gab es ein anderes Projekt mit mehr als hundert Geräten, bei dem das Protokoll auf USB-Flash-Laufwerken gespeichert wurde. Auch dort gab es Probleme mit der Zuverlässigkeit, manchmal war die Anzahl der Ausfälle pro Monat in den Dutzenden. Wir haben verschiedene Flash-Laufwerke getestet, darunter auch Markenprodukte mit SLC-Speicher; ja, einige Modelle sind zuverlässiger als andere, aber der Austausch der Flash-Laufwerke hat das Problem nicht grundlegend gelöst.
Achtung! Long-Read! Wenn Sie nicht interessiert sind an "warum", sondern nur an "wie", können Sie gleich zum Artikel.
Lösung
Das Erste, was mir in den Sinn kommt: auf MicroSD verzichten, beispielsweise ein SSD einsetzen und von dort booten. Theoretisch ist das vielleicht möglich, aber relativ teuer und nicht so zuverlässig (es muss ein USB-SATA-Adapter hinzugefügt werden; die Statistiken über Ausfälle bei budgetfreundlichen SSDs sind ebenfalls nicht erfreulich).
USB HDD sieht auch nicht besonders attraktiv aus.
Deshalb sind wir zu folgender Lösung gekommen: Den Bootvorgang von MicroSD beizubehalten, sie aber im Nur-Lese-Modus zu verwenden und das Betriebsprotokoll (und andere spezifische Informationen für das jeweilige Gerät – Seriennummer, Kalibrierung der Sensoren usw.) woanders zu speichern.
Das Thema read-only FS für den Raspberry Pi wurde bereits umfassend untersucht, ich werde in diesem Artikel nicht auf die Einzelheiten der Umsetzung eingehen. (aber wenn Interesse besteht – vielleicht schreibe ich einen Mini-Artikel zu diesem Thema). Der einzige Punkt, den ich anmerken möchte: sowohl aus persönlicher Erfahrung als auch aus den Rückmeldungen der bereits implementierenden Nutzer ist ein Gewinn an Zuverlässigkeit vorhanden. Ja, es ist unmöglich, vollständig von Ausfällen abzusehen, aber die Häufigkeit erheblich zu reduzieren — das ist durchaus realistisch. Zudem werden die Karten vereinheitlicht, was den Austausch für das Servicepersonal erheblich vereinfacht.
Hardware
Bei der Wahl des Speichertyps gab es keine besonderen Zweifel — NOR Flash.
Argumente:
- einfache Anbindung (meist über SPI-Bus, von dem wir bereits Erfahrungen haben, sodass keine „technischen“ Probleme zu erwarten sind);
- lächerlicher Preis;
- Standardarbeitsprotokoll (eine Implementierung ist bereits im Linux-Kernel vorhanden, bei Bedarf kann man auch Drittanbieterlösungen nutzen, die ebenfalls vorhanden sind, oder sogar eine eigene schreiben, da alles recht einfach ist);
- Zuverlässigkeit und Lebensdauer:
aus einem typischen Datenblatt: die Daten werden 20 Jahre lang aufbewahrt, 100000 Löschzyklen für jeden Block;
aus externen Quellen: extrem niedriger BER, es wird postuliert, dass keine Fehlerkorrekturcodes erforderlich sind. (in einigen Arbeiten wird ECC für NOR betrachtet, aber normalerweise ist hier von MLC NOR die Rede, was ebenfalls vorkommen kann).
Lassen Sie uns die Anforderungen an Volumen und Lebensdauer abschätzen.
Wir wünschen uns, dass die Daten für mehrere Tage sicher gespeichert werden. Dies ist wichtig, damit im Falle von Kommunikationsproblemen die Verkaufsstatistik nicht verloren geht. Wir orientieren uns an 5 Tagen, in diesem Zeitraum (sogar unter Berücksichtigung von Wochenenden und Feiertagen) kann das Problem gelöst werden.
Aktuell sammeln wir täglich etwa 100KB Protokolle (3-4 Tausend Einträge), aber diese Zahl wächst allmählich — die Detaillierung nimmt zu, neue Ereignisse werden hinzugefügt. Außerdem gibt es manchmal Spitzen (ein gewisser Sensor fängt an, mit falschen Auslösungen zu spammen, zum Beispiel). Wir rechnen mit 10 Tausend Einträgen zu je 100 Byte — ein Megabyte pro Tag.
Insgesamt ergibt das 5MB an reinen (gut komprimierbaren) Daten. Dazu kommen noch (grobe Schätzung) 1MB an Steuerdaten.
Das heißt, wir benötigen einen Chip mit 8MB, wenn wir keine Komprimierung verwenden, oder 4MB, wenn wir es tun. Völlig realistische Zahlen für diesen Speichertyp.
Was die Lebensdauer betrifft: Wenn wir planen, dass der Speicher insgesamt nicht häufiger als alle 5 Tage überschrieben wird, erhalten wir bei 10 Jahren Betriebsdauer weniger als tausend Wiederbeschreibungszyklen.
Ich erinnere daran, dass der Hersteller zehntausend verspricht.
Ein wenig zu NOR vs NAND
Heute ist natürlich NAND-Speicher viel beliebter, aber für dieses Projekt würde ich ihn nicht verwenden: NAND erfordert im Gegensatz zu NOR unbedingt die Verwendung von Fehlerkorrekturcodes, fehlerhaften Blocktabellen usw. Außerdem haben NAND-Chips normalerweise viel mehr Pins.
Als Nachteile von NOR kann man angeben:
- geringe Kapazität (und entsprechend hoher Preis pro Megabyte);
- nicht hohe Übertragungsgeschwindigkeit (hauptsächlich aufgrund des verwendeten seriellen Interfaces, üblicherweise SPI oder I2C);
- langsame Löschvorgänge (je nach Blockgröße dauert es von Bruchteilen einer Sekunde bis zu mehreren Sekunden).
Nichts Kritisches scheint es für uns zu sein, also machen wir weiter.
Wenn Sie an Einzelheiten interessiert sind, wurde der Chip ausgewählt (das ist jedoch nicht entscheidend, auf dem Markt gibt es viele Analoga, die hinsichtlich Pinbelegung und Befehlssatz kompatibel sind; selbst wenn wir einen Chip eines anderen Herstellers und/oder mit anderer Kapazität verwenden möchten, wird alles ohne Änderung des Codes funktionieren).
Ich verwende den im Linux-Kernel eingebauten Treiber, auf Raspberry ist es dank der Unterstützung des Device Tree Overlays ganz einfach – man muss einfach den kompilierten Overlay in /boot/overlays legen und /boot/config.txt ein wenig modifizieren.
Beispiel einer dts-Datei
Ehrlich gesagt bin ich mir nicht sicher, ob es fehlerfrei geschrieben ist, aber es funktioniert.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
Und noch eine Zeile in config.txt
dtoverlay=at25:spimaxfrequency=50000000Die Beschreibung der Anschlussmethode des Chips an den Raspberry Pi lasse ich weg. Einerseits bin ich kein Elektronikspezialist, andererseits ist es für mich auch banal: Der Chip hat nur 8 Pins, von denen wir Masse, Stromversorgung, SPI (CS, SI, SO, SCK) benötigen; die Pegel stimmen mit den entsprechenden beim Raspberry Pi überein, es sind keine zusätzlichen Verbindungen erforderlich – man verbindet einfach die angegebenen 6 Kontakte.
Aufgabenstellung
Wie gewohnt gibt es mehrere Iterationen bei der Aufgabenstellung, ich denke, es ist an der Zeit für eine weitere. Lassen Sie uns also innehalten, das, was bereits geschrieben wurde, zusammenfassen und die noch im Schatten verbliebenen Details klären.
Also haben wir uns darauf geeinigt, dass das Journal im SPI NOR Flash gespeichert wird.
Was ist NOR Flash für diejenigen, die es nicht wissen
Es ist nichtflüchtiger Speicher, mit dem man drei Operationen durchführen kann:
- Lesen:
Das ganz gewöhnliche Lesen: wir übergeben die Adresse und lesen so viele Bytes, wie wir benötigen; - Aufzeichnung:
Der Schreibvorgang in NOR-Flash sieht gewöhnlich aus, hat jedoch eine Besonderheit: Man kann nur 1 in 0 umwandeln, nicht umgekehrt. Wenn zum Beispiel in einer Speichereinheit 0x55 gespeichert war, würde nach dem Schreiben von 0x0f dort 0x05 gespeichert sein. (siehe Tabelle etwas weiter unten); - Löschen:
Natürlich müssen wir auch die umgekehrte Operation beherrschen – 0 in 1 umzuwandeln, genau dafür gibt es die Löschoperation. Im Gegensatz zu den ersten beiden operiert sie nicht mit Bytes, sondern mit Blöcken (der minimale Löschblock im ausgewählten Chip beträgt 4 KB). Löschen zerstört den gesamten Block und dies ist die einzige Möglichkeit, 0 in 1 umzuwandeln. Daher muss man beim Arbeiten mit Flash-Speicher oft Datenstrukturen an die Grenzen des Löschblocks anpassen.
Schreiben in NOR-Flash:
Binärdaten
War
01010101
Gespeichert
00001111
Wurde
00000101
Das Journal selbst besteht aus einer Sequenz von Einträgen variabler Länge. Eine typische Eintragslänge beträgt etwa 30 Bytes (obwohl manchmal auch Einträge mit mehreren Kilobyte vorkommen). In diesem Fall behandeln wir sie einfach als eine Menge von Bytes, aber wenn es interessiert, werden innerhalb der Einträge CBOR verwendet.
Neben dem Journal müssen wir einige "Einstellinformationen" speichern, sowohl aktualisierbare als auch nicht: eine Art Geräte-ID, Kalibrierungen von Sensoren, ein Flag "Gerät vorübergehend ausgeschaltet", usw.
Diese Informationen bestehen aus einer Reihe von Schlüssel-Wert-Paaren und werden ebenfalls in CBOR gespeichert. Wir haben nicht viele dieser Informationen (höchstens einige Kilobyte) und sie werden nicht häufig aktualisiert.
Im weiteren Verlauf werden wir sie Kontext nennen.
Wenn wir uns erinnern, womit dieser Artikel begann, ist es sehr wichtig, die Zuverlässigkeit der Datenspeicherung zu gewährleisten und, wenn möglich, einen ununterbrochenen Betrieb selbst bei Hardwarefehlern oder Datenbeschädigungen sicherzustellen.
Welche Problemquellen können wir betrachten?
- Stromausfall während der Write-/Erase-Operationen. Das gehört zu der Kategorie "Gegen einen Brecheisen gibt es kein Rezept".
Information aus auf Stack Exchange: Bei einem Stromausfall während der Arbeit mit Flash führt sowohl ein Löschen (Setzen auf 1) als auch ein Schreiben (Setzen auf 0) zu einem undefinierten Verhalten: Daten können geschrieben werden, teilweise geschrieben werden (sagen wir, wir haben 10 Bytes/80 Bit übertragen, aber es wurden nur 45 Bit geschrieben), es ist auch möglich, dass einige Bits in einem "Zwischenzustand" sind (das Lesen kann sowohl 0 als auch 1 ausgeben); - Fehler im Flash-Speicher selbst.
Obwohl die BER sehr niedrig ist, kann sie nicht null sein; - Fehler über den Bus
Die über SPI übertragenen Daten sind nicht geschützt und können sowohl einfache Bitfehler als auch Synchronisationsfehler – den Verlust oder das Einfügen von Bits (was zu massiven Datenverzerrungen führt) – aufweisen; - Weitere Fehler/Fehlfunktionen
Fehler im Code, „Glitches“ bei Raspberry, Eingreifen von Außerirdischen…
Ich habe die Anforderungen formuliert, deren Erfüllung meiner Meinung nach notwendig ist, um die Zuverlässigkeit zu gewährleisten:
- Aufzeichnungen müssen sofort in den Flash-Speicher geschrieben werden, verzögerte Aufzeichnungen werden nicht in Betracht gezogen; - wenn ein Fehler auftritt, muss dieser so früh wie möglich erkannt und verarbeitet werden; - das System sollte nach Möglichkeit nach Fehlern wieder funktionsfähig gemacht werden.
(ein praktisches Beispiel „wie es nicht sein sollte“, mit dem ich denke, dass alle konfrontiert wurden: nach einem unerwarteten Neustart war das Dateisystem beschädigt und das Betriebssystem startet nicht)
Ideen, Ansätze, Überlegungen
Als ich anfing, über diese Aufgabe nachzudenken, schoss mir eine Menge Ideen durch den Kopf, zum Beispiel:
- Datenkompression verwenden;
- schlaue Datenstrukturen verwenden, zum Beispiel die Kopfzeilen von Aufzeichnungen getrennt von den eigentlichen Aufzeichnungen speichern, damit bei einem Fehler in einer Aufzeichnung die anderen problemlos gelesen werden können;
- Bitfelder zur Kontrolle der Vollständigkeit der Aufzeichnung bei Stromausfall verwenden;
- Prüfziffern für alles und jedes speichern;
- eine Art von fehlerresistenter Codierung verwenden.
Ein Teil dieser Ideen wurde umgesetzt, teilweise wurde entschieden, darauf zu verzichten. Lassen Sie uns der Reihe nach vorgehen.
Datenkompression
Die Ereignisse, die wir im Protokoll festhalten, sind in der Regel recht gleichförmig und wiederholend („eine 5-Rubel-Münze geworfen“, „die Taste für die Rückgabe gedrückt“, …). Daher sollte die Kompression recht effektiv sein.
Die Kosten für die Kompression sind gering (wir haben einen ziemlich leistungsstarken Prozessor, selbst das erste Pi hatte einen Kern mit 700 MHz, bei den aktuellen Modellen mehrere Kerne mit über einem Gigahertz), die Geschwindigkeit des Austauschs mit dem Speicher ist niedrig (einige Megabyte pro Sekunde), die Größe der Aufzeichnungen ist klein. Insgesamt, wenn die Kompression einen Einfluss auf die Leistung hat, dann nur positiv. (absolut nicht kritisch, ich stelle es einfach fest). Wir haben ja kein echtes Embedded, sondern ein gewöhnliches Linux – die Implementierung sollte also nicht viele Anstrengungen erfordern (es reicht aus, die Bibliothek einfach zu verlinken und einige Funktionen daraus zu verwenden).
Es wurde ein Ausschnitt aus dem Protokoll eines funktionierenden Geräts (1,7 MB, 70.000 Einträge) entnommen und zunächst auf Komprimierbarkeit mit den auf dem Computer verfügbaren gzip, lz4, lzop, bzip2, xz, zstd überprüft.
- Gzip, xz und zstd zeigten ähnliche Ergebnisse (40 KB).
Es erstaunte, dass das angesagte xz hier auf dem Niveau von gzip oder zstd abschneidet; - Lzip mit den Standardeinstellungen lieferte ein etwas schlechteres Ergebnis;
- Lz4 und lzop zeigten kein besonders gutes Ergebnis (150 KB);
- Bzip2 zeigte ein überraschend gutes Ergebnis (18 KB).
Die Daten komprimieren sich also sehr gut.
Wenn wir also (wenn wir keine fatalen Mängel finden) das Komprimieren umsetzen! Einfach, weil mehr Daten auf dasselbe Flash-Laufwerk passen.
Lassen Sie uns über die Nachteile nachdenken.
Das erste Problem: Wir haben bereits vereinbart, dass jeder Eintrag sofort auf das Flash-Laufwerk geschrieben werden muss. Normalerweise sammelt ein Archivierungsprogramm die Daten aus dem Eingabestrom, bis es entscheidet, dass es Zeit ist, sie in den Ausgang zu schreiben. Wir hingegen müssen sofort einen komprimierten Datenblock erhalten und ihn im nichtflüchtigen Speicher speichern.
Ich sehe drei Wege:
- Jeden Eintrag mit Hilfe von Dictionary-Kompression statt der oben genannten Algorithmen zu komprimieren.
Das ist eine durchaus praktikable Möglichkeit, aber ich mag sie nicht. Um einen mehr oder weniger akzeptablen Komprimierungsgrad zu gewährleisten, muss das Wörterbuch auf bestimmte Daten angepasst sein; jede Änderung führt dazu, dass der Komprimierungsgrad katastrophal sinkt. Ja, das Problem kann durch die Erstellung einer neuen Version des Wörterbuchs gelöst werden, aber das wäre Kopfschmerzen – wir müssten alle Wörterbuchversionen speichern; bei jedem Eintrag müssten wir angeben, mit welcher Version des Wörterbuchs er komprimiert wurde… - Jeden Eintrag mit „klassischen“ Algorithmen zu komprimieren, jedoch unabhängig von anderen.
Die betrachteten Kompressionsalgorithmen sind nicht für die Verarbeitung von Einträgen dieser Größe (Dutzende von Bytes) konzipiert; der Kompressionsfaktor wird eindeutig unter 1 liegen (das heißt, die Datenmenge wird statt komprimiert vergrößert); - Nach jedem Eintrag FLUSH zu machen.
In vielen Kompressionsbibliotheken gibt es Unterstützung für FLUSH. Dies ist ein Befehl (oder ein Parameter des Komprimierungsprozesses), der, wenn er empfangen wird, sicherstellt, dass der Archivator den komprimierten Stream so strukturiert, dass die bereits erhaltenen Ressourcen) abgeschlossen ist, lösen wir nicht komprimierten Daten wiederhergestellt werden können. Eine solche Analogiesyncin Dateisystemen odercommitin SQL.
Es ist wichtig, dass die folgenden Komprimierungsoperationen das angesammelte Wörterbuch verwenden können und der Grad der Kompression nicht so stark leidet wie im vorherigen Fall.
Ich denke, es ist offensichtlich, dass ich die dritte Option gewählt habe; lassen Sie uns genauer darauf eingehen.
Gefunden über FLUSH in zlib.
Ich habe einen Test basierend auf einem Artikel gemacht, ich nahm 70.000 Protokolleinträge von einem echten Gerät, bei einer Seitengröße von 60KB (auf die Seitengröße kommen wir noch zurück) erhalten:
Stammdaten
Gzip-Kompression -9 (ohne FLUSH)
zlib mit Z_PARTIAL_FLUSH
zlib mit Z_SYNC_FLUSH
Volumen, KB
1692
40
352
604
Auf den ersten Blick scheint der Preis, den FLUSH verursacht, übermäßig hoch zu sein; jedoch haben wir tatsächlich nicht viele Optionen - entweder gar nicht komprimieren oder (sehr effektiv) mit FLUSH komprimieren. Man sollte nicht vergessen, dass wir 70.000 Einträge haben, und die Überflüssigkeit, die durch Z_PARTIAL_FLUSH eingeführt wird, beträgt nur 4-5 Bytes pro Eintrag. Der Kompressionsfaktor stellte sich als fast 5:1 heraus, was mehr als ein hervorragendes Ergebnis ist.
Es mag überraschend erscheinen, aber tatsächlich ist Z_SYNC_FLUSH eine effektivere Methode, um FLUSH durchzuführen.
Wenn Z_SYNC_FLUSH verwendet wird, werden die letzten 4 Bytes jedes Eintrags immer 0x00, 0x00, 0xff, 0xff sein. Und wenn wir sie kennen, dann können wir sie nicht speichern, sodass die endgültige Größe nur 324KB beträgt.
In dem Artikel, auf den ich mich beziehe, gibt es eine Erklärung:
Ein neuer Typ-0-Block mit leeren Inhalten wird angehängt.
Ein Typ-0-Block mit leeren Inhalten besteht aus:
- dem dreibitigen Blockkopf;
- 0 bis 7 Bits, die gleich Null sind, um die Byte-Ausrichtung zu erreichen;
- der vier-Byte-Sequenz 00 00 FF FF.
Wie man leicht erkennen kann, gehen vor diesen 4 Bytes im letzten Block 3 bis 10 Nullbits. Die Praxis hat jedoch gezeigt, dass es tatsächlich mindestens 10 Nullbits gibt.
Es stellt sich heraus, dass so kurze Datenblöcke normalerweise (immer?) mit einem Block vom Typ 1 (fester Block) codiert werden, der unbedingt mit 7 Nullbits endet, sodass wir insgesamt 10-17 garantiert null Bits erhalten (und die anderen werden mit einer Wahrscheinlichkeit von etwa 50 % null sein).
Daher zeigt sich in den Testdaten, dass in 100 % der Fälle vor 0x00, 0x00, 0xff, 0xff ein Nullbyte kommt, und in mehr als einem Drittel der Fälle - zwei Nullbytes (möglicherweise liegt es daran, dass ich binäres CBOR verwende, und bei der Verwendung von textlichem JSON würden wir wahrscheinlich öfter auf Blöcke vom Typ 2 - dynamischer Block - stoßen, weshalb wir auch auf Blöcke ohne zusätzliche Nullbytes vor 0x00, 0x00, 0xff, 0xff stoßen würden).
Insgesamt kann man mit den vorhandenen Testdaten in weniger als 250KB komprimierten Daten unterkommen.
Man kann noch etwas sparen, indem man mit den Bits jongliert: Wir ignorieren derzeit das Vorhandensein mehrerer Null-Bits am Ende des Blocks, einige Bits am Anfang des Blocks bleiben ebenfalls unverändert ...
Aber dann traf ich die Entscheidung, aufzuhören, sonst könnte ich in der Geschwindigkeit zur Entwicklung meines eigenen Archivierers gelangen.
Insgesamt habe ich aus meinen Testdaten 3-4 Bytes pro Schreibvorgang erhalten, das Komprimierungsverhältnis liegt bei über 6:1. Ehrlich gesagt: Auf ein solches Ergebnis hatte ich nicht gehofft, meiner Meinung nach ist alles, was besser als 2:1 ist, bereits ein Ergebnis, das die Verwendung von Kompression rechtfertigt.
Alles gut, aber zlib (deflate) ist dennoch ein ehrwürdiger und etwas altmodischer Komprimierungsalgorithmus. Schon alleine, dass als Wörterbuch die letzten 32 Kb des unkomprimierten Datenstroms verwendet werden, sieht heute seltsam aus (das heißt, wenn ein bestimmter Datenblock dem ähnelt, was vor 40 Kb im Eingabestrom war, wird er neu archiviert und verweist nicht auf den vorherigen Vorkommen). In modernen und angesagten Archivierern wird die Dictionary-Größe häufig in Megabyte und nicht in Kilobyte gemessen.
Also machen wir unsere Mini-Studie zu Archivierern weiter.
Als Nächstes wurde bzip2 ausprobiert (ich erinnere daran, dass es ohne FLUSH einen fantastischen Komprimierungsgrad von fast 100:1 zeigte). Leider hat es mit FLUSH sehr schlecht abgeschnitten, die Größe der komprimierten Daten war größer als die der unkomprimierten.
Meine Vermutungen über die Gründe für das Scheitern
Libbz2 bietet nur eine Flush-Option an, die anscheinend das Wörterbuch löscht (analog zu Z_FULL_FLUSH in zlib), sodass man nicht von einer effektiven Kompression danach sprechen kann.
Und zuletzt wurde zstd ausprobiert. Je nach Parametern komprimiert es entweder auf Gzip-Niveau, jedoch viel schneller, oder besser als Gzip.
Leider hat es sich mit FLUSH ebenfalls 'nicht so gut' präsentiert: Die Größe der komprimierten Daten betrug etwa 700 Kb.
Ich auf der Projektseite in GitHub, und erhielt die Antwort, dass man mit bis zu 10 Bytes an Verwaltungsdaten pro Block der komprimierten Daten rechnen sollte, was den erhaltenen Ergebnissen nahekommt, den deflate wird man nicht einholen können.
Damit habe ich beschlossen, meine Experimente mit Archivierern zu beenden (ich erinnere daran, dass xz, lzip, lzo, lz4 sich bei den Tests ohne FLUSH nicht bewährt haben, und ich habe es nicht für nötig gehalten, exotischere Komprimierungsalgorithmen zu betrachten).
Kehren wir zu den Problemen der Archivierung zurück.
Das zweite (wie es sagt, nach Reihenfolge, nicht nach Bedeutung) Problem ist, dass komprimierte Daten einen einheitlichen Strom darstellen, in dem ständig Verweise auf vorherige Abschnitte gemacht werden. Dadurch verlieren wir bei Beschädigung eines Abschnitts der komprimierten Daten nicht nur den damit verbundenen Block unkomprimierter Daten, sondern auch alle nachfolgenden.
Es gibt Ansätze zur Lösung dieses Problems:
- Das Auftreten des Problems verhindern – redundante Informationen zu den komprimierten Daten hinzufügen, die es ermöglichen, Fehler zu erkennen und zu korrigieren; darüber werden wir später sprechen;
- Die Folgen im Fall eines Problems minimieren.
Wir haben bereits früher gesagt, dass wir jeden Datenblock unabhängig komprimieren können, wodurch das Problem von selbst verschwinden würde (eine Beschädigung der Daten eines Blocks würde nur zum Verlust der Daten dieses Blocks führen). Dies ist jedoch der Extremfall, in dem die Datenkompression ineffizient wird. Der entgegengesetzte Extremfall: alle 4Mb unseres Mikrochips als ein einziges Archiv zu verwenden, was uns eine hervorragende Komprimierung bieten würde, aber katastrophale Folgen im Fall von Datenbeschädigung hätte.
Ja, ein Kompromiss ist aus Sicht der Zuverlässigkeit erforderlich. Aber wir müssen uns daran erinnern, dass wir ein Datenformat für nichtflüchtigen Speicher mit extrem niedrigem BER und einer angegebenen Datenhaltbarkeit von 20 Jahren entwickeln.
Im Verlauf der Experimente habe ich festgestellt, dass spürbare Verluste in der Kompressionsrate bei komprimierten Datenblöcken von weniger als 10Kb beginnen.
Es wurde vorher erwähnt, dass der verwendete Speicher eine seitenbasierte Organisation hat. Ich sehe keinen Grund, warum man nicht die Zuordnung „eine Seite – ein Block komprimierter Daten“ verwenden sollte.
Das heißt, die minimal vernünftige Seitengröße beträgt 16Kb (mit einem Puffer für Verwaltungsinformationen). Allerdings bringt eine so kleine Seitengröße erhebliche Einschränkungen für die maximale Aufzeichnungsgröße mit sich.
Obwohl ich bisher keine Aufzeichnungen größer als ein Kilobyte in komprimierter Form plane, habe ich mich entschieden, Seiten mit einer Größe von 32Kb zu verwenden (insgesamt 128 Seiten pro Chip).
Zusammenfassung:
- Die Daten werden komprimiert mit zlib (deflate) gespeichert;
- Für jede Aufzeichnung setzen wir Z_SYNC_FLUSH;
- Jede komprimierte Aufzeichnung wird an den Endbytes gekürzt. (zum Beispiel 0x00, 0x00, 0xff, 0xff); im Header geben wir an, wie viele Bytes wir gekürzt haben;
- Die Daten speichern wir seitenweise mit 32 KB; innerhalb der Seite läuft ein einheitlicher Strom komprimierter Daten; bei jeder Seite beginnen wir die Kompression von neuem.
Und bevor wir mit der Kompression fertig sind, möchte ich darauf hinweisen, dass wir nur einige Bytes an komprimierten Daten pro Aufzeichnung erhalten, daher ist es äußerst wichtig, die Verwaltungsinformationen nicht aufzublähen, jedes Byte zählt hier.
Speicherung von Datenüberschriften
Da wir Aufzeichnungen variabler Länge haben, müssen wir eine Möglichkeit finden, die Platzierung/Grenzen der Aufzeichnungen zu bestimmen.
Ich kenne drei Ansätze:
- Alle Aufzeichnungen werden in einem kontinuierlichen Strom gespeichert, zuerst kommt die Überschrift der Aufzeichnung, die die Länge enthält, und danach die eigentliche Aufzeichnung.
In dieser Variante können sowohl die Überschriften als auch die Daten eine variable Länge haben.
Im Grunde erhalten wir eine einfach verkettete Liste, die überall verwendet wird; - Überschriften und die eigentlichen Aufzeichnungen werden in separaten Strömen gespeichert.
Durch die Verwendung von Überschriften fester Länge sorgen wir dafür, dass die Beschädigung einer Überschrift keine Auswirkungen auf die anderen hat.
Ein ähnlicher Ansatz wird zum Beispiel in vielen Dateisystemen verwendet; - Aufzeichnungen werden in einem kontinuierlichen Strom gespeichert, die Grenze der Aufzeichnung wird durch einen bestimmten Marker (Symbol/Zeichenfolge, die innerhalb der Datenblöcke verboten ist) bestimmt. Wenn innerhalb einer Aufzeichnung ein Marker gefunden wird, ersetzen wir ihn durch eine bestimmte Folge (wir maskieren ihn).
Ein ähnlicher Ansatz wird beispielsweise im PPP-Protokoll verwendet.
Ich werde es veranschaulichen.
Option 1:
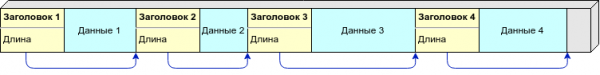
Es ist ganz einfach: Wenn wir die Länge der Aufzeichnung kennen, können wir die Adresse der nächsten Überschrift berechnen. So bewegen wir uns durch die Überschriften, bis wir auf einen Bereich treffen, der mit 0xff gefüllt ist (freier Bereich) oder das Seitenende erreicht ist.
Option 2:
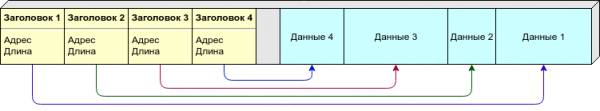
Aufgrund der variablen Länge der Aufzeichnungen können wir nicht im Voraus sagen, wie viele Aufzeichnungen (also auch Überschriften) wir pro Seite benötigen werden. Man könnte die Überschriften und die Daten auf verschiedenen Seiten anordnen, aber ich bevorzuge einen anderen Ansatz: sowohl Überschriften als auch Daten werden auf einer Seite platziert, jedoch beginnen die Überschriften (fester Größe) vom Anfang der Seite und die Daten (variabler Länge) vom Ende. Sobald sie sich „treffen“ (nicht genügend freien Platz für eine neue Aufzeichnung) - betrachten wir diese Seite als voll.
Variante 3:

Es ist nicht notwendig, die Länge oder andere Informationen über die Datenanordnung im Header zu speichern; Marker, die die Grenzen der Datensätze anzeigen, sind ausreichend. Allerdings müssen die Daten beim Schreiben/Lesen verarbeitet werden.
Als Marker würde ich 0xff verwenden (mit dem die Seite nach dem Löschen gefüllt ist), so dass der freie Bereich sicherlich nicht als Daten interpretiert wird.
Vergleichstabelle:
Option 1
Option 2
Option 3
Fehlerresistenz
—
+
+
Kompaktheit
+
—
+
Implementierungskomplexität
*
**
**
Variante 1 hat einen fatalen Nachteil: Wenn einer der Header beschädigt wird, wird die gesamte nachfolgende Kette zerstört. Die anderen Varianten ermöglichen es, Teile der Daten selbst bei massiven Beschädigungen wiederherzustellen.
Es ist jedoch erwähnenswert, dass wir uns entschieden haben, die Daten komprimiert zu speichern; so oder so verlieren wir alle Daten auf der Seite nach einem "kaputten" Schreibvorgang, sodass wir die Minuszahl in der Tabelle nicht berücksichtigen.
Kompaktheit:
- Bei der ersten Variante müssen wir im Header nur die Länge speichern; bei der Verwendung variabler Längen Ganzzahlen können wir in den meisten Fällen mit einem Byte auskommen;
- In der zweiten Variante müssen wir die Startadresse und die Länge speichern; der Datensatz sollte eine konstante Größe haben, ich schätze 4 Byte pro Datensatz (zwei Bytes für die Verschiebung und zwei Bytes für die Länge);
- Die dritte Variante benötigt nur ein Zeichen, um den Anfang des Datensatzes zu kennzeichnen; aufgrund der Maskierung wird der Datensatz um 1-2% größer. Insgesamt gibt es eine ungefähre Parität zur ersten Variante.
Ursprünglich betrachtete ich die zweite Variante als die Hauptvariante (und habe sogar eine Implementierung geschrieben). Ich habe sie nur verworfen, als ich endgültig beschloss, Kompression zu verwenden.
Vielleicht werde ich irgendwann doch eine ähnliche Variante verwenden. Zum Beispiel, wenn ich für ein Raumschiff, das zwischen der Erde und dem Mars verkehrt, Daten speichern muss – ganz andere Anforderungen an die Zuverlässigkeit, Strahlung im Weltraum, ...
Was die dritte Variante angeht: Ich habe ihr wegen der Komplexität der Implementierung zwei Sterne gegeben, einfach weil ich nicht gerne mit Maskierung, Längenänderung während des Prozesses usw. umgehe. Ja, möglicherweise voreingenommen, aber ich muss den Code schreiben – warum sollte ich mich zwingen, etwas zu tun, das mir nicht gefällt.
Zusammenfassung: Wir wählen die Speicheroption in Form von Ketten "Header mit Länge – variabel lange Daten" wegen der Effizienz und Einfachheit der Implementierung.
Die Verwendung von Bitfeldern zur Kontrolle des Erfolgs von Schreibvorgängen
Ich erinnere mich nicht mehr, wo ich die Idee gesehen habe, aber es sieht ungefähr so aus:
Für jeden Eintrag reservieren wir mehrere Bits zur Speicherung von Flags.
Wie bereits erwähnt, sind nach dem Löschen alle Bits auf 1 gesetzt, und wir können 1 auf 0 ändern, aber nicht umgekehrt. Für "Flag nicht gesetzt" verwenden wir 1, für "Flag gesetzt" — 0.
So könnte die Unterbringung eines variablen Längeneintrags im Flash aussehen:
- Setzen des Flags „Länge des Schreibens begonnen“;
- Länge aufzeichnen;
- Setzen des Flags „Datenaufzeichnung begonnen“;
- Daten aufzeichnen;
- Setzen des Flags „Aufzeichnung abgeschlossen“.
Darüber hinaus haben wir ein Flag „Fehler aufgetreten“, insgesamt also 4 Bit-Flags.
In diesem Fall haben wir zwei stabile Zustände „1111“ — Aufzeichnung nicht begonnen und „1000“ — Aufzeichnung war erfolgreich; bei unvorhergesehenen Unterbrechungen des Schreibvorgangs erhalten wir Zwischenzustände, die wir später erkennen und verarbeiten können.
Der Ansatz ist interessant, schützt aber nur vor plötzlichem Stromausfall und ähnlichen Störungen, was natürlich wichtig ist, jedoch bei weitem nicht die einzige (und selbst nicht die Haupt-) Ursache für mögliche Störungen darstellt.
Zusammenfassung: Lass uns weiter auf der Suche nach einer guten Lösung.
Prüfziffern
Prüfziffern ermöglichen ebenfalls zu verifizieren (mit ausreichender Wahrscheinlichkeit), dass wir genau das lesen, was hätte aufgezeichnet werden sollen. Und im Gegensatz zu den oben betrachteten Bitfeldern funktionieren sie immer.
Wenn wir die Liste potenzieller Problemerkenner betrachten, die wir zuvor besprochen haben, kann die Prüfziffer einen Fehler unabhängig von seiner Herkunft erkennen (außer natürlich bei böswilligen Außerirdischen — die können auch die Prüfziffer fälschen).
Wenn unser Ziel also darin besteht, zu überprüfen, ob die Daten intakt sind, sind Prüfziffern eine hervorragende Idee.
Die Wahl des Algorithmus zur Berechnung der Prüfziffer war unproblematisch — CRC. Einerseits ermöglichen mathematische Eigenschaften, dass einige Typen von Fehlern zu 100 % erkannt werden, andererseits zeigt dieser Algorithmus bei zufälligen Daten normalerweise eine Kollisionswahrscheinlichkeit, die nicht wesentlich über dem theoretischen Limit liegt.  Möge es nicht der schnellste Algorithmus sein und nicht immer die geringste Anzahl von Kollisionen aufweisen, aber er hat eine sehr wichtige Eigenschaft: In den mir begegneten Tests gab es keine Muster, bei denen er klar versagte. Stabilität ist in diesem Fall die wichtigste Eigenschaft.
Beispiel für eine umfassende Untersuchung: , (Links zu narod.ru, entschuldigung).
Die Aufgabe der Auswahl einer Prüfziffer ist jedoch noch nicht abgeschlossen, CRC ist eine ganze Familie von Prüfziffern. Man muss sich mit der Länge entscheiden und dann ein Polynom auswählen.
Die Auswahl der Länge der Prüfziffer ist nicht so einfache Frage, wie sie auf den ersten Blick erscheint.
Ich werde es veranschaulichen:
Angenommen, wir haben eine Fehlerwahrscheinlichkeit in jedem Byte  und eine ideale Prüfziffer, berechnen wir die durchschnittliche Anzahl von Fehlern auf eine Million Einträge:
Daten, Byte
Prüfziffer, Byte
Nicht entdeckte Fehler
Falschpositive Fehlererkennungen
Insgesamt falsche Auslösungen
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Es scheint einfach zu sein – wähle je nach Länge der geschützten Daten die Länge der Prüfziffer mit minimalen falschen Auslösungen – und alles ist erledigt.
Das Problem bei kurzen Prüfziffern ist jedoch, dass sie, obwohl sie einzelne Bitfehler gut erkennen, mit einer erheblichen Wahrscheinlichkeit völlig zufällige Daten für korrekt halten können. Auf habra wurde bereits ein Artikel beschrieben, der .
Um zufällige Übereinstimmungen der Prüfziffer praktisch unmöglich zu machen, müssen Prüfziffern mit einer Länge von 32 Bit oder mehr verwendet werden (Für Längen über 64 Bit verwendet man normalerweise kryptografische Hash-Funktionen).
Obwohl ich zuvor geschrieben habe, dass wir jeden Byte Platz sparen sollten, werden wir dennoch eine 32-Bit-Prüfziffer verwenden (16 Bit sind zu wenig, die Kollisionswahrscheinlichkeit liegt über 0,01 %; und 24 Bit sind sozusagen weder hier noch dort).
Hier könnte der Einwand aufkommen: Haben wir jeden Byte beim Komprimieren gespart, nur um jetzt sofort 4 Byte abzugeben? Wäre es nicht besser gewesen, nicht zu komprimieren und keine Prüfziffer hinzuzufügen? Natürlich nicht, das Fehlen von Komprimierung bedeutet, dass die Integritätsprüfung für uns nicht notwendig ist.
Bei der Auswahl des Polynoms werden wir das Rad nicht neu erfinden und das derzeit beliebte CRC-32C verwenden.
Dieser Code erkennt 6 Bitfehler in Paketen bis zu 22 Bytes (wahrscheinlich der häufigste Fall für uns), 4 Bitfehler in Paketen bis zu 655 Bytes (auch ein häufiger Fall für uns), 2 oder eine beliebige ungerade Anzahl von Bitfehlern in Paketen beliebiger sinnvoller Länge.
Falls jemand an den Details interessiert ist
über CRC.
auf – wahrscheinlich der führende Experte für CRC auf dem Planeten.
Im einen , die etwas bessere Parameter für die für uns relevanten Paketlängen bietet, aber ich habe den Unterschied als nicht signifikant angesehen und fühle mich kompetent genug, um einen benutzerdefinierten Code anstelle eines standardisierten und gut erforschten Codes zu wählen.
Außerdem stellt sich, da unsere Daten komprimiert sind, die Frage: Soll die Prüfziffer für komprimierte oder unkomprimierte Daten berechnet werden?
Argumente "für" die Berechnung der Prüfziffer für unkomprimierte Daten:
- Wir müssen letztendlich die Integrität der Datenspeicherung überprüfen – das prüfen wir direkt (und dabei werden auch mögliche Fehler bei der Implementierung von Kompression/Dekompression sowie Beschädigungen, die durch defekten Speicher verursacht werden, überprüft);
- der deflate-Algorithmus in zlib hat eine ausreichend ausgereifte Implementierung und sollte nicht bei "krummen" Eingabedaten abstürzen; darüber hinaus ist er häufig in der Lage, Fehler im Eingabestrom selbst zu erkennen, wodurch die allgemeine Wahrscheinlichkeit einer unentdeckten Fehler entstehen verringert wird (ich habe einen Test mit der Umkehrung eines einzelnen Bits in einem kurzen Datensatz durchgeführt, zlib hat den Fehler in etwa einem Drittel der Fälle erkannt).
Argumente "gegen" die Berechnung der Prüfziffer für unkomprimierte Daten:
- CRC ist speziell auf seltene Bitfehler abgestimmt, die charakteristisch für Flash-Speicher sind (ein Bitfehler im komprimierten Stream kann eine Massenänderung des Ausgangsstroms zur Folge haben, wo wir theoretisch eine Kollision "erwischen" könnten);
- ich bin nicht so begeistert von der Idee, potenziell fehlerhafte Daten an den Dekompressor zu übergeben, , wie er reagieren wird.
In diesem Projekt habe ich beschlossen, von der üblichen Praxis abzuweichen, die Prüfziffer für unkomprimierte Daten zu speichern.
Zusammenfassung: Wir verwenden CRC-32C, die Prüfziffer wird von den Daten in der Form berechnet, in der sie in den Flash geschrieben werden (nach der Kompression).
Redundanz
Der Einsatz von Redundanzkodierung kann zwar nicht verhindern, dass Daten verloren gehen, aber er kann die Wahrscheinlichkeit eines irreversiblen Datenverlusts erheblich (oft um viele Größenordnungen) verringern.
Wir können verschiedene Arten von Redundanz verwenden, um Fehler zu korrigieren.
Hamming-Codes können einzelne Bitfehler korrigieren, Reed-Solomon-Codes sind symbolbasierend, mehrere Kopien von Daten zusammen mit Prüfziffern oder Kodierungen wie RAID-6 können helfen, Daten selbst im Falle massiver Schäden wiederherzustellen.
Zunächst war ich für den breiten Einsatz von fehlerresistenten Kodierungen eingestellt, verstand dann aber, dass man zunächst eine Vorstellung davon haben muss, vor welchen Fehlern man sich schützen möchte, bevor man die Kodierung wählt.
Wir haben zuvor gesagt, dass Fehler so schnell wie möglich erkannt werden müssen. Zu welchen Zeitpunkten können wir mit Fehlern konfrontiert werden?
- Unvollständiges Schreiben (aus irgendeinem Grund war beim Schreiben die Stromversorgung unterbrochen, Raspberry hing, ...)
Leider bleibt im Falle eines solchen Fehlers nur, ungültige Aufzeichnungen zu ignorieren und die Daten als verloren zu betrachten; - Schreibfehler (aus irgendeinem Grund wurde in den Flash-Speicher etwas anderes geschrieben als beabsichtigt)
Solche Fehler können wir sofort erkennen, wenn wir unmittelbar nach dem Schreiben eine Prüflesung durchführen; - Datenverzerrung im Speicher während der Speicherung;
- Lese-Fehler
Zur Behebung genügt es, im Falle eines Abgleichs der Prüfziffer das Lesen mehrere Male zu wiederholen.
Das heißt, nur Fehler des dritten Typs (spontane Datenkorruption bei der Speicherung) können ohne fehlerresistente Kodierung nicht behoben werden. Man könnte denken, dass solche Fehler dennoch äußerst unwahrscheinlich sind.
Zusammenfassung: Es wurde beschlossen, auf Redundanzkodierung zu verzichten, aber wenn der Betrieb zeigt, dass diese Entscheidung falsch war, wird man die Frage erneut prüfen (mit bereits gesammelter Statistik über Ausfälle, die es ermöglichen wird, die optimale Art der Kodierung auszuwählen).
Sonstiges
Natürlich erlaubt das Artikelformat nicht, jedes Bit im Format zu begründen (und mir sind auch die Kräfte ausgegangen), deshalb werde ich einige Punkte kurz anreißen, die zuvor nicht angesprochen wurden.
- Es wurde entschieden, alle Seiten "gleichberechtigt" zu gestalten.
Das heißt, es wird keine speziellen Seiten mit Metadaten oder separaten Streams usw. geben, stattdessen einen einzigen Stream, der alle Seiten nacheinander überschreibt.
Das sorgt für einen gleichmäßigen Verschleiß der Seiten, vermeidet einen einzelnen Fehlerpunkt und gefällt einfach. - Die Versionierung des Formats sollte unbedingt berücksichtigt werden.
Ein Format ohne Versionsnummer im Header ist eine Katastrophe!
Es reicht aus, im Header der Seite ein Feld mit einer Art Magic Number (Signatur) hinzuzufügen, die auf die verwendete Versionsnummer des Formats hinweist. (Ich denke nicht, dass es in der Praxis mehr als ein Dutzend davon geben wird.); - Verwenden Sie für die Einträge (von denen es sehr viele gibt) einen Header variabler Länge und versuchen Sie, ihn in den meisten Fällen auf 1 Byte zu beschränken.
- Zur Kodierung der Länge des Headers und der Länge des abgeschnittenen Teils des komprimierten Eintrags sollten binäre Codes variabler Länge verwendet werden.
Online-Generator Beschreibung des Datenspeicherformats
Byte-Reihenfolge
Felder, die größer als ein Byte sind, werden im Big-Endian-Format (Netzwerk-Byte-Reihenfolge) gespeichert, das heißt, 0x1234 wird als 0x12, 0x34 gespeichert.
Seitenaufteilung
Der gesamte Flash-Speicher ist in gleich große Seiten unterteilt.
Die standardmäßige Seitengröße beträgt 32KB, jedoch nicht mehr als 1/4 der gesamten Größe des Speicherchips (für einen 4MB-Chip ergibt das 128 Seiten).
Jede Seite speichert Daten unabhängig von anderen (d. h. die Daten einer Seite verweisen nicht auf die Daten einer anderen Seite).
Alle Seiten sind in natürlicher Reihenfolge (in aufsteigender Adressfolge) nummeriert, beginnend mit der Nummer 0 (die Nullseite beginnt mit Adresse 0, die erste mit 32KB, die zweite mit 64KB usw.).
Der Speicherchip wird als zirkulärer Puffer (Ringpuffer) verwendet, d. h. zuerst wird in die Seite mit der Nummer 0 geschrieben, dann in die Seite mit der Nummer 1, … wenn wir die letzte Seite füllen, beginnt ein neuer Zyklus und das Schreiben geht mit der Nullseite weiter.
Innerhalb der Seite
Am Anfang der Seite wird ein 4-Byte-Header gespeichert, gefolgt von einer Prüfziffer des Headers (CRC-32C) und dann werden die Einträge im Format „Header, Daten, Prüfziffer“ gespeichert.
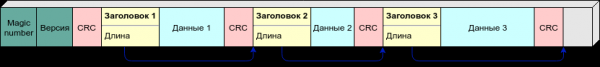
Der Header der Seite (auf dem Diagramm schmutziggrün) besteht aus:
einem zweibyteigen Feld Magic Number (auch als Versionsbezeichnung des Formats bekannt)
- für die aktuelle Version des Formats wird er als
Für die aktuelle Version des Formats wird er als0xed00 ⊕ Seitenzahl; - des zweibyteigen Zählers „Seitenversion“ (Zyklusnummer der Speicherüberschreibung).
Die Aufzeichnungen auf der Seite werden in komprimierter Form gespeichert (es wird der Algorithmus deflate verwendet). Alle Aufzeichnungen auf einer Seite werden in einem Stream komprimiert (das wird ein gemeinsames Wörterbuch verwendet), auf jeder neuen Seite beginnt die Kompression erneut. Das heißt, für die Dekomprimierung jeder Aufzeichnung sind alle vorhergehenden Aufzeichnungen von dieser Seite notwendig (und nur von dieser).
Jede Aufzeichnung wird mit dem Flag Z_SYNC_FLUSH komprimiert, dabei befinden sich am Ende des komprimierten Streams 4 Bytes 0x00, 0x00, 0xff, 0xff, möglicherweise vorangestellt durch ein oder zwei Nullbytes.
Diese Sequenz (von 4, 5 oder 6 Bytes) wird bei der Aufzeichnung in den Flash-Speicher verworfen.
Der Header der Aufzeichnung besteht aus 1, 2 oder 3 Bytes, die folgendes speichern:
- ein Bit (T), das den Typ der Aufzeichnung anzeigt: 0 — Kontext, 1 — Protokoll;
- ein variabel langes Feld (S) von 1 bis 7 Bits, das die Länge des Headers und den „Schwanz“, der der Aufzeichnung zur Dekompression hinzugefügt werden muss, definiert;
- die Länge der Aufzeichnung (L).
Tabelle der Werte S:
S
Länge des Headers, Bytes
Wird bei der Aufzeichnung verworfen, Bytes
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Ich habe versucht, es zu veranschaulichen, ich weiß nicht, wie anschaulich es geworden ist:
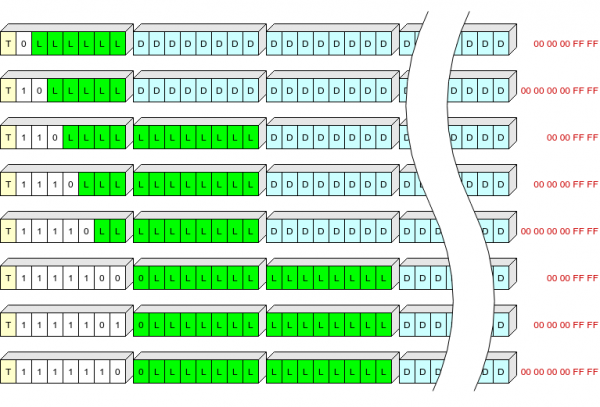
Hier ist das Feld T gelb gekennzeichnet, das Feld S weiß, grün ist L (die Länge der komprimierten Daten in Bytes), blau sind die komprimierten Daten, rot sind die Endbytes der komprimierten Daten, die nicht im Flash-Speicher geschrieben werden.
Somit können wir die Header der am häufigsten vorkommenden Länge (bis zu 63+5 Bytes in komprimierter Form) mit einem Byte aufzeichnen.
Nach jeder Aufzeichnung wird eine CRC-32C-Prüfziffer gespeichert, bei der als Initialwert (init) der invertierte Wert der vorherigen Prüfziffer verwendet wird.
CRC hat die Eigenschaft der „Fortdauer“, die Formel funktioniert (plus-minus Invertierung der Bits im Prozess):  .
Das heißt, wir berechnen tatsächlich die CRC aller vorhergehenden Bytes der Header und Daten auf dieser Seite.
Direkt nach der Prüfziffer befindet sich der Header der nächsten Aufzeichnung.
Der Header ist so konstruiert, dass das erste Byte immer unterschiedlich von 0x00 und 0xff ist (wenn wir anstelle des ersten Bytes des Headers 0xff antreffen, bedeutet das, dass es sich um einen nicht verwendeten Bereich handelt; 0x00 signalisiert einen Fehler).
Ungefähre Algorithmen
Lesen aus dem Flash-Speicher
Jedes Lesen erfolgt mit einer Überprüfung der Prüfziffer.
Wenn die Prüfziffer nicht übereinstimmt, wird das Lesen mehrmals wiederholt, in der Hoffnung, die tatsächlichen Daten korrekt zu lesen.
(das macht Sinn, Linux cached das Lesen aus NOR Flash nicht, getestet)
Schreiben in den Flash-Speicher
Wir schreiben Daten.
Wir lesen sie.
Wenn die gelesenen Daten nicht mit den geschriebenen übereinstimmen, füllen wir den Bereich mit Nullen und signalisieren einen Fehler.
Vorbereitung des neuen Chips zur Verwendung
Zur Initialisierung wird im ersten (genauer gesagt, nullten) Seitenbereich ein Header mit der Version 1 geschrieben.
Danach wird in diesen Seitenbereich der Anfangskontext (enthält die UUID der Maschine und die Standardkonfigurationen) geschrieben.
Alles, der Flash-Speicher ist bereit zur Verwendung.
Laden der Maschine
Beim Laden werden die ersten 8 Byte jeder Seite (Header + CRC) gelesen. Seiten mit unbekannter Magic Number oder ungültigem CRC werden ignoriert.
Aus den „richtigen“ Seiten werden die Seiten mit der maximalen Version ausgewählt, davon wird die Seite mit der höchsten Nummer entnommen.
Der erste Eintrag wird gelesen, die Korrektheit des CRC wird überprüft, sowie das Vorhandensein des „Kontext“-Flags. Wenn alles in Ordnung ist, wird diese Seite als aktuell betrachtet. Andernfalls gehen wir auf die vorherige zurück, bis wir eine „lebendige“ Seite finden.
Auf der gefundenen Seite lesen wir alle Einträge, die mit dem Flag „Kontext“ versehen sind, wenden wir an.
Wir speichern das zlib-Wörterbuch (wird für das Nachschreiben in diese Seite benötigt).
Alles, der Ladevorgang ist abgeschlossen, der Kontext wurde wiederhergestellt, man kann arbeiten.
Hinzufügen eines Eintrags zum Protokoll
Wir komprimieren den Eintrag mit dem richtigen Wörterbuch und geben Z_SYNC_FLUSH an. Wir prüfen, ob der komprimierte Eintrag auf die aktuelle Seite passt.
Wenn er nicht passt (oder die Seite CRC-Fehler aufwies) – beginnen wir eine neue Seite (siehe unten).
Wir schreiben den Eintrag und den CRC. Tritt ein Fehler auf, beginnen wir eine neue Seite.
Neue Seite
Wählen Sie die freie Seite mit der minimalen Nummer aus (eine Seite gilt als frei, wenn sie eine falsche Prüfziffer im Header oder eine Version hat, die kleiner ist als die aktuelle). Wenn es solche Seiten nicht gibt, wählen wir die Seite mit der minimalen Nummer aus denjenigen aus, die die gleiche Version wie die aktuelle haben.
Wir führen ein Erase für die gewählte Seite durch. Wir vergleichen den Inhalt mit 0xff. Wenn etwas nicht stimmt, nehmen wir die nächste freie Seite usw.
Auf die gelöschte Seite schreiben wir den Header, als ersten Eintrag den aktuellen Zustand des Kontextes, als nächsten den nicht geschriebenen Eintrag aus dem Protokoll (wenn vorhanden).
Anwendbarkeit des Formats
Meiner Meinung nach ist das ein ganz passables Format zur Speicherung beliebiger mehr oder weniger komprimierbarer Informationsströme (einfacher Text, JSON, MessagePack, CBOR, möglicherweise Protobuf) im NOR Flash.
Natürlich ist das Format auf SLC NOR Flash ausgelegt.
Es sollte nicht mit Trägern mit hohem BER verwendet werden, wie NAND oder MLC NOR (gibt es solche Speicher überhaupt im Handel? Ich habe nur Erwähnungen in Arbeiten über Fehlerkorrektur gefunden).
Umso mehr sollte es nicht mit Geräten verwendet werden, die über ein eigenes FTL verfügen: USB-Flash, SD, MicroSD usw. (Für solchen Speicher habe ich ein Format mit einer Seitengröße von 512 Byte, einer Signatur am Anfang jeder Seite und eindeutigen Aufzeichnungsnummern erstellt — manchmal konnte ich alle Daten durch einfaches sequentielles Lesen von einem "glitschigen" Flash wiederherstellen).
Je nach Aufgabe kann das Format unverändert auf Flash-Laufwerken von 128 Kbit (16 KB) bis 1 Gbit (128 MB) verwendet werden. Bei Bedarf kann es auch auf Chips mit größerem Volumen verwendet werden, aber wahrscheinlich muss die Seitengröße angepasst werden. (Aber hier stellt sich bereits die Frage der Wirtschaftlichkeit, der Preis für großen NOR Flash ist nicht erfreulich).
Wenn jemand das Format interessant findet und es in einem Open-Source-Projekt verwenden möchte — schreibt mir, ich werde versuchen, Zeit zu finden, um den Code zu überarbeiten und ihn auf GitHub hochzuladen.
Fazit
Wie man sieht, ist das Format am Ende einfach und sogar langweilig.
In dem Artikel ist es schwierig, die Evolution meiner Sichtweise widerzuspiegeln, aber glauben Sie mir: Ursprünglich wollte ich etwas Komplexes, Unzerstörbares schaffen, das selbst nach einer nuklearen Explosion in unmittelbarer Nähe überleben kann. Doch die Vernunft (hoffentlich) hat letztendlich gesiegt und die Prioritäten verschoben sich allmählich in Richtung Einfachheit und Kompaktheit.
Kann es sein, dass ich mich geirrt habe? Ja, natürlich. Es könnte durchaus sein, dass wir zum Beispiel eine Partie minderwertiger Chips gekauft haben. Oder aus einem anderen Grund erfüllt die Hardware nicht die Erwartungen an die Zuverlässigkeit.
Habe ich einen Plan für diesen Fall? Ich denke, dass Sie beim Lesen des Artikels keinen Zweifel haben, dass ich einen Plan habe. Und sogar mehrere.
Etwas ernster gesagt, wurde das Format gleichzeitig als Arbeitstyp und als "Versuchsschuss" entwickelt.
Im Moment funktioniert alles auf meinem Tisch normal, in den nächsten Tagen wird die Lösung bereitgestellt (ungefähr) Bei Hunderten von Geräten werden wir sehen, wie sie im "Einsatz" abschneiden (zum Glück hoffe ich, erlaubt das Format eine zuverlässige Fehlerdetektion; so können wir umfassende Statistiken sammeln). Über mehrere Monate können dann Schlussfolgerungen gezogen werden. (und wenn wir Pech haben – sogar früher).
Falls bei der Nutzung schwerwiegende Probleme festgestellt werden und Anpassungen erforderlich sind, werde ich unbedingt darüber berichten.
Literatur
Ich wollte keine lange, langweilige Liste der verwendeten Arbeiten erstellen; schließlich hat jeder Google.
Hier habe ich beschlossen, eine Liste von Entdeckungen zu führen, die mir besonders interessant erschienen. Diese sind jedoch allmählich in den Artikeltext gewandert, und in der Liste blieb nur ein Punkt übrig:
- Das Tool von Autor zlib. Kann den Inhalt von deflate/zlib/gzip-Archiven in verständlicher Form anzeigen. Wenn Sie sich mit dem inneren Aufbau des deflate-Formats (oder gzip) auseinandersetzen müssen, kann ich es dringend empfehlen.
Quelle: habr.com
