

Fürchten Sie Operationen, die Buffers bringen…
Anhand einer kleinen Abfrage betrachten wir einige universelle Ansätze zur Optimierung von Abfragen in PostgreSQL. Ob Sie sie nutzen oder nicht, liegt bei Ihnen, aber es ist gut, darüber Bescheid zu wissen.
In den späteren Versionen von PG könnte sich die Situation mit der „Intelligenz“ des Planers ändern, aber für 9.4/9.6 sieht es hier ungefähr gleich aus wie in den Beispielen hier.
Ich nehme eine völlig reale Abfrage:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentErweiterung" doc_ex
    USING("@Dokument")
INNER JOIN
  "DokumentTyp" t_doc ON
    t_doc."@DokumentTyp" = d."DokumentTyp"
WHERE
  (d."Person3" = 19091 or d."Mitarbeiter" = 19091) AND
  d."$Entwurf" IS NULL AND
  d."Gelöscht" IS NOT TRUE AND
  doc_ex."Zustand"[1] IS TRUE AND
  t_doc."DokumentTyp" = 'Arbeitsplan'
LIMIT 1;
über Tabellennamen und FelderZu den „russischen“ Bezeichnungen von Feldern und Tabellen kann man unterschiedlich stehen, aber das ist Geschmackssache. Da keine ausländischen Entwickler haben und PostgreSQL es uns erlaubt, Namen sogar mit Hieroglyphen zu geben, wenn sie in Anführungszeichen gesetzt sind, ziehen wir es vor, Objekte eindeutig und klar zu benennen, um Missverständnisse zu vermeiden.
Schauen wir uns den entstandenen Plan an:
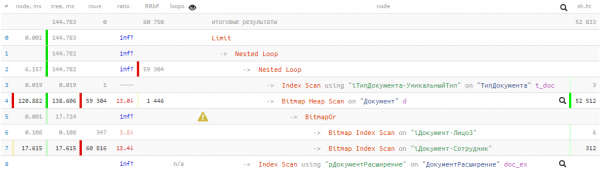
144ms und fast 53K Buffers — das sind über 400MB Daten! Und wir haben Glück, wenn alle diese Daten zum Zeitpunkt unserer Abfrage im Cache sind, sonst wird es beim Auslesen von der Festplatte um ein Vielfaches länger.
Der Algorithmus ist das Wichtigste!
Um jede Abfrage irgendwie zu optimieren, muss man zunächst verstehen, was sie eigentlich tun soll.
Lassen Sie die Entwicklung der Datenbankstruktur für diesen Artikel vorerst außen vor, und vereinbaren wir, dass wir relativ "kostengünstig" die Abfrage umschreiben und/oder einige benötigte Indizes auf die Datenbank anwenden können.
Also, die Abfrage:
— überprüft die Existenz eines beliebigen Dokuments
— im gewünschten Zustand und bestimmten Typ
— wo der Autor oder Ausführende der benötigte Mitarbeiter ist
JOIN + LIMIT 1
Häufig ist es für den Entwickler einfacher, eine Abfrage zu schreiben, bei der zunächst eine große Anzahl von Tabellen verbunden wird und dann aus dieser Vielzahl nur ein einzelner Datensatz übrig bleibt. Aber einfacher für den Entwickler heißt nicht effektiver für die Datenbank.
In unserem Fall gab es insgesamt 3 Tabellen — und welcher Effekt…
Lassen Sie uns zunächst die Verbindung zur Tabelle "DokumentTyp" entfernen und gleichzeitig der Datenbank mitteilen, dass wir einen einzigartigen Typ von Datensatz haben (das wissen wir, aber der Planer ahnt es noch nicht):
WITH T AS (
  SELECT
    "@DokumentTyp"
  FROM
    "DokumentTyp"
  WHERE
    "DokumentTyp" = 'Arbeitsplan'
  LIMIT 1
)
...
WHERE
  d."DokumentTyp" = (TABLE T)
...
Ja, wenn die Tabelle/CTE aus einem einzigen Feld eines einzigen Datensatzes besteht, kann man in PG sogar so schreiben, anstatt
d."DokumentTyp" = (SELECT "@DokumentTyp" FROM T LIMIT 1)„Faule“ Berechnungen in PostgreSQL-Abfragen
BitmapOr vs UNION
In einigen Fällen kann ein Bitmap Heap Scan sehr kostspielig sein - zum Beispiel in unserer Situation, in der eine recht große Anzahl von Datensätzen in die erforderlichen Bedingungen fällt. Wir haben es erhalten aufgrund von OR-Bedingungen, die sich in BitmapOr-Operationen im Plan verwandelt haben.
Kehren wir zur ursprünglichen Aufgabe zurück - wir müssen den Datensatz finden, der einem der Bedingungen entspricht - das heißt, es gibt keinen Grund, alle 59K Datensätze nach beiden Bedingungen zu durchsuchen. Es gibt einen Weg, eine Bedingung abzuarbeiten und erst zur zweiten überzugehen, wenn bei der ersten nichts gefunden wurde.Uns hilft eine solche Konstruktion:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
Der „äußere“ LIMIT 1 garantiert, dass die Suche endet, sobald der erste Datensatz gefunden wird. Und wenn dieser bereits im ersten Block gefunden wird, erfolgt die Ausführung des zweiten nicht (never executed im Plan).
„Verstecken unter CASE“ komplexe Bedingungen
Im ursprünglichen Anfrage gibt es einen äußerst ungünstigen Punkt - die Überprüfung des Status der verknüpften Tabelle „DokumentErweiterung“. Unabhängig von der Wahrhaftigkeit der anderen Bedingungen in der Aussage (zum Beispiel, d."Entfernt" IS NOT TRUE), wird diese Verbindung immer durchgeführt und „kostet Ressourcen“. Ob mehr oder weniger dafür aufgewendet wird, hängt vom Umfang dieser Tabelle ab.
Aber man kann die Anfrage so modifizieren, dass die Suche nach dem verknüpften Datensatz nur dann erfolgt, wenn es tatsächlich notwendig ist:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Entwurf" IS NULL AND "Entfernt" IS NOT TRUE THEN (
      SELECT
        "Status"[1] IS TRUE
      FROM
        "DokumentErweiterung"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Da aus der verknüpften Tabelle keine Felder für das Ergebnis benötigt werden, können wir den JOIN in eine Bedingung eines Subqueries umwandeln.Wir lassen die indizierten Felder „außerhalb“ des CASE, einfache Bedingungen in den WHEN-Block einbringen - und jetzt wird die „schwere“ Anfrage nur ausgeführt, wenn wir in das THEN übergehen.
Mein Nachname ist „Insgesamt“
Wir aggregieren die endgültige Anfrage mit all den oben beschriebenen Mechaniken:
Wir erstellen die resultierende Abfrage unter Berücksichtigung aller oben beschriebenen Mechanismen:
MIT T AS (
  SELECT
    "@Dokumenttyp"
  FROM
    "Dokumenttyp"
  WHERE
    "Dokumenttyp" = 'Arbeitsplan'
)
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("Person3", "Dokumenttyp") = (19091, (TABEL T)) AND
      FALLS
        WENN "$Entwurf" NULL IST UND "Gelöscht" IST NICHT TRUE DANN (
          SELECT
            "Zustand"[1] IST TRUE
          FROM
            "Dokumenterweiterung"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("Dokumenttyp", "Mitarbeiter") = ((TABEL T), 19091) AND
      FALLS
        WENN "$Entwurf" NULL IST UND "Gelöscht" IST NICHT TRUE DANN (
          SELECT
            "Zustand"[1] IST TRUE
          FROM
            "Dokumenterweiterung"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Anpassung [an] Indizes
Ein geschultes Auge hat bemerkt, dass die indizierten Bedingungen in den UNION-Unterblocks leicht variieren – das liegt daran, dass wir bereits geeignete Indizes in der Tabelle haben. Wenn es sie nicht gegeben hätte, wäre es sinnvoll gewesen, sie zu erstellen: Dokument(Person3, Dokumenttyp) und Dokument(Dokumenttyp, Mitarbeiter).
zur Reihenfolge der Felder in ROW-BedingungenAus der Sicht des Planers kann man natürlich auch schreiben (A, B) = (constA, constB), und (B, A) = (constB, constA). Aber bei der Aufzeichnung in der Reihenfolge der Felder im Index, ist eine solche Abfrage einfach leichter zu debuggen.
Was steht an?
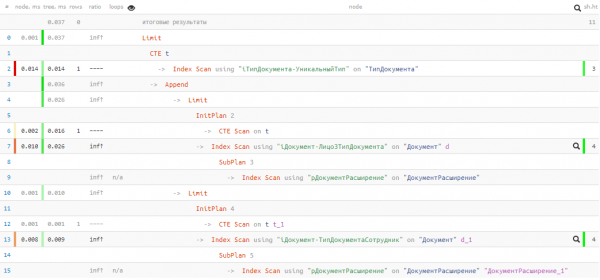
Leider hatten wir Pech und im ersten UNION-Block wurde nichts gefunden, daher wurde der zweite tatsächlich ausgeführt. Aber selbst dabei – nur 0,037 ms und 11 Buffers!
Wir haben die Abfrage beschleunigt und die "Bearbeitung" von Daten im Speicher um mehrere Tausend Mal, indem wir ziemlich einfache Techniken angewendet haben – ein gutes Ergebnis bei geringem Aufwand. 🙂
Quelle: habr.com
