

Hallo, Habra!
Ich arbeite im Team von Tinkoff, das für die Entwicklung unseres eigenen Benachrichtigungszentrums zuständig ist. Hauptsächlich entwickle ich in Java unter Verwendung von Spring Boot und löse verschiedene technische Probleme, die im Projekt auftreten.
Die meisten unserer Mikrodienste wirken asynchron über einen Nachrichtenbroker miteinander. Früher verwendeten wir IBM MQ als Broker, der mit der Last überfordert war, aber hohe Liefergarantien bot.
Als Ersatz wurde uns Apache Kafka vorgeschlagen, das über ein hohes Skalierungspotenzial verfügt, aber leider einen nahezu individuellen Ansatz zur Konfiguration für verschiedene Szenarien erfordert. Darüber hinaus erlaubte der standardmäßig in Kafka arbeitende Mechanismus der einmaligen Lieferung nicht, den erforderlichen Konsistenzgrad sofort zu gewährleisten. Im Folgenden werde ich unsere Erfahrungen mit der Konfiguration von Kafka teilen, insbesondere wie man genau einmalige Lieferungen einrichtet und damit umgeht.
Garantierte Lieferung und noch mehr
Die im Folgenden besprochenen Parameter helfen, eine Reihe von Problemen mit den Standardverbindungseinstellungen zu verhindern. Zunächst möchte ich jedoch auf einen Parameter hinweisen, der das mögliche Debugging erleichtert.
Hierbei hilft client.id für Producer und Consumer. Auf den ersten Blick kann als Wert der Name der Anwendung verwendet werden, und in den meisten Fällen wird es funktionieren. Allerdings führt die Situation, in der mehrere Consumer in der Anwendung verwendet werden und Sie ihnen denselben client.id zuweisen, zur folgenden Warnung:
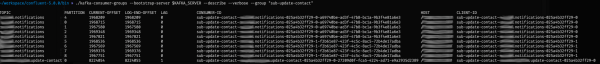
org.apache.kafka.common.utils.AppInfoParser — Fehler bei der Registrierung von AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Wenn Sie JMX in einer Anwendung mit Kafka verwenden möchten, kann dies ein Problem darstellen. In diesem Fall ist es am besten, als Wert für client.id eine Kombination aus dem Namen der Anwendung und beispielsweise dem Namen des Topics zu verwenden. Das Ergebnis unserer Konfiguration kann im Ausgabewert des Befehls kafka-consumer-groups aus den Confluent-Tools eingesehen werden:
Jetzt betrachten wir das Szenario der garantierten Nachrichtenlieferung. Der Kafka Producer hat den Parameter acks, der es ermöglicht zu konfigurieren, nach wie vielen Bestätigungen der Clusterleiter eine Nachricht als erfolgreich gespeichert betrachten soll. Dieser Parameter kann folgende Werte annehmen:
- 0 — Bestätigungen werden nicht gezählt.
- 1 — Standardparameter, erforderlich ist eine Bestätigung nur von 1 Replik.
- −1 — Es sind Bestätigungen von allen synchronisierten Replikaten erforderlich (Cluster-Konfiguration min.insync.replicas).
Aus den aufgeführten Werten ist ersichtlich, dass ein acks von −1 die stärksten Garantien dafür bietet, dass die Nachricht nicht verloren geht.
Wie wir alle wissen, sind verteilte Systeme unzuverlässig. Um sich vor temporären Ausfällen zu schützen, bietet der Kafka Producer den Parameter retries, der die Anzahl der Wiederholungsversuche innerhalb von delivery.timeout.msfestlegt. Da der Parameter retries standardmäßig den Wert Integer.MAX_VALUE (2147483647) hat, kann die Anzahl der Wiederholungen einer Nachricht nur durch Anpassung von delivery.timeout.ms gesteuert werden.
Wir bewegen uns in Richtung genau einmalige Zustellung
Die genannten Einstellungen ermöglichen es unserem Producer, Nachrichten mit hoher Garantie zuzustellen. Lassen Sie uns nun darüber sprechen, wie man sicherstellt, dass nur eine Kopie der Nachricht in ein Kafka-Topic geschrieben wird? Im einfachsten Fall muss dafür am Producer der Parameter enable.idempotence auf den Wert true gesetzt werden. Idempotenz garantiert, dass nur eine Nachricht in eine bestimmte Partition eines Topics geschrieben wird. Eine Voraussetzung für die Aktivierung der Idempotenz sind die Werte acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. Wenn diese Parameter nicht vom Entwickler festgelegt werden, werden die oben genannten Werte automatisch eingestellt.
Wenn die Idempotenz konfiguriert ist, muss sichergestellt werden, dass identische Nachrichten jedes Mal in dieselben Partitionen gelangen. Dies kann erreicht werden, indem der Schlüssel und der Parameter partitioner.class am Producer konfiguriert werden. Lassen Sie uns mit dem Schlüssel beginnen. Er muss für jede Sendung identisch sein. Dies lässt sich leicht erreichen, indem ein Geschäftsidentifikator aus der ursprünglichen Nachricht verwendet wird. Der Parameter partitioner.class hat den Standardwert — . Bei dieser Standardpartitionierungsstrategie handeln wir wie folgt:
- Wenn die Partition beim Senden der Nachricht ausdrücklich angegeben ist, verwenden wir diese.
- Wenn keine Partition angegeben ist, aber ein Schlüssel vorliegt, wählen wir die Partition basierend auf dem Hash des Schlüssels.
- Wenn weder Partition noch Schlüssel angegeben sind, wählen wir die Partitionen im Round-Robin-Verfahren aus.
Darüber hinaus ermöglicht die Verwendung des Schlüssels und das idempotente Senden mit dem Parameter max.in.flight.requests.per.connection = 1 gibt Ihnen eine strukturierte Verarbeitung von Nachrichten an den Consumer. Es ist wichtig zu beachten, dass Sie, wenn auf Ihrem Cluster eine Zugriffskontrolle eingerichtet ist, Berechtigungen für das idempotente Schreiben in das Topic benötigen.
Falls Ihnen die Möglichkeiten des idempotenten Sendens nach Schlüssel fehlen oder die Logik auf der Produzenten-Seite Konsistenz zwischen verschiedenen Partitionen erfordert, können Transaktionen helfen. Außerdem können Sie mit einer Ketten-Transaktion das Schreiben in Kafka hypothetisch mit dem Schreiben in eine DB synchronisieren. Um die transaktionale Sendung am Producer zu aktivieren, muss er idempotent sein und zusätzlich transactional.id. Wenn auf Ihrem Kafka-Cluster eine Zugriffskontrolle eingerichtet ist, benötigen Sie für das transaktionale Schreiben, wie auch für das idempotente, Schreibrechte, die über eine Maske mit dem Wert, der in transactional.id gespeichert ist, erteilt werden können.
Formal kann jede Zeichenkette, z.B. der Name der Anwendung, als Transaktions-ID verwendet werden. Aber wenn Sie mehrere Instanzen derselben Anwendung mit derselben transactional.id starten, wird die zuerst gestartete Instanz mit einem Fehler gestoppt, da Kafka sie als Zombieprozess betrachtet.
org.apache.kafka.common.errors.ProducerFencedException: Der Producer hat versucht, eine Operation mit einer alten Epoche durchzuführen. Entweder gibt es einen neueren Producer mit derselben transactionalId, oder die Transaktion des Producers wurde vom Broker abgelaufen.Um dieses Problem zu lösen, fügen wir dem Namen der Anwendung einen Suffix in Form des Hostnamens hinzu, den wir aus Umgebungsvariablen erhalten.
Der Producer ist konfiguriert, aber Transaktionen in Kafka steuern nur den Geltungsbereich der Nachricht. Unabhängig vom Status der Transaktion wird die Nachricht sofort ins Topic geschrieben, hat jedoch zusätzliche systemtechnische Attribute.
Um zu vermeiden, dass solche Nachrichten vom Consumer vor der Zeit gelesen werden, muss er den Parameter isolation.level auf den Wert read_committed setzen. Ein solcher Consumer kann nicht-transaktionale Nachrichten wie gewohnt und transaktionale nur nach dem Commit lesen.
Wenn Sie alle zuvor genannten Einstellungen vorgenommen haben, dann haben Sie genau einmalige Zustellungen konfiguriert. Herzlichen Glückwunsch!
Es gibt jedoch noch einen weiteren Punkt. Die transactional.id, die wir oben konfiguriert haben, ist in Wirklichkeit ein Präfix der Transaktion. Bei dem Transaktionsmanager wird eine fortlaufende Nummer angehängt. Die erhaltene ID wird auf transactional.id.expiration.ms, der auf einem Kafka-Cluster konfiguriert wird und einen Standardwert von „7 Tagen“ hat. Wenn die Anwendung in dieser Zeit keine Nachrichten empfangen hat, erhalten Sie bei dem nächsten transaktionalen Versand einen InvalidPidMappingException. Danach wird der Transaktionskoordinator eine neue Seriennummer für die nächste Transaktion vergeben. Dabei kann eine Nachricht verworfen werden, wenn die InvalidPidMappingException nicht richtig behandelt wird.
Statt der Ergebnisse
Wie zu erkennen ist, reicht es nicht aus, einfach Nachrichten an Kafka zu senden. Es ist erforderlich, eine Kombination von Parametern auszuwählen und bereit zu sein, schnelle Änderungen vorzunehmen. In diesem Artikel habe ich versucht, die Konfiguration für genau einmalige Zustellungen im Detail darzustellen und einige Probleme mit den Konfigurationen client.id und transactional.id zu beschreiben, auf die wir gestoßen sind. Unten sind die Einstellungen für Producer und Consumer in kurzer Form aufgeführt.
Producer:
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — für geordnete Sendungen)
- transactional.id = ${application-name}-${hostname}
Consumer:
- isolation.level = read_committed
Um Fehler in zukünftigen Anwendungen zu minimieren, haben wir unsere eigene Wrapper-Implementierung über die Spring-Konfiguration erstellt, wo bereits Werte für einige der genannten Parameter festgelegt sind.
Hier sind ein paar Materialien für das Selbststudium:
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish