

Hallo Habr! Die Datenmengen für Big Data und maschinelles Lernen wachsen exponentiell, und man muss sie rechtzeitig verarbeiten. Unser Beitrag handelt von einer weiteren innovativen Technologie im Bereich des Hochleistungsrechnens (HPC, High Performance Computing), die am Stand von Kingston auf präsentiert wurde. Dies ist die Anwendung von Hi-End-Speichersystemen (SSDs) in Servern mit Grafikeinheiten (GPUs) und der Technologie GPUDirect Storage. Durch den direkten Datenaustausch zwischen SSDs und GPUs, ohne Umweg über die CPU, wird die Datenladezeit in GPU-Beschleuniger erheblich beschleunigt, sodass Big Data-Anwendungen mit maximaler Leistung ausgeführt werden können, die die GPUs bieten. Im Gegenzug sind Entwickler von HPC-Systemen an Fortschritten im Bereich SSDs mit höchster Ein- / Ausgabegeschwindigkeit interessiert, wie sie von Kingston hergestellt werden.
Die Leistung von GPUs übertrifft die Datenladezeiten
Seit der Einführung von CUDA im Jahr 2007 – einer Software-Hardware-Architektur für paralleles Rechnen auf Basis von GPUs zur Entwicklung von Anwendungen für allgemeine Zwecke – haben sich die Hardwarefähigkeiten der GPUs enorm gesteigert. Heute finden GPUs immer breitere Anwendung im Bereich von HPC-Anwendungen wie Big Data, maschinellem Lernen (ML) und Deep Learning (DL).
Es ist zu beachten, dass trotz der Ähnlichkeit der Begriffe die letzten beiden - dies sind algorithmisch unterschiedliche Aufgaben. ML trainiert den Computer auf der Grundlage strukturierter Daten, während DL auf der Grundlage der Rückmeldung von neuronalen Netzen arbeitet. Ein Beispiel zur Veranschaulichung der Unterschiede ist recht einfach. Angenommen, der Computer soll Fotos von Katzen und Hunden unterscheiden, die von einem Speichergerät hochgeladen werden. Für ML sollte ein Bildsatz mit vielen Tags bereitgestellt werden, von denen jeder ein bestimmtes Merkmal des Tieres definiert. Für DL genügt es, eine viel größere Anzahl von Bildern hochzuladen, aber nur mit einem einzigen Tag „das ist eine Katze“ oder „das ist ein Hund“. DL ähnelt sehr dem, wie kleine Kinder lernen – sie sehen sich einfach Bilder von Hunden und Katzen in Büchern und im Leben an (häufig sogar ohne detaillierte Erklärungen zu den Unterschieden), und das Gehirn des Kindes beginnt selbst, den Typ des Tieres nach einer bestimmten kritischen Anzahl von Vergleichsbildern zu definieren (laut Schätzungen sind das nur etwa einhundert bis zweihundert Vorführungen in der gesamten frühen Kindheit). Die DL-Algorithmen sind noch nicht perfekt: Damit ein neuronales Netzwerk zur erfolgreichen Mustererkennung in der Lage ist, müssen Millionen von Bildern auf der GPU bereitgestellt und verarbeitet werden.
Zusammenfassend lässt sich sagen: Auf Basis von GPUs können HPC-Anwendungen im Bereich Big Data, ML und DL entwickelt werden, aber es gibt ein Problem – die Datensätze sind so groß, dass die Zeit, die für das Laden der Daten aus dem Speichersystem in die GPU aufgewendet wird, die Gesamtleistung der Anwendung zu verringern beginnt. Mit anderen Worten bleiben die schnellen Grafikprozessoren aufgrund der langsamen Daten-Eingabe- und -Ausgabe von anderen Subsystemen unterausgelastet. Der Unterschied in der Eingabe-/Ausgabegeschwindigkeit zwischen der GPU und dem Bus zu CPU/Speichergerät kann um den Faktor zehn betragen.
Wie funktioniert die Technologie GPUDirect Storage?
Der Eingabe- und Ausgabeprozess wird vom CPU gesteuert, ebenso wie der Prozess des Ladevorgangs von Daten aus dem Speicher in die Grafikprozessoren zur anschließenden Verarbeitung. Daher entstand die Notwendigkeit für eine Technologie, die einen direkten Zugriff zwischen GPU und NVMe-Laufwerken für eine schnelle Interaktion zwischen ihnen ermöglichen würde. Die erste solche Technologie wurde von NVIDIA vorgestellt und als GPUDirect Storage bezeichnet. Im Wesentlichen handelt es sich um eine Variante der zuvor von ihnen entwickelten Technologie GPUDirect RDMA (Remote Direct Memory Access).
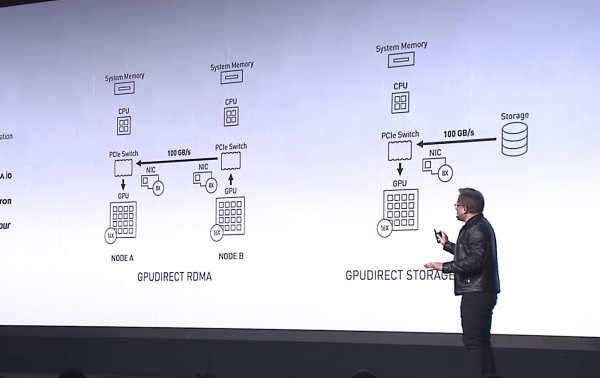
Jensen Huang, CEO von NVIDIA, präsentiert GPUDirect Storage als eine Variante von GPUDirect RDMA auf der Messe SC-19. Quelle: NVIDIA
Der Unterschied zwischen GPUDirect RDMA und GPUDirect Storage liegt in den Geräten, zwischen denen die Adressierung erfolgt. Die GPUDirect RDMA-Technologie ist für den direkten Datentransfer zwischen der eingehenden Netzwerkschnittstellenkarte (NIC) und dem GPU-Speicher konzipiert, während GPUDirect Storage einen direkten Übertragungsweg zwischen lokalem oder entfernten Speicher, wie NVMe oder NVMe über Fabric (NVMe-oF), und dem GPU-Speicher bietet.
Beide Optionen, GPUDirect RDMA und GPUDirect Storage, vermeiden unnötige Datenbewegungen durch einen Puffer im CPU-Speicher und ermöglichen es dem Direct Memory Access (DMA) Mechanismus, Daten direkt vom Netzwerkadapter oder Speicher in den GPU-Speicher oder umgekehrt zu verschieben – alles ohne Belastung des Hauptprozessors. Für GPUDirect Storage spielt der Standort des Speichers keine Rolle: Er kann eine NVMe-Disk innerhalb der GPU-Einheit, im Rack oder netzwerkgebunden als NVMe-oF sein.
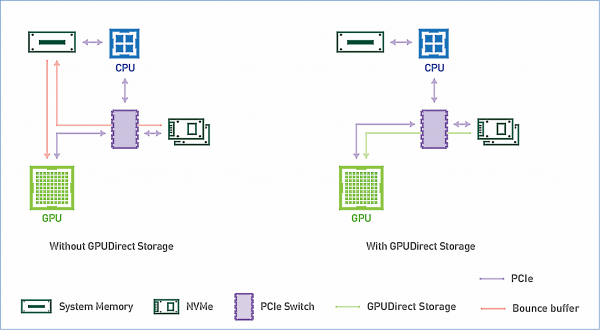
Funktionsweise von GPUDirect Storage. Quelle: NVIDIA
Hi-End SANs auf NVMe sind auf dem Markt für HPC-Anwendungen gefragt.
Angesichts der Tatsache, dass mit dem Erscheinen von GPUDirect Storage das Interesse großer Kunden auf Systeme mit einer Eingangs-/Ausgabegeschwindigkeit gelenkt wird, die der Bandbreite von GPUs entspricht, präsentierte Kingston auf der Messe SC-19 ein Demomuster aus einem SAN, das auf NVMe-Disk basierte und eine GPU-Einheit beinhaltete und in der Tausende von Satellitenbildern pro Sekunde analysiert wurden. Über ein solches SAN auf Basis von 10 DC1000M U.2 NVMe-Laufwerken haben wir bereits berichtet. .
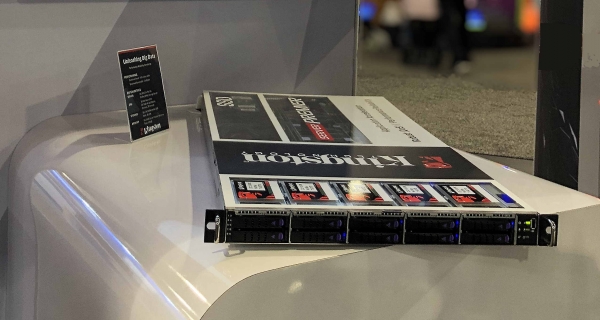
Das SAN basierend auf 10 DC1000M U.2 NVMe-Laufwerken ergänzt den Server mit Grafikkarten hervorragend. Quelle: Kingston
Ein solches SAN wird als 1U oder größerer Rack-Einheit ausgeführt und kann je nach Anzahl der DC1000M U.2 NVMe-Laufwerke skaliert werden, wobei jedes eine Kapazität von 3,84–7,68 TB hat. Der DC1000M ist das erste NVMe SSD-Modell im U.2-Formfaktor in der Kingston-Linie von Datacenter-Laufwerken. Es hat eine Ausdauerbewertung (DWPD, Drive writes per day), die es ermöglicht, Daten einmal täglich auf die volle Kapazität während der garantierten Lebensdauer des Laufwerks zu überschreiben.
Im Test fio v3.13 unter Ubuntu 18.04.3 LTS, Linux-Kernel 5.0.0-31-generic, zeigte das Ausstellungsmodell des SAN eine Leseleistung (Sustained Read) von 5,8 Millionen IOPS bei einer stabilen Bandbreite (Sustained Bandwidth) von 23,8 Gbit/s.
Ariel Pérez, Business-Manager für SSD bei Kingston, charakterisierte die neuen Speicherlösungen mit den Worten: „Wir sind bereit, die nächste Generation von Servern mit U.2 NVMe SSD-Lösungen auszustatten, um viele der traditionellen Engpässe in der Datenübertragung zu beseitigen, die mit Speichersystemen verbunden sind. Die Kombination von NVMe SSD-Speichern und unserem Premium Server Premier DRAM macht Kingston zu einem der umfassendsten Anbieter von integrierten Datenverarbeitungslösungen in der Branche.“
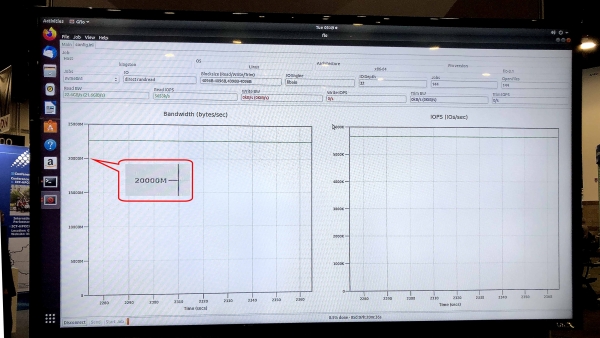
Der Test gfio v3.13 zeigte eine Bandbreite von 23,8 Gbit/s für die Demoversion der Speicherlösung auf DC1000M U.2 NVMe-Laufwerken. Quelle: Kingston
Wie könnte ein typisches System für HPC-Anwendungen aussehen, in dem die GPUDirect Storage-Technologie oder eine ähnliche implementiert ist? Es handelt sich um eine Architektur mit physischer Trennung der funktionalen Einheiten innerhalb des Racks: ein bis zwei Einheiten für den Arbeitsspeicher, mehrere weitere für die Rechenknoten GPU und CPU sowie eine oder mehrere Einheiten für das Speichersystem.
Mit der Ankündigung von GPUDirect Storage und dem möglichen Auftauchen ähnlicher Technologien bei anderen GPU-Anbietern wächst die Nachfrage nach Speichersystemen von Kingston, die für den Einsatz in Hochleistungsrechnen konzipiert sind. Ein Marker wird die Lesegeschwindigkeit der Daten aus dem Speichersystem sein, vergleichbar mit der Bandbreite von 40- oder 100-Gbit-Netzwerkkarten an der Eingangsseite der Recheneinheit mit GPU. So werden ultraschnelle Speichersysteme, einschließlich externer NVMe über Fabrics, von einer Exotik zu einem Mainstream für HPC-Anwendungen. Neben Wissenschaft und Finanzberechnungen finden sie Anwendung in vielen anderen praktischen Bereichen, wie z.B. Sicherheitssystemen auf Mega-Städte-Niveau wie Safe City oder Verkehrsüberwachungszentren, wo die Geschwindigkeit von Erkennung und Identifikation auf dem Niveau von Millionen HD-Bildern pro Sekunde erforderlich ist“, so wurde die Marktposition der führenden Speichersysteme gekennzeichnet.
Zusätzliche Informationen zu den Produkten von Kingston finden Sie auf der Firma.
Quelle: habr.com
