

Ich begrüße Sie und beginne zunächst mit etwas Lyrik. Manchmal beneide ich meine Kollegen, die remote arbeiten — es ist einfach wunderbar, die Möglichkeit zu haben, von jedem Ort der vernetzten Welt aus zu arbeiten, Urlaub wann man will, Verantwortung für Projekte und Deadlines zu tragen, statt von 8 bis 17 Uhr im Büro zu sein. Meine Position und Arbeitsaufgaben schließen lange Abwesenheiten im Rechenzentrum praktisch aus. Doch regelmäßig gibt es interessante Fälle, wie den unten beschriebenen — und ich merke, dass es nur wenige Positionen gibt, die so viel Raum für die kreative Entfaltung eines internen Troubleshooters bieten.
Ein kleiner Disclaimer — zum Zeitpunkt des Schreibens des Artikels war der Fall noch nicht vollständig gelöst, aber angesichts der Reaktionsgeschwindigkeit der Anbieter kann es noch Monate dauern, bis eine vollständige Lösung erarbeitet wird; ich möchte aber meine Entdeckungen schon jetzt teilen. Ich hoffe, verehrte Leser, Sie verzeihen mir diese Eile. Aber genug der Vorrede — was ist mit dem Fall?
Zunächst eine Einleitung: Es gibt eine Firma (in der ich als Netzwerkingenieur arbeite), die Kundenlösungen in einer privaten VMWare-Cloud hostet. Die meisten neuen Lösungen sind mit VXLAN-Segmenten verbunden, die von NSX-V verwaltet werden — ich möchte nicht bewerten, wie viel Zeit mir dieses System geschenkt hat; kurz gesagt — es ist viel. Ich konnte sogar meinen Kollegen die Einrichtung von NSX ESG beibringen, und kleinere Kundenlösungen werden ohne mein Zutun implementiert. Ein wichtiger Hinweis — der Control Layer bei uns verwendet Unicast-Replikation. Die Hypervisoren sind über zwei Schnittstellen redundant an verschiedene physische Juniper QFX5100-Switches (zu einem Virtual Chassis zusammengeschaltet) angeschlossen und die Routing-Politik basiert auf dem ursprünglichen virtuellen Port — zur Vollständigkeit der Darstellung.
Die Kundenlösungen sind sehr unterschiedlich: von Windows IIS, wo alle Komponenten des Webservers auf einem einzigen Rechner installiert sind, bis hin zu größeren Lösungen — beispielsweise Lastverteilung für Apache-Web-Frontends + LB MariaDB in Galera + Share-Server, die mit GlusterFS synchronisiert werden. Praktisch jeder Server muss einzeln überwacht werden, und nicht alle Komponenten haben öffentliche Adressen — falls Sie sich mit dieser Herausforderung auseinandergesetzt haben und elegantere Lösungen zur Verfügung stehen, würde ich mich über Ratschläge freuen.
Meine Überwachungsentscheidung besteht darin, die Firewall (Fortigate) an jedes interne Kundennetzwerk anzuschließen (+SNAT und natürlich strenge Einschränkungen hinsichtlich des erlaubten Datenverkehrs) und die internen Adressen zu beobachten – auf diese Weise wird eine gewisse Vereinheitlichung und Vereinfachung der Überwachung erreicht. Die Überwachung erfolgt aus einem Cluster von PRTG-Servern. Das Überwachungsschema sieht ungefähr so aus:
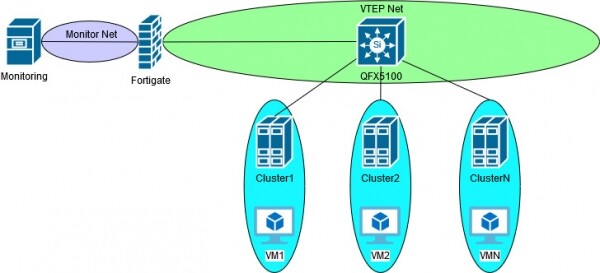
Solange wir nur mit VLANs gearbeitet haben, war alles ganz üblich und vorhersehbar, es funktionierte wie ein Uhrwerk. Nach der Einführung von NSX-V und VXLAN standen wir vor der Frage – können wir die Überwachung wie gewohnt fortsetzen? Zu dem Zeitpunkt war die „schnellste“ Lösung, NSX ESG zu implementieren und den VXLAN-Trunk-Schnittstellen in das VTEP-Netzwerk anzuschließen. Schnell in Anführungszeichen – denn die Verwendung der GUI zur Konfiguration der Kundennetzwerke, SNAT und Firewall-Regeln vereinheitlicht zwar die Verwaltung in einer einzigen vSphere-Oberfläche, ist meiner Meinung nach jedoch recht umständlich und schränkt zudem die Werkzeugsammlung für das Troubleshooting ein. Diejenigen, die NSX ESG als Ersatz für eine „echte“ Firewall verwendet haben, werden dem vermutlich zustimmen. Obwohl eine solche Lösung wahrscheinlich stabiler wäre – schließlich geschieht alles im Rahmen eines Anbieters.
Eine weitere Lösung besteht darin, den NSX DLR im Bridge-Modus zwischen VLAN und VXLAN zu verwenden. Hier denke ich, ist alles klar – es verliert einfach die Vorteile der Anwendung von VXLAN – denn in diesem Fall muss man das VLAN doch an die Monitoring-Installation anbinden. Übrigens bin ich bei der Ausarbeitung dieser Lösung auf ein Problem gestoßen, bei dem der DLR-Bridge keine Pakete an die virtuelle Maschine sendete, mit der sie sich auf demselben Host befand. Ich weiß, ich weiß – in den Büchern und Leitfäden zu NSX-V steht ausdrücklich, dass für NSX Edge ein separater Cluster bereitgestellt werden muss, aber das steht in den Büchern... So oder so, nach ein paar Monaten mit dem Support konnten wir das Problem nicht lösen. Im Prinzip habe ich die Logik verstanden – das Hypervisor-Kernel-Modul, das für die Kapselung von VXLAN verantwortlich ist, wurde nicht genutzt, wenn DLR und der überwachte Server sich auf demselben Host befanden, da der Verkehr den Host nicht verlässt und laut Logik an das VXLAN-Segment angeschlossen sein sollte – die Kapselung ist nicht notwendig. Mit dem Support haben wir uns auf das virtuelle Interface vdrPort geeinigt, das logisch die Uplinks vereint und auch die Bridging/Kapselung durchführt – dort wurde eine Diskrepanz im eingehenden Traffic festgestellt, die ich in diesem Fall weiterverfolgt habe. Aber wie gesagt, ich habe diesen Fall nicht zu Ende gebracht, da ich auf ein anderes Projekt versetzt wurde und der Ast ursprünglich eine Sackgasse war und ich nicht wirklich das Bedürfnis hatte, ihn weiterzuentwickeln. Wenn ich mich nicht irre, trat das Problem in den Versionen NSX 6.1.4 und 6.2 auf.
Und hier – Bingo! Fortinet kündigt die native an. Und es handelt sich nicht nur um Point-to-Point oder VXLAN-over-IPSec, nicht um softwarebasiertes Bridging zwischen VLAN und VXLAN – all dies wurde bereits seit Version 5.4 implementiert (und bei anderen ), und eine echte Unterstützung des Unicast Control Plane. Bei der Implementierung der Lösung bin ich auf ein weiteres Problem gestoßen – die überwachten Server verschwanden gelegentlich aus der Überwachung, obwohl die virtuelle Maschine selbst noch aktiv war. Der Grund war, dass ich vergessen hatte, Ping auf dem VXLAN-Interface zu aktivieren. Während des Rebalancierens der Cluster wurden die virtuellen Maschinen verschoben und der vMotion-Prozess endete mit Ping, um den neuen ESXi-Host zu kennzeichnen, auf den die Maschine verschoben wurde. Meine Dummheit, aber dieses Problem hat mein Vertrauen in den Support des Herstellers erneut erschüttert – in diesem Fall Fortinet. Ganz zu schweigen davon, dass jeder Fall, der mit VXLAN zu tun hat, mit der Frage beginnt: „Wo haben Sie die VLAN-VXLAN-Einstellungen in Ihrer Konfiguration?“ Dieses Mal wurde mir geraten, die MTU zu ändern – das für den Ping, der 32 Byte beträgt. Danach „spiele“ ein wenig mit tcp-send-mss und tcp-receive-mss in der Policy – für VXLAN, das in UDP eingekapselt ist. Puh, Entschuldigung – es musste raus. Zusammenfassend gesagt, habe ich dieses Problem eigenständig gelöst.
Nachdem ich den Testverkehr erfolgreich durchlaufen hatte, wurde beschlossen, diese Lösung einzuführen. Und in der Produktionsumgebung stellte sich heraus, dass nach ein oder zwei Tagen all das, was über VXLAN überwacht wurde, allmählich ausfiel. Das Deaktivieren/Aktivieren des Interfaces half, aber nur vorübergehend. In Anbetracht der Langsamkeit des Herstellersupports habe ich mit dem Troubleshooting von meiner Seite aus begonnen – schließlich ist meine Firma, mein Netzwerk – meine Verantwortung.
Der Fortschritt des Troubleshootings unter Spoiler. Wer von Buchstaben und Prahlerei müde ist – überspringt und geht zur Nachanalyse.
Fortschritt des TroubleshootingsDanke, dass Sie weiter gelesen haben – wir machen weiter!
Also, die Überwachung funktioniert eine Weile, dann fällt sie von selbst aus. Das bedeutet, dass es in der Firewall-Policy wahrscheinlich keine Probleme gibt. Da ich jedoch auf Probleme mit hängenden Systemprozessen in Fortigate-Versionen 5.6+ gestoßen bin, schauen wir uns zuerst „diagnose debug flow“ an – erwartungsgemäß wird der Datenverkehr genehmigt und verlässt das Interface, und erwartungsgemäß kommt nichts als Antwort zurück. Das bedeutet, wir müssen weiter im Stack graben. Leider muss ich die Adressen sogar RFC1918-sichtbar verstecken, aber ich hoffe, den Prozess mit ausreichend Beschreibung für das Verständnis zu versehen. Der Server innerhalb des VXLAN hat die Adresse x.x.x.15, das Interface des Fortigates x.x.x.254, alle anderen Adressen gehören zum VTEP-Netzwerk.
Für die erfolgreiche Übertragung von VXLAN-kapsulierten Paketen ist die korrekte Information in mehreren Tabellen erforderlich. Für das Overlay sind dies ARP und OVSDB, für das Underlay ARP und CAM. Bei Fortigate ist VXLAN FDB und OVSDB vorhanden. Dort fangen wir an:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
Hier ist alles recht einfach – die MAC-Adresse der virtuellen Maschine muss sich am VTEP mit der Adresse у.у.у.47 befinden. Bei der Überprüfung des Inhalts und der Einstellungen des ESXi-Clusters stelle ich fest, dass die MAC-Adresse der virtuellen Maschine korrekt ist und auch die Adresse des VTEP. Ich überprüfe die CAM/ARP-Tabelle auf dem Fortigate – erneut stimmen die Einstellungen mit dem ESXi-Host überein:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
Die Tabellen sind korrekt und der Traffic wird gesendet – könnte das Problem nicht an der Fortigate liegen? Ich habe die Analyse der Verkehrskommunikation auf dem Juniper absichtlich ausgelassen – logisch sollte der nächste Schritt der Fehlersuche dort stattfinden, aber mein Netzwerk ist einfach – nur ein VLAN für VTEP und alle Komponenten sind direkt verbunden. Zudem fällt mir der Fall mit dem DLR-Bridge, VDR und dem verschwindenden Traffic ein – ich gehe schnüffeln auf dem ESXi-Host und eröffne parallel einen Fall bei VMware. Unten gehört die MAC „97:6e“ zur Fortigate, vmnic1 ist das Interface, das VTEP mit der Adresse у.у.у.47 hat, schnüffeln wir in beide Richtungen "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
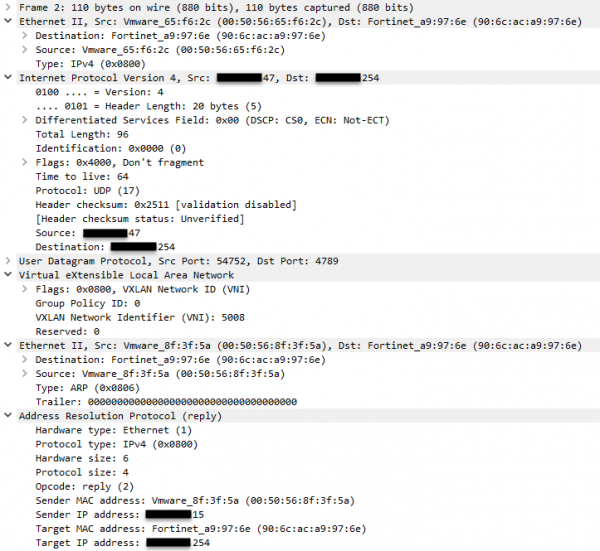
Fortschritt – im Schnüffelprotokoll sehe ich ARP-Anfragen und die eingehende Antwort. Ich führe nur die ARP-Antwort an und dort stimmt alles. Ich habe nicht erwähnt, dass der Überwachungsserver die Adresse х.х.х.15 anpingt – wo bleibt der ICMP-Traffic? Ich erinnere mich, dass ich zwei Uplinks habe. Hier kann man argumentieren und sagen, dass der virtuelle Ausgangsport der gleiche ist (meine Teaming-Politik), also für dieselbe vNIC derselbe Uplink ausgewählt werden sollte, aber da ich bereits auf dem Host bin, ist es kein Problem, den anderen Uplink zu überprüfen:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
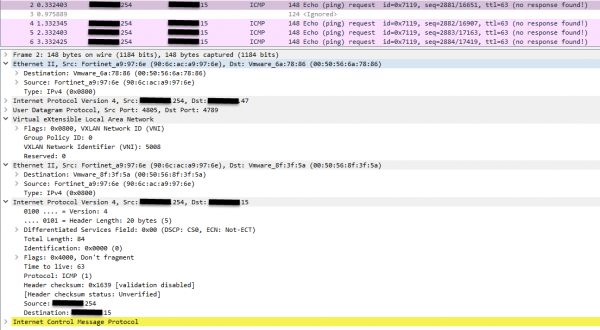
Es kommen Anfragen vom Fortigate, aber es gibt keine Antwort. Das heißt, das Problem liegt nicht am Fortigate. Also denke ich: Wieder das gleiche Problem mit dem verschwindenden Verkehr auf dem VDR, wieder ein paar Monate, um den Fall in die richtige Richtung zu lenken. Nach ein paar Tagen, nach einem kurzen Besinnungsprozess und um nicht mit dem Stau zu leben, beschloss ich, weitere Sniffs für den Support zu sammeln, um den Prozess zu beschleunigen. Und hier fällt mein Blick „zufällig“ auf die Ethernet-Kapselung der Underlay. Der König ist also nicht echt und die MAC-Adresse des VTEP stimmt nicht mit seiner IP überein. Ich setze alles auf null, sniffle, grabe weiter – recht, was nicht recht ist. Ich werde die ARP-Tabelle daneben bringen, um den Vergleich zu erleichtern. Beachten Sie die erste Ethernet-Kapselung auf dem Bild oben:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep u.u.u.42
u.u.u.42 0 00:50:56:6a:78:86 dmz
Was haben wir also als Ergebnis – nach der Migration der virtuellen Maschine versucht der Fortigate, den Verkehr an den VTEP aus der (korrekten) VXLAN-FDB zu senden, verwendet aber die falsche DST-MAC und der Verkehr wird erwartungsgemäß vom empfangenden Interface des Hypervisors verworfen. In einem von vier Fällen gehörte diese MAC zum ursprünglichen Hypervisor, von dem die Migration der Maschine begann.
Gestern erhielt ich eine Nachricht vom Fortinet-Support – zu meinem Fall wurde ein Bug 615586 eröffnet. Ich weiß nicht, ob ich mich freuen oder trauern soll: Einerseits liegt das Problem nicht an den Einstellungen, andererseits kommt der Fix nur mit einem Firmware-Update, bestenfalls im nächsten. Mein Ego wird auch von einem weiteren Bug angeheizt, den ich letzten Monat entdeckt habe, allerdings diesmal im HTML5 GUI vSphere. Da haben wir eine lokale QA-Abteilung der Anbieter…
Ich wage folgende Vermutung:
1 – Der Multicast-Control-Plane wird wahrscheinlich nicht von dem beschriebenen Problem betroffen sein – denn die MAC-Adressen des VTEP werden aus der IP-Adresse der Gruppe gewonnen, auf die das Interface abonniert ist.
2 – Wahrscheinlich liegt das Problem beim Fortigate im Offloading von Sessions auf dem Network Processor (ähnlich wie CEF) – wenn man jedes Paket durch die CPU leitet, werden die Tabellen verwendet, die die korrekten – zumindest visuell – Informationen enthalten. Dies stützt die Vermutung, dass es hilft, das Interface zu schließen/zu öffnen oder eine gewisse Zeit abzuwarten – länger als 5 Minuten.
3 – Eine Änderung der Teaming-Policy, zum Beispiel auf explizites Failover, oder die Einführung von LAG wird das Problem nicht lösen, da das „Steckenbleiben“ der MAC des ursprünglichen Hypervisors in den gekapselten Paketen beobachtet wurde.
In diesem Licht kann ich teilen, dass ich kürzlich , wo in einem der Artikel behauptet wurde, dass Stateful-Firewalls und cachefähige Methoden zur Datenübertragung eine Krücke sind. Nun, ich bin nicht so erfahren in IT, um so etwas zu behaupten, außerdem stimme ich nicht sofort mit allen Aussagen der Blogartikel überein. Doch etwas sagt mir, dass ein Körnchen Wahrheit in Ivans Worten steckt.
Danke für Ihre Aufmerksamkeit! Ich freue mich darauf, Fragen zu beantworten und konstruktive Kritik zu hören.
Quelle: habr.com
