

Tausende von Managern aus Verkaufsbüros im ganzen Land dokumentieren in täglich Zehntausende von Kontakten — Fakten der Kommunikation mit potenziellen oder bereits mit uns tätigen Kunden. Zunächst muss dieser Kunde gefunden werden, und das vorzugsweise sehr schnell. Und dies geschieht meist aufgrund des Namens.
Deshalb ist es nicht überraschend, dass ich, als ich erneut die "schwierigen" Anfragen in einer der am stärksten belasteten Datenbanken — unserem eigenen , entdeckte, dass "in der Spitze" eine Anfrage für die "schnelle" Suche nach Namen für die Unternehmensprofile.
Darüber hinaus offenbarte eine weitere Untersuchung ein interessantes Beispiel zuerst der Optimierung, dann der Verschlechterung der Leistung der Anfrage bei deren schrittweiser Verbesserung durch mehrere Teams, die jeweils ausschließlich aus besten Absichten agierten.
0: Was wollte der Benutzer
 [KDPW ]
Was versteht der Benutzer normalerweise, wenn er von einer "schnellen" Suche nach Namen spricht? Es handelt sich fast nie um eine "ehrliche" Suche nach einem Substring wie ... LIKE '%rose%' — denn dann würden nicht nur 'Roselia' und 'Laden Rose', sondern auch 'Grose' und sogar 'Haus des Großvaters rose'.
Der Benutzer erwartet im Alltagsverständnis, dass Sie ihm eine Suche nach dem Wortanfang im Titel bieten und ihm relevanter zeigen, was mit dem Eingetragenen anfängt. Und das machen Sie praktisch sofort — bei der Substring-Eingabe.
1: Die Aufgabe einschränken
Und schon gar nicht wird jemand absichtlich eingeben 'rose laden', sodass jedes Wort von Ihnen präfixmäßig gesucht werden muss. Nein, für den Benutzer ist es viel einfacher, schnell auf den Vorschlag für das letzte Wort zu reagieren, als bewusst die vorherigen "unvollständig" einzugeben — schauen Sie sich an, wie das bei jeder Suchmaschine funktioniert.
Im Allgemeinen ist es wichtig, die Anforderungen an die Aufgabe richtig zu formulieren — mehr als die Hälfte der Lösung. Manchmal kann eine sorgfältige Analyse des Anwendungsfalls .
Was macht also ein abstrakter Entwickler?
1.0: Externe Suchmaschine
Oh je, die Suche ist kompliziert, ich möchte mich wirklich nicht damit beschäftigen — lass uns das den DevOps überlassen! Lassen Sie sie uns eine externe, relative zur Datenbank Suchmaschine aufsetzen: Sphinx, ElasticSearch,…
Eine arbeitsintensive, aber dennoch effektive Variante in Bezug auf Synchronisierung und Schnelligkeit der Änderungen. Aber nicht in unserem Fall, da die Suche für jeden Kunden nur im Rahmen seiner Kontodaten durchgeführt wird. Und die Daten unterliegen einer erheblichen Veränderlichkeit – wenn der Manager jetzt eine Karte eingibt, 'Rosa-Shop', kann er nach 5-10 Sekunden bereits daran denken, dass er die E-Mail-Adresse dort vergessen hat und sie finden und korrigieren möchte.
Deshalb – lassen Sie uns direkt in der Datenbank suchen. Zum Glück erlaubt uns PostgreSQL dies und nicht nur auf eine Weise – wir werden sie betrachten.
1.1: „ehrlicher“ Teilstring
Wir hängen uns an das Wort „Teilstring“. Denn genau für die Indizierung von Teilstrings (und sogar von regulären Ausdrücken!) gibt es ein ausgezeichnetes ! Allerdings müssen wir danach richtig sortieren.
Lassen Sie uns zur Vereinfachung so eine Tabelle nehmen:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Wir laden 7,8 Millionen Datensätze von realen Organisationen hoch und indizieren:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Wir suchen die ersten 10 Datensätze für die Teilstringsuche:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rosa')
ORDER BY
  lower(name) ~ ('^' || 'rosa') DESC -- zuerst "beginnend mit"
, lower(name) -- der Rest alphabetisch
LIMIT 10;
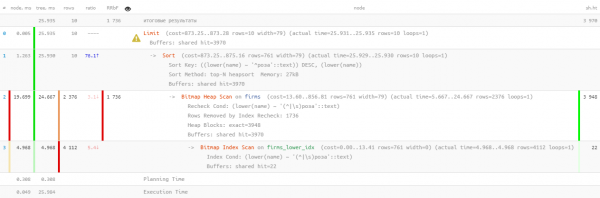
Nun, das ist nicht so toll... 26ms, 31MB gelesene Daten und mehr als 1,7K gefilterte Datensätze – für 10 gesuchte. Die Overheads sind zu hoch, kann man das nicht effizienter gestalten?
1.2: Suche nach Text? Das ist doch FTS!
In der Tat bietet PostgreSQL einen sehr leistungsstarken (Full Text Search), einschließlich der Möglichkeit der Prefixsuche. Eine großartige Option, sogar ohne Erweiterungen! Lassen Sie uns versuchen:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*')
ORDER BY
lower(name) ~ ('^' || 'rosa') DESC
, lower(name)
LIMIT 10; 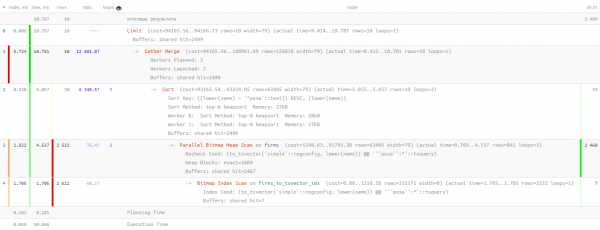
Hier hat uns ein wenig die Parallelisierung der Anfrage geholfen, was die Zeit auf 11msreduziert hat. Und wir mussten auch 1,5 Mal weniger lesen – nur 20MB. Und hier gilt: je weniger, desto besser, denn je mehr Daten wir lesen, desto höher ist die Wahrscheinlichkeit eines Cache-Misses, und jede zusätzlich von der Festplatte gelesene Seite kann potenzielle „Bremsen“ für die Anfrage sein.
1.3: Immer noch LIKE?
Die vorherige Anfrage ist gut, aber wenn wir sie hunderttausend Mal am Tag ausführen, dann summiert sich das schon auf 2TB gelesene Daten. Im besten Fall aus dem Speicher, aber wenn das nicht klappen sollte, dann von der Festplatte. Lassen Sie uns also versuchen, ihn kleiner zu machen.
Erinnern wir uns, dass der Benutzer sehen möchte zuerst "die mit ... beginnen". Das ist doch rein mit text_pattern_ops! Und nur wenn uns bis zu 10 gesuchten Einträge "fehlen", müssen wir sie mit der FTS-Suche nachladen:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('роза' || '%')
LIMIT 10; 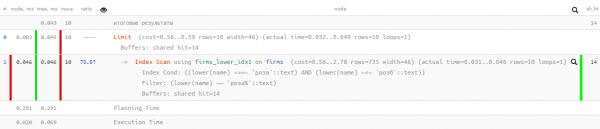
Tolle Werte — nur 0,05 ms und etwas über 100 KB gelesen! Nur haben wir vergessen die Sortierung nach Namen, damit der Benutzer sich nicht in den Ergebnissen verirrt:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('роза' || '%')
ORDER BY
  lower(name)
LIMIT 10; 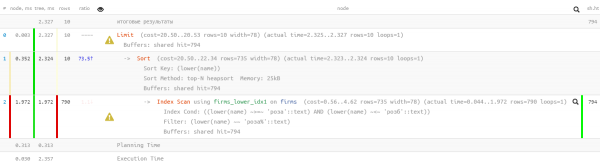
Oh, das sieht schon nicht mehr so schön aus — scheinbar gibt es einen Index, aber die Sortierung ignoriert ihn ... Es ist natürlich schon um ein Vielfaches effizienter als die vorherige Variante, aber ...
1.4: "mit einer Feile nacharbeiten"
Aber es gibt doch einen Index, der sowohl für den Bereich suchen als auch die Sortierung normal verwenden kann — gewöhnlicher btree!
CREATE INDEX ON firms(lower(name));Nur müssen wir die Abfrage für ihn "manuell zusammenstellen":
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'роза' AND
  lower(name) <= ('роза' || chr(65535)) -- für UTF8, für einbyteige - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 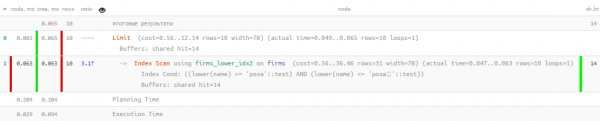
Ausgezeichnet — sowohl die Sortierung funktioniert, als auch der Ressourcenverbrauch bleibt "mikroskopisch". Einstimmig tausendmal effizienter als "reine" FTS.! Jetzt müssen wir alles in eine einzige Abfrage zusammenfassen:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'роза' AND
    lower(name) <= ('роза' || chr(65535)) -- für UTF8, für einbyteige Kodierungen - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'роза:*') AND
    lower(name) NOT LIKE ('роза' || '%') -- "die mit" haben wir schon oben gefunden
  ORDER BY
    lower(name) ~ ('^' || 'роза') DESC -- verwenden dieselbe Sortierung, um den btree-Index NICHT zu verwenden
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Ich bemerke, dass die zweite Unterabfrage nur ausgeführt wird wenn die erste weniger als erwartet zurückgegeben hat. zuletzt LIMIT Anzahl der Zeilen. Über diese Art der Optimierung von Abfragen habe ich .
Ja, jetzt haben wir sowohl einen btree- als auch einen gin-Index auf der Tabelle, allerdings ist statistisch herausgekommen, dass weniger als 10% der Abfragen die Ausführung des zweiten Blocks erreichen.. Das bedeutet, dass wir bei solchen im Voraus bekannten typischen Einschränkungen für die Aufgabe den Gesamtkonsum an Server-Ressourcen praktisch um das Tausendfache reduzieren konnten!
1.5*: kommen wir ohne Feile aus.
Oben LIKE Wir wurden von einer falschen Sortierung aufgehalten. Aber sie kann mit Hilfe des USING-Operators „auf den richtigen Weg gebracht“ werden:
Standardmäßig wird angenommen,
ASC. Außerdem kann ein spezifischer Sortieroperator im Satz angegeben werdenUSING. Der Sortieroperator muss ein Mitglied einer bestimmten Familie von B-Baum-Operatoren sein.ASCentspricht normalerweiseUSING <undDESCentspricht normalerweiseUSING >.
In unserem Fall bedeutet „weniger“ ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rose' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 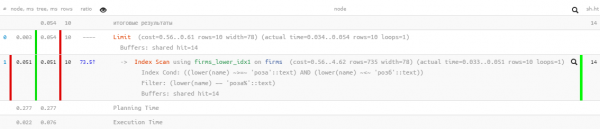
2: wie Anfragen „verderben“
Jetzt lassen wir unsere Anfrage „ein halbes Jahr bis ein Jahr reifen“ und stellen überrascht fest, dass sie wieder „an der Spitze“ mit den Gesamtwerten der täglichen „Speicherauslastung“ ist (buffers shared hit) bei 5.5TB — also noch mehr als ursprünglich.
Natürlich ist unser Unternehmen gewachsen und die Last ist gestiegen, aber nicht so stark! Das bedeutet, dass hier etwas nicht stimmt — lasst uns das klären.
2.1: die Geburt des Paging
Irgendwann wollte ein anderes Entwicklerteam die Möglichkeit schaffen, aus der schnellen Suchanfrage in ein Register mit denselben, aber erweiterten Ergebnissen „zu springen“. Und welches Register kommt ohne Seitennavigation aus? Lass es uns einbauen!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Jetzt konnte man ohne viel Aufwand für den Entwickler das Suchregister mit „ähnlich seitenweise“ nachgeladenen Ergebnissen anzeigen.
Natürlich in Wirklichkeit werden für jede folgende Seite der Daten immer mehr gelesen (alles, was beim letzten Mal verworfen wurde, plus der benötigte „Rest“) — das ist also ein eindeutiges Antimuster. Besser wäre es gewesen, die Suche bei der nächsten Iteration vom im Interface gespeicherten Schlüssel aus zu starten, aber darüber – ein anderes Mal.
2.2: exotische Wünsche
Irgendwann wollte der Entwickler die Ergebnisauswahl mit Daten aus einer anderen Tabelle bereichern, wofür die gesamte vorherige Anfrage in ein CTE geschickt wurde:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- eine Art Anfrage an die verknüpfte Tabelle
FROM
  q
LIMIT 10 OFFSET ;
Und selbst so — nicht schlecht, da die verschachtelte Anfrage nur für die 10 zurückgegebenen Datensätze ausgewertet wird, wenn nicht ...
2.3: DISTINCT - sinnlos und schonungslos
Irgendwo im Prozess dieser Evolution ging verloren NOT LIKE Bedingung. Klar ist, dass danach UNION ALL begann zurückzugeben einige Einträge doppelt — zuerst die am Anfang der Zeile gefundenen, dann erneut — am Anfang des ersten Wortes dieser Zeile. Im Extremfall könnten alle Einträge der 2. Unterabfrage mit den Einträgen der ersten übereinstimmen.
Was macht der Entwickler, anstatt die Ursache zu suchen?.. Keine Frage!
- erhöhen wir die Größe um das Doppelte der Ausgangsauswahlen
- wenden wir DISTINCT an, damit nur einzelne Instanzen jeder Zeile entstehen
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Das heißt, es ist klar, dass das Ergebnis letztendlich genau das gleiche ist, aber die Chance, im 2. Unterabfrage-CTE "durchzufallen", ist erheblich gestiegen, und das ohne dies. es wird deutlich mehr gelesen.
Aber das ist nicht das Schlimmste. Da der Entwickler darum bat, auszuwählen DISTINCT nicht nach konkreten, sondern sofort nach allen Feldern Einträge, ist auch das Feld sub_query — das Ergebnis der Unterabfrage — automatisch hineingekommen. Jetzt musste die DISTINCTDatenbank bereits nicht 10 Unterabfragen, sondern alle + 10!
2.4: Kooperation über alles!
So lebten die Entwickler — sorglos, denn im Register „drehen“ auf signifikante Werte N bei chronischer Verlangsamung des Abrufs jeder nächsten „Seite“ hatte der Benutzer offensichtlich nicht die Geduld.
Bis die Entwickler von einer anderen Abteilung zu ihnen kamen und einen so praktischen Ansatz nutzen wollten für die iterative Suche — das heißt, wir nehmen aus einer Auswahl ein Stück, filtern nach zusätzlichen Bedingungen, erstellen das Ergebnis, dann das nächste Stück (was in unserem Fall durch Erhöhung von N erreicht wird), und das geht so weiter, bis wir den Bildschirm füllen.
Im Allgemeinen hat der gefangene Eintrag N erreichte Werte von fast 17K, und innerhalb von 24 Stunden wurden "kettengeschaltet" nicht weniger als 4K solcher Anfragen ausgeführt. Die letzten wurden bereits mit 1GB Speicher bei jeder Iteration gescannt.…
Insgesamt
Quelle: habr.com
