

Hallo! Mein Name ist Alexey Pjankov, ich bin Entwickler bei Sportmaster. In diesem Artikel erzähle ich, wie die Arbeit an der Sportmaster-Website im Jahr 2012 begann, welche Initiativen wir "durchsetzen" konnten und welche Herausforderungen wir dagegen überwunden haben.
Heute möchte ich Gedanken teilen, die sich um ein anderes Thema drehen – die Auswahl eines Cache-Systems für das Java-Backend im Admin-Bereich der Website. Dieses Thema ist für mich von besonderer Bedeutung – obwohl die Geschichte nur zwei Monate dauerte, arbeiteten wir an diesen 60 Tagen 12-16 Stunden ohne einen einzigen freien Tag. Ich hätte nie gedacht oder mir vorstellen können, dass man so viel arbeiten kann.
Deshalb teile ich den Text in 2 Teile, um nicht zu überlasten. Im Gegenteil, der erste Teil wird sehr leicht sein – eine Vorbereitung, eine Einführung und einige Überlegungen, was Cache bedeutet. Wenn Sie bereits ein erfahrener Entwickler sind oder mit Caches gearbeitet haben, wird dieser Artikel in technischer Hinsicht wahrscheinlich nichts Neues bieten. Für einen Junior-Entwickler kann dieser kleine Überblick jedoch eine hilfreiche Richtung anzeigen, in die er schauen sollte, falls er vor einer solchen Entscheidung steht.
Als die neue Version der Sportmaster-Website in die Produktion ging, wurden die Daten auf eine, gelinde gesagt, nicht sehr bequeme Weise bereitgestellt. Die Grundlage bildeten Tabellen, die für die alte Version der Website (Bitrix) vorbereitet waren, die in ETL gebracht, in ein neues Format überführt und mit verschiedenen kleinen Anpassungen aus einem Dutzend anderer Systeme angereichert werden mussten. Damit ein neues Bild oder eine Produktbeschreibung auf der Website erscheint, musste man bis zum nächsten Tag warten – das Update fand nur nachts einmal täglich statt.
In den ersten Wochen nach dem Produktionsstart hatten wir so viele Anliegen, dass solche Unannehmlichkeiten für die Content-Manager kaum bedeutend waren. Aber sobald sich alles beruhigte, ging die Entwicklung des Projekts weiter – nach einigen Monaten, Anfang 2015, begannen wir aktiv, den Admin-Bereich zu entwickeln. 2015 und 2016 lief alles gut, wir veröffentlichten regelmäßig Updates, der Admin-Bereich deckte immer größere Teile der Datenvorbereitung ab, und wir bereiteten uns darauf vor, dass unser Team bald mit dem Wichtigsten und Schwierigsten betraut wird – dem Produktbereich (vollständige Vorbereitung und Verwaltung der Daten zu allen Produkten). Aber im Sommer 2017, kurz vor dem Launch des Produktbereichs, befand sich das Projekt in einer sehr schwierigen Situation – gerade wegen der Probleme mit dem Caching. Über diesen Zwischenfall möchte ich in der zweiten Teil dieser zweiteiligen Veröffentlichung berichten.
In diesem Beitrag möchte ich von weitem anfangen und einige Gedanken – Vorstellungen zum Thema Caching zusammenfassen, die es wert wären, vor einem großen Projekt im Voraus durchdacht zu werden.
Wenn die Aufgabe des Cachings entsteht
Die Aufgabe des Cachings taucht nicht einfach so auf. Wir Entwickler entwickeln ein Softwareprodukt und wollen, dass es gefragt ist. Wenn das Produkt gefragt und erfolgreich ist – kommen die Nutzer. Und noch mehr Nutzer kommen dazu. Und dann sind es sehr viele Nutzer und das Produkt wird hochgradig belastet.
In den ersten Phasen denken wir nicht über die Optimierung und die Leistungsfähigkeit des Codes nach. Das Wichtigste ist die Funktionalität, schnell ein Pilotprojekt herauszubringen und Hypothesen zu überprüfen. Und wenn die Last steigt – verbessern wir die Hardware. Wir verdoppeln, verdreifachen, verfünffachen, vielleicht auch verzehnfachen. Irgendwo hier – die Finanzen lassen das nicht mehr zu. Und um wie viel wird die Anzahl der Nutzer wachsen? Es wird nicht nur 2-5-10 sein, sondern im Erfolgsfall – es werden von 100-1000 bis zu 100.000 mehr sein. Das heißt, früher oder später müssen wir uns mit der Optimierung befassen.
Nehmen wir an, ein bestimmter Teil des Codes (nennen wir diesen Teil eine Funktion) benötigt unverhältnismäßig lange, und wir wollen die Ausführungszeit verkürzen. Eine Funktion kann der Zugriff auf die Datenbank sein, es kann die Ausführung einer komplexen Logik sein – das Wichtigste ist, dass sie lange dauert. Wie viel kann die Ausführungszeit verkürzt werden? Im besten Fall kann sie auf null gesenkt werden, nicht weiter. Und wie kann die Ausführungszeit auf null verkürzt werden? Antwort: indem man die Ausführung einfach ausschließt. Stattdessen – sofort das Ergebnis zurückgeben. Und wie erfährt man das Ergebnis? Antwort: entweder berechnen oder irgendwo nachsehen. Berechnen – das ist zeitaufwendig. Und nachsehen – das bedeutet beispielsweise, sich das Ergebnis zu merken, das die Funktion beim letzten Aufruf mit den gleichen Parametern gegeben hat.
Das heißt, die Implementierung der Funktion ist für uns unwichtig. Es reicht aus zu wissen, von welchen Parametern das Ergebnis abhängt. Wenn die Werte der Parameter als Objekt dargestellt werden, das als Schlüssel in einem bestimmten Speicher verwendet werden kann, können wir das Ergebnis der Berechnung speichern und beim nächsten Aufruf abrufen. Wenn das Speichern und Abrufen des Ergebnisses schneller ist als die Ausführung der Funktion, haben wir einen Geschwindigkeitsvorteil. Der Umfang des Vorteils kann 100, 1000 oder sogar 100.000-fach (10^5 – das ist eher die Ausnahme, aber bei einer stark verzögerten Datenbank durchaus möglich) erreichen.
Hauptanforderungen an das Cachesystem
Die erste Anforderung an ein Cachesystem könnte eine schnelle Lesegeschwindigkeit und in etwas geringerem Maße – die Schreibgeschwindigkeit sein. Das ist auch so, aber nur bis zu dem Punkt, an dem wir das System in die Produktion bringen.
Lassen Sie uns einen solchen Fall durchspielen.
Angenommen, wir haben die aktuelle Last mit Hardware gedeckt und fangen nun allmählich an, das Caching einzuführen. Die Anzahl der Nutzer steigt langsam an, die Last wächst – wir fügen ein wenig Caches hinzu und integrieren sie hier und da. Das geht eine Weile so weiter, und die rechenintensiven Funktionen werden praktisch nicht mehr aufgerufen – die gesamte Hauptlast liegt auf dem Cache. In dieser Zeit ist die Nutzerzahl um N-fach gestiegen.
Und wenn der anfängliche Hardwarevorrat 2-5-fach gewesen sein könnte, so konnten wir mit Hilfe von Caching die Leistung um das 10-fache oder im besten Fall um das 100-fache steigern, an manchen Stellen vielleicht sogar um das 1000-fache. Das heißt, auf derselben Hardware bearbeiten wir 100-mal mehr Anfragen. Großartig, das haben wir uns verdient!
Aber jetzt, eines schönen Tages, hat die Systemzufälligkeit versagt und der Cache ist zusammengebrochen. Nichts Besonderes – schließlich haben wir den Cache nach den Anforderungen „hohe Lese- und Schreibgeschwindigkeit, der Rest ist unwichtig“ ausgewählt.
Relativ zur anfänglichen Last hatten wir einen Hardwarevorrat von 2-5-fach, während die Last in dieser Zeit auf 10-100-fach gewachsen ist. Mit Hilfe des Caches haben wir Aufrufe für rechenintensive Funktionen ausgeschlossen und daher lief alles reibungslos. Und jetzt, ohne Cache – wie stark wird unser System zurückgehen? Was wird mit uns passieren? Das System wird zusammenbrechen.
Selbst wenn unser Cache nicht zusammengebrochen ist, sondern nur für eine gewisse Zeit geleert wurde, muss er wieder aufgewärmt werden, und das wird einige Zeit in Anspruch nehmen. Und während dieser Zeit wird die Hauptlast auf die Funktionalität fallen.
Fazit: Hochbelastete Projekte in der Produktion erfordern von einem Caching-System nicht nur hohe Lese- und Schreibgeschwindigkeiten, sondern auch Datensicherheit und Ausfallsicherheit.
Das Dilemma der Auswahl
In einem Projekt mit Admin-Bereich verlief die Auswahl so: Zunächst haben wir Hazelcast gewählt, da wir bereits Erfahrungen mit diesem Produkt von der Hauptseite hatten. Allerdings stellte sich diese Wahl als unglücklich heraus – unter unserem Lastprofil arbeitet Hazelcast nicht nur langsam, sondern extrem langsam. Und zu dem Zeitpunkt hatten wir uns bereits auf die Fristen für den Produktionsstart festgelegt.
Spoiler: Wie genau die Umstände entstanden sind, dass wir eine solche Gelegenheit verpasst haben und in eine angespannte Situation geraten sind – darüber werde ich im zweiten Teil berichten — wie wir dahin kamen und wie wir wieder herauskamen. Aber jetzt — ich sage nur, dass es ein großer Stress war, und „denken geht nicht, wir schütteln die Flasche“. „Wir schütteln die Flasche“ — das ist auch ein Spoiler, darüber später mehr.
Was wir gemacht haben:
- Wir erstellen eine Liste aller Systeme, die Google und StackOverflow vorschlagen. Etwas mehr als 30.
- Wir schreiben Tests mit einer Last, die für die Produktion typisch ist. Dazu haben wir Daten aufgezeichnet, die in einem Produktionsumfeld durch das System fließen – eine Art Sniffer für Daten nicht im Netzwerk, sondern innerhalb des Systems. In die Tests haben wir genau diese Daten eingesetzt.
- Das gesamte Team wählt gemeinsam das nächste System aus der Liste aus, konfiguriert es und führt die Tests durch. Besteht der Test nicht, hält die Last nicht stand – wird das System verworfen, und wir wechseln zum nächsten in der Reihe.
- Bei System 17 wurde klar, dass alles aussichtslos ist. Genug „die Flasche schütteln“, es ist Zeit, ernsthaft nachzudenken.
Dies ist aber die Variante, wenn man ein System auswählen muss, das in den vorab vorbereiteten Tests „schnell genug“ ist. Aber was, wenn es noch keine solchen Tests gibt und man schneller auswählen möchte?
Wir simulieren ein solches Szenario (schwer vorstellbar, dass ein Mittel- oder Senior-Entwickler in einem Vakuum lebt und zum Zeitpunkt der Auswahl noch nicht entschieden hat, welches Produkt er zuerst ausprobieren möchte — daher sind die weiteren Überlegungen eher theoretischer Natur / Philosophie / über Junior-Entwickler).
Nachdem wir die Anforderungen festgelegt haben, beginnen wir mit der Auswahl einer Standardlösung. Warum das Rad neu erfinden: Wir gehen und nehmen ein fertiges Caching-System.
Wenn Sie gerade erst anfangen und googeln, wird die Reihenfolge mehr oder weniger die gleiche sein, aber die Orientierungspunkte werden so sein. Zuerst werden Sie auf Redis stoßen, das überall bekannt ist. Dann erfahren Sie, dass es EhCache gibt, das als das älteste und bewährte System gilt. Danach wird über Tarantool geschrieben – ein inländisches Produkt, das einen einzigartigen Aspekt der Lösung bietet. Und auch Ignite, weil es derzeit an Popularität gewinnt und von SberTech unterstützt wird. Zum Schluss noch Hazelcast, da es in der Unternehmenswelt oft bei großen Firmen erwähnt wird.
Damit ist die Liste noch lange nicht erschöpft; es gibt Dutzende von Systemen. Aber wir werden nur eines betrachten. Wir nehmen fünf ausgewählte Systeme für einen "Schönheitswettbewerb" und führen eine Auswahl durch. Wer wird der Sieger sein?
Redis
Lesen wir, was auf der offiziellen Website steht.
– Open-Source-Projekt. Es bietet einen In-Memory-Datenspeicher, die Möglichkeit zur Speicherung auf der Festplatte, automatische Partitionierung, hohe Verfügbarkeit und Wiederherstellung nach Netzwerkunterbrechungen.
Eigentlich sieht alles gut aus, man kann es nehmen und integrieren – alles, was man braucht, macht es. Aber schauen wir nur aus Interesse auf die anderen Kandidaten.
EhCache
– "der am weitesten verbreitete Cache für Java" (Übersetzung des Slogans von der offiziellen Website). Auch Open-Source. Hier verstehen wir, dass Redis nicht für Java, sondern allgemein ist, und eine Wrapper für die Interaktion benötigt wird. EhCache wird bequemer sein. Was verspricht das System noch? Zuverlässigkeit, Bewährtheit, Vollständigkeit. Außerdem ist es das am weitesten verbreitete. Und es cached Terabytes an Daten.
Redis gerät in Vergessenheit, ich bin bereit, EhCache auszuwählen.
Aber das Gefühl des Patriotismus drängt mich, zu schauen, was Tarantool gut macht.
Tarantool
– wird als "Plattform für die Integration von Daten in Echtzeit" bezeichnet. Es klingt sehr kompliziert, also lesen wir die Seite im Detail und finden eine gewagte Aussage: "Cached 100 % der Daten im Arbeitsspeicher." Das sollte Fragen aufwerfen – denn es kann deutlich mehr Daten als Speicher geben. Die Erklärung ist, dass damit gemeint ist, dass Tarantool beim Schreiben von Daten auf die Festplatte die Serialisierung im Arbeitsspeicher überspringt. Stattdessen nutzt es die Low-Level-Eigenschaften des Systems, bei denen der Speicher einfach auf das Dateisystem abgebildet wird, mit sehr guten I/O-Werten. Insgesamt haben sie es erstaunlich und großartig gemacht.
Schauen wir uns die Implementierungen an: Mail.ru, Unternehmenshauptleitung, Avito, Beeline, Megafon, Alfa-Bank, Gazprom…
Wenn es noch irgendwelche Zweifel an Tarantool gab, dann reißt mich der Implementierungsfall bei Mastercard endgültig um. Ich wähle Tarantool.
Aber trotzdem…
Ignite
… gibt es noch , angekündigt als „in-memory Rechenplattform… in-memory Geschwindigkeiten auf Petabytes von Daten“. Auch hier gibt es viele Vorteile: verteiltes in-memory Caching, der schnellste Key-Value Speicher und Cache, horizontale Skalierung, hohe Verfügbarkeit, strikte Integrität. Insgesamt stellt sich heraus, dass Ignite das schnellste ist.
Implementierungen: Sberbank, American Airlines, Yahoo! Japan. Und dann erfahre ich auch noch, dass Ignite nicht nur in der Sberbank implementiert ist, sondern dass das SberTech-Team seine Leute ins Team von Ignite sendet, um das Produkt weiterzuentwickeln. Das überzeugt mich vollständig und ich bin bereit, Ignite zu wählen.
Ganz unverständlich, warum, schaue ich mir den fünften Punkt an.
Hazelcast
Ich gehe auf die Website , lese. Und es stellt sich heraus, dass die schnellste Lösung für verteiltes Caching Hazelcast ist. Es ist um ein Vielfaches schneller als alle anderen Lösungen und generell ist es der Marktführer im Bereich in-memory Daten-Grid. Vor diesem Hintergrund etwas anderes zu wählen — das wäre Selbstmissachtung. Außerdem nutzt es redundante Datenspeicherung für einen kontinuierlichen Betrieb des Clusters ohne Datenverluste.
Ich bin bereit, Hazelcast zu wählen.
Vergleich
Aber wenn man sich das anschaut, sind alle fünf Kandidaten so beschrieben, dass jeder von ihnen der beste ist. Wie wählt man aus? Wir können sehen, welcher von ihnen am beliebtesten ist, nach Vergleichen suchen, und das Kopfzerbrechen wird verschwinden.
Wir finden so etwas , wählen unsere 5 Systeme aus.
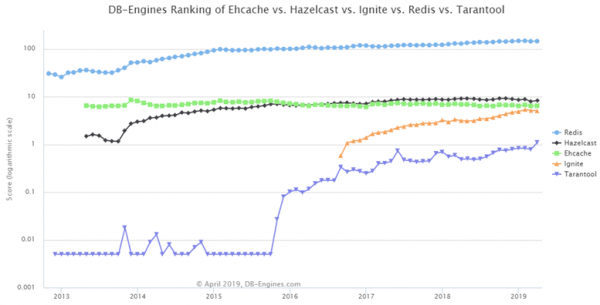
Hier sind sie sortiert: oben Redis, an zweiter Stelle — Hazelcast, an Popularität gewinnen Tarantool und Ignite, EhCache bleibt wie es war.
Aber schauen wir uns die : Links zu Websites, allgemeines Interesse am System, Jobangebote — großartig! Das heißt, wenn mein System ausfällt, sage ich: „Nein, es ist zuverlässig! Hier gibt es viele Stellenangebote…“. So ein einfacher Vergleich passt nicht.
All diese Systeme sind nicht nur Systeme zum Cachen. Sie haben auch sehr viele Funktionen, einschließlich – wenn nicht die Daten zum Verarbeiten an den Kunden übertragen werden, sondern umgekehrt: der Code, der über den Daten ausgeführt werden muss, wird auf den Server übertragen, dort ausgeführt und das Ergebnis zurückgegeben. Und als separates Caching-System werden sie nicht so oft betrachtet.
Gut, wir geben nicht auf, wir finden einen direkten Vergleich der Systeme. Nehmen wir die beiden obersten Optionen — Redis und Hazelcast. Wir interessieren uns für Geschwindigkeiten, und nach diesem Parameter vergleichen wir sie.
Hz vs Redis
Wir finden so etwas :
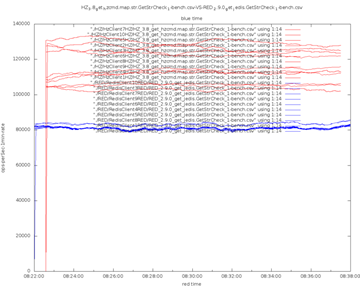
Blau ist Redis, rot ist Hazelcast. Hazelcast gewinnt überall, und das ist begründet: Es ist mehrthreadig, hochoptimiert, jeder Thread arbeitet mit seiner eigenen Partition, daher gibt es keine Sperren. Redis hingegen ist ein einthreadiges System; es profitiert nicht von modernen Mehrkern-CPUs. Hazelcast verwendet asynchrones I/O, während Redis-Jedis blockierende Sockets nutzt. Schließlich verwendet Hazelcast ein Binärprotokoll, während Redis textorientiert ist, was ineffizient ist.
Der Vollständigkeit halber schauen wir uns eine weitere Vergleichsquelle an. Was wird sie uns zeigen?
Redis vs Hz
Noch ein weiteres :
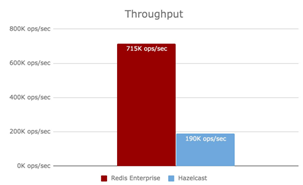
Hier ist es umgekehrt, rot ist Redis. Das bedeutet, Redis übertrifft Hazelcast in Bezug auf die Leistung. Im ersten Vergleich gewann Hazelcast, im zweiten jedoch Redis. wurde sehr präzise erklärt, warum Hazelcast im vorherigen Vergleich gewonnen hat.
Es stellte sich heraus, dass das Ergebnis des ersten Vergleichs tatsächlich manipuliert war: Redis wurde in der Standardkonfiguration verwendet, während Hazelcast auf den Testfall optimiert war. Das führt dazu, dass: Erstens, man niemandem trauen kann, und zweitens, wenn wir unser System schließlich wählen, müssen wir es richtig konfigurieren. Diese Konfiguration umfasst Dutzende, fast Hunderte von Parametern.
Wir schütteln die Flasche
Und den gesamten Prozess, den wir gerade durchlaufen haben, kann ich mit der Metapher "Wir schütteln die Flasche" erklären. Das heißt, jetzt kann man nicht programmieren, jetzt ist es wichtig, Stack Overflow lesen zu können. Und in meinem Team gibt es eine Person, einen Experten, der genau so in kritischen Momenten arbeitet.
Was macht er? Er sieht ein nicht funktionierendes Teil, erkennt den Stack Trace, nimmt einige Wörter daraus (welche genau das sind, ist seine Expertise in der Software), sucht bei Google und findet darunter Stack Overflow. Ohne zu lesen oder nachzudenken wählt er aus den Antworten auf die Frage etwas aus, das am ehesten wie der Vorschlag "das und das zu tun" klingt (diese Auswahl ist sein Talent, denn es ist nicht immer die Antwort, die die meisten Likes bekommt), implementiert es, schaut: Wenn sich etwas geändert hat, großartig. Wenn nichts passiert ist, rollen wir zurück. Und wir wiederholen den Start-Test-Suchprozess. Auf diese intuitive Weise bringt er es zustande, dass der Code nach einer Weile funktioniert. Er weiß nicht warum, er weiß nicht, was er getan hat, und kann es nicht erklären. Aber! Das Ding funktioniert. Und "das Feuer ist gelöscht". Jetzt schauen wir uns an, was wir getan haben. Wenn die Software funktioniert, ist es um vieles leichter. Und es spart erheblich Zeit.
Dieser Ansatz wird sehr gut durch folgendes Beispiel erklärt.
Es war einst sehr beliebt, ein Segelschiff in einer Flasche zu bauen. Dabei ist das Segelschiff groß und zerbrechlich, während der Flaschenhals sehr schmal ist, sodass es nicht hineinpasst. Wie kann man es zusammenbauen?
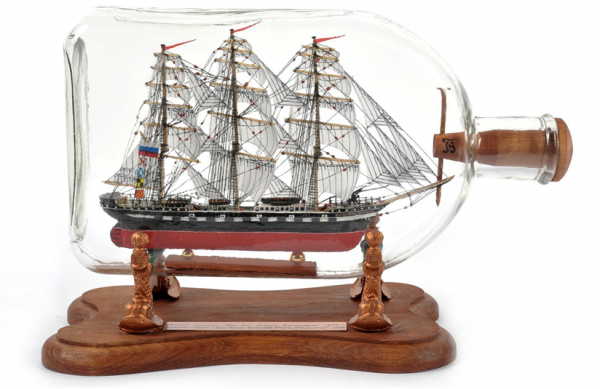
Es gibt eine Methode, die sehr schnell und sehr effektiv ist.
Das Schiff besteht aus vielen kleinen Dingen: Stäbchen, Schnüre, Segel, Kleber. All das legen wir in die Flasche.
Wir nehmen die Flasche mit beiden Händen und beginnen zu schütteln. Wir schütteln und schütteln. Und normalerweise — dabei kommt natürlich nichts Gutes heraus. Aber manchmal, manchmal entsteht ein Schiff! Genauer gesagt, etwas ähnliches wie ein Schiff.
Wir zeigen dieses Etwas jemandem: „Siehst du, Serjoga!?“. Und tatsächlich, aus der Ferne sieht es aus wie ein Schiff. Aber weitergeben kann man es nicht.
Es gibt noch einen anderen Weg. Fortgeschrittene Typen verwenden ihn, solche Hacker.
Ich gab einem solchen Typen eine Aufgabe, er erledigte alles und ging. Und wenn man schaut – sieht es aus, als wäre es gemacht. Aber nach einer Weile, wenn man den Code nachbessern muss — fängt das an, wegen ihm… Gut, dass er schon weit weggelaufen ist. Das sind solche Typen, die aus dem Beispiel der Flasche das machen: Siehst du, wo der Boden ist – das Glas biegt sich. Und es ist nicht ganz klar, ob es durchsichtig ist oder nicht. Dann sägen die „Hacker“ diesen Boden ab, setzen das Schiff hinein, kleben den Boden dann wieder fest, und es sieht so aus, als wäre es genau so nötig.
Aus der Sicht der Aufgabenstellung scheint alles korrekt zu sein. Aber aus Sicht der Schiffe: Warum überhaupt dieses Schiff machen, wem nützt es überhaupt? Funktionalität hat es keine. Solche Schiffe sind meistens Geschenke für sehr hochrangige Personen, die es auf das Regal über sich stellen, als ein gewisses Symbol, als Zeichen. Und wenn bei so einer Person, einem Leiter eines großen Unternehmens oder eines hochrangigen Beamten, ein solches Stück Arbeit, dessen Flaschenhals abgesägt ist, als Flagge aufgestellt wird? Es wäre besser, wenn er niemals davon erfährt. Wie werden also diese Schiffe hergestellt, die man wichtigen Personen schenken kann?
Der einzige Ort, an dem man wirklich nichts machen kann, ist der Rumpf. Und der Rumpf des Schiffs passt genau durch den Flaschenhals. Während das Schiff außerhalb der Flasche zusammengesetzt wird. Aber es geht nicht nur darum, das Schiff zusammenzubauen, es ist ein echtes Juwelierhandwerk. In die Einzelteile werden spezielle Hebel eingefügt, die es später ermöglichen, sie anzuheben. Zum Beispiel werden die Segel gefaltet, sorgfältig nach innen gebracht, und dann werden sie mit einer Pinzette sehr kunstvoll, genau, angehoben und angezogen. Das Ergebnis ist ein Kunstwerk, das man mit reinem Gewissen und Stolz verschenken kann.
Und wenn wir wollen, dass das Projekt erfolgreich ist, muss mindestens eine Person im Team ein Juwelier sein. Jemand, der sich um die Qualität des Produkts kümmert und alle Aspekte berücksichtigt, ohne einen einzigen auch in stressigen Momenten zu opfern, wenn die Umstände verlangen, etwas Dringendes auf Kosten des Wichtigen zu tun. Alle erfolgreichen Projekte, die nachhaltig sind und die Zeit überstanden haben, basieren auf diesem Prinzip. Sie haben etwas sehr Präzises und Einzigartiges, etwas, das alle verfügbaren Möglichkeiten nutzt. Im Beispiel mit dem Schiff in der Flasche wird gespielt mit der Tatsache, dass der Rumpf des Schiffs durch den Flaschenhals geht.
Um auf die Aufgabe der Auswahl unseres Cache-Servers zurückzukommen, wie könnte dieser Ansatz angewendet werden? Ich schlage einen Auswahlansatz aus all den verfügbaren Systemen vor: nicht die Flasche schütteln, nicht auswählen, sondern zu schauen, was grundsätzlich darin vorhanden ist, auf das man bei der Auswahl des Systems achten sollte.
Wo den Flaschenhals suchen.
Lassen Sie uns versuchen, die Flasche nicht zu schütteln, nicht alles nacheinander zu durchgehen, sondern zu sehen, welche Aufgaben auftreten, wenn wir plötzlich für unsere Aufgabe - ein solches System selbst zu entwerfen. Wir werden natürlich kein Fahrrad neu erfinden, sondern dieses Schema nutzen, um uns zu orientieren, auf welche Punkte wir in den Produktbeschreibungen achten sollten. Lassen Sie uns ein solches Schema skizzieren.
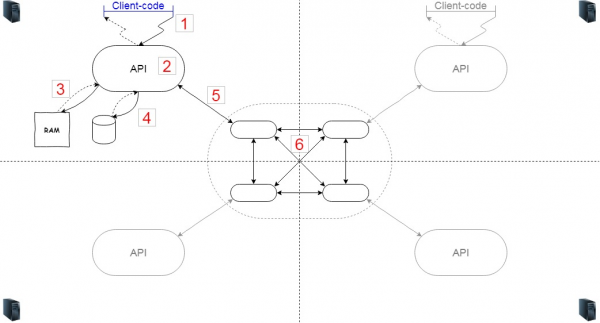
Wenn das System verteilt ist, haben wir mehrere Server (6). Nehmen wir an, vier (bequem, um sie im Bild darzustellen, aber natürlich kann es beliebig viele geben). Wenn die Server auf verschiedenen Knoten sind, läuft auf ihnen allen ein gewisser Code, der dafür verantwortlich ist, dass diese Knoten ein Cluster bilden und sich im Falle einer Unterbrechung wieder verbinden und erkennen.
Es wird noch eine Code-Logik (2) benötigt, die sich mit dem Caching befasst. Mit diesem Code interagieren die Clients über eine bestimmte API. Der Client-Code (1) kann sowohl innerhalb derselben JVM laufen als auch über das Netzwerk darauf zugreifen. Die implementierte Logik besteht darin, welche Objekte im Cache behalten und welche verworfen werden. Für die Speicherung des Caches verwenden wir den Speicher (3), aber wenn nötig, können wir auch einen Teil der Daten auf der Festplatte speichern (4).
Lassen Sie uns betrachten, in welchen Bereichen die Last entstehen wird. Im Grunde genommen werden jede Pfeilspitze und jeder Knoten belastet. Erstens kann es zwischen dem Client-Code und der API, wenn es sich um eine Netzwerkinteraktion handelt, zu spürbaren Verzögerungen kommen. Zweitens, innerhalb der API selbst – wenn wir zu viel komplexer Logik einsetzen, könnten wir auf die CPU stoßen. Es wäre gut, wenn die Logik den Speicher nicht unnötig beansprucht. Und es bleibt die Interaktion mit dem Dateisystem – im Normalfall bedeutet das Serialisieren/Wiederherstellen und Schreiben/Lesen.
Dann gibt es die Interaktion mit dem Cluster. Höchstwahrscheinlich wird es sich im selben System befinden, kann aber auch separat sein. Auch hier muss die Datenübertragung zu ihm, die Geschwindigkeit der Datenserialisierung und die Interaktion zwischen den Clustern berücksichtigt werden.
Jetzt können wir einerseits überlegen, „welche Zahnräder sich“ im Caching-System bei der Verarbeitung von Anfragen von unserem Code drehen werden, und andererseits können wir einschätzen, welche und wie viele Anfragen unser Code an dieses System generieren wird. Das reicht aus, um eine mehr oder weniger kluge Entscheidung zu treffen – ein System für unsere Nutzung auszuwählen.
Hazelcast
Lassen Sie uns anschauen, wie wir eine solche Aufteilung auf unsere Liste anwenden können. Zum Beispiel, Hazelcast.
Um Daten in Hazelcast zu speichern/abzurufen, spricht der Client-Code (1) die API an. Hz ermöglicht es, den Server als Embedded zu starten, und in diesem Fall ist der API-Aufruf ein Methodenaufruf innerhalb der JVM, was als kostenlos betrachtet werden kann.
Damit die Logik in (2) funktioniert, stützt sich Hz auf den Hash des byte-Arrays des serialisierten Schlüssels – das heißt, die Serialisierung des Schlüssels findet in jedem Fall statt. Dies ist ein unvermeidlicher Overhead für Hz.
Die Eviction-Strategien sind gut implementiert, aber für besondere Fälle können eigene hinzugefügt werden. Um diesen Teil muss man sich keine Sorgen machen.
Das Speicher (4) kann angeschlossen werden. Ausgezeichnet. Die Interaktion (5) für Embedded kann als sofort betrachtet werden. Der Datenaustausch zwischen den Knoten im Cluster (6) – ja, das gibt es. Dies ist ein Beitrag zur Fehlertoleranz auf Kosten der Geschwindigkeit. Die Nähe von Hz-Funktion Near-cache senkt die Kosten – Daten, die von anderen Knoten des Clusters erhalten wurden, werden zwischengespeichert.
Was kann unter diesen Bedingungen zur Geschwindigkeitssteigerung unternommen werden?
Um beispielsweise die Serialisierung des Schlüssels in (2) zu vermeiden – einen weiteren Cache über Hazelcast zu legen, für die am häufigsten genutzten Daten. Bei Sportmaster haben wir dafür Caffeine ausgewählt.
Für Anpassungen auf Ebene (6) werden in Hz zwei Speichertypen angeboten: IMap und ReplicatedMap.
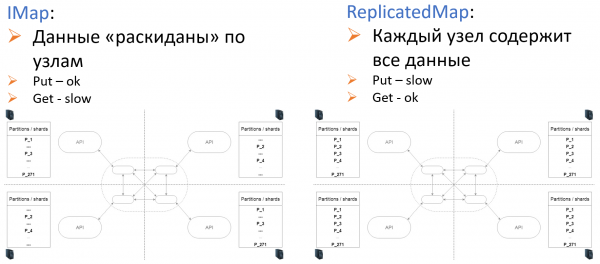
Es sei gesagt, wie Hazelcast in den Technologiestack von Sportmaster gelangte.
Im Jahr 2012, als wir an dem allerersten Pilotprojekt der zukünftigen Website arbeiteten, war es genau Hazelcast, der der erste Link war, den die Suchmaschine zurückgab. Die Bekanntschaft entstand "auf den ersten Blick" – wir waren begeistert, dass er nur zwei Stunden später, nachdem wir Hz in das System integriert hatten – funktionierte. Und zwar gut. Bis zum Ende des Tages haben wir eine Anzahl von Tests geschrieben und uns gefreut. Und diese Energie reichte aus, um die Überraschungen zu überwinden, die Hz im Laufe der Zeit bot. Jetzt hat das Team von Sportmaster keinen Grund, Hazelcast abzulehnen.
Aber solche Argumente wie "der erste Link in der Suchmaschine" und "schnell ein HelloWorld zusammengestellt" – das sind natürlich Ausnahmen und Besonderheiten des Moments, in dem die Auswahl getroffen wurde. Die wirklichen Prüfungen für das gewählte System beginnen mit dem Wechsel in die Produktion, und genau auf diesen Schritt sollte man bei der Auswahl eines jeden Systems, einschließlich Caching, achten. Man kann sagen, dass wir Hazelcast zufällig gewählt haben, aber später stellte sich heraus, dass die Wahl richtig war.
Für die Produktion sind viel wichtiger: Monitoring, Fehlerbehandlung auf einzelnen Knoten, Datenreplikation, Kosten für das Scaling. Das heißt, man sollte auf die Aufgaben achten, die beim Betrieb des Systems auftreten – wenn die Last um das Zehnfache die geplante übersteigt, wenn wir versehentlich etwas Falsches und auf den falschen Ort hochladen, wenn eine neue Version des Codes ausgerollt und Daten ersetzt werden müssen und dies unbemerkt für die Kunden geschieht.
Für all diese Anforderungen passt Hazelcast zweifellos.
Fortsetzung folgt
Aber Hazelcast ist kein Allheilmittel. 2017 wählten wir Hazelcast als Cache für das Admin-Panel, einfach basierend auf den positiven Eindrücken aus der Vergangenheit. Dies spielte eine Schlüsselrolle in einem sehr bösen Witz, wodurch wir uns in einer schwierigen Situation wiederfanden und uns "heldenhaft" 60 Tage daraus herauskämpfen mussten. Aber davon in dem nächsten Teil.
Und bis dahin... Happy New Code!
Quelle: habr.com
