

Entwickler des Netfilter-Subsystems zur Filterung und Modifikation von Netzwerkpaketen ein Satz von Patches, die die Verarbeitung großer Matching-Listen (nftables set), die eine Überprüfung der Kombination aus Subnetzen, Netzwerkports, Protokollen und MAC-Adressen erfordern, erheblich beschleunigen. Die Patches wurden bereits in die Branch , die für die Aufnahme in den Linux-Kernel 5.7 vorgeschlagen wird. Die bemerkenswerteste Beschleunigung wurde durch von AVX2-Instruktionen erreicht (eine ähnliche Optimierung auf Basis von NEON-Instruktionen für ARM ist vorgesehen).
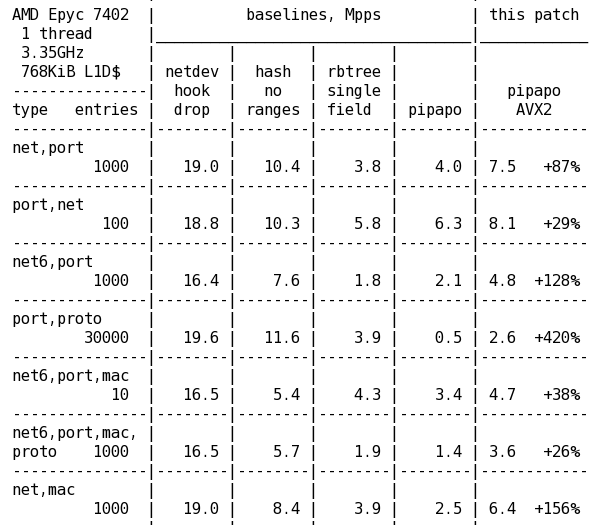
Die Optimierungen wurden in das Modul eingeführt (PIle PAcket POlicies), das die Aufgabe übernimmt, den Inhalt eines Pakets mit den in den Filterregeln verwendeten beliebigen Bereichszuständen der Felder, wie beispielsweise IP- und Netzwerkportbereichen, abzugleichen (nft_set_rbtree und nft_set_hash manipulieren den Abgleich von Intervallen und direkten Wertspiegelungen). Die vektorisierten 256-Bit-AVX2-Version von pipapo auf einem System mit einem AMD Epyc 7402-Prozessor zeigte eine Leistungssteigerung von 420 % beim Parsen von 30.000 Einträgen, darunter Port-Protokoll-Paare. Die Steigerung beim Abgleich eines Paars aus Subnetz und Portnummer beim Parsen von 1.000 Einträgen betrug 87 % für IPv4 und 128 % für IPv6.
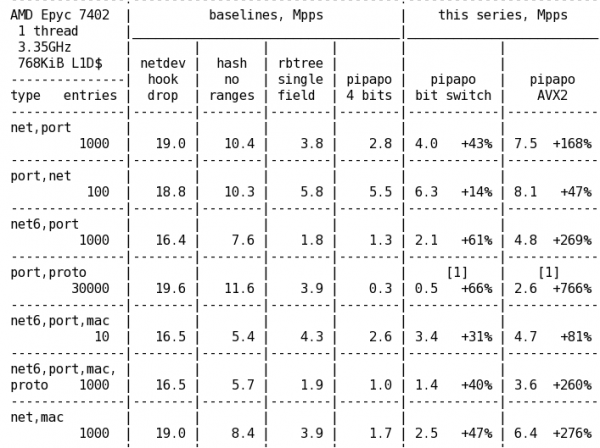
Eine weitere Optimierung, die die Verwendung von 8-Bit-Matching-Gruppen anstelle von 4-Bit-Gruppen ermöglicht, zeigte ebenfalls einen spürbaren Leistungsschub: 66 % beim Parsen von 30.000 Port-Protokoll-Einträgen, 43 % — Subnetz_IPV4-Port und 61 % — Subnetz_IPV6-Port. Insgesamt, unter Berücksichtigung der AVX2-Optimierungen, erhöhte sich die Leistung von pipapo in den genannten Tests um 766 %, 168 % und 269 % entsprechend. Die für komplexe Abgleiche erzielten Charakteristika übertreffen die Überprüfungen einzelner Felder in (außer im Test des Port+Protokoll-Paars), liegen aber derzeit hinter direkten Überprüfungen mithilfe von und Drop-Handlers auf Basis von netdev zurück.
Quelle: opennet.ru
