

Vor einigen Monaten — ein öffentlicher für PostgreSQL.
In der Zwischenzeit haben Sie ihn bereits über 6000 Mal genutzt, aber eine der nützlichen Funktionen könnte unbemerkt geblieben sein — das sind strukturierte Hinweise, die ungefähr so aussehen:
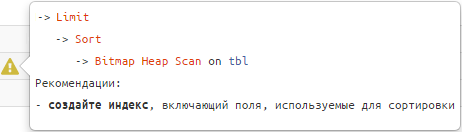
Achten Sie darauf, und Ihre Abfragen werden „glatt und seidig“. 🙂
Und ernsthaft gesagt, viele Situationen, die eine Abfrage langsam und „ressourcenintensiv“ machen, sind typisch und können an der Struktur und den Daten des Plans erkannt werden..
In diesem Fall muss jeder einzelne Entwickler nicht selbst nach einer Optimierung suchen, nur basierend auf seiner Erfahrung — wir können ihm sagen, was hier passiert, wo die Ursache sein könnte, und wie man an die Lösung herangehen kann. Das haben wir auch getan.
Lassen Sie uns diese Fälle etwas genauer betrachten — wie sie definiert werden und zu welchen Empfehlungen sie führen.
Um besser in das Thema einzutauchen, können Sie zunächst den entsprechenden Block aus anhören, und dann zum detaillierten Durchgang jedes Beispiels übergehen:
#1: индексная «недосортировка»
Wenn entsteht
Zeigen Sie die letzte Rechnung für den Kunden „OOO Kolokolchik“.
Wie erkennt man
-> Limit
   -> Sort
      -> Index [Only] Scan [Backward] | Bitmap Heap Scan
Empfehlungen
Verwendeter Index mit Sortierfeldern erweitern.
Beispiel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "Fakten"
, (random() * 1000)::integer fk_cli; -- 1K verschiedene Fremdschlüssel

CREATE INDEX ON tbl(fk_cli); -- Index für foreign key

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- Auswahl anhand einer bestimmten Verbindung
ORDER BY
  pk DESC -- wir möchten nur einen "letzten" Eintrag
LIMIT 1; 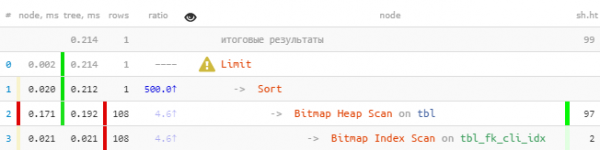
Es fällt sofort auf, dass über den Index mehr als 100 Datensätze gelesen wurden, die dann alle sortiert wurden und dann blieb nur einer übrig.
Wir verbessern:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- Sortierschlüssel hinzugefügt
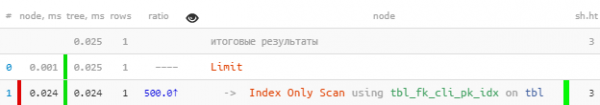
Selbst bei solch einer primitiven Auswahl — 8,5 Mal schneller und 33 Mal weniger Lesevorgänge.Der Effekt wird umso deutlicher, je mehr „Fakten“ Sie für jeden Wert haben fk.
Ich möchte anmerken, dass ein solcher Index auch als „Präfix“-Index nicht schlechter bei anderen Abfragen funktionieren wird, bei fk, wo es keine Sortierung nach pk gab und gibt (mehr dazu können Sie lesen ). Darüber hinaus wird er auch eine normale die explizite Unterstützung von Foreign Keys für dieses Feld.
#2: пересечение индексов (BitmapAnd)
Wenn entsteht
Zeige alle Verträge für den Kunden „OOO Kolokolchik“, die im Namen von „NAO Lyutik“ abgeschlossen wurden.
Wie erkennt man
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Empfehlungen
Erstellen komplexer Index über Felder aus beiden Ausgangstypen oder erweitere einen der vorhandenen mit Feldern aus dem zweiten.
Beispiel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "Fakten"
, (random() *  100)::integer fk_org  -- 100 verschiedene Foreign Keys
, (random() * 1000)::integer fk_cli; -- 1K verschiedene Foreign Keys

CREATE INDEX ON tbl(fk_org); -- Index für Foreign Key
CREATE INDEX ON tbl(fk_cli); -- Index für Foreign Key

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- Auswahl nach spezifischem Paar 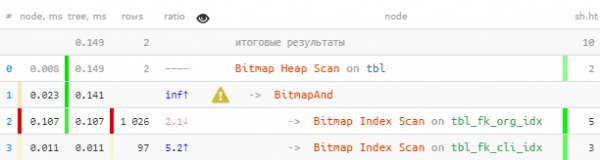
Wir verbessern:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
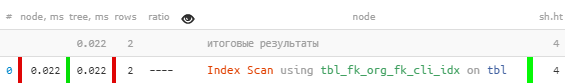
Hier ist der Gewinn geringer, da der Bitmap Heap Scan allein schon recht effizient ist. Aber trotzdem siebenmal schneller und 2,5-mal weniger Lesevorgänge.
#3: объединение индексов (BitmapOr)
Wenn entsteht
Zeige die ersten 20 ältesten „eigenen“ oder nicht zugewiesenen Anträge zur Bearbeitung, wobei die eigenen Vorrang haben.
Wie erkennt man
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Empfehlungen
Verwenden UNION [ALL] um Unterabfragen für jede der OR-Bedingungen zusammenzuführen.
Beispiel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "Fakten"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- mit einer Wahrscheinlichkeit von 1:16 wird "unentschieden" gespeichert
    ELSE (random() * 100)::integer -- 100 verschiedene Foreign Keys
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- Index mit "anscheinend passender" Sortierung

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- eigene
  fk_own IS NULL -- ... oder "unentschieden"
ORDER BY
  pk
, (fk_own = 1) DESC -- zuerst "eigene"
LIMIT 20;
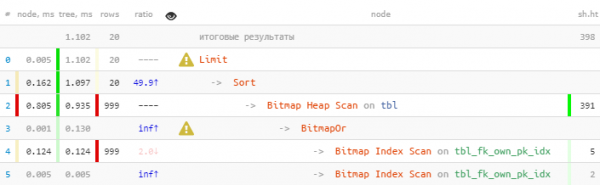
Wir verbessern:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- zuerst "eigene" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- dann "unentschieden" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- aber insgesamt - 20, mehr ist nicht nötig 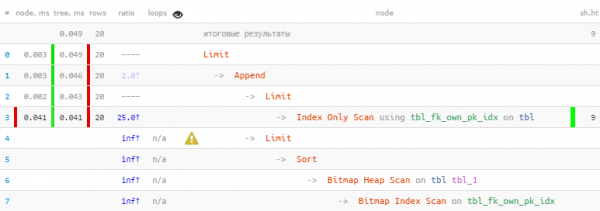
Wir haben davon profitiert, dass alle 20 benötigten Einträge bereits im ersten Block abgerufen wurden, sodass der zweite Block mit dem "teuereren" Bitmap Heap Scan nicht einmal ausgeführt wurde — somit 22-mal schneller, bei 44-mal weniger Lesevorgängen!
Eine detaillierte Erzählung über diese Optimierungsmethode an konkreten Beispielen kann in den Artikeln und .
Eine verallgemeinerte Version der sortierten Auswahl nach mehreren Schlüsselwerten (nicht nur nach einem Paar const/NULL) wird im Artikel behandelt .
#4: читаем много лишнего
Wenn entsteht
Entsteht in der Regel, wenn man "noch einen Filter" zu einer bereits bestehenden Abfrage hinzufügen möchte.
„Haben Sie nicht so etwas, aber mit Perlmuttknöpfen?» Film «Der diamantene Arm»
Zum Beispiel, indem die vorherige Aufgabe modifiziert wird, um die ersten 20 ältesten "kritischen" Anträge zur Bearbeitung anzuzeigen, unabhängig von ihrer Bestimmung.
Wie erkennt man
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × Zeilen < RRbF -- mehr als 80 % des Gelesenen gefiltert
   && Schleifen × RRbF > 100 -- und mehr als 100 Datensätze insgesamt
Empfehlungen
Erstellen Sie [ein] spezialisierteres Index mit WHERE-Bedingung oder zusätzliche Felder in den Index einfügen.
Wenn die Filterbedingung für Ihre Aufgaben "statisch" ist - das heißt, keine Erweiterung der Werte in Zukunft vermuten lässt - ist es besser, ein WHERE-Index zu verwenden. In diese Kategorie passen gut verschiedene boolean/enum-Status.
Wenn jedoch die Filterbedingung verschiedene Werte annehmen kann,, ist es besser, den Index mit diesen Feldern zu erweitern - wie im obigen Beispiel mit BitmapAnd.
Beispiel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "Fakten"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 verschiedene Fremdschlüssel
  END fk_own
, (random() < 1::real/50) kritisch; -- 1:50, dass der Antrag "kritisch" ist

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  kritisch
ORDER BY
  pk
LIMIT 20; 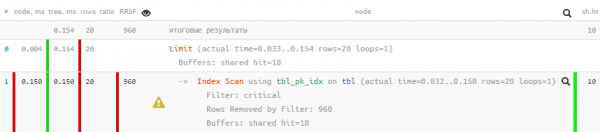
Wir verbessern:
CREATE INDEX ON tbl(pk)
  WHERE kritisch; -- "statische" Filterbedingung hinzugefügt
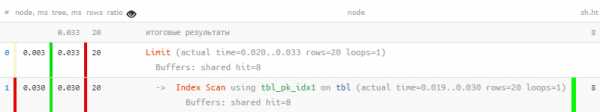
Wie wir sehen, ist die Filterung aus dem Plan vollständig verschwunden und die Anfrage wurde 5 Mal schneller.
#5: разреженная таблица
Wenn entsteht
Verschiedene Versuche, eine eigene Aufgabenbearbeitungswarteschlange zu erstellen, wenn eine große Anzahl von Aktualisierungen/Löschungen von Datensätzen in der Tabelle zu einer Situation mit vielen "toten" Datensätzen führt.
Wie erkennt man
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && Schleifen × (Zeilen + RRbF) < (shared hit + shared read) × 8
      -- mehr als 1KB pro Datensatz gelesen
   && shared hit + shared read > 64
Empfehlungen
Regelmäßig manuell durchführen VACUUM [FULL] oder eine angemessen häufige Bearbeitung erreichen durch Feineinstellung seiner Parameter, einschließlich .
In den meisten Fällen werden solche Probleme durch eine schlechte Strukturierung der Anfragen bei Aufrufen aus der Geschäft logik wie die, die in .
Aber es ist wichtig zu verstehen, dass selbst VACUUM FULL nicht immer helfen kann. Für solche Fälle sollte man sich mit dem Algorithmus aus dem Artikel vertrautmachen .
#6: чтение с «середины» индекса
Wenn entsteht
Es scheint, als hätten wir ein wenig gelesen, alles nach dem Index und niemanden unnötig gefiltert - und dennoch wurden erheblich mehr Seiten gelesen, als gewünscht.
Wie erkennt man
-> Index [Nur] Scan [Rückwärts]
   && Schleifen × (Zeilen + RRbF)  64
Empfehlungen
Schauen Sie sich sorgfältig die Struktur des verwendeten Index und die Schlüsselbereiche an, die in der Anfrage festgelegt sind – höchstwahrscheinlich ein Teil des Index ist nicht festgelegt. Höchstwahrscheinlich müssen Sie einen ähnlichen Index erstellen, aber ohne Präfixbereiche oder .
Beispiel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "Fakten"
, (random() *  100)::integer fk_org  -- 100 verschiedene Fremdschlüssel
, (random() * 1000)::integer fk_cli; -- 1K verschiedene Fremdschlüssel

CREATE INDEX ON tbl(fk_org, fk_cli); -- alles fast wie in #2
-- nur, dass wir den separaten Index nach fk_cli als überflüssig betrachtet und entfernt haben

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- aber fk_org ist nicht festgelegt, obwohl es früher im Index steht
LIMIT 20; 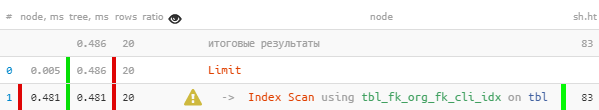
Es scheint alles gut zu sein, sogar nach dem Index, aber irgendwie verdächtig – für jeden der 20 gelesenen Einträge mussten 4 Datenseiten gelesen werden, 32KB pro Eintrag – ist das nicht zu viel? Und der Name des Index tbl_fk_org_fk_cli_idx regt zum Nachdenken an.
Wir verbessern:
CREATE INDEX ON tbl(fk_cli); 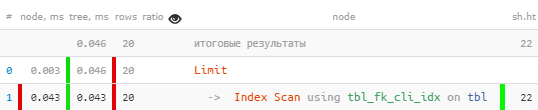
Überraschenderweise – 10 Mal schneller und 4 Mal weniger zu lesen!
Weitere Beispiele für ineffektive Indexnutzung sind im Artikel zu sehen .
#7: CTE × CTE
Wenn entsteht
In der Anfrage wurden "fette" CTEs aus verschiedenen Tabellen gesammelt, und dann entschieden, zwischen ihnen JOIN.
Der Fall ist relevant für Versionen unter v12 oder Anfragen mit WITH MATERIALIZED.
Wie erkennt man
-> CTE Scan
   && Schleifen > 10
   && Schleifen × (Zeilen + RRbF) > 10000
      -- zu großes kartesisches Produkt der CTE
Empfehlungen
Die Anfrage sorgfältig analysieren – sind hier überhaupt CTEs notwendig ? Если все-таки да, то nach dem in beschriebenen Modell. .
#8: swap на диск (temp written)
Wenn entsteht
Eine einmalige Verarbeitung (Sortierung oder Einzigartigkeit) einer großen Anzahl von Einträgen passt nicht in den dafür vorgesehenen Speicher.
Wie erkennt man
-> *
   && Temp geschrieben > 0
Empfehlungen
Wenn der durch die Operation verwendete Speicher die festgelegte Parametergrenze nicht stark überschreitet, , sollte er angepasst werden. Man kann es gleich in der Konfiguration für alle tun, oder durch SET [LOCAL] für eine bestimmte Anfrage/Transaktion.
Beispiel:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 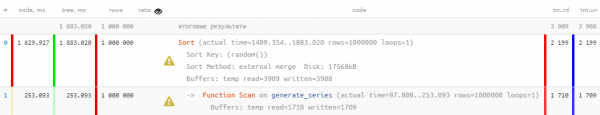
Wir verbessern:
SET work_mem = '128MB'; -- vor der Ausführung der Anfrage 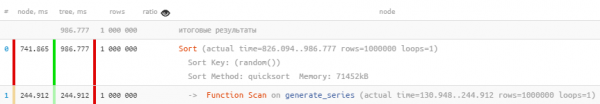
Aus offensichtlichen Gründen, wenn nur der Speicher und nicht die Festplatte verwendet wird, wird die Anfrage auch viel schneller ausgeführt. Dabei wird auch ein Teil der Last von der HDD genommen.
Aber man muss verstehen, dass es nicht immer möglich ist, sehr viel Speicher zuzuweisen – es reicht einfach nicht für alle.
#9: неактуальная статистика
Wenn entsteht
In die Datenbank wurden sofort viele Daten eingespielt, aber es blieb keine Zeit für die Verarbeitung. ANALYSIEREN.
Wie erkennt man
-> Sequential Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && Verhältnis >> 10
Empfehlungen
Tatsächlich durchführen ANALYSIEREN.
Diese Situation wird ausführlicher beschrieben in .
#10: «что-то пошло не так»
Wenn entsteht
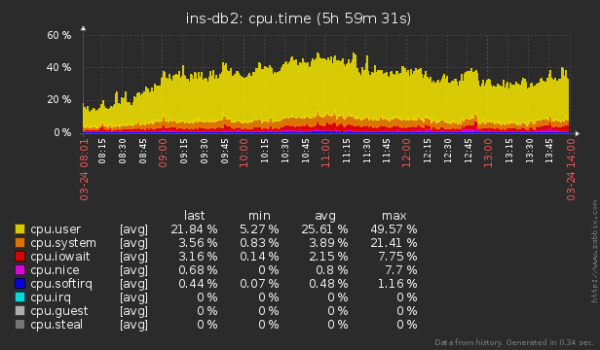
Es gab eine Warteschlange wegen einer Sperre, die von einer konkurrierenden Abfrage verhängt wurde, oder es gab nicht genug Hardware-Ressourcen von CPU/Hypervisor.
Wie erkennt man
-> *
   && (shared hit / 8K) + (shared read / 1K) < Zeit / 1000
      -- RAM-Hit = 64MB/s, HDD-Lesevorgang = 8MB/s
   && Zeit > 100ms -- wir haben wenig gelesen, aber es hat zu lange gedauert
Empfehlungen
Verwenden Sie ein externes Überwachungssystem für Server zur Überwachung auf Sperren oder unregelmäßigen Ressourcenverbrauch. Über unseren Ansatz zur Organisation dieses Prozesses für Hunderte von Servern haben wir bereits berichtet. und .
Quelle: habr.com
