

Ich erkläre sofort den Titel des Artikels. Ursprünglich war geplant, einen guten, zuverlässigen Rat zur Beschleunigung der Nutzung von Reflection anhand eines einfachen, aber realistischen Beispiels zu geben. Im Verlauf des Benchmarks stellte sich jedoch heraus, dass Reflection nicht so langsam arbeitet, wie ich dachte, während LINQ langsamer ist, als ich in meinen schlimmsten Albträumen befürchtet hatte. Außerdem stellte sich heraus, dass ich einen Fehler bei den Messungen gemacht habe… Die Details dieser Lebensgeschichte finden Sie im weiteren Verlauf und in den Kommentaren. Da das Beispiel recht alltäglich ist und grundsätzlich so umgesetzt wird, wie es normalerweise in einem Unternehmen geschieht, handelt es sich meiner Meinung nach um eine interessante Demonstration des Lebens: Der Einfluss auf die Geschwindigkeit der Arbeit des Hauptthemas des Artikels war aufgrund der externen Logik nicht spürbar: Moq, Autofac, EF Core und ähnliches "Wrapping".
Ich begann meine Arbeit mit dem Eindruck, den dieser Artikel hinterließ:
Wie man sieht, schlägt der Autor vor, kompilierte Delegaten anstelle des direkten Zugriffs auf die Methoden der Typen der Reflection zu verwenden, als hervorragenden Weg, die Leistung der Anwendung erheblich zu steigern. Es gibt dort auch IL-Emissionen, aber die möchte ich vermeiden, da dies die arbeitsintensivste Art der Aufgabenerledigung ist, die fehleranfällig ist.
Da ich immer der gleichen Meinung über die Geschwindigkeit der Reflection war, hatte ich nicht vor, die Schlussfolgerungen des Autors in Frage zu stellen.
Ich stoße häufig auf naive Anwendungen von Reflection im Unternehmen. Man nimmt einen Typ, holt sich Informationen über eine Eigenschaft, ruft die Methode SetValue auf und alle sind glücklich. Der Wert ist im Zielgebiet angekommen, alle sind zufrieden. Die Menschen sind sehr klug – Senior-Entwickler und Teamleiter – sie schreiben ihre Erweiterungen für Object, basierend auf solch einer naiven Implementierung "universelle" Mapper von einem Typ zu einem anderen. Die Vorgehensweise ist meistens: alle Felder und Eigenschaften holen und über sie iterieren: Bei Übereinstimmung der Namen der Typmitglieder wird SetValue ausgeführt. Gelegentlich fangen wir Ausnahmen bei Fehlern, wenn eine Eigenschaft eines der Typen nicht gefunden wurde, aber auch dafür gibt es eine Lösung, die die Leistung verbessert. Try/Catch.
Ich habe gesehen, wie Menschen Parser und Mapper neu erfinden, ohne vollständig informiert zu sein, wie die vorher erfundenen Fahrräder funktionieren. Ich habe gesehen, wie Menschen ihre naiven Implementierungen hinter Strategien, Interfaces und Injektionen verstecken, als könnte das die nachfolgende Wirrsal entschuldigen. Von solchen Implementierungen habe ich Abstand genommen. Tatsächlich habe ich keine echte Leistungsabnahme gemessen und habe, wo immer möglich, einfach die Implementierung gegen eine „optimale“ ausgetauscht, wenn ich dazu kam. Deshalb hat mich die erste Messung, über die weiter unten die Rede ist, ernsthaft überrascht.
Ich denke, viele von Ihnen haben beim Lesen von Richter oder anderen Ideologen mit einem durchaus berechtigten Argument konfrontiert, dass Reflexion im Code sich äußerst negativ auf die Performance der Anwendung auswirkt.
Der Reflexionsaufruf zwingt den CLR, die Assemblies nach der benötigten zu durchsuchen, ihre Metadaten zu laden, sie zu parsen usw. Darüber hinaus führt die Reflexion während des Durchlaufens von Sequenzen zu einer großen Speicherallokation. Wenn wir Speicher verbrauchen, schaltet der CLR den GC ein und schon gibt es Ruckler. Das sollte spürbar langsam sein, glauben Sie mir. Große Speichermengen moderner Produktionsserver oder Cloud-Maschinen schützen nicht vor hohen Latenzen bei der Verarbeitung. Tatsächlich gilt: Je mehr Speicher vorhanden ist, desto wahrscheinlicher werden Sie merken, wie der GC arbeitet. Reflexion ist, theoretisch gesehen, ein zusätzlicher roter Tuch für ihn.
Dennoch nutzen wir sowohl IoC-Container als auch Datenmapper, deren Funktionsweise ebenfalls auf Reflexion basiert. Fragen zur Performance treten dabei normalerweise nicht auf. Nein, nicht weil Dependency Injection und Abstraktion von Modellen des eingeschränkten äußeren Kontexts so notwendig sind, dass wir in jedem Fall auf Performance verzichten müssen. Es ist einfacher – sie wirken sich tatsächlich nicht stark auf die Leistung aus.
Die Sache ist die, dass die gängigsten Frameworks, die auf Reflexionstechnologie basieren, verschiedenste Tricks anwenden, um effizienter damit zu arbeiten. In der Regel geschieht dies durch Caching. Üblicherweise sind das Expressions und aus dem Ausdrucksbaum kompilierte Delegaten. Der gleiche Automapper hält ein konkurrierendes Dictionary bereit, das Typen mit Funktionen verknüpft, die bereits ohne Reflexionsaufruf in einander konvertieren können.
Wie wird das erreicht? Im Grunde genommen unterscheidet es sich nicht von der Logik, die die Plattform selbst zur Generierung von JIT-Code verwendet. Bei dem ersten Aufruf einer Methode wird diese kompiliert (und ja, dieser Prozess ist nicht schnell), bei nachfolgenden Aufrufen wird die Kontrolle an die bereits kompilierte Methode übergeben, und hier gibt es keine signifikanten Leistungseinbußen.
In unserem Fall können wir ebenfalls die JIT-Kompilierung nutzen und dann das kompilierte Verhalten mit derselben Leistung wie seine AOT-Alternativen verwenden. Ausdrücke werden uns in diesem Fall helfen.
Der Grundsatz, um den es hier geht, lässt sich kurz zusammenfassen:
Es ist sinnvoll, das Endergebnis der Reflexion in Form eines Delegaten zu cachen, der die kompilierte Funktion enthält. Auch alle notwendigen Objekte mit Typinformationen sollten in den außerhalb der Objekte gespeicherten Feldern Ihres Typs – des Workers – gecacht werden.
Da macht es Sinn. Der gesunde Menschenverstand sagt uns, dass, wenn etwas kompiliert und zwischengespeichert werden kann, es sinnvoll ist, dies zu tun.
Um vorzugreifen, sollte gesagt werden, dass Caching bei der Arbeit mit Reflexion seine Vorteile hat, selbst wenn die vorgeschlagene Methode zur Kompilierung von Ausdrücken nicht verwendet wird. Tatsächlich wiederhole ich hier einfach die Thesen des Autors des Artikels, auf den ich oben verlinkt habe.
Jetzt zum Code. Lassen Sie uns ein Beispiel betrachten, das auf meinem jüngsten Schmerz basiert, mit dem ich in einer ernsthaften Produktion einer ernsthaften Kreditinstitution konfrontiert wurde. Alle Entitäten sind fiktiv, damit niemand darauf kommt.
Es gibt eine gewisse Entität. Nennen wir sie Kontakt. Es gibt E-Mails mit einem standardisierten Inhalt, aus denen Parser und Hydrator diese Kontakte erstellen. Eine E-Mail kommt an, wir lesen sie, zerlegen sie in Schlüssel-Wert-Paare, erstellen einen Kontakt und speichern ihn in der Datenbank.
Das ist ganz einfach. Angenommen, der Kontakt hat die Eigenschaften Name, Alter und Telefonnummer. Diese Daten werden in der E-Mail übermittelt. Außerdem möchte das Geschäft, dass die Supportmitarbeiter neue Schlüssel zur Zuordnung von Eigenschaften der Entität zu Paaren im E-Mail-Inhalt schnell hinzufügen können, falls jemand einen Tippfehler im Template gemacht hat oder wenn vor der Veröffentlichung dringend die Zuordnung eines neuen Partners im neuen Format gestartet werden muss. Dann können wir die neue Zuordnung als einfachen Datenfix hinzufügen. Das heißt, ein praxisnahes Beispiel.
Wir implementieren und erstellen Tests. Es funktioniert.
Ich werde den Code nicht bereitstellen: Es gibt viele Quellcodes, und sie sind über den Link am Ende des Artikels auf GitHub verfügbar. Sie können sie herunterladen, gründlich testen und messen, wie es sich in Ihrem Fall auswirken würde. Ich werde nur den Code von zwei Vorlagenmethoden bereitstellen, die den schnellen Hydrator von dem langsamen unterscheiden.
Die Logik ist wie folgt: Die Vorlagenmethode erhält Paare, die durch die grundlegende Logik des Parsers gebildet werden. Das LINQ-Niveau ist der Parser und die grundlegende Logik des Hydrators, die Abfragen an den Datenbankkontext stellt und Schlüssel mit den Paaren des Parsers abgleicht (für diese Funktionen gibt es einen Code ohne LINQ zum Vergleich). Anschließend werden die Paare an die Hauptmethode der Hydrierung übergeben und die Werte der Parameter werden den entsprechenden Eigenschaften der Entität zugewiesen.
"Schnell" (Präfix Fast in Benchmarks):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Wie wir sehen, wird eine statische Sammlung mit Property-Settern verwendet – kompilierten Lambdas, die den Setter der Entität aufrufen. Sie werden mit folgendem Code erstellt:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Im Großen und Ganzen ist es klar. Wir durchlaufen die Eigenschaften, erstellen Delegaten, die die Setter aufrufen und speichern sie. Dann rufen wir sie auf, wenn es nötig ist.
"Langsam" (Präfix Slow in Benchmarks):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Hier durchlaufen wir sofort die Eigenschaften und rufen direkt SetValue auf.
Zur Veranschaulichung und als Referenz habe ich eine naive Methode implementiert, die die Werte ihrer Korrelationspaare direkt in die Felder der Entität schreibt. Präfix – Manual.
Jetzt nehmen wir BenchmarkDotNet und untersuchen die Leistung. Und plötzlich… (Spoiler — das ist nicht das richtige Ergebnis, Details — unten)
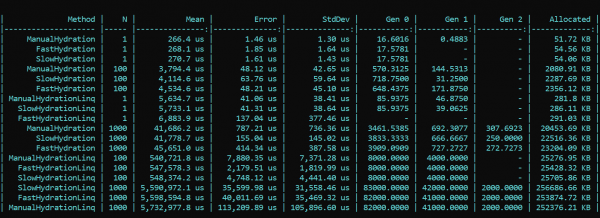
Was sehen wir hier? Methoden, die triumphierend das Präfix Fast tragen, sind fast in allen Durchläufen langsamer als die Methoden mit dem Präfix Slow. Das gilt sowohl für die Allokation als auch für die Geschwindigkeit. Auf der anderen Seite frisst eine schöne und elegante Implementierung des Mappings mit der Verwendung aller verfügbaren LINQ-Methoden hingegen stark Leistungsverluste. Der Unterschied ist erheblich. Die Tendenz ändert sich nicht mit der Anzahl der Durchläufe. Der Unterschied liegt nur in den Maßstäben. Mit LINQ ist es 4 — 200 Mal langsamer, der Müll ist in etwa den gleichen Maßstäben höher.
AKTUALISIERT
Ich konnte meinen Augen nicht trauen, aber was noch wichtiger ist, weder meine Augen noch mein Code wollten unserem Kollegen glauben — . Nachdem er meine Lösung überprüft hatte, entdeckte und wies er brillant auf den Fehler hin, den ich aufgrund einer Reihe von Änderungen bei der Implementierung von der ursprünglichen zur endgültigen Version übersehen hatte. Nach der Korrektur des gefundenen Fehlers in der Moq-Konfiguration bekamen alle Ergebnisse ihren Platz zurück. Bei den Ergebnissen des Retests ändert sich die Haupttendenz nicht — LINQ beeinflusst die Leistung immer noch stärker als die Reflexion. Es ist jedoch erfreulich, dass die Arbeit mit der Kompilierung von Expressions nicht umsonst ist und das Ergebnis sowohl bei der Allokation als auch bei der Ausführungszeit sichtbar ist. Der erste Start, bei dem statische Felder initialisiert werden, ist erwartungsgemäß langsamer bei der „schnellen“ Methode, aber danach ändert sich die Situation.
Hier sind die Ergebnisse des Retests:
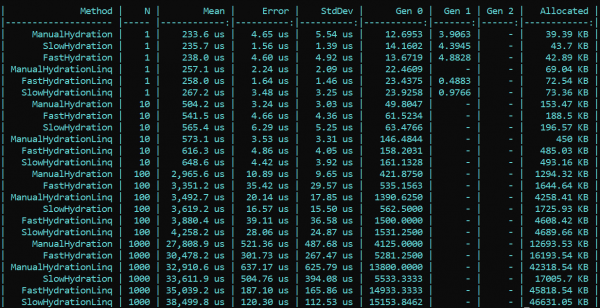
Fazit: Bei der Verwendung von Reflexion im Unternehmensumfeld ist es nicht erforderlich, besonders zu tricksen — LINQ frisst die Leistung stärker. Dennoch kann in hochbelasteten Methoden, die eine Optimierung erfordern, Reflexion in Form von Initialisierern und Delegatenkompilierern beibehalten werden, die später die „schnelle“ Logik sicherstellen. So können Sie sowohl die Flexibilität der Reflexion als auch die Geschwindigkeit der Anwendung erhalten.
Der Code mit dem Benchmark ist hier verfügbar. Alle Interessierten können meine Aussagen überprüfen:
PS: Der Code in den Tests verwendet IoC, während in den Benchmarks eine explizite Struktur verwendet wird. Das liegt daran, dass ich in der endgültigen Implementierung alle Faktoren ausgeschlossen habe, die sich auf die Leistung auswirken und das Ergebnis verschleiern könnten.
PPS: Danke an den Benutzer für die Entdeckung meines Fehlers in der Moq-Konfiguration, der die ersten Messungen beeinflusst hat. Wenn einer der Leser genug Karma hat, liken Sie ihn bitte. Die Person hat innegehalten, sich eingelesen, alles überprüft und auf den Fehler hingewiesen. Ich halte das für respektabel und sympathisch.
PPPS: Danke an den gewissenhaften Leser, der sich mit dem Stil und der Gestaltung beschäftigt hat. Ich bin für Einheitlichkeit und Benutzerfreundlichkeit. Die Diplomatie der Präsentation lässt zu wünschen übrig, aber ich habe die Kritik berücksichtigt. Bitte um Verständnis.
Quelle: habr.com
