

Mit dem Schwinden der IPv4-Adressen stehen viele Telekommunikationsanbieter vor der Notwendigkeit, den Zugang ihrer Kunden zum Netzwerk über Address Translation zu organisieren. In diesem Artikel werde ich erklären, wie man Carrier Grade NAT-Leistung auf Commodity-Servern erreichen kann.
Ein wenig Geschichte
Das Thema des Schwunds des IPv4-Adressraums ist nicht neu. So gab es irgendwann in RIPE Wartelisten, dann entstanden Märkte, auf denen Adressblöcke gehandelt und Mietverträge für diese abgeschlossen wurden. Nach und nach begannen die Telekommunikationsanbieter, Internetzugangsdienste mithilfe von Address- und Port-Translation anzubieten. Einige konnten nicht genügend Adressen erhalten, um jedem Abonnenten eine „weiße“ Adresse zuzuweisen, während andere begannen, Kosten zu sparen, indem sie auf den Kauf von Adressen auf dem Sekundärmarkt verzichteten. Die Hersteller von Netzwerkausrüstung unterstützten diese Idee, da diese Funktionalität in der Regel zusätzliche Erweiterungsmodule oder Lizenzen erfordert. Zum Beispiel kann man bei Juniper in der MX-Router-Linie (außer bei den neuesten MX104 und MX204) NAPT auf einer separaten Servicekarte MS-MIC durchführen, bei Cisco ASR1k ist eine CGN-Lizenz erforderlich, bei Cisco ASR9k ein separates Modul A9K-ISM-100 und eine Lizenz A9K-CGN-LIC dafür. Insgesamt kostet der Spaß eine Menge Geld.
IPTables
Die Aufgabe, NAT zu implementieren, erfordert keine spezialisierten Rechenressourcen; sie kann von allgemeinen Prozessoren bewältigt werden, die beispielsweise in jedem Heimrouter installiert sind. Im Rahmen einer Telekommunikationsgesellschaft kann diese Aufgabe mit Commodity-Servern unter FreeBSD (ipfw/pf) oder GNU/Linux (iptables) gelöst werden. FreeBSD wollen wir hierbei nicht betrachten, da ich diese Betriebssystem vor einiger Zeit aufgehört habe zu nutzen, also werden wir uns auf GNU/Linux konzentrieren.
Es ist überhaupt nicht schwierig, die Adressübersetzung zu aktivieren. Zunächst müssen Sie eine Regel in iptables in die nat-Tabelle einfügen:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Das Betriebssystem lädt das Modul nf_conntrack, das alle aktiven Verbindungen überwacht und die erforderlichen Umwandlungen durchführt. Es gibt dabei einige Feinheiten. Erstens, da es sich um NAT im Umfang eines Telekommunikationsanbieters handelt, müssen die Timeouts angepasst werden, da die Standardwerte dazu führen, dass die Größe der Translations-Tabelle schnell auf katastrophale Werte anwächst. Hier ein Beispiel für die Einstellungen, die ich auf meinen Servern verwendet habe:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
Und zweitens, da die Standardgröße der Translations-Tabelle nicht für den Betrieb bei einem Telekommunikationsanbieter ausgelegt ist, muss sie erhöht werden:
net.netfilter.nf_conntrack_max = 3145728
Außerdem muss auch die Anzahl der Buckets für die Hash-Tabelle, die alle Translations speichert (dies ist eine Option des Moduls nf_conntrack), erhöht werden:
options nf_conntrack hashsize=1572864
Nach diesen einfachen Anpassungen entsteht eine funktionierende Struktur, die eine große Anzahl an Client-Adressen in einen Pool von externen Adressen umwandeln kann. Allerdings lässt die Leistung dieser Lösung zu wünschen übrig. Bei meinen ersten Versuchen, GNU/Linux für NAT zu verwenden (ca. 2013) konnte ich eine Leistung von etwa 7Gbit/s bei 0,8Mpps auf einem Server (Xeon E5-1650v2) erreichen. Seitdem wurden viele verschiedene Optimierungen im Netzwerk-Stack des GNU/Linux-Kernels vorgenommen, und die Leistung eines Servers bei der gleichen Hardware stieg praktisch auf 18-19 Gbit/s bei 1,8-1,9 Mpps (das waren die Grenzwerte). Doch der Bedarf an dem Volumen des Datenverkehrs, das von einem Server verarbeitet wird, nahm viel schneller zu. letztlich wurden Load-Balancing-Schemata auf verschiedene Server entwickelt, wodurch die Komplexität der Konfiguration, des Betriebs und der Aufrechterhaltung der Qualität der Dienstleistungen zunahm.
NFTables
Derzeit ist der Trend im programmatischen «Umsetzen von Paketen» die Nutzung von DPDK und XDP. Zu diesem Thema wurden zahlreiche Artikel veröffentlicht, viele verschiedene Präsentationen gehalten, und es erscheinen kommerzielle Produkte (zum Beispiel SKAT von VasExperts). Doch unter den Bedingungen begrenzter Ressourcen der Programmierer bei den Telekommunikationsanbietern ist es ziemlich problematisch, eigenständig ein «Werk» auf Basis dieser Frameworks zu entwickeln. Ein solches Lösung später zu nutzen, wird wesentlich schwieriger sein, da insbesondere Werkzeuge zur Diagnose entwickelt werden müssen. Beispielsweise wird der Standard tcpdump mit DPDK nicht einfach so funktionieren, und die Pakete, die mit XDP zurück in die Leitungen gesendet werden, wird er nicht «sehen». Vor dem Hintergrund aller Gespräche über neue Technologien zum Ausgeben von Paketweiterleitungen im User-Space sind unbemerkt geblieben und Pablo Neira Ayuso, den Maintainer von iptables, über die Entwicklung des Flow Offloadings in nftables. Lassen Sie uns diesen Mechanismus genauer betrachten.
Die Hauptidee besteht darin, dass, wenn der Router Pakete einer Sitzung in beide Richtungen des Flusses (eine TCP-Sitzung hat den Status ESTABLISHED erreicht) durchlässt, es nicht notwendig ist, nachfolgende Pakete dieser Sitzung durch alle Firewall-Regeln zu leiten, da alle diese Prüfungen ohnehin mit der Übertragung des Pakets zur weiteren Routing fortgesetzt werden. Zudem muss die Routenwahl nicht getroffen werden — wir wissen bereits, auf welches Interface und an welchen Host die Pakete innerhalb dieser Sitzung gesendet werden sollen. Es bleibt nur, diese Informationen zu speichern und sie für das Routing in der frühen Phase der Paketverarbeitung zu verwenden. Bei der Durchführung von NAT müssen zusätzlich die Informationen über die Adress- und Portänderungen, die vom Modul nf_conntrack umgewandelt wurden, gespeichert werden. Ja, natürlich funktionieren dabei verschiedene Policer und andere informationsstatistische Regeln in iptables nicht mehr, aber im Rahmen der Aufgabe eines einzelnen stehenden NAT oder zum Beispiel eines Borders ist das nicht so wichtig, da die Dienste auf verschiedene Geräte verteilt sind.
Konfiguration
Um diese Funktion zu nutzen, müssen wir:
- Ein aktuelles Kerneldatum verwenden. Obwohl die Funktionalität bereits in Kernel 4.16 eingeführt wurde, war sie lange Zeit sehr «instabil» und führte regelmäßig zu Kernel-Panics. Stabilisiert hat sich alles etwa im Dezember 2019, als die LTS-Kernel 4.19.90 und 5.4.5 erschienen.
- Die iptables-Regeln im nftables-Format umschreiben, wobei eine ausreichend aktuelle Version von nftables verwendet wird. Funktioniert genau in Version 0.9.0.
Wenn der erste Punkt grundsätzlich klar ist, das Wichtigste ist, das Modul in die Konfiguration beim Kompilieren aufzunehmen (CONFIG_NFT_FLOW_OFFLOAD=m), erfordert der zweite Punkt Erklärungen. Die nftables-Regeln werden ganz anders beschrieben als die von iptables. deckt praktisch alle Aspekte ab, es gibt auch spezielle von Regeln aus iptables in nftables. Daher werde ich nur ein Beispiel für die Einrichtung von NAT und Flow Offload geben. Eine kurze Legende für das Beispiel: , — das sind die Netzwerk-Interfaces, über die der Verkehr läuft; tatsächlich kann es mehr als zwei geben. , — die Start- und Endadresse des Bereichs der „weißen“ Adressen.
Die NAT-Konfiguration ist sehr einfach:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Mit Flow Offload ist es etwas komplizierter, aber durchaus nachvollziehbar:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Das ist eigentlich die gesamte Konfiguration. Jetzt wird der gesamte TCP/UDP-Verkehr in die Tabelle fastnat gelangen und viel schneller verarbeitet.
Ergebnisse
Um klarzumachen, wie viel schneller dies wirklich ist, werde ich einen Screenshot der Last auf zwei realen Servern beifügen, die die gleiche Ausrüstung (Xeon E5-1650v2), eine identische Konfiguration und denselben Linux-Kernel verwenden, aber NAT in iptables (NAT4) und in nftables (NAT5) ausführen.
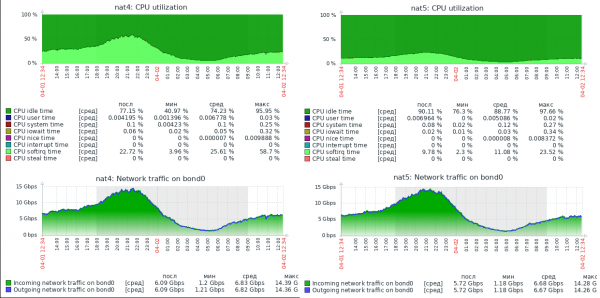
Im Screenshot gibt es kein Diagramm der Pakete pro Sekunde, aber im Lastprofil dieser Server liegt die durchschnittliche Paketgröße bei etwa 800 Byte, weshalb die Werte bis zu 1,5Mpps erreichen. Wie zu sehen ist, hat der Server mit nftables eine enorme Leistungsreserven. Derzeit verarbeitet dieser Server bis zu 30Gbit/s bei 3Mpps und kann offenbar das physische Limit des Netzwerks von 40Gbps erreichen, während er freie CPU-Ressourcen hat.
Ich hoffe, dieses Material wird Netzwerkingenieuren nützlich sein, die versuchen, die Leistung ihrer Server zu verbessern.
Quelle: habr.com
