

Hallo zusammen! Wir haben tolle Neuigkeiten, im Juni startet OTUS wieder einen Kurs , weshalb wir traditionell nützliche Materialien mit Ihnen teilen.
Wenn Sie mit dieser gesamten Geschichte der Mikrodienste ohne jeglichen Kontext konfrontiert wurden, kann man verstehen, dass Sie sie etwas seltsam finden. Die Zerlegung einer Anwendung in Fragmente, die durch ein Netzwerk verbunden sind, bedeutet unweigerlich die Einführung komplexer Ausfallsicherheitsmodi in das entstandene verteilte System.
Obwohl dieser Ansatz die Zerlegung in zahlreiche unabhängige Dienste umfasst, ist das endgültige Ziel viel größer, als nur die Funktion dieser Dienste auf verschiedenen Maschinen. Es geht vielmehr um die Interaktion mit der umliegenden Welt, die ihrer Natur nach ebenfalls verteilt ist. Nicht im technischen Sinne, sondern vielmehr im Sinne eines Ökosystems, das aus vielen Menschen, Teams und Programmen besteht, wobei jedes dieser Teile auf die eine oder andere Weise seine Arbeit erledigen muss.
Unternehmen stellen beispielsweise eine Reihe verteilter Systeme dar, die zusammen zur Erreichung eines bestimmten Ziels beitragen. Wir haben diese Tatsache jahrzehntelang ignoriert, indem wir versucht haben, zu integrieren, Dateien über FTP auszutauschen oder Unternehmensintegrationswerkzeuge zu verwenden, während wir uns auf unsere persönlichen isolierten Ziele konzentriert haben. Aber mit dem Aufkommen von Diensten hat sich alles verändert. Dienste haben uns geholfen, über den Tellerrand hinauszuschauen und die Welt der wechselseitigen Abhängigkeiten von Programmen zu sehen, die zusammenarbeiten. Um jedoch erfolgreich zu arbeiten, ist es notwendig, zwei grundlegend unterschiedliche Welten zu erkennen und zu gestalten: die Außenwelt, in der wir in einem Ökosystem vieler anderer Dienste leben, und unsere persönliche, innere Welt, in der wir allein herrschen.
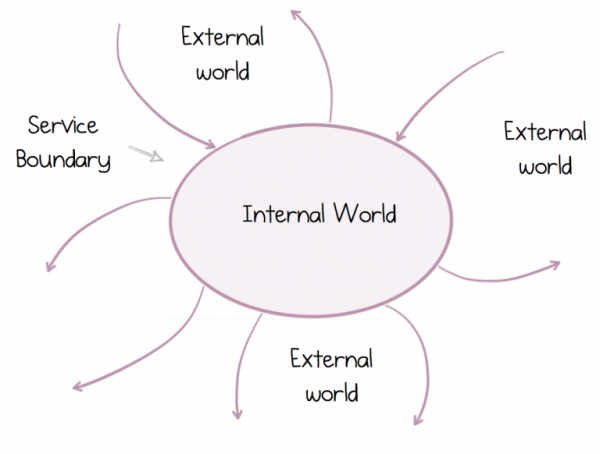
Eine solche verteilte Welt unterscheidet sich von der, in der wir aufgewachsen sind und an die wir gewöhnt sind. Die Prinzipien des traditionellen monolithischen Architekturmodells halten keiner Kritik stand. Deshalb ist ein richtiges Verständnis solcher Systeme mehr als nur die Erstellung eines coolen Diagramms auf einem weißen Flipchart oder eines beeindruckenden Proof of Concept. Es geht darum, dass ein solches System über lange Zeit erfolgreich funktioniert. Glücklicherweise gibt es Dienste schon seit geraumer Zeit, obwohl sie unterschiedlich aussehen. sind immer noch relevant, selbst wenn sie mit Docker, Kubernetes gewürzt und leicht von hipsterischen Bärten zerzaust sind.
Heute schauen wir uns an, wie sich die Regeln geändert haben, warum wir unsere Herangehensweise an die Dienste und die Daten, die sie austauschen, überdenken müssen und warum wir dafür vollkommen andere Werkzeuge benötigen.
Kapselung wird nicht immer Ihr Freund sein.
Mikroservices können unabhängig voneinander arbeiten. Gerade diese Eigenschaft verleiht ihnen den größten Wert. Diese Eigenschaft ermöglicht es den Diensten auch, zu skalieren und zu wachsen. Nicht nur im Sinne der Skalierung auf Quadrillionen von Nutzern oder Petabyte an Daten (obwohl sie auch hierbei helfen können), sondern im Hinblick auf das Wachstum von Teams und Organisationen.
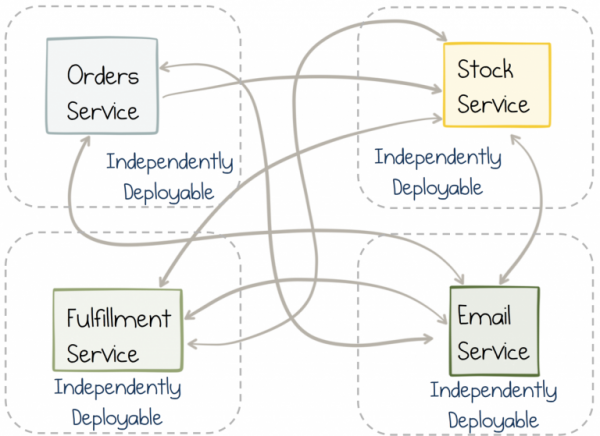
Die Unabhängigkeit ist jedoch ein zweischneidiges Schwert. Ein Dienst kann für sich genommen leicht und mühelos laufen. Wenn jedoch innerhalb eines Dienstes eine Funktion implementiert wird, die einen anderen Dienst erfordert, müssen wir letztendlich nahezu gleichzeitig Änderungen in beiden Diensten vornehmen. In einem Monolithen ist das einfach, man nimmt einfach die Änderung vor und sendet sie in die Veröffentlichung, aber bei der Synchronisierung unabhängiger Dienste gibt es mehr Probleme. Die Koordination zwischen den Teams und den Veröffentlichungszyklen zerstört die Flexibilität.
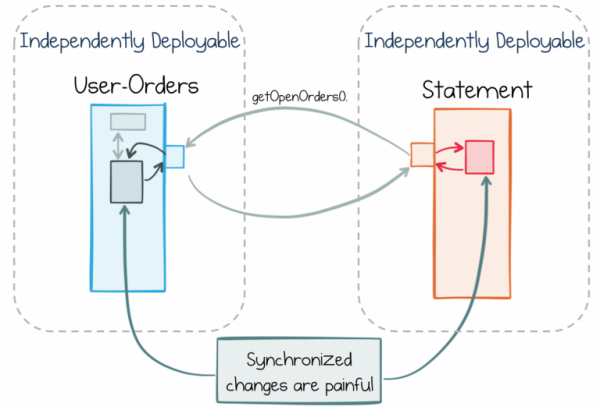
Im Rahmen des Standardansatzes versucht man, ärgerliche Durchgriffsänderungen zu vermeiden, indem die Funktionalität klar zwischen den Diensten aufgeteilt wird. Ein Dienst als Eingangspunkt zum System kann hier ein gutes Beispiel sein. Er hat eine klar definierte Rolle, die ihn von anderen Diensten unterscheidet. Diese klare Trennung bedeutet, dass der Eingangspunkt in einer Welt, die sich schnell ändernden Anforderungen an die ihn umgebenden Dienste stellt, wahrscheinlich nicht verändert wird. Er exists in einem streng begrenzten Kontext.
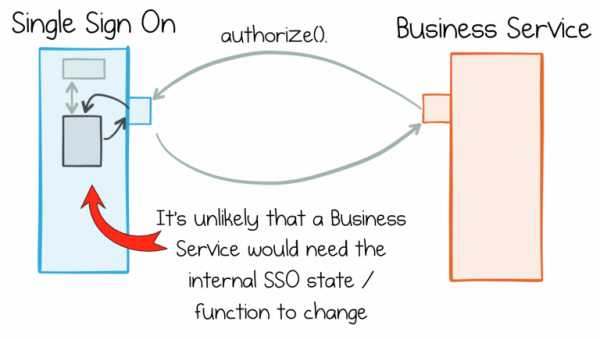
Das Problem besteht darin, dass in der realen Welt Geschäftsdienste nicht ständig eine gleichmäßige Trennung der Rollen aufrechterhalten können. Zum Beispiel arbeiten dieselben Geschäftsdienste in größerem Maße mit Daten, die von anderen ähnlichen Diensten stammen. Wenn Sie im Online-Handel tätig sind, wird die Verarbeitung des Bestellflusses, des Produktkatalogs oder von Benutzerinformationen zu einer Anforderung für viele Ihrer Dienste. Jeder dieser Dienste benötigt Zugang zu diesen Daten, um zu funktionieren.
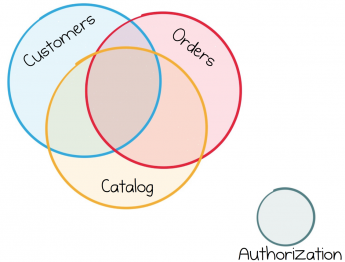
Die meisten Geschäftsdienste nutzen denselben Datenfluss, weshalb ihre Arbeit untrennbar miteinander verwoben ist.
So sind wir zu einem wichtigen Punkt gekommen, über den es sich zu sprechen lohnt. Während Dienste gut für Infrastrukturkomponenten funktionieren, die weitgehend isoliert arbeiten, sind die meisten Geschäftsdienste wesentlich enger miteinander verbunden.
Daten-Dichotomie
Service-orientierte Ansätze existieren möglicherweise bereits, allerdings gibt es noch wenig Informationen darüber, wie man große Datenmengen zwischen Diensten austauschen kann.
Das Hauptproblem besteht darin, dass Daten und Dienste untrennbar miteinander verbunden sind. Einerseits fordert die Kapselung uns auf, Daten zu verbergen, sodass Dienste voneinander getrennt werden können, was ihr Wachstum und ihre zukünftigen Änderungen erleichtert. Andererseits müssen wir die Möglichkeit haben, gemeinsame Daten genauso frei zu teilen und zu verwalten wie jede andere Art von Daten. Es geht darum, die Fähigkeit zu haben, sofort und genauso frei wie in jedem anderen Informationssystem zu arbeiten.
Allerdings haben Informationssysteme wenig mit Kapselung zu tun. Tatsächlich ist es eher umgekehrt. Datenbanken tun alles, was sie können, um den Zugriff auf die darin gespeicherten Daten zu ermöglichen. Sie kommen mit einer leistungsstarken deklarativen Schnittstelle, die es ermöglicht, die Daten nach Bedarf zu verändern. Eine solche Funktionalität ist in der Phase der Voruntersuchungen wichtig, aber nicht für das Management der wachsenden Komplexität eines sich ständig weiterentwickelnden Dienstes.
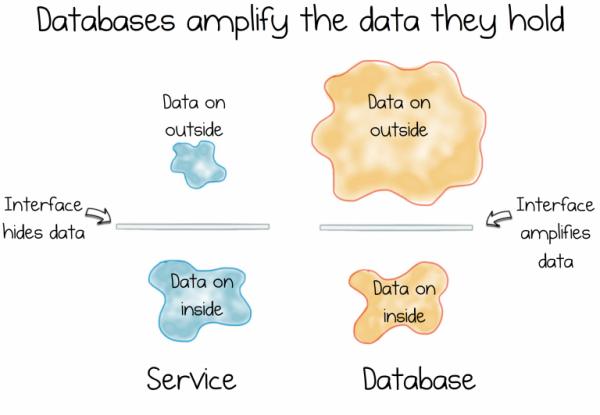
Hier entsteht ein Dilemma. Ein Widerspruch. Eine Dichotomie. Denn Informationssysteme dreht sich um die Bereitstellung von Daten, während Dienste sich mit deren Verbergen befassen.
Diese beiden Kräfte sind fundamental. Sie bilden die Grundlage für den Großteil unserer Arbeit und kämpfen ständig um die Vorherrschaft in den Systemen, die wir erschaffen.
Mit dem Wachstum und den Entwicklungen von Servicessystemen sehen wir verschiedene Erscheinungsformen der Auswirkungen der Datendichotomie. Entweder wächst die Dienstschnittstelle und bietet immer umfangreichere Funktionen und beginnt, wie eine sehr seltsame, hausgemachte Datenbank auszusehen, oder wir erleben Frustration, und wir implementieren irgendeine Möglichkeit, große Datensätze massenhaft aus einem Dienst in einen anderen zu extrahieren oder zu übertragen.
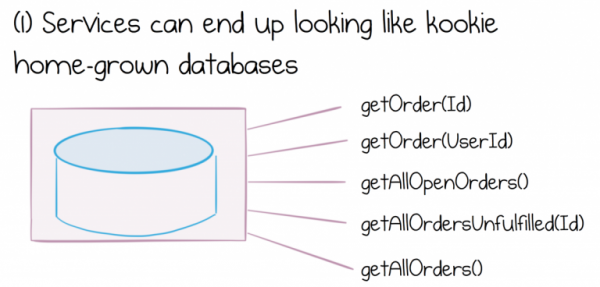
Die Schaffung von etwas, das wie eine seltsame hausgemachte Datenbank aussieht, führt wiederum zu einer ganzen Reihe von Problemen. Wir werden nicht auf die Einzelheiten eingehen, warum shared databasebedeutende kostspielige Ingenieurs- und Betriebs für ein Unternehmen darstellt, das versucht, sie zu nutzen.
Schlimmer ist, dass die Datenmengen die Probleme mit den Grenzen der Dienste verstärken. Je mehr gemeinsame Daten innerhalb eines Dienstes liegen, desto komplizierter wird die Schnittstelle und desto schwieriger wird es, Datensätze aus verschiedenen Diensten zu kombinieren.
Ein alternativer Ansatz zur Extraktion und Übertragung ganzer Datensätze hat ebenfalls seine Probleme. Der häufigste Ansatz zu diesem Thema besteht darin, einen Datensatz komplett zu extrahieren und dann lokal in jedem Verbraucherdienst zu speichern.
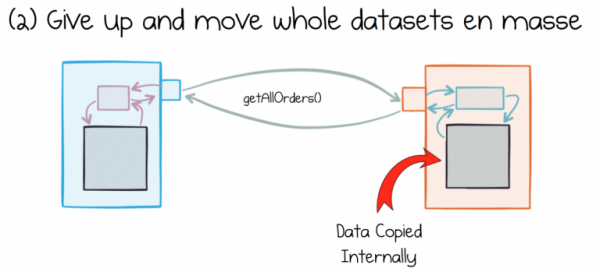
Das Problem ist, dass verschiedene Dienste die Daten, die sie konsumieren, unterschiedlich interpretieren. Diese Daten sind immer zur Hand. Sie werden lokal geändert und verarbeitet. Sehr schnell haben sie nichts mehr mit den Daten aus der Quelle gemeinsam.
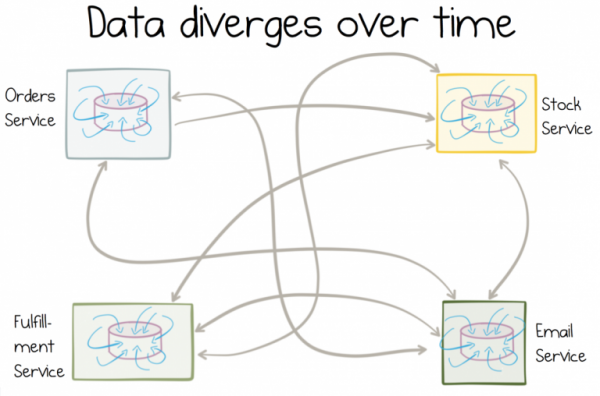
Je mutierbarer die Kopien sind, desto mehr werden die Daten mit der Zeit abweichen.
Was noch schlimmer ist, solche Daten sind retrospektiv schwer zu korrigieren ( da könnte wirklich Hilfe kommen). Tatsächlich entstehen einige der schwer zu lösenden technologischen Probleme, mit denen Unternehmen konfrontiert sind, durch heterogene Daten, die sich von Anwendung zu Anwendung vervielfältigen.
Um eine Lösung für das Problem gemeinsamer Daten zu finden, muss man anders denken. Sie sollten in den Architekturen, die wir bauen, zu erstklassigen Objekten werden. bezeichnet solche Daten als "extern", und das ist eine sehr wichtige Eigenschaft. Wir benötigen eine Kapselung, um die interne Struktur des Dienstes nicht offenzulegen, aber wir müssen den Diensten den Zugang zu gemeinsam genutzten Daten erleichtern, damit sie ihre Arbeit ordnungsgemäß erledigen können.
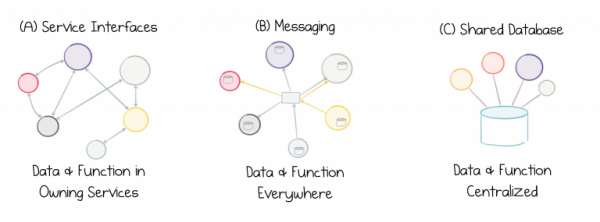
Das Problem ist, dass heute kein Ansatz mehr relevant ist, da weder die Schnittstellen des Dienstes, noch der Nachrichtenaustausch, noch die Shared Database eine gute Lösung für den Umgang mit externen Daten bieten. Die Schnittstellen des Dienstes eignen sich schlecht für den Austausch von Daten in beliebigem Umfang. Der Nachrichtenaustausch bewegt Daten, speichert aber deren Geschichte nicht, weshalb die Daten im Laufe der Zeit beschädigt werden. Shared Databases sind zu stark auf einen Punkt fokussiert, was die Entwicklung des Fortschritts hemmt. Wir stecken zwangsläufig in einem Teufelskreis von Dateninkonsistenz fest:
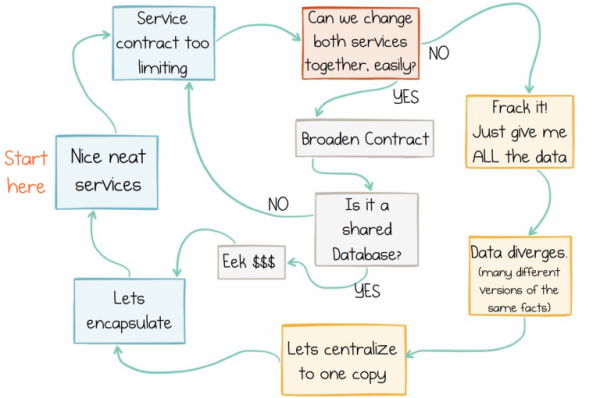
Der Teufelskreis der Dateninkonsistenz
Ströme: ein dezentraler Ansatz für Daten und Dienste
Idealerweise sollten wir unseren Ansatz ändern, wie Dienste mit gemeinsamen Daten arbeiten. Momentan sieht sich jeder Ansatz der oben erwähnten Dichotomie gegenüber, da es kein magisches Pulver gibt, mit dem man es großzügig bestäuben und zum Verschwinden bringen könnte. Wir können jedoch das Problem neu überdenken und zu einem Kompromiss kommen.
Dieser Kompromiss setzt ein gewisses Maß an Zentralisierung voraus. Wir können den Mechanismus verteilter Protokolle nutzen, da er zuverlässige, skalierbare Ströme bietet. Jetzt müssen die Dienste in der Lage sein, sich diesen gemeinsamen Strömen anzuschließen und damit zu arbeiten, jedoch möchten wir komplizierte zentralisierte God Services vermeiden, die solche Verarbeitungen durchführen. Deshalb ist die beste Option, die Stream-Verarbeitung in jeden Verbraucher-Dienst zu integrieren. So können die Dienste Datensätze aus verschiedenen Quellen zusammenführen und damit arbeiten, wie sie es benötigen.
Ein Weg, um einen solchen Ansatz zu erreichen, ist die Nutzung einer Streaming-Plattform. Es gibt viele Optionen, aber heute werden wir uns speziell mit Kafka befassen, da die Nutzung ihrer Stateful Stream Processing es ermöglicht, das dargestellte Problem effektiv zu lösen.
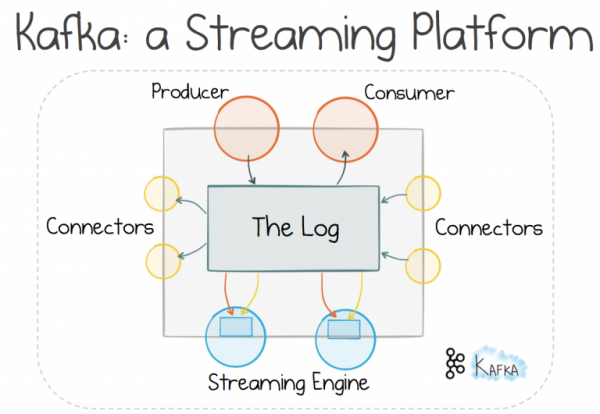
Die Nutzung des Mechanismus des verteilten Loggens erlaubt es uns, den bereits eingeschlagenen Weg zu gehen und den Nachrichtenaustausch zu nutzen, um damit zu arbeiten. . Es wird angenommen, dass dieser Ansatz eine bessere Skalierbarkeit und Trennung bietet als das „Request-Response“-Mechanismus, da er den Datenfluss an den Empfänger und nicht an den Sender übergibt. Allerdings muss man für alles im Leben bezahlen, und hier benötigen Sie einen Broker. Für große Systeme ist dieser Kompromiss jedoch von Bedeutung (was man nicht von Ihren durchschnittlichen Webanwendungen sagen kann).
Wenn der Broker für das verteilte Logging verantwortlich ist und nicht das traditionelle Nachrichtensystem, können zusätzliche Funktionen genutzt werden. Der Transport kann nahezu ebenso linear skalierbar sein wie ein verteiltes Dateisystem. Die Daten können lange genug in Logs gespeichert werden, sodass wir nicht nur Nachrichten, sondern auch ein Informationsspeicher erhalten. Ein skalierbarer Speicher, ohne die Befürchtung, einen veränderlichen gemeinsamen Zustand zu bekommen.
Dann kann der Mechanismus der zustandsbehafteten Streamverarbeitung (Stateful Stream Processing) verwendet werden, um deklarative Datenbankwerkzeuge in den konsumierenden Diensten hinzuzufügen. Das ist ein sehr wichtiger Gedanke. Solange die Daten in gemeinsamen Streams aufbewahrt werden, auf die alle Dienste zugreifen können, bleiben die Kombination und die Verarbeitung, die der Dienst vornimmt, privat. Sie sind innerhalb eines streng abgegrenzten Kontexts isoliert.
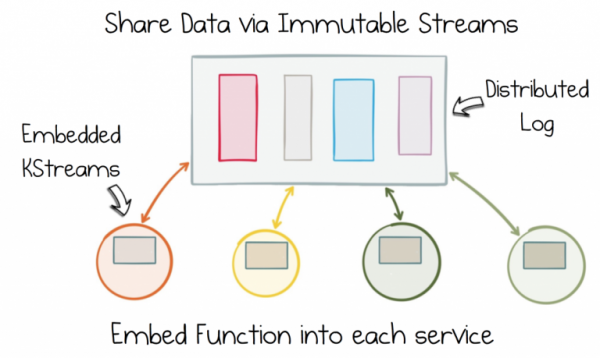
Befreien Sie sich von der Dichotomie der Daten, indem Sie den unveränderlichen Zustandspool trennen. Fügen Sie diese Funktion dann jedem Dienst mithilfe von Stateful Stream Processing hinzu.
Somit hat Ihr Dienst vollen Zugriff, wenn er mit Bestellungen, Produktkatalogen und Lagerbeständen arbeiten muss: Nur Sie entscheiden, welche Daten zusammengefügt werden, wo sie verarbeitet werden und wie sie sich im Laufe der Zeit ändern sollen. Obwohl die Daten gemeinsam sind, erfolgt die Arbeit mit ihnen vollständig dezentralisiert. Sie geschieht innerhalb jedes Dienstes in einer Welt, in der alles nach Ihren Regeln geht.
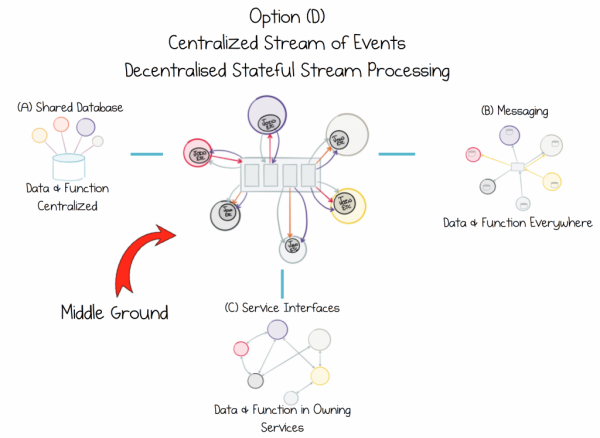
Teilen Sie Daten so, dass ihre Integrität gewahrt bleibt. Kapseln Sie die Funktion und nicht die Quelle in jedem Dienst, der sie benötigt.
Es kommt vor, dass Daten massenhaft verschoben werden müssen. Manchmal benötigt der Service einen lokalen historischen Datensatz in der gewählten Datenbank-Engine. Der Fokus liegt darauf, dass garantiert werden kann, dass bei Bedarf eine Kopie aus der Quelle mithilfe des verteilten Logging-Mechanismus wiederhergestellt werden kann. Die Connectoren in Kafka meistern diese Aufgabe hervorragend.
Der heute betrachtete Ansatz hat mehrere Vorteile:
- Die Daten werden in Form von gemeinsamen Streams verwendet, die lange in Logs gespeichert werden können, und der Mechanismus für den Umgang mit gemeinsam genutzten Daten ist in jedem einzelnen Kontext integriert, was es den Diensten ermöglicht, einfach und schnell zu arbeiten. So kann die Dichotomie von Daten ausgeglichen werden.
- Die Daten, die aus verschiedenen Diensten stammen, können problemlos zu Sets zusammengefügt werden. Dadurch wird die Interaktion mit gemeinsam genutzten Daten vereinfacht und die Notwendigkeit für die Unterstützung lokaler Datensätze in der Datenbank entfällt.
- Stateful Stream Processing speichert lediglich die Daten im Cache, während die gemeinsamen Logs die Quelle der Wahrheit bleiben, sodass das Problem der Datenbeschädigung im Laufe der Zeit weniger drängend ist.
- Im Grunde genommen werden die Dienste von Daten gesteuert, das heißt, trotz des ständigen Anstiegs des Datenvolumens können die Dienste weiterhin schnell auf geschäftliche Ereignisse reagieren.
- Die Skalierbarkeitsprobleme liegen beim Broker und nicht bei den Diensten. Dadurch wird die Komplexität bei der Erstellung von Diensten erheblich reduziert, da keine Überlegungen zur Skalierbarkeit angestellt werden müssen.
- Die Hinzufügung neuer Dienste erfordert keine Änderungen an den bestehenden, was den Anschluss neuer Dienste erleichtert.
Wie Sie sehen, ist es mehr als nur REST. Wir haben ein Set von Tools, das es ermöglicht, dezentral mit gemeinsam genutzten Daten zu arbeiten.
In dem heutigen Artikel wurden längst nicht alle Aspekte behandelt. Wir müssen noch klären, wie wir zwischen dem Paradigma „Anfrage-Antwort“ und dem ereignisgesteuerten Paradigma balancieren. Aber das werden wir beim nächsten Mal besprechen. Es gibt Themen, die es besser kennenzulernen gilt, wie zum Beispiel die Vorteile von Stateful Stream Processing. Darüber werden wir im dritten Artikel sprechen. Außerdem gibt es andere mächtige Konstruktionen, die wir nutzen können, wenn wir sie heranziehen, zum Beispiel, Mit ihrer Hilfe ändern sich die Spielregeln für verteilte Geschäftssysteme, da diese Struktur transaktionale Garantien für in skalierbarer Form bietet. Darum wird es im vierten Artikel gehen. Und schließlich müssen wir die Details der Umsetzung dieser Prinzipien durchgehen.
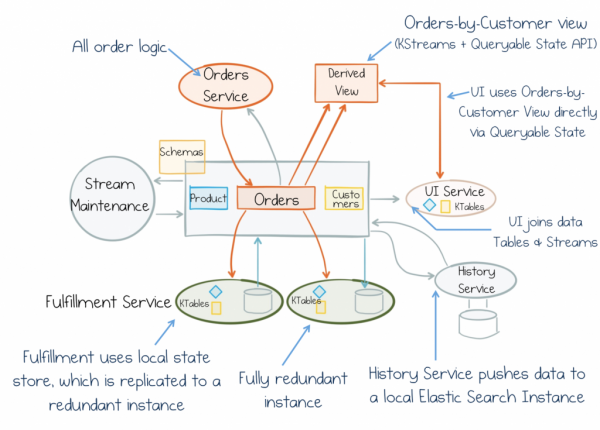
Aber merken Sie sich vorerst Folgendes: Die Dichotomie der Daten ist die Kraft, mit der wir bei der Erstellung von Geschäftsdiensten konfrontiert sind. Und wir müssen dies im Hinterkopf behalten. Der Fokus liegt darauf, alles auf den Kopf zu stellen und gemeinsame Daten als erstklassige Objekte zu betrachten. Stateful Stream Processing bietet dafür einen einzigartigen Kompromiss. Es vermeidet zentralisierte „Gott-Komponenten“, die den Fortschritt hemmen. Darüber hinaus gewährleistet es die Effizienz, Skalierbarkeit und Ausfallsicherheit von Datenstreaming-Pipelines und integriert sie in jeden Dienst. Dadurch können wir uns auf den gemeinsamen Bewusstseinsstrom konzentrieren, an den jeder Dienst anschließen und mit seinen Daten arbeiten kann. So werden die Dienste skalierbarer, austauschbarer und autonomer. Sie werden also nicht nur gut auf Whiteboards und bei Hypothesenüberprüfungen aussehen, sondern auch Jahrzehnte lang funktionieren und sich weiterentwickeln.
Quelle: habr.com
