

Die Suche nach funktionalen Abhängigkeiten in Daten wird in verschiedenen Analysebereichen angewendet: Datenbankmanagement, Datenbereinigung, Reverse Engineering von Datenbanken und Datenexploration. Über die Abhängigkeiten selbst haben wir bereits veröffentlicht Anastasia Birillo und Nikita Bobrov. Diesmal teilt Anastasia – Absolventin des Computer Science Centers dieses Jahres – die Entwicklung ihrer Arbeit im Rahmen der Forschungsarbeit, die sie im Zentrum verteidigt hat.
Aufgabenwahl
Während meines Studiums im CS-Zentrum begann ich, mich intensiv mit Datenbanken zu beschäftigen, insbesondere mit der Suche nach funktionalen und differenziellen Abhängigkeiten. Dieses Thema war mit dem Thema meiner Abschlussarbeit an der Universität verbunden, sodass ich beim Arbeiten an meiner Arbeit begann, Artikel zu verschiedenen Abhängigkeiten in Datenbanken zu lesen. Ich schrieb einen Überblick über dieses Gebiet – eine meiner ersten in englischer Sprache und reichte ihn für die Konferenz SEIM-2017 ein. Ich war sehr froh, als ich erfuhr, dass er angenommen wurde, und beschloss, mich tiefer mit dem Thema zu befassen. Das Konzept selbst ist nicht neu – es wird seit den 90er Jahren angewendet, kommt aber immer noch in vielen Bereichen zur Anwendung.
Im zweiten Semester meines Studiums im Zentrum begann ich ein Forschungsprojekt zur Verbesserung der Algorithmen zur Suche nach funktionalen Abhängigkeiten. Ich arbeitete daran zusammen mit dem Doktoranden Nikita Bobrov von der Universität St. Petersburg basierend auf JetBrains Research.
Berechnungskomplexität der Suche nach funktionalen Abhängigkeiten
Das Hauptproblem ist die Berechnungskomplexität. Die Anzahl der möglichen minimalen und nicht-trivialen Abhängigkeiten ist nach oben durch den Wert begrenzt 
 – die Anzahl der Attribute der Tabelle. Die Laufzeit der Algorithmen hängt nicht nur von der Anzahl der Attribute, sondern auch von der Anzahl der Zeilen ab. In den 90er Jahren konnten Algorithmen zur Suche nach funktionalen Abhängigkeiten auf einem normalen Desktop-PC Datensätze mit bis zu 20 Attributen und Tausenden von Zeilen in mehreren Stunden verarbeiten. Moderne Algorithmen, die auf Mehrkernprozessoren arbeiten, erkennen Abhängigkeiten für Datensätze mit Hunderte von Attributen (bis zu 200) und Hunderttausenden von Zeilen in etwa der gleichen Zeit. Dennoch ist das nicht ausreichend: Diese Zeit ist für die meisten realen Anwendungen inakzeptabel. Daher haben wir Ansätze zur Beschleunigung bestehender Algorithmen entwickelt.
Caching-Modelle für die Partitionierung
Im ersten Teil der Arbeit haben wir Caching-Schemata für die Klasse von Algorithmen entwickelt, die das Methode des Partitionenschnitts verwenden. Eine Partition für ein Attribut besteht aus einer Gruppe von Listen, wobei jede Liste die Zeilennummern mit denselben Werten für dieses Attribut enthält. Jede solche Liste wird als Cluster bezeichnet. Viele moderne Algorithmen verwenden Partitionen, um festzustellen, ob eine Abhängigkeit gehalten wird oder nicht, und halten sich dabei an das Lemma: Abhängigkeit  wird gehalten, wenn
 . Hier wird die Partition bezeichnet und das Konzept der Partitionsgröße - die Anzahl der Cluster darin - verwendet. Algorithmen, die Partitionen verwenden, fügen bei Verletzung der Abhängigkeit zusätzliche Attribute in den linken Teil der Abhängigkeit ein und berechnen sie dann neu, indem sie den Schnitt der Partitionen durchführen. Dieser Vorgang wird in den Artikeln als Spezialisierung bezeichnet. Wir haben jedoch festgestellt, dass Partitionen für Abhängigkeiten, die erst nach mehreren Runden der Spezialisierung gehalten werden, aktiv wiederverwendet werden können, was die Laufzeit der Algorithmen erheblich verkürzen kann, da der Schnitt eine kostenintensive Operation ist.
 Daher haben wir eine Heuristik vorgeschlagen, die auf der Shannon-Entropie und der Ungewissheit von Genie basiert, sowie auf unserer Metrik, die wir als Umgekehrte Entropie bezeichnet haben. Sie ist eine geringfügige Modifikation der Shannon-Entropie und wächst mit zunehmender Einzigartigkeit des Datensatzes. Die vorgeschlagene Heuristik sieht wie folgt aus:
— Der Grad der Einzigartigkeit der kürzlich berechneten Partition

Hier  — Grad der Einzigartigkeit einer kürzlich berechneten Partition
 , und
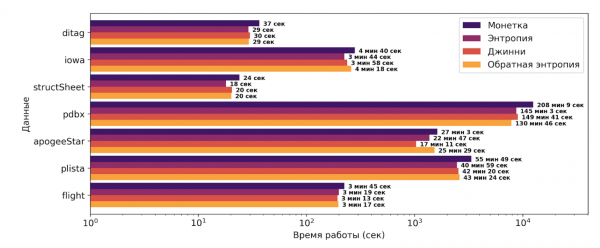
 ist die Median der Einzigartigkeitsstufen für einzelne Attribute. Alle drei oben beschriebenen Metriken wurden als Metrik der Einzigartigkeit getestet. Es fällt auch auf, dass die Heuristik zwei Modifikatoren enthält. Der erste gibt an, wie nahe die aktuelle Partition am Primärschlüssel ist und ermöglicht es in größerem Maße, diejenigen Partitionen zwischenzuspeichern, die weit vom potenziellen Schlüssel entfernt sind. Der zweite Modifikator ermöglicht es, die Cache-Auslastung zu überwachen und fördert damit die Aufnahme einer größeren Anzahl von Partitionen in den Cache, wenn Platz vorhanden ist. Die erfolgreiche Lösung dieses Problems erlaubte eine Beschleunigung des PYRO-Algorithmus um 10-40 Prozent, abhängig von dem Datensatz. Es ist erwähnenswert, dass der PYRO-Algorithmus in diesem Bereich am erfolgreichsten ist.
In der untenstehenden Abbildung sind die Ergebnisse der Anwendung der vorgeschlagenen Heuristik im Vergleich zum grundlegenden Ansatz des Cachings zu sehen, der auf dem Werfen einer Münze basiert. Die X-Achse ist logarithmisch.
Alternativer Ansatz zur Speicherung von Partitionen
Dann haben wir einen alternativen Ansatz zur Speicherung von Partitionen vorgeschlagen. Partitionen stellen eine Menge von Clustern dar, in denen die Nummern von Tuplen mit denselben Werten für bestimmte Attribute gespeichert sind. Diese Cluster können lange Sequenzen von Tuplennummern enthalten, beispielsweise wenn die Daten in der Tabelle sortiert sind. Daher haben wir ein Kompressionsschema für die Speicherung von Partitionen vorgeschlagen, nämlich die intervallbasierte Speicherung von Werten in den Clustern der Partitionen:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Erster~Intervall}, underbrace{7, 8}_{Zweiter~Intervall}, 10}}\ downarrow{Kompression}\ pi(X) = {{underbrace{$, 1, 5}_{Erster~Intervall}, underbrace{7, 8}_{Zweiter~Intervall}, 10}}$$display$$
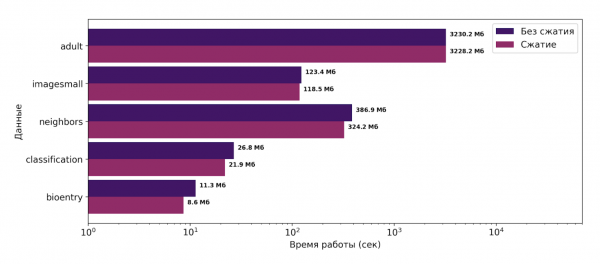
Diese Methode konnte den Speicherverbrauch während der Ausführung des TANE-Algorithmus um 1 bis 25 % reduzieren. Der TANE-Algorithmus ist ein klassischer Algorithmus zur Suche nach funktionalen Abhängigkeiten, der während seiner Ausführung Partitionen verwendet. Innerhalb der Praxis wurde der TANE-Algorithmus ausgewählt, da es wesentlich einfacher war, die intervallbasierte Speicherung zu implementieren als beispielsweise im PYRO, um zu bewerten, ob der vorgeschlagene Ansatz funktioniert. Die erhaltenen Ergebnisse sind in der untenstehenden Abbildung dargestellt. Die X-Achse ist logarithmisch.
Konferenz ADBIS-2019
Im Ergebnis der Studie im September 2019 habe ich einen Artikel präsentiert Auf der 23. Europäischen Konferenz über Fortschritte in Datenbanken und Informationssystemen (ADBIS-2019) bemerkte Bernhard Thalheim, eine bedeutende Persönlichkeit im Bereich der Datenbanken, während seiner Präsentation meine Arbeit. Die Forschungsergebnisse bildeten die Grundlage meiner Masterarbeit im Fachbereich Mathematik und Mechanik an der Universität St. Petersburg, im Rahmen derer beide vorgeschlagenen Ansätze (Caching und Kompression) in die beiden Algorithmen TANE und PYRO integriert wurden. Die Ergebnisse zeigten, dass die vorgeschlagenen Ansätze universell sind, da bei beiden Algorithmen und beiden Ansätzen eine signifikante Reduktion des Speicherverbrauchs sowie eine erhebliche Verkürzung der Laufzeit der Algorithmen beobachtet wurde.
Quelle: habr.com
