

Heute gibt es 100500 Data Science-Kurse, und es ist schon lange bekannt, dass man mit Data Science-Kursen am meisten Geld verdienen kann (warum graben, wenn man Schaufeln verkaufen kann?). Der Hauptnachteil dieser Kurse ist, dass sie nichts mit der tatsächlichen Arbeit zu tun haben: Niemand wird Ihnen saubere, bearbeitete Daten im benötigten Format zur Verfügung stellen. Und wenn Sie von den Kursen kommen und beginnen, ein echtes Problem zu lösen, tauchen viele Nuancen auf.
Deshalb beginnen wir eine Reihe von Notizen mit dem Titel „Was kann im Data Science schiefgehen“, die auf realen Ereignissen basieren, die mir, meinen Kollegen und Freunden passiert sind. Wir werden typische Data Science-Aufgaben an realen Beispielen untersuchen: wie das tatsächlich abläuft. Heute beginnen wir mit der Aufgabe der Datensammlung.
Und das Erste, worüber Menschen stolpern, wenn sie beginnen, mit echten Daten zu arbeiten, ist die Sammlung genau der relevanten Daten. Die zentrale Botschaft dieses Artikels:
Wir unterschätzen systematisch die Zeit, Ressourcen und den Aufwand für die Sammlung, Reinigung und Vorbereitung von Daten.
Und vor allem werden wir besprechen, was zu tun ist, um dies zu vermeiden.
Nach verschiedenen Schätzungen nehmen Reinigung, Transformation, Datenverarbeitung, Feature Engineering usw. 80-90 % der Zeit in Anspruch, während die Analyse nur 10-20 % benötigt, wobei praktisch das gesamte Lehrmaterial sich ausschließlich auf die Analyse konzentriert.
Lassen Sie uns anhand eines einfachen analytischen Beispiels in drei Varianten untersuchen, welche „erschwerenden Umstände“ es geben kann.
Und als Beispiel wiederum betrachten wir ähnliche Variationen der Aufgabe zur Datensammlung und des Vergleichs von Gemeinschaften für:
- Zwei Subreddits von Reddit
- Zwei Abteilungen von Habr
- Zwei Gruppen von Odnoklassniki
Ein bedingter Ansatz in der Theorie
Die Website zu öffnen und die Beispiele durchzulesen, wenn es klar ist, einige Stunden für das Lesen einzuplanen, einige Stunden für den Code nach den Beispielen und die Fehlersuche. Fügen Sie einige Stunden für die Sammlung hinzu. Legen Sie einige Stunden als Puffer drauf (mal zwei multiplizieren und N Stunden hinzuzufügen).
Der Schlüsselpunkt: Die Zeitabschätzung basiert auf Annahmen und Vermutungen darüber, wie lange es dauern wird.
Die Analyse der Zeit muss mit der Bewertung der folgenden Parameter für die oben beschriebene bedingte Aufgabe beginnen:
- Wie groß sind die Daten und wie viel muss physisch gesammelt werden (*siehe unten*).
- Wie viel Zeit benötigt die Sammlung eines Datensatzes und wie lange muss man warten, bevor man den zweiten sammeln kann.
- Das Schreiben von Code einplanen, der den Zustand speichert und einen Neustart beginnt, wenn (und nicht wenn) alles abstürzt.
- Überprüfen, ob wir eine Authentifizierung benötigen, und die Zeit für den Zugriff über die API einplanen.
- Die Anzahl der Fehler als Funktion der Komplexität der Daten einplanen — anhand der konkreten Aufgabe bewerten: Struktur, wie viele Transformationen, was und wie wir extrahieren.
- Netzwerkfehler und Probleme mit dem nicht standardmäßigen Verhalten des Projekts einplanen.
- Bewerten, ob die benötigten Funktionen in der Dokumentation vorhanden sind, und falls nicht, wie viele Resourcen für einen Workaround benötigt werden.
Das Wichtigste für die Zeitbewertung ist, dass Sie tatsächlich Zeit und Mühe für eine "Erkundung" aufwenden müssen — nur dann wird Ihre Planung angemessen sein. Also, egal wie sehr man Sie drängt, zu sagen: "Wie viel Zeit brauchen wir, um Daten zu sammeln" — nehmen Sie sich die Zeit für eine vorläufige Analyse und argumentieren Sie, dass die Zeit je nach den realen Parametern der Aufgabe stark variieren wird.
Und jetzt zeigen wir konkrete Beispiele, bei denen solche Parameter tatsächlich variieren werden.
Der Schlüsselpunkt: Die Schätzung basiert auf der Analyse der wichtigsten Faktoren, die das Volumen und die Komplexität der Arbeit beeinflussen.
Eine schätzungsbasierte Annäherung ist ein guter Ansatz, wenn die funktionalen Elemente relativ klein sind und es nicht allzu viele Faktoren gibt, die die Struktur der Aufgabe erheblich beeinflussen können. Aber in vielen Data-Science-Aufgaben werden solche Faktoren extrem zahlreich, und dieser Ansatz wird unangemessen.
Vergleich von Reddit-Communities
Beginnen wir mit dem einfachsten Fall (wie sich später herausstellen wird). Ganz ehrlich, wir haben es hier mit einem nahezu idealen Fall zu tun, lassen Sie uns unsere Komplexitäts-Checkliste überprüfen:
- Es gibt eine klare, verständliche und dokumentierte API.
- Es ist extrem einfach, und vor allem wird das Token automatisch generiert.
- Ja — mit vielen Beispielen.
- Eine Community, die Datenanalyse und -sammlung auf Reddit betreibt (bis hin zu YouTube-Videos, die erklären, wie man den python wrapper verwendet), .
- Die benötigten Methoden existieren wahrscheinlich in der API. Darüber hinaus sieht der Code kompakt und sauber aus; hier ist ein Beispiel für eine Funktion, die Kommentare zu einem Beitrag sammelt.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Entnommen aus Sammlungen nützlicher Tools zur Verpackung.
Auch wenn wir hier den besten Fall haben, sollten wir dennoch eine Reihe wichtiger Faktoren aus der Realität berücksichtigen:
- API-Limits – wir sind gezwungen, Daten in Batches abzurufen (wir müssen zwischen den Anfragen warten usw.).
- Zeitaufwand für die Erfassung – für eine vollständige Analyse und den Vergleich müssen wir erheblich Zeit einplanen, damit der Spider durch das Subreddit läuft.
- Der Bot muss auf einem Server laufen – Sie können ihn nicht einfach auf Ihrem Laptop starten, in Ihren Rucksack packen und mitnehmen. Daher habe ich alles auf einem VPS gestartet. Mit dem Promo-Code habrahabr10 kann man weitere 10% sparen.
- Physische Unzugänglichkeit bestimmter Daten (die für Administratoren sichtbar sind oder zu kompliziert gesammelt werden) – das muss berücksichtigt werden, nicht alle Daten können innerhalb eines angemessenen Zeitrahmens gesammelt werden.
- Netzwerkfehler: Die Arbeit mit dem Netzwerk ist schmerzhaft.
- Das sind echte, lebendige Daten – sie sind nie sauber.
Natürlich müssen die genannten Nuancen in die Entwicklung eingeplant werden. Die konkreten Stunden/Tage hängen von der Erfahrung in der Entwicklung oder der Arbeit an ähnlichen Aufgaben ab, dennoch sehen wir, dass es sich hier um eine rein ingenieurtechnische Aufgabe handelt, die keine zusätzlichen Bewegungen zur Lösung erfordert – man kann alles sehr gut einschätzen, planen und umsetzen.
Vergleich der Hub-Sektionen
Kommen wir zu einem interessanteren und nicht-triviale Fall, dem Vergleich von Streams und/oder Sektionen des Hubs.
Überprüfen wir unsere Checkliste zur Komplexität – hier muss man, um jeden Punkt zu verstehen, schon ein wenig mit der Aufgabe interagieren und experimentieren.
- Zuerst denkt man, dass es eine API gibt, aber es gibt sie nicht. Ja, ja, Habr hat eine API, aber sie ist nur für Benutzer nicht zugänglich (oder funktioniert vielleicht überhaupt nicht).
- Danach fängt man einfach an, HTML zu parsen – „import requests“, was könnte schon schiefgehen?
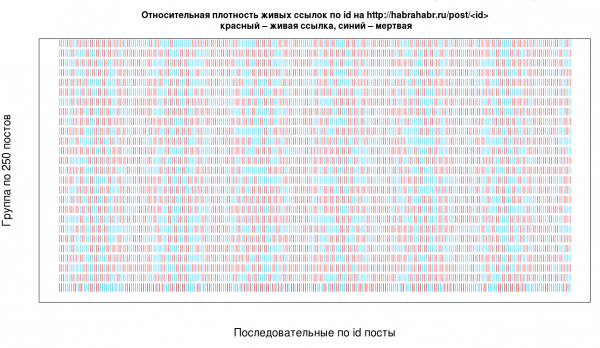
- Und wie parst man überhaupt? Der einfachste und häufig verwendete Ansatz ist, über die ID zu iterieren, wobei zu beachten ist, dass es nicht der effizienteste Weg ist und verschiedene Fälle behandelt werden müssen – hier zum Beispiel die Dichte der echten IDs unter allen existierenden.

Entnommen aus Artikel. - Rohdaten, die in HTML über das Netzwerk gewickelt sind, sind lästig. Zum Beispiel möchten Sie die Bewertung eines Artikels sammeln und speichern: Sie extrahieren den Score aus dem HTML und entscheiden sich, ihn als Zahl für die weitere Verarbeitung zu speichern.
1) int(score) wirft einen Fehler: da auf Habr ein Minuszeichen, wie zum Beispiel in "–5", ein kurzes Gedankenstrich ist und kein Minuszeichen (überraschend, oder?), musste der Parser irgendwann mit einem so schrecklichen Fix wiederbelebt werden.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Es kann sein, dass es keine Daten, Plus- oder Minuszeichen gibt (wie wir oben in der Funktion check_date sehen können, kam das vor).
2) Unescaped Sonderzeichen — sie werden kommen, man muss vorbereitet sein.
3) Die Struktur ändert sich je nach Art des Beitrags.
4) Ältere Beiträge können eine **seltsame Struktur** haben.
- Im Grunde genommen müssen Fehlerbehandlungen und das, was passieren kann oder nicht, behandelt werden. Man kann nicht sicher vorhersagen, was schiefgehen wird und wie die Struktur anders sein könnte und wo etwas ausfällt — man muss es einfach ausprobieren und die Fehler berücksichtigen, die der Parser auswirft.
- Dann verstehen Sie, dass Sie in mehreren Threads parsen müssen, sonst dauert das Parsen in einem einzigen Thread über 30 Stunden (das ist die reine Ausführungszeit eines bereits funktionierenden einheitlichen Parsers, der schläft und nicht unter irgendwelche Sperren fällt). In dem Artikel führte dies irgendwann zu einem solchen Schema:
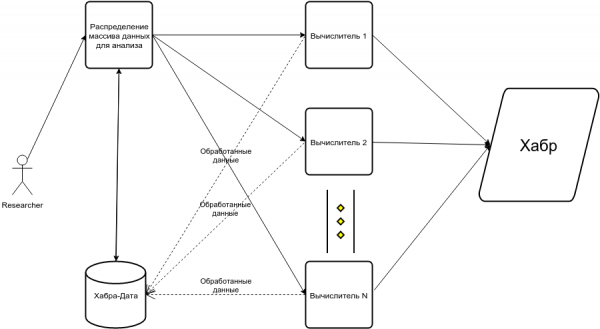
Zusammengefasst die Checkliste nach Schwierigkeit:
- Arbeiten mit dem Netzwerk und Parsen von HTML mit Iteration und Durchlauf nach ID.
- Dokumente mit unterschiedlicher Struktur.
- Es gibt viele Stellen, an denen der Code leicht fehlschlagen kann.
- Es ist notwendig, || Code zu schreiben.
- Die benötigte Dokumentation, Codebeispiele und/oder eine Community fehlen.
Die Schätzung der Zeit für diese Aufgabe wird 3-5 mal höher sein als für das Sammeln von Daten von Reddit.
Vergleich von Gruppen in Odnoklassniki.
Kommen wir zum technisch interessantesten Fall aus den beschriebenen. Für mich war er genau deshalb interessant, weil er auf den ersten Blick ziemlich trivial aussieht, aber das ganz und gar nicht ist — sobald man mit einem Stock darauf zeigt.
Es beginnt mit unserer Schwierigkeit-Checkliste und wir werden feststellen, dass viele von ihnen viel komplizierter sind, als sie zunächst erscheinen:
- Das API existiert, aber es fehlen fast vollständig die benötigten Funktionen.
- Für bestimmte Funktionen muss man per E-Mail um Zugang bitten, also ist die Gewährung des Zugangs nicht sofort.
- Die Dokumentation ist schrecklich (beginnend damit, dass überall russische und englische Begriffe inkonsistent vermischt werden — manchmal muss man einfach raten, was von einem erwartet wird) und mehr noch, sie ist designtechnisch ungeeignet, um Daten zu sammeln, zum Beispiel .
- Erfordert eine Session in der Dokumentation, benutzt sie jedoch in der Praxis nicht — es gibt keine Möglichkeit, alle Feinheiten der API-Modi zu verstehen, außer durch Herumprobieren und Hoffen, dass irgendetwas funktioniert.
- Es fehlen Beispiele und eine Community, der einzige Anhaltspunkt zur Informationssammlung ist ein kleiner in Python (ohne viele Anwendungsbeispiele).
- Die sinnvollste Option scheint Selenium zu sein, da viele benötigte Daten gesperrt sind.
1) Das heißt, es erfolgt eine Authentifizierung über einen fiktiven Benutzer (und manuelle Registrierung).2) Allerdings gibt es mit Selenium keine Garantien für korrekte und wiederholbare Funktionalität (zumindest im Fall von ok.ru genau).
3) Die Seite ok.ru enthält JavaScript-Fehler und verhält sich manchmal seltsam und inkonsistent.
4) Man muss sich mit Pagination, dem Nachladen von Elementen usw. beschäftigen…
5) API-Fehler, die der Wrapper zurückgibt, müssen umständlich bearbeitet werden, zum Beispiel so (ein Stück experimentellen Codes):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Mein Lieblingsfehler war:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) Letztendlich scheint die Kombination aus Selenium + API die rationalste Lösung zu sein.
- Es ist notwendig, den Zustand zu erhalten und das System neu zu starten, viele Fehler zu verarbeiten, einschließlich inkonsistentem Verhalten der Website — dabei handelt es sich um Fehler, die sich nur schwer vorstellen lassen (es sei denn, man programmiert professionell Parser).
Die geschätzte Zeit für diese Aufgabe wird 3-5 mal höher sein als für das Sammeln von Daten von Habr. Obwohl wir beim Habr einen direkten Ansatz mit HTML-Parsen anwenden, können wir bei ok.ru an kritischen Stellen mit der API arbeiten.
Das DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.
Egal, wie sehr Sie von Ihnen eine Einschätzung der Fristen „vor Ort“ verlangen (wir haben schließlich heute Planung!), ist es praktisch nie möglich, die Ausführungszeit auch nur ansatzweise ohne Analyse der Aufgabendetails qualitativ zu bewerten.
Wenn wir etwas philosophischer sprechen, dann passen Bewertungsstrategien im Agile-Bereich gut zu ingenieurtechnischen Aufgaben, aber bei experimentelleren und in gewissem Sinne „kreativen“ und forschenden Aufgaben, also solchen, die weniger vorhersehbar sind, treten Schwierigkeiten auf, wie in den Beispielen, die wir hier behandelt haben.
Natürlich ist das Sammeln von Daten ein anschauliches Beispiel – normalerweise scheint diese Aufgabe unglaublich einfach und technisch unkompliziert zu sein, und genau in den Details versteckt sich hier oft der Teufel. An dieser Aufgabe lässt sich das gesamte Spektrum möglicher Varianten aufzeigen, was schiefgehen könnte und wie sehr die Arbeit sich verzögern kann.
Wenn man die Anforderungen an die Aufgabe oberflächlich betrachtet, ohne zusätzliche Experimente, scheinen Reddit und OK ähnlich zu sein: Es gibt eine API, einen Python-Wrapper, aber im Grunde genommen ist der Unterschied riesig. Nach diesen Kriterien sieht das Parsen von Habr komplizierter aus als OK – in der Praxis ist es jedoch genau umgekehrt, und genau das kann durch einfache Experimente zur Analyse der Aufgabenparameter herausgefunden werden.
Nach meiner Erfahrung ist der effektivste Ansatz eine grobe Schätzung der Zeit, die Sie für die eigentliche Voranalyse, einfache erste Experimente und das Lesen der Dokumentation benötigen – diese ermöglichen es Ihnen, eine genaue Schätzung für die gesamte Arbeit abzugeben. In den Begriffen der beliebten Agile-Methodologie bitte ich darum, ein Ticket für „Bewertung der Aufgabenparameter“ zu erstellen, auf dessen Grundlage ich eine Schätzung abgeben kann, was im Rahmen des „Sprints“ machbar ist, sowie eine genauere Schätzung für jede Aufgabe.
Daher scheint der effektivste Ansatz ein Argument zu sein, das einem „nicht-technischen“ Spezialisten zeigt, wie stark die Zeit und die Ressourcen je nach den Parametern variieren werden, die noch bewertet werden müssen.
Quelle: habr.com
