

Der CAP-Satz ist das Fundament der Theorie verteilte Systeme. Natürlich hält der Streit darüber an: Die Definitionen sind nicht kanonisch und es gibt keinen strengen Beweis… Dennoch, fest in der Position des gesunden Menschenverstands verankert™, verstehen wir intuitiv, dass der Satz wahr ist.
Das Einzige, was nicht offensichtlich ist, ist die Bedeutung des Buchstabens „P“. Wenn sich der Cluster teilt, entscheidet er, ob er nicht antworten soll, bis ein Quorum erreicht ist, oder ob er die Daten bereitstellt, die er hat. Je nach den Ergebnissen dieser Entscheidung wird das System entweder als CP oder als AP klassifiziert. Cassandra kann beispielsweise so oder so agieren, abhängig nicht nur von den Cluster-Einstellungen, sondern auch von den Parametern jeder spezifischen Anfrage. Aber wenn das System nicht „P“ ist und es sich geteilt hat, was passiert dann?
Die Antwort auf diese Frage ist etwas überraschend: Ein CA-Cluster kann sich nicht teilen.
Was ist das für ein Cluster, der sich nicht teilen kann?
Ein unverzichtbares Attribut eines solchen Clusters ist ein gemeinsames Datenspeichersystem. In den meisten Fällen bedeutet dies die Anbindung über SAN, was die Anwendung von CA-Lösungen auf große Unternehmen beschränkt, die in der Lage sind, eine SAN-Infrastruktur zu unterhalten. Damit mehrere Server mit denselben Daten arbeiten können, ist ein clusterfähiges Dateisystem erforderlich. Solche Dateisysteme sind im Portfolio von HPE (CFS), Veritas (VxCFS) und IBM (GPFS) zu finden.
Oracle RAC
Die Option Real Application Cluster trat erstmals 2001 in der Oracle 9i-Version auf. In einem solchen Cluster arbeiten mehrere Instanzen Server mit derselben Datenbank.
Oracle kann sowohl mit einem clusterfähigen Dateisystem als auch mit einer eigenen Lösung – ASM, Automatic Storage Management – arbeiten.
Jede Instanz führt ihr eigenes Protokoll. Eine Transaktion wird von einer Instanz ausgeführt und festgehalten. Im Fall eines Instanzfehlers liest einer der überlebenden Knoten des Clusters (Instanzen) ihr Protokoll und stellt die verlorenen Daten wieder her – dadurch wird die Verfügbarkeit sichergestellt.
Alle Instanzen unterstützen ihren eigenen Cache, und dieselben Seiten (Blöcke) können gleichzeitig im Cache mehrerer Instanzen vorhanden sein. Darüber hinaus, wenn eine Instanz eine Seite benötigt und diese im Cache einer anderen Instanz vorhanden ist, kann sie sie über den Mechanismus des Cache Fusion von ihrem „Nachbarn“ abholen, anstatt sie von der Festplatte zu lesen.
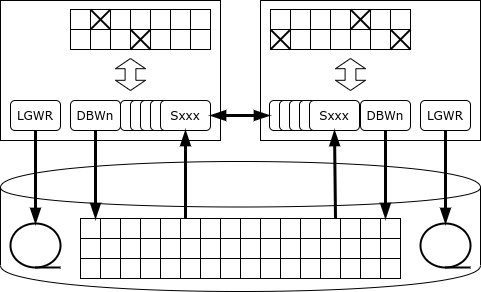
Was passiert jedoch, wenn eine der Instanzen Daten ändern muss?
Das Besondere an Oracle ist, dass es keinen dedizierten Sperrdienst gibt: Wenn der Server eine Zeile sperren möchte, wird der Sperreintrag direkt auf der Speicherseite gesetzt, auf der sich die zu sperrende Zeile befindet. Dank dieses Ansatzes ist Oracle der Leistungschampion unter monolithischen Datenbanken: Der Sperrdienst wird niemals zum Engpass. In einer Cluster-Konfiguration kann diese Architektur jedoch zu intensivem Netzwerkverkehr und gegenseitigen Blockierungen führen.
Sobald ein Eintrag gesperrt wird, benachrichtigt die Instanz alle anderen Instanzen, dass die Seite, die diesen Eintrag enthält, im alleinigen Zugriff ist. Wenn eine andere Instanz einen Eintrag auf derselben Seite ändern möchte, muss sie warten, bis die Änderungen auf der Seite festgeschrieben wurden, d.h. die Änderungsinformationen nicht mehr im Protokoll auf der Festplatte stehen (in der Zwischenzeit kann die Transaktion fortgesetzt werden). Es kann auch vorkommen, dass die Seite nacheinander von mehreren Instanzen geändert wird, und dann muss beim Schreiben der Seite auf die Festplatte geklärt werden, bei wem die aktuelle Version dieser Seite gespeichert ist.
Zufällige Aktualisierungen derselben Seiten über verschiedene RAC-Knoten führen zu einem drastischen Leistungsabfall der Datenbank – bis zu dem Punkt, an dem die Leistung des Clusters schlechter sein kann als die eines einzelnen Exemplars.
Die richtige Nutzung von Oracle RAC besteht in der physischen Aufteilung von Daten (zum Beispiel durch das Mechanismus der partitionierten Tabellen) und dem Zugriff auf jedes Set von Partitionen über einen dedizierten Knoten. Das Hauptziel von RAC besteht nicht in der horizontalen Skalierung, sondern in der Gewährleistung der Fehlertoleranz.
Wenn ein Knoten nicht mehr auf das Heartbeat signalisiert, startet der Knoten, der dies zuerst feststellt, das Verfahren zur Abstimmung auf der Festplatte. Wenn der verlorene Knoten auch hier nicht registriert ist, übernimmt einer der Knoten die Verantwortung für die Datenwiederherstellung:
- „einfrieren“ aller Seiten, die sich im Cache des verlorenen Knotens befanden;
- liest die Protokolle (Redo) des verlorenen Knotens und wendet die darin aufgezeichneten Änderungen erneut an, während gleichzeitig überprüft wird, ob andere Knoten neuere Versionen der zu ändernden Seiten haben.
- Rollback unvollständiger Transaktionen.
Um den Wechsel zwischen Knoten zu erleichtern, gibt es in Oracle das Konzept eines Dienstes – einer virtuellen Instanz. Eine Instanz kann mehrere Dienste bedienen, und ein Dienst kann zwischen Knoten wechseln. Eine Anwendungsinstanz, die einen bestimmten Teil der Datenbank (z. B. eine Kundengruppe) bedient, arbeitet mit einem Dienst, und der Dienst, der für diesen Teil der Datenbank verantwortlich ist, wechselt bei einem Ausfall des Knotens zu einem anderen Knoten.
IBM Pure Data Systems for Transactions
Die Clusterlösung für Datenbanken erschien 2009 im Portfolio des Blauen Riesen. Ideologisch ist sie der Nachfolger des Parallel Sysplex-Clusters, der auf "normaler" Hardware basiert. 2009 wurde das Produkt DB2 pureScale eingeführt, das ein Softwarepaket darstellt, und 2012 bietet IBM ein software-hardware-System (Appliance) mit dem Namen Pure Data Systems for Transactions an. Es ist nicht mit den Pure Data Systems for Analytics zu verwechseln, die lediglich eine umbenannte Netezza-Version sind.
Die Architektur von pureScale ähnelt auf den ersten Blick Oracle RAC: Genau wie mehrere Knoten mit einem gemeinsamen Datenspeichersystem verbunden sind, läuft auf jedem Knoten eine eigene Instanz der Datenbank-Software mit eigenen Arbeitsspeicherbereichen und Transaktionsprotokollen. Aber im Gegensatz zu Oracle gibt es in DB2 einen speziellen Lock-Service, der durch eine Reihe von Prozessen db2LLM* dargestellt wird. In einer Clusterkonfiguration wird dieser Service auf einen separaten Knoten ausgegliedert, der in Parallel Sysplex als Coupling Facility (CF) und in Pure Data als PowerHA bekannt ist.
PowerHA bietet folgende Dienste an:
- Lock-Manager;
- globaler Puffer-Cache;
- Bereich für Interprozesskommunikation.
Für die Datenübertragung von PowerHA zu den DB-Knoten und zurück wird ein Remote Memory Access verwendet, weshalb das Cluster-Interconnect das RDMA-Protokoll unterstützen muss. PureScale kann sowohl Infiniband als auch RDMA über Ethernet verwenden.
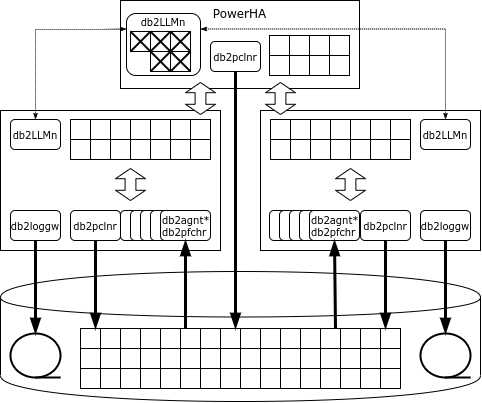
Wenn ein Knoten eine Seite benötigt und diese Seite nicht im Cache vorhanden ist, fordert der Knoten die Seite im globalen Cache an, und nur wenn sie dort ebenfalls nicht vorhanden ist, wird sie von der Festplatte gelesen. Im Gegensatz zu Oracle erfolgt die Anfrage nur an PowerHA und nicht an benachbarte Knoten.
Wenn eine Instanz beabsichtigt, eine Zeile zu ändern, sperrt sie diese im exklusiven Modus und die Seite, auf der sich die Zeile befindet, im geteilten Modus. Alle Sperren werden im globalen Lock-Manager registriert. Wenn die Transaktion abgeschlossen ist, sendet der Knoten eine Nachricht an den Lock-Manager, der die geänderte Seite in den globalen Cache kopiert, die Sperren aufhebt und die geänderte Seite in den Caches anderer Knoten ungültig macht.
Wenn die Seite, auf der sich die änderbare Zeile befindet, bereits gesperrt ist, liest der Lock-Manager die geänderte Seite aus dem Speicher des Knotens, der die Änderungen vorgenommen hat, hebt die Sperre auf, macht die geänderte Seite in den Caches anderer Knoten ungültig und übergibt die Sperre der angeforderten Seite an den Knoten, der sie angefordert hat.
„Dirty“, das heißt geänderte, Seiten können sowohl von einem normalen Knoten als auch von PowerHA (castout) auf die Festplatte geschrieben werden.
Bei einem Ausfall eines der Knoten ist die Wiederherstellung auf die Transaktionen beschränkt, die zum Zeitpunkt des Fehlers noch nicht abgeschlossen waren: Seiten, die von diesem Knoten in abgeschlossenen Transaktionen geändert wurden, befinden sich im globalen Cache auf PowerHA. Der Knoten wird in einer reduzierten Konfiguration auf einem der Cluster-Server neu gestartet, rollt unvollendete Transaktionen zurück und hebt Sperren auf.
PowerHA arbeitet mit zwei Servern, und der Hauptknoten repliziert seinen Zustand synchron. Im Falle eines Ausfalls des Hauptknotens setzt das PowerHA-Cluster die Arbeit mit dem Backup-Knoten fort.
Natürlich wird die Gesamtleistung des Clusters höher sein, wenn auf einen Datensatz über einen Knoten zugegriffen wird. PureScale kann sogar feststellen, dass ein bestimmter Datenbereich von einem Knoten verarbeitet wird, und dann werden alle Sperren, die sich auf diesen Bereich beziehen, lokal vom Knoten ohne Kommunikation mit PowerHA verarbeitet. Sobald die Anwendung jedoch versucht, auf diese Daten über einen anderen Knoten zuzugreifen, wird die zentrale Sperrverarbeitung wieder aufgenommen.
Interne IBM-Tests mit einer Last von 90 % Lesen und 10 % Schreiben, die sehr ähnlich zur realen industriellen Last sind, zeigen fast lineare Skalierung bis zu 128 Knoten. Die Testbedingungen werden leider nicht bekannt gegeben.
HPE NonStop SQL
Die eigene hochverfügbare Plattform ist auch im Portfolio von Hewlett-Packard Enterprise zu finden. Es handelt sich um die NonStop-Plattform, die 1976 von Tandem Computers auf den Markt gebracht wurde. Im Jahr 1997 wurde das Unternehmen von Compaq übernommen, das 2002 wiederum in Hewlett-Packard eingegliedert wurde.
NonStop wird zum Aufbau kritischer Anwendungen verwendet – beispielsweise HLR oder die Verarbeitung von Kreditkarten. Die Plattform wird als Software-Hardware-Komplex (Appliance) geliefert, der Recheneinheiten, ein Speichersystem und Kommunikationsausrüstung umfasst. Das ServerNet-Netzwerk (in modernen Systemen – Infiniband) dient sowohl dem Austausch zwischen den Knoten als auch dem Zugriff auf das Speichersystem.
In den frühen Versionen des Systems wurden proprietäre Prozessoren verwendet, die miteinander synchronisiert waren: Alle Operationen wurden synchron von mehreren Prozessoren ausgeführt, und sobald ein Prozessor einen Fehler hatte, schaltete er sich aus, während der andere weiterarbeitete. Später wechselte das System zu Standardprozessoren (zuerst MIPS, dann Itanium und schließlich x86), während andere Mechanismen zur Synchronisation verwendet wurden:
- Nachrichten: Jeder Systemprozess hat einen Duplikaten-„Schatten“, an den der aktive Prozess periodisch Nachrichten über seinen Zustand sendet; bei einem Fehler des Hauptprozesses übernimmt der Schattenprozess die Arbeit ab dem Zeitpunkt, der in der letzten Nachricht festgelegt wurde;
- Abstimmung: Das Speichersystem verfügt über ein spezielles Hardware-Komponente, die mehrere identische Anfragen entgegennimmt und sie nur ausführt, wenn die Anfragen übereinstimmen; anstelle einer physischen Synchronisation arbeiten die Prozessoren asynchron, und die Ergebnisse ihrer Arbeit werden nur zu den Zeitpunkten des Ein- / Ausgabes verglichen.
Seit 1987 läuft auf der NonStop-Plattform ein relationales DBMS – zunächst SQL/MP, später SQL/MX.
Die gesamte Datenbank wird in Teile untergliedert, wobei jeder Teil von einem eigenen Prozess namens Data Access Manager (DAM) verwaltet wird. Dieser stellt die Datenspeicherung, das Caching und einen Mechanismus zur Sperrung bereit. Die Datenverarbeitung erfolgt durch die Executor Server Processes, die auf denselben Knoten wie die entsprechenden Datenmanager arbeiten. Der SQL/MX-Planer teilt die Aufgaben den Executor-Prozessen zu und vereint die Ergebnisse. Für die Durchführung einvernehmlicher Änderungen wird ein Protokoll der zweiphasigen Bestätigung verwendet, das von der TMF-Bibliothek (Transaction Management Facility) bereitgestellt wird.
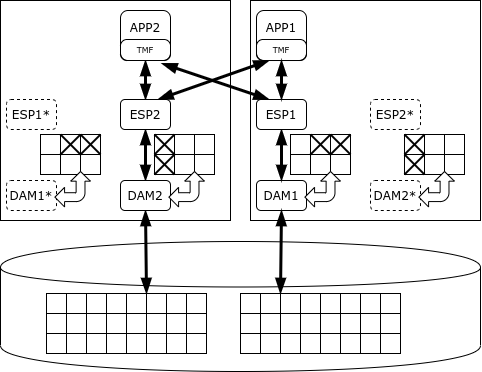
NonStop SQL kann die Prozesse priorisieren, sodass lange analytische Abfragen die Ausführung von Transaktionen nicht beeinträchtigen. Ihr Hauptzweck ist jedoch die Verarbeitung kurzer Transaktionen und nicht die Analytik. Der Entwickler garantiert eine Verfügbarkeit des NonStop-Clusters auf dem Niveau von fünf „Neun“, was bedeutet, dass die Ausfallzeit nur fünf Minuten pro Jahr beträgt.
SAP HANA
Die erste stabile Version des Datenbanksystems HANA (1.0) wurde im November 2010 veröffentlicht, und das Paket SAP ERP wechselte im Mai 2013 zu HANA. Die Plattform basiert auf erworbenen Technologien: TREX-Suchmaschine (Suche im Spaltenlager), Datenbank P*TIME und MAX DB.
Das Wort „HANA“ ist ein Akronym für High performance ANalytical Appliance. Diese Datenbank wird in Form von Code bereitgestellt, der auf jeder x86-Serverhardware betrieben werden kann, jedoch sind industrielle Installationen nur auf zertifiziertem Equipment zulässig. Es gibt Lösungen von HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi und NEC. Einige Konfigurationen von Lenovo erlauben sogar den Betrieb ohne SAN – der GPFS-Cluster auf lokalen Festplatten fungiert als gemeinsame Speichereinheit.
Im Gegensatz zu den oben genannten Plattformen ist HANA eine In-Memory-Datenbank, d. h. das primäre Datenbild wird im Arbeitsspeicher gespeichert, während auf der Festplatte nur Protokolle und periodische Sicherungen für die Wiederherstellung im Falle eines Ausfalls gespeichert werden.
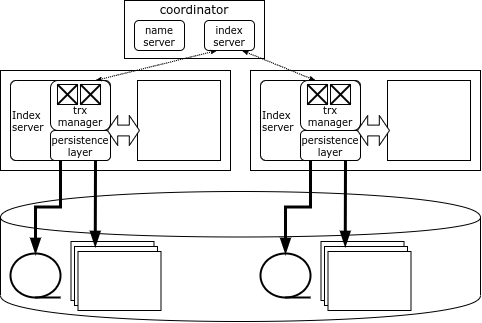
Jeder Knoten im HANA-Cluster ist für seinen Datenanteil verantwortlich, und die Datenkarte wird in einem speziellen Komponenten – dem Name Server – gespeichert, der auf dem Koordinatorknoten angesiedelt ist. Daten werden nicht zwischen den Knoten dupliziert. Informationen über Sperren werden ebenfalls auf jedem Knoten gespeichert, aber es gibt auch einen globalen Deadlock-Detektor im System.
Der HANA-Client lädt beim Verbinden mit dem Cluster dessen Topologie und kann anschließend direkt auf jeden Knoten zugreifen, je nachdem, welche Daten benötigt werden. Wenn eine Transaktion nur Daten eines einzelnen Knotens betrifft, kann sie lokal von diesem Knoten ausgeführt werden. Bei Änderungen an den Daten mehrerer Knoten wendet sich der initiierende Knoten an den Koordinator-Knoten, der die verteilte Transaktion öffnet und koordiniert und sie mit einem optimierten Protokoll zur zweiphasigen Bestätigung abschließt.
Der Koordinator-Knoten ist redundant, sodass im Falle eines Ausfalls des Koordinators sofort der Backup-Knoten übernimmt. Wenn jedoch ein Knoten mit Daten ausfällt, besteht der einzige Weg, auf seine Daten zuzugreifen – den Knoten neu zu starten. In der Regel wird in HANA-Clustern ein Reserve-Server (spare) gehalten, um den verlorenen Knoten so schnell wie möglich neu zu starten.
Quelle: habr.com
