

In SQL, you describe "what" you want to obtain, not "how" it should be executed. Thus, the problem of developing SQL queries in a "write as you hear it" style holds a worthy place, alongside .
Today, through extremely simple examples, we will look at where that can lead in the context of using GROUP/DISTINCT und LIMIT alongside them.
If you wrote in the query "first join these tables, and then remove all duplicates, only one instance per key should remain" — that’s exactly how it will work, even if the join wasn’t necessary at all.
And sometimes it just works, sometimes it negatively affects performance, and sometimes it produces completely unexpected results from the developer's point of view.
Well, maybe not as spectacular, but…
"Sweet couple": JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
It’s clear that they wanted to select such records X for which there are related records in Y that meet the executing condition.They wrote a query through JOIN — and got some pk values multiple times (exactly as many as suitable records were in Y). How to eliminate this? Of course, DISTINCT!
It’s especially "delightful" when for each X record hundreds of related Y records are found, and then duplicates are heroically removed…
How to fix this? First, realize that the task can be modified to "select those records X for which there is AT LEAST ONE related record in Y that meets the executing condition" — since we don’t need anything from the Y record itself.
Nested EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Some versions of PostgreSQL understand that it's enough to find the first matching record for EXISTS; older versions do not. Therefore, I prefer to always specify LIMIT 1 innerhalb EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
This option allows you to also immediately return some data from the found related Y record if necessary. A similar option is discussed in the article .
"Why Pay More": DISTINCT [ON] + LIMIT 1
Ein weiterer Vorteil solcher Anfrageumwandlungen ist die Möglichkeit, die Ergebnismenge leicht einzuschränken, falls nur eine oder mehrere davon benötigt werden, wie im folgenden Fall:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Jetzt lesen wir die Abfrage und versuchen zu verstehen, was die Datenbankmanagementsystem (DBMS) machen soll:
- wir verbinden die Tabellen
- wir machen sie eindeutig nach X.pk
- aus den verbleibenden Datensätzen wählen wir irgendeinen aus
Was haben wir also? „Irgendeinen Datensatz“ aus den eindeutigen – und wenn wir diesen einen aus den nicht eindeutigen nehmen, ändert sich das Ergebnis dann nicht irgendetwas?.. „Und wenn es keinen Unterschied gibt, warum mehr bezahlen?“
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- hier können passende Bedingungen eingefügt werden
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Und das gleiche Thema mit GROUP BY + LIMIT 1.
„Ich muss nur fragen“: implizite GROUP + LIMIT
Solche Dinge begegnen bei verschiedenen Überprüfungen auf Nichtigkeit Tabellen oder CTE während der Ausführung der Abfrage:
...
CASE
  WHEN (
    SELECT
      count(*))
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Aggregatfunktionen (count/min/max/sum/...) funktionieren erfolgreich auf dem gesamten Datensatz, selbst ohne explizite Angabe GROUP BY. Nur mit LIMIT verstehen sie sich nicht sehr gut.
Der Entwickler könnte denken „Wenn dort Datensätze vorhanden sind, dann brauche ich nicht mehr als das LIMIT“. Aber so sollte es nicht sein! Denn für die Datenbank bedeutet das:
- zähl, was gewünscht ist gib so viele Zeilen zurück, wie verlangt
- Je nach Zielbedingungen ist es hier sinnvoll, eine der folgenden Ersetzungen vorzunehmen:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)auf(count + LIMIT 1) > 0EXISTS(LIMIT 1)aufcount >= N(SELECT count(*) FROM (... LIMIT N))auf„Wie viel in Gramm wiegen“: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
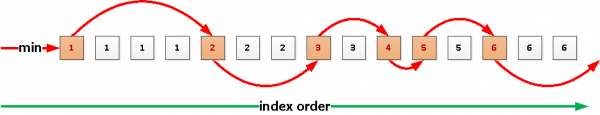
Ein naiver Entwickler könnte aufrichtig glauben, dass die Ausführung der Abfrage Stoppen wird,sobald wir die ersten $1 verschiedenen Werte gefunden haben In der Zukunft könnte das so funktionieren Dank eines neuen Knotens.
Index Skip Scan , dessen Implementierung derzeit ausgearbeitet wird, aber bisher – nein.Bis jetzt werden zuerst
alle Datensätze extrahiert , einzigartig gemacht, und nur dann wird zurückgegeben, was angefordert wurde. Besonders traurig ist es, wenn wir etwas wollten wie, und in der Tabelle sind es Hunderttausende… $1 = 4Um unnötige Traurigkeit zu vermeiden, nutzen wir die rekursive Abfrage
„DISTINCT für Arme“ aus dem PostgreSQL Wiki :
Quelle: habr.com
