

Viele sind mit der PostgreSQL-Datenbank vertraut, und sie hat sich bei kleinen Installationen hervorragend bewährt. Doch der Trend zur Nutzung von Open Source wird immer offensichtlicher, selbst wenn es um große Unternehmen und Anforderungen der Unternehmenswelt geht. In diesem Artikel werden wir erläutern, wie man Postgres in einer Unternehmensumgebung integriert und unsere Erfahrungen mit dem Aufbau eines Backup-Systems (BKS) für diese Datenbank anhand des Beispiels des Commvault-Backup-Systems teilen.
PostgreSQL hat bereits ihre Leistungsfähigkeit bewiesen – die Datenbank funktioniert hervorragend, sie wird von modernen Digitalunternehmen wie Alibaba und TripAdvisor verwendet, und das Fehlen von Lizenzgebühren macht sie zu einer verlockenden Alternative zu Giganten wie MS SQL oder Oracle DB. Aber sobald wir anfangen, über PostgreSQL im Unternehmensumfeld nachzudenken, stoßen wir sofort auf strenge Anforderungen: „Wie steht es um die Ausfallsicherheit der Konfiguration? Die Katastrophensicherung? Wo ist die umfassende Überwachung? Und automatisierte Backups? Und die Verwendung von Bandbibliotheken sowohl direkt als auch für sekundäre Speicher?“
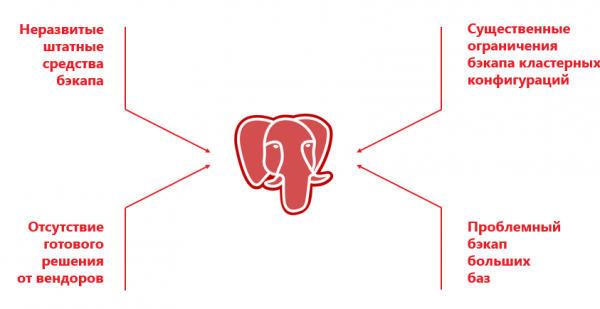
Einerseits hat PostgreSQL keine integrierten Backup-Tools wie die „erwachsenen“ Datenbanken RMAN in Oracle DB oder SAP-Datenbanksicherung. Andererseits unterstützen Anbieter von Unternehmens-Backup-Systemen (Veeam, Veritas, Commvault) zwar PostgreSQL, arbeiten aber in der Praxis nur mit bestimmten (gewöhnlich Standalone-) Konfigurationen und einer Reihe von unterschiedlichen Einschränkungen.
Speziell für PostgreSQL entwickelte Backup-Systeme wie Barman, Wal-g und pg_probackup sind insbesondere bei kleinen PostgreSQL-Installationen oder dort, wo keine aufwendigen Backups anderer IT-Elemente erforderlich sind, äußerst populär. Beispielsweise können in der Infrastruktur neben PostgreSQL physische und virtuelle Server, OpenShift, Oracle, MariaDB, Cassandra usw. vorhanden sein. All dies sollte idealerweise mit einem gemeinsamen Tool gesichert werden. Eine separate Lösung ausschließlich für PostgreSQL einzurichten, ist keine gute Idee: Die Daten würden irgendwo auf eine Festplatte kopiert und müssten dann auf ein Band ausgelagert werden. Diese doppelte Sicherung verlängert die Backup-Zeit und, was noch kritischer ist, die Wiederherstellung.
In der Enterprise-Lösung erfolgt die Sicherung der Installation mit einer bestimmten Anzahl von Knoten des dedizierten Clusters. Zum Beispiel kann Commvault nur mit einem Zweiknoten-Cluster arbeiten, in dem Primary und Secondary fest an bestimmten Knoten gebunden sind. Zudem macht es nur Sinn, vom Primary zu sichern, da die Sicherung vom Secondary eigene Einschränkungen hat. Aufgrund der Besonderheiten der Datenbank wird kein Dump auf dem Secondary erstellt, sodass nur die Möglichkeit eines Dateibackups bleibt.
Um die Ausfallrisiken zu minimieren, wird bei der Erstellung eines ausfallsicheren Systems eine "lebende" Clusterkonfiguration gebildet, und der Primary kann schrittweise zwischen verschiedenen Servern migrieren. Zum Beispiel startet die Software Patroni den Primary automatisch auf einem zufällig ausgewählten Knoten des Clusters. Das SRM hat keine Möglichkeit, dies "out of the box" zu verfolgen, und wenn sich die Konfiguration ändert, brechen die Prozesse. Das bedeutet, dass die Einführung einer externen Verwaltung das SRM daran hindert, effizient zu arbeiten, da der Steuerungsserver einfach nicht versteht, woher und welche Daten kopiert werden müssen.
Ein weiteres Problem ist die Implementierung des Backups in Postgres. Dies ist über Dump möglich, und bei kleinen Datenbanken funktioniert das auch. Bei großen Datenbanken dauert der Dump jedoch lange, benötigt viele Ressourcen und kann zu einem Ausfall der Datenbankinstanz führen.
Dateibackup verbessert die Situation, aber bei großen Datenbanken erfolgt es langsam, da es im einsträngigen Modus arbeitet. Zudem treten eine Reihe zusätzlicher Einschränkungen von Anbietern auf. So kann man beispielsweise nicht gleichzeitig Dateibackup und Dump-Backup verwenden, oder die Deduplizierung wird nicht unterstützt. Es gibt viele Probleme, und oftmals ist es einfacher, anstelle von Postgres eine teure, bewährte Datenbank zu wählen.
Es gibt keinen Rückzug mehr! Hinter uns ist Moskau, die Entwickler!
Vor kurzem sah sich unser Team jedoch mit einer herausfordernden Aufgabe konfrontiert: Im Projekt zur Erstellung des AIS OSAGO 2.0, wo wir die IT-Infrastruktur aufbauten, wählten die Entwickler PostgreSQL für das neue System aus.
Großen Softwareentwicklern fällt es deutlich leichter, "modische" Open-Source-Lösungen zu nutzen. Im Team von Facebook gibt es genügend Spezialisten, die den Betrieb dieser Datenbank unterstützen. Im Falle der RSA lagen jedoch alle "Zweittag"-Aufgaben auf unseren Schultern. Von uns wurde gefordert, die Ausfallsicherheit zu gewährleisten, das Cluster aufzubauen und natürlich Backups einzurichten. Die Logik der Vorgehensweise war folgende:
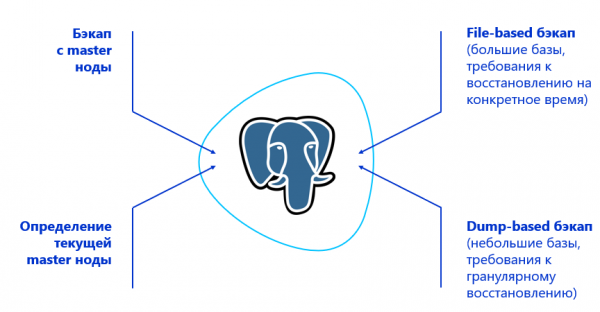
- SRK beizubringen, ein Backup von der Primary-Node des Clusters zu erstellen. Dazu muss SRK diese finden – also ist eine Integration mit einer der Lösungen für das Management von PostgreSQL-Clustern erforderlich. Im Fall von RSA wurde dafür die Software Patroni verwendet.
- Den Typ des Backups festlegen, basierend auf den Datenmengen und den Wiederherstellungsanforderungen. Zum Beispiel, wenn Seiten granular wiederhergestellt werden müssen, einen Dump verwenden, und wenn die Datenbanken groß sind und keine granulare Wiederherstellung erforderlich ist – auf Dateiebene arbeiten.
- Die Möglichkeit eines blockbasierten Backups in die Lösung integrieren, um im Multithreading-Modus ein Backup zu erstellen.
Dabei war es uns von Anfang an wichtig, ein effektives und einfaches System ohne monströse Anbindungen von zusätzlichen Komponenten zu schaffen. Je weniger „Krücken“, desto geringer die Belastung für das Personal und das Risiko, dass SRK ausfällt. Ansätze, bei denen Veeam und RMAN eingesetzt wurden, schlossen wir sofort aus, da das Set aus zwei Lösungen schon auf eine Unsicherheiten in der Systemzuverlässigkeit hinweist.
Ein wenig Magie für Unternehmen
Wir mussten zuverlässige Backups für 10 Cluster mit jeweils 3 Knoten garantieren, während im Backup-Rechenzentrum eine identische Infrastruktur spiegelt. Die Rechenzentren arbeiten im Sinne von PostgreSQL nach dem Prinzip aktiv-passiv. Das Gesamtvolumen der Datenbanken betrug 50 TB. Das kann jede unternehmensgerechte SRK problemlos bewältigen. Der Knackpunkt ist jedoch, dass PostgreSQL ursprünglich keine Grundlage für vollständige und tiefe Kompatibilität mit Backup-Systemen bietet. Daher mussten wir eine Lösung suchen, die von Anfang an maximale Funktionalität in Verbindung mit PostgreSQL bietet und das System ergänzen.
Wir haben 3 interne „Hackathons“ durchgeführt – über fünfzig Entwicklungen gesichtet, getestet, Anpassungen aufgrund unserer Hypothesen vorgenommen und erneut geprüft. Nach Analyse der verfügbaren Optionen haben wir uns für Commvault entschieden. Dieses Produkt konnte bereits „out of the box“ mit einer einfachen Clusterinstallation von PostgreSQL arbeiten, und seine offene Architektur weckte die Hoffnung (die sich bewahrheitete) auf eine erfolgreiche Erweiterung und Integration. Zudem kann Commvault auch PostgreSQL-Logs sichern. Zum Beispiel kann Veritas NetBackup in Bezug auf PostgreSQL nur vollständige Backups erstellen.
Weitere Informationen zur Architektur. Die Verwaltungsserver von Commvault wurden in jeder der beiden Rechenzentren in einer CommServ HA-Konfiguration installiert. Das System ist spiegelsymmetrisch, wird über eine Konsole verwaltet und erfüllt aus HA-Sicht alle Anforderungen an ein Unternehmen.
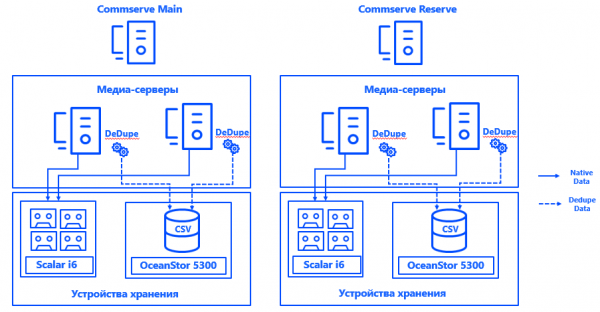
Außerdem haben wir in jedem Rechenzentrum zwei physische Medienserver gestartet, die über SAN mit Fibre Channel an speziell für Backups bereitgestellte Speichersysteme und Bandbibliotheken angeschlossen sind. Die verteilten Deduplication-Datenbanken gewährleisten die Ausfallsicherheit der Medienserver, und die Verbindung jedes Servers mit jedem CSV ermöglicht einen kontinuierlichen Betrieb, selbst wenn eine Komponente ausfällt. Die Systemarchitektur ermöglicht es, die Sicherung fortzusetzen, selbst wenn eines der Rechenzentren ausfällt.
Patroni bestimmt für jeden Cluster die Primary-Node. Diese kann jede freie Node im Rechenzentrum sein – aber nur in der Hauptgruppe. In der Standby-Gruppe sind alle Nodes Secondary.
Damit Commvault erkennt, welche Node des Clusters die Primary ist, haben wir das System (danke an die offene Architektur der Lösung) mit Postgres integriert. Zu diesem Zweck wurde ein Skript erstellt, das die aktuelle Position der Primary-Node an die Verwaltung meldet. zu einem Server Commvault.
Insgesamt sieht der Prozess so aus:
Patroni wählt die Primary → Keepalived aktiviert die IP-Cluster und führt das Skript aus → Der Commvault-Agent auf der gewählten Node des Clusters erhält eine Benachrichtigung, dass dies die Primary ist → Commvault konfiguriert das Backup automatisch innerhalb des Pseudokunden neu.
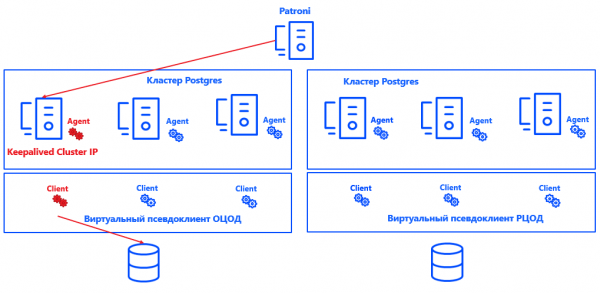
Ein Vorteil dieses Ansatzes ist, dass die Lösung weder die Konsistenz noch die Korrektheit der Protokolle oder die Wiederherstellung der Postgres-Instanz beeinträchtigt. Sie ist auch leicht skalierbar, da es jetzt nicht mehr notwendig ist, die Primary- und Secondary-Nodes für Commvault festzulegen. Es reicht aus, dass das System weiß, wo sich die Primary befindet, und die Anzahl der Nodes kann praktisch bis zu jedem Wert erhöht werden.
Die Lösung erhebt keinen Anspruch auf Perfektion und hat ihre Nuancen. Commvault kann nur die gesamte Instanz sichern, nicht einzelne Datenbanken. Daher wurde für jede DB eine separate Instanz erstellt. Tatsächliche Kunden sind in virtuellen Pseudokunden zusammengefasst. Jeder Pseudokunde von Commvault stellt einen UNIX-Cluster dar. Es werden die Nodes des Clusters hinzugefügt, auf denen der Commvault-Agent für Postgres installiert ist. Infolgedessen werden alle virtuellen Nodes des Pseudokunden als eine einzige Instanz gesichert.
Innerhalb jedes Pseudoklienten ist ein aktiver Knoten des Clusters angegeben. Genau diesen bestimmt unsere Integrationslösung für Commvault. Das Prinzip seiner Funktionsweise ist recht einfach: Wenn auf dem Knoten eine Cluster-IP hochgefahren wird, setzt das Skript im Binärformat des Commvault-Agenten den Parameter „aktiver Knoten“ — faktisch setzt das Skript eine „1“ an die erforderliche Stelle im Speicher. Der Agent überträgt diese Daten an CommServe, und Commvault erstellt ein Backup vom erforderlichen Knoten. Darüber hinaus wird auf der Ebene des Skripts die Richtigkeit der Konfiguration überprüft, um Fehler beim Start der Datensicherung zu vermeiden.
Große Datenbanken werden blockweise in mehreren Streams gesichert, um den Anforderungen an RPO und das Backup-Fenster gerecht zu werden. Die Belastung des Systems ist gering: Vollsicherungen finden nicht so häufig statt, an den anderen Tagen werden nur die Protokolle gesammelt, und zwar in Phasen geringer Auslastung.
Übrigens haben wir separate Richtlinien für die Sicherung von Archivprotokollen in PostgreSQL angewendet — diese werden nach anderen Regeln aufbewahrt, nach einem anderen Zeitplan gesichert und es wird keine Deduplizierung aktiviert, da diese Protokolle einzigartige Daten enthalten.
Um die Konsistenz der gesamten IT-Infrastruktur zu gewährleisten, sind separate Datei-Clients von Commvault auf jedem der Cluster-Knoten installiert. Sie schließen PostgreSQL-Dateien von den Backups aus und sind nur für die Sicherung des Betriebssystems und der Anwendungsprogramme gedacht. Für diesen Teil der Daten ist ebenfalls eine eigene Richtlinie und ein eigener Aufbewahrungszeitraum vorgesehen.
Derzeit hat das SRK keinen Einfluss auf die produktiven Dienste, aber falls sich die Situation ändert, kann im Commvault ein System zur Lastbegrenzung aktiviert werden.
Geht das? Geht!
So haben wir nicht nur ein funktionsfähiges, sondern auch ein vollständig automatisiertes Backup für die Clusterinstallation von PostgreSQL erhalten, das allen Anforderungen des Unternehmens gerecht wird.
Die Parameter RPO und RTO von 1 Stunde und 2 Stunden sind mit einem Puffer abgedeckt, das bedeutet, dass das System diesen auch bei einem signifikanten Anstieg des Speicherbedarfs erfüllen wird. Trotz vieler Zweifel sind PostgreSQL und die Unternehmensumgebung durchaus kompatibel. Und jetzt wissen wir aus eigener Erfahrung, dass Backups für solche DBMS in den unterschiedlichsten Konfigurationen möglich sind.
Natürlich mussten wir auf diesem Weg sieben Paare von Eisenstiefeln abnutzen, eine Reihe von Schwierigkeiten überwinden, auf einige Rechen treten und eine gewisse Anzahl von Fehlern korrigieren. Aber jetzt ist der Ansatz erprobt und kann zur Implementierung von Open Source anstelle proprietärer DBMS unter den harten Bedingungen im Enterprise-Bereich verwendet werden.
Haben Sie schon einmal mit PostgreSQL in einer Unternehmensumgebung gearbeitet?
Autoren:
Oleg Lawrenow, Systemarchitekt für Datenspeicherung bei «Infosemesty Jet»
Dmitri Jerik, Systemarchitekt für Rechenanlagen bei «Infosemesty Jet»
Quelle: habr.com
