

Hallo zusammen. Dieser Artikel ist für diejenigen geschrieben, die noch zwischen den Virtualisierungsplattformen schwanken und nach dem Lesen eines Artikels aus der Reihe „Wir haben Proxmox installiert und alles läuft prima, 6 Jahre ohne Ausfall“ auf die Frage stoßen: Wie kann ich das hier anpassen und hier, um das Monitoring verständlicher zu machen, oder hier, um die Backups zu steuern.... Und dann kommt der Zeitpunkt, an dem man merkt, dass man etwas Funktionaleres möchte, oder dass man möchte, dass alles in seinem System klar ist und nicht wie eine schwarze Box erscheint, oder dass man etwas mehr als nur einen Hypervisor und eine Menge virtueller Maschinen nutzen möchte. In diesem Artikel wird es einige Überlegungen und praktische Erfahrungen mit der Plattform OpenNebula geben – ich habe sie gewählt, weil sie ressourcenschonend ist und die Architektur nicht so kompliziert ist.
Wie wir sehen, arbeiten viele Cloud-Anbieter mit KVM und erstellen externe Bindings zur Verwaltung von Maschinen. Es ist klar, dass große Hostanbieter ihre eigenen Bindungen für die Cloud-Infrastruktur schreiben, wie zum Beispiel YANDEX. Manche nutzen OpenStack und erstellen darauf basierende Bindungen — SELECTEL, MAIL.RU. Aber wenn Sie Ihre eigene Hardware und ein kleines Team von Spezialisten haben, wählen Sie normalerweise etwas Fertiges — VMWARE, HYPER-V, es gibt kostenlose und kostenpflichtige Lizenzen, aber darum geht es jetzt nicht. Sprechen wir über Enthusiasten — das sind diejenigen, die keine Angst haben, Neues anzubieten und auszuprobieren, obwohl die Firma eindeutig angedeutet hat: „Wer wird das nach dir warten?“, „Wird das wirklich in die Produktion gehen? Das macht Angst.“ Aber man kann solche Lösungen zunächst in einer Testumgebung anwenden, und wenn es allen gefällt, kann man das Thema einer weiteren Entwicklung und Nutzung in ernsthafteren Umgebungen ansprechen.
Hier ist der Link zur Präsentation von einem aktiven Teilnehmer an der Entwicklung dieser Plattform.
In diesem Artikel könnte es möglicherweise überflüssige Informationen geben, die bereits für erfahrene Spezialisten verständlich sind, während ich in einigen Fällen nicht alle Details beschreiben werde, da ähnliche Befehle und Beschreibungen im Internet verfügbar sind. Hier teile ich nur meine Erfahrungen mit dieser Plattform. Ich hoffe, dass die aktiven Teilnehmer in den Kommentaren ergänzen, was verbessert werden kann und welche Fehler ich gemacht habe. Alle Aktionen fanden unter den Bedingungen eines Heimstandards mit 3 PCs mit unterschiedlichen Spezifikationen statt. Ich habe absichtlich darauf verzichtet, die Funktionsweise dieser Software und die Installation zu beschreiben. Nein, es geht nur um meine Administrierungserfahrungen und die Probleme, mit denen ich konfrontiert war. Möglicherweise wird dies jemandem bei seiner Entscheidung nützlich sein.
Also, beginnen wir. Für mich als Systemadministrator sind die folgenden Punkte wichtig, ohne die ich diese Lösung wahrscheinlich nicht nutzen werde.
1. Wiederholbarkeit der Installation
Es gibt viele Anleitungen zur Installation von OpenNebula, es sollte keine Probleme geben. Von Version zu Version kommen neue Funktionen hinzu, die bei einem Upgrade nicht immer funktionieren.
2. Überwachung
Wir werden die Node, KVM und OpenNebula selbst überwachen. Zum Glück gibt es bereits Lösungen dafür. Es gibt viele Optionen für die Überwachung von Linux-Hosts, beispielsweise Zabbix oder Node Exporter – je nach Vorliebe. Im Moment definiere ich die Überwachung der Systemmetriken (Temperatur, wo messbar, Konsistenz des Speicher-Arrays) über Zabbix, während ich für die Anwendungen den Exporter in Prometheus verwende. Für die KVM-Überwachung könnte man beispielsweise dieses Projekt verwenden: und es über Systemd starten, funktioniert ganz gut und zeigt KVM-Metriken an. Es gibt auch ein fertiges Dashboard: .
Zum Beispiel, hier ist meine Datei:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
Und so haben wir 1 Exporter, wir benötigen einen zweiten zur Überwachung von OpenNebula, ich habe diesen verwendet:
Das kann man einfach hinzufügen, um die Systemüberwachung Folgendes zu machen.
Im Datei für Node Exporter ändern wir den Start wie folgt:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorErstellen Sie das Verzeichnis mkdir -p /var/lib/opennebula_exporter
Das obige Bash-Skript testen wir zunächst über die Konsole; wenn es das zeigt, was es soll (bei Fehlern installieren wir xmlstarlet), kopieren wir es nach /usr/local/bin/opennebula_exporter.sh
Fügen Sie einen Cron-Job hinzu, der jede Minute läuft:
*\/1 * * * * (/usr/local/bin/opennebula_exporter.sh > /var/lib/opennebula_exporter/textfile_collector/opennebula.prom)Die Metriken sind verfügbar, man kann sie mit Prometheus abrufen und Diagramme erstellen sowie Alarme einrichten. In Grafana kann man beispielsweise ein einfaches Dashboard zeichnen.
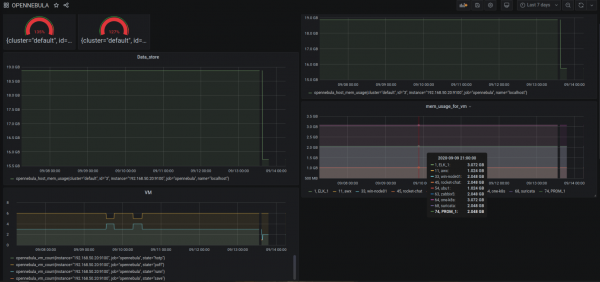
(Man sieht, dass ich hier overcommit für CPU und RAM gemacht habe)
Für diejenigen, die Zabbix mögen und nutzen, gibt es
Das ist alles zur Überwachung, das Wichtigste ist, dass es vorhanden ist. Natürlich kann man zusätzlich die integrierten Überwachungsfunktionen der virtuellen Maschinen nutzen und Daten in die Abrechnung exportieren; hier hat jeder seine eigene Sichtweise, ich habe mich damit bisher nicht intensiver beschäftigt.
Zum Logging habe ich bisher nicht viel gemacht. Die einfachste Option ist, td-agent zum Parsen des Verzeichnisses /var/lib/one mit regulären Ausdrücken hinzuzufügen. Zum Beispiel passt die Datei sunstone.log zu regexp nginx und anderen Dateien, die die Historie der Plattformzugriffe zeigen – was ist der Vorteil? Nun, wir können eindeutig die Anzahl der „Error, error“ verfolgen und schneller herausfinden, wo und auf welcher Ebene es ein Problem gibt.
3. Backups
Es gibt auch kostenpflichtige, angepasste Projekte – zum Beispiel sep :OpenNebula_Backup. Hier müssen wir verstehen, dass es nicht ausreicht, nur das Image der Maschine zu sichern, denn unsere virtuellen Maschinen müssen mit voller Integration arbeiten (dieselbe Kontextdatei, in der die Netzwerkeinstellungen, der Name der VM und benutzerdefinierte Einstellungen für Ihre Anwendungen beschrieben sind). Daher müssen wir festlegen, was und wie wir sichern wollen. In einigen Fällen ist es besser, Kopien von dem zu machen, was sich in der VM selbst befindet. Und vielleicht müssen wir nur eine Festplatte von dieser Maschine sichern.
Zum Beispiel haben wir festgelegt, dass alle Maschinen mit persistenten Images gestartet werden, also haben wir gelesen
Das bedeutet, dass wir zuerst das Image von unserer VM exportieren können:
onevm disk-saveas 74 3 prom.qcow2
Image ID: 77

Wir schauen, unter welchem Namen es gespeichert wurde

oneimage show 77
/var/lib/one//datastores/100/f9503161fe180658125a9b32433bf6e8

Und dann kopieren wir es dorthin, wo es benötigt wird. Natürlich ist das nicht der beste Weg. Ich wollte nur zeigen, dass man mit den Werkzeugen von OpenNebula solche Lösungen erstellen kann.
Außerdem habe ich im Internet gefunden und es gibt noch , aber hier nur für qcow2-Speichersysteme.
Wie wir alle wissen, kommt irgendwann der Moment, an dem man inkrementelle Backups möchte. Hier wird es komplizierter, und möglicherweise wird das Management Geld für eine kostenpflichtige Lösung bereitstellen. Alternativ kann man den Weg gehen und verstehen, dass wir hier nur Ressourcen abbauen, während das Backup auf Anwendungsebene erfolgt und man die Anzahl neuer Knoten und virtueller Maschinen erhöht. Ich sage, dass man die Cloud rein für den Start von Anwendungsclustern nutzen sollte, während man die Datenbanken auf einer anderen Plattform betreibt oder eine fertige Lösung vom Anbieter verwendet, wenn dies möglich ist.
4. Benutzerfreundlichkeit
In diesem Punkt werde ich die Probleme beschreiben, mit denen ich konfrontiert war. Zum Beispiel gibt es bei Images, wie wir wissen, den Typ persistent — wenn dieses Image an eine VM angebunden wird, werden alle Daten in dieses Image geschrieben. Bei non-persistent wird das Image auf den Speicher kopiert und die Daten werden in das kopierte Original-Image geschrieben — so funktionieren die Templates. Ich habe mir selbst mehrmals Probleme gemacht, indem ich vergessen habe, persistent anzugeben, und 200 GB des Images wurden kopiert. Das Problem ist, dass man diesen Vorgang wahrscheinlich nicht abbrechen kann; man muss zur Node gehen und den aktuellen Prozess „cp“ stoppen.
Ein wichtiger Nachteil ist, dass man Aktionen nicht einfach über die GUI abbrechen kann. Oder besser gesagt, man wird sie abbrechen und sehen, dass nichts passiert, dann wieder starten, abbrechen und letztendlich gibt es dann zwei cp-Prozesse, die das Image kopieren.
Und hier versteht man, warum OpenNebula jedem neuen Instanz eine neue ID zuweist. Zum Beispiel habe ich in Proxmox eine VM mit der ID 101 erstellt, sie gelöscht und dann wieder erstellt, jedoch hatte sie erneut die ID 101. In OpenNebula wird das nicht der Fall sein; jede neue Instanz wird mit einer neuen ID erstellt, und darin liegt eine Logik — zum Beispiel die Bereinigung alter Daten oder missratener Installationen.
Das Gleiche gilt für den Speicher; diese Plattform ist vor allem auf zentralisierten Speicher ausgerichtet. Es gibt Add-Ons für die Nutzung lokalen Speichers, aber darum geht es hier nicht. Ich denke, dass in Zukunft jemand einen Artikel darüber schreiben wird, wie es gelungen ist, lokalen Speicher auf Nodes zu nutzen und erfolgreich in der Produktion anzuwenden.
5. Maximale Einfachheit
Natürlich, je weiter man geht, desto weniger Menschen wird es geben, die dich verstehen.
In meinem Setup — 3 Knoten mit NFS-Speicher — funktioniert alles einwandfrei. Aber wenn man Experimente mit der Energieabschaltung durchführt, dann bleibt zum Beispiel beim Starten eines Snapshots und dem Ausschalten der Stromzufuhr der Eintrag in der Datenbank bestehen, dass ein Snapshot existiert, tatsächlich gibt es jedoch keinen (wir wissen ja, dass dieser Vorgang ursprünglich in die SQL-Datenbank eingetragen wurde, aber die Operation war nicht erfolgreich). Der Vorteil ist, dass bei der Erstellung eines Snapshots eine separate Datei generiert wird und es einen „Elternteil“ gibt; im Falle von Problemen, auch wenn es über die GUI nicht funktioniert, können wir die QCOW2-Datei abrufen und separat wiederherstellen.
Bei Netzwerken ist leider nicht alles so einfach. Nun, zumindest einfacher als in OpenStack. Ich habe nur VLAN (802.1Q) verwendet — funktioniert ganz gut, aber wenn Sie Änderungen an den Einstellungen in der Template-Netzwerk vornehmen, werden diese Einstellungen nicht auf bereits laufende Maschinen angewendet, d. h. Sie müssen die Netzwerkkarte entfernen und erneut hinzufügen, dann werden die neuen Einstellungen angewendet.
Wenn man OpenStack weiter vergleichen möchte, kann man sagen, dass es in OpenNebula keine klare Definition gibt, welche Technologien zur Speicherung von Daten, zur Netzwerk- und Ressourcenverwaltung verwendet werden sollten — jeder Administrator entscheidet selbst, wie es für ihn am besten ist.
6. Zusätzliche Plugins und Installationen
Denn wie wir wissen, kann die Cloud-Plattform nicht nur KVM, sondern auch VMware ESXi verwalten. Leider hatte ich keinen Pool mit VCenter, wenn jemand es ausprobiert hat, schreiben Sie bitte.
In der Unterstützung anderer Cloud-Anbieter wurde angegeben,
AWS, AZURE.
Ich habe auch versucht, VMware Cloud von Selectel anzuschließen, aber es hat nichts funktioniert — insgesamt habe ich aufgegeben, da es viele Faktoren gibt, und es macht keinen Sinn, beim Hosting-Anbieter den technischen Support zu kontaktieren.
Außerdem gibt es jetzt in der neuen Version Firecracker — das ist der Start von MicroVMs, eine Art KVM-Wrapper über Docker, was zusätzlich mehr Vielseitigkeit, Sicherheit und Leistung bietet, da keine Ressourcen für die Emulation von Hardware verschwendet werden. Ich sehe nur den Vorteil gegenüber Docker darin, dass es keine zusätzlichen Prozesse benötigt und keine besetzten Sockets bei der Verwendung dieser Emulation gibt, d. h. es kann durchaus als Lastenausgleich verwendet werden (aber darüber sollte man vielleicht einen separaten Artikel schreiben, da ich bisher nicht alle Tests vollständig durchgeführt habe).
7. Positive Erfahrungen und Debugging von Fehlern
Ich wollte meine Beobachtungen zur Funktionsweise teilen, einen Teil habe ich oben beschrieben, und ich möchte mehr schreiben. Tatsächlich bin ich wahrscheinlich nicht der Einzige, der anfangs denkt, dass dies nicht das richtige System ist und dass hier alles etwas hacky ist – wie funktioniert man hier überhaupt? Aber dann kommt das Verständnis, dass alles ganz logisch ist. Natürlich kann man es nicht allen recht machen und einige Aspekte erfordern Nachbesserungen.
Zum Beispiel eine einfache Operation zum Kopieren eines Disk-Images von einem Datastore auf einen anderen. In meinem Fall gibt es 2 Knoten mit NFS, ich sende das Image – das Kopieren erfolgt über das Frontend von OpenNebula, obwohl wir es gewohnt sind, dass die Daten direkt zwischen den Hosts kopiert werden – genauso wie bei VMware oder Hyper-V, dort sind wir es gewohnt, aber hier ist es anders. Hier gibt es einen anderen Ansatz und eine andere Ideologie, und in Version 5.12 wurde die Schaltfläche „migrate to datastore“ entfernt – es wird nur die Maschine selbst verschoben, aber nicht der Speicher, da ein zentrales Speicher verwendetes wird.
Dann gibt es den häufigen Fehler mit verschiedenen Ursachen „Fehler beim Bereitstellen der virtuellen Maschine: Konnte Domain nicht aus /var/lib/one//datastores/103/10/deployment.5 erstellen“. Weiter unten wird die Liste bereitgestellt, was man ansehen sollte.
- Berechtigungen für das Image für den Benutzer oneadmin;
- Berechtigungen für den Benutzer oneadmin zum Starten von libvirtd;
- Ist der Datastore richtig gemountet? Geh und überprüfe den Pfad am Knoten selbst, möglicherweise ist etwas abgebrochen;
- Falsch konfigurierte Netzwerke, genauer gesagt, in den Netzwerkeinstellungen des Frontends steht, dass br0 als primäres Interface für VLAN verwendet wird, während am Knoten bridge0 eingetragen ist – es sollte gleich sein.
Der system datastore speichert Metadaten für Ihre VM. Wenn Sie die VM mit einem persistenten Image starten, muss die VM auf die ursprünglich erstellte Konfiguration auf dem Datastore zugreifen, auf dem Sie die VM erstellt haben – das ist sehr wichtig. Daher sollten bei der Übertragung der VM auf einen anderen Datastore alle Überprüfungen vorgenommen werden.
8. Dokumentation, Community. Weitere Entwicklung
Und das andere, gute Dokumentation, eine Community und vor allem, dass das Projekt weiterhin lebendig bleibt.
Insgesamt ist hier alles ziemlich gut dokumentiert, und selbst bei der offiziellen Quelle wird es keine Probleme geben, die Installation durchzuführen und Antworten auf Fragen zu finden.
Eine aktive Gemeinschaft. Sie veröffentlicht viele fertige Lösungen, die Sie in Ihren Installationen verwenden können.
Momentan haben sich mit 5.12 einige Richtlinien im Unternehmen geändert. Es wird interessant sein zu erfahren, wie sich das Projekt entwickeln wird. Zu Beginn habe ich absichtlich einige Anbieter aufgeführt, die ihre eigenen Lösungen verwenden und was die Industrie anbietet. Eine klare Antwort darauf, was Sie verwenden sollten, gibt es natürlich nicht. Aber für kleine Organisationen kann die Unterstützung ihrer eigenen kleinen privaten Cloud vielleicht weniger kostspielig sein als gedacht. Das Wichtigste ist, genau zu wissen, dass Sie dies benötigen.
Zusammenfassend lässt sich sagen, dass Sie, unabhängig davon, welches Cloud-System Sie gewählt haben, nicht bei einem Produkt stehen bleiben sollten. Wenn Sie Zeit haben, sollten Sie sich auch andere offenere Lösungen ansehen.
Es gibt einen guten Chat. Sie helfen aktiv und schicken nicht zum Suchen von Problemlösungen zu Google. Treten Sie bei.
Quelle: habr.com
