

Ich setze meine Erzählung darüber fort, wie man Exchange und ELK zusammenbringt (Anfang ). Ich erinnere daran, dass diese Kombination ohne Zögern eine sehr große Menge an Logs verarbeiten kann. Diesmal werden wir darüber sprechen, wie man die Zusammenarbeit von Exchange mit den Komponenten Logstash und Kibana einrichtet.
Logstash im ELK-Stack wird für die intelligente Verarbeitung von Logs und deren Vorbereitung zur Speicherung in Elastic in Form von Dokumenten verwendet, auf deren Grundlage verschiedene Visualisierungen in Kibana bequem erstellt werden können.
Installation
Besteht aus zwei Phasen:
- Installation und Konfiguration des OpenJDK-Pakets.
- Installation und Konfiguration des Logstash-Pakets.
Installation und Konfiguration des OpenJDK-Pakets
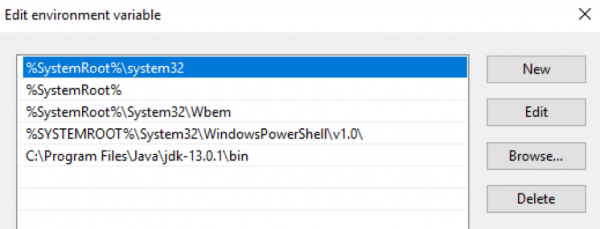
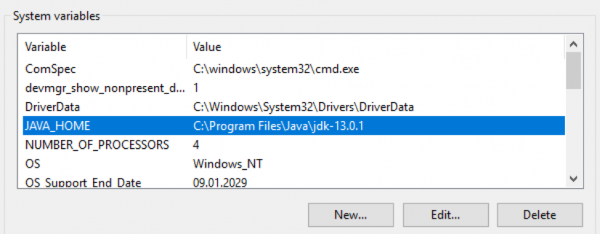
Das OpenJDK-Paket muss heruntergeladen und in ein bestimmtes Verzeichnis entpackt werden. Anschließend muss der Pfad zu diesem Verzeichnis in die Variablen $env:Path und $env:JAVA_HOME des Windows-Betriebssystems eingefügt werden:
Überprüfen wir die Java-Version:
PS C:<; java -version
openjdk version "13.0.1" 2019-10-15
OpenJDK Runtime Environment (build 13.0.1+9)
OpenJDK 64-Bit Server VM (build 13.0.1+9, mixed mode, sharing)
Installation und Konfiguration des Logstash-Pakets
Laden Sie die Archivdatei mit dem Logstash-Distribution herunter . Das Archiv sollte im Wurzelverzeichnis des Laufwerks entpackt werden. Es sollte nicht in einen Ordner entpackt werden, C:Program Files da Logstash sich sonst nicht ordnungsgemäß starten lässt. Anschließend müssen Änderungen in der Datei jvm.options vorgenommen werden, die für die Zuweisung von Arbeitsspeicher an den Java-Prozess verantwortlich sind. Ich empfehle, die Hälfte des Arbeitsspeichers des Servers anzugeben. Wenn er 16 GB RAM hat, lauten die Standardwerte:
-Xms1g
-Xmx1g
sollten ersetzt werden durch:
-Xms8g
-Xmx8g
Darüber hinaus ist es sinnvoll, die Zeile -XX:+UseConcMarkSweepGCzu kommentieren. Weitere Informationen dazu . Der nächste Schritt besteht darin, eine Standardkonfiguration in der Datei logstash.conf zu erstellen:
input {
 stdin{}
}

filter {
}

output {
 stdout {
 codec => "rubydebug"
 }
}
Mit dieser Konfiguration liest Logstash Daten von der Konsole, leitet sie durch einen leeren Filter und gibt sie zurück in die Konsole aus. Die Anwendung dieser Konfiguration ermöglicht es, die Funktionalität von Logstash zu überprüfen. Dazu starten wir es im interaktiven Modus:
PS C:...bin> .logstash.bat -f .logstash.conf
...
[2019-12-19T11:15:27,769][INFO ][logstash.javapipeline    ][main] Pipeline gestartet {"pipeline.id"=>"main"}
Das stdin-Plugin wartet jetzt auf Eingaben:
[2019-12-19T11:15:27,847][INFO ][logstash.agent           ] Pipelines laufen {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]}
[2019-12-19T11:15:28,113][INFO ][logstash.agent           ] Logstash API-Endpunkt erfolgreich gestartet {:port=>9600}
Logstash wurde erfolgreich auf Port 9600 gestartet.
Der letzte Schritt der Installation: Start von Logstash als Windows-Dienst. Dies kann beispielsweise mit dem Paket :
PS C:...bin> .nssm.exe install logstash
Dienst "logstash" erfolgreich installiert!
Fehlertoleranz
Die Sicherheit der Protokolle beim Transfer vom ursprünglichen Server wird durch den Mechanismus der Persistent Queues gewährleistet.
Wie es funktioniert
Schema der Anordnung der Queues im Prozess der Protokollverarbeitung: input → queue → filter + output.
Das Input-Plugin erhält Daten von der Protokollquelle, speichert diese in der Queue und sendet eine Bestätigung an die Quelle über den Erhalt der Daten.
Nachrichten aus der Queue werden von Logstash verarbeitet, durchlaufen den Filter und das Output-Plugin. Nach Erhalt einer Bestätigung der Sendung vom Output entfernt Logstash das verarbeitete Protokoll aus der Queue. Wenn Logstash gestoppt wird, bleiben alle nicht verarbeiteten Nachrichten und Nachrichten, für die keine Sendebestätigung erhalten wurde, in der Queue, und Logstash wird deren Verarbeitung beim nächsten Start fortsetzen.
Einstellungen
Reguliert durch Schlüssel in der Datei C:Logstashconfiglogstash.yml:
queue.type: (mögliche Werte —persistedundmemory (Standard)).path.queue: (Pfad zum Ordner mit den Queue-Dateien, die standardmäßig in C:Logstashqueue gespeichert werden).queue.page_capacity: (maximale Seitenkapazität der Queue, Standardwert — 64mb).queue.drain: (true/false — schaltet die Verarbeitung der Queue vor dem Stoppen von Logstash ein/aus. Ich empfehle, dies nicht zu aktivieren, da es die Geschwindigkeit des Serverstopps direkt beeinflussen kann).queue.max_events: (maximale Anzahl an Ereignissen in der Queue, Standard — 0 (nicht begrenzt)).queue.max_bytes: (maximale Größe der Queue in Bytes, Standard — 1024mb (1gb)).
Wenn konfiguriert, queue.max_events und queue.max_bytes, werden keine Nachrichten mehr in die Queue aufgenommen, wenn der Wert einer dieser Einstellungen erreicht wird. Mehr Informationen über Persistent Queues sind .
Ein Beispiel für einen Teil von logstash.yml, der für die Konfiguration der Queue zuständig ist:
queue.type: persisted
queue.max_bytes: 10gb
Einstellungen
Die Konfiguration von Logstash besteht normalerweise aus drei Teilen, die für verschiedene Phasen der Verarbeitung eingehender Protokolle verantwortlich sind: Empfang (Input-Sektion), Parsing (Filter-Sektion) und Sendung an Elastic (Output-Sektion). Im Folgenden betrachten wir jeden von ihnen näher.
Input
Den eingehenden Strom mit rohen Protokollen erhalten wir von Filebeat-Agenten. Genau dieses Plugin geben wir in der Input-Sektion an:
input {
  beats {
    port => 5044
  }
}
Nach dieser Konfiguration beginnt Logstash, den Port 5044 zu überwachen, und verarbeitet bei Erhalt von Protokollen diese gemäß den Einstellungen der Filter-Sektion. Bei Bedarf kann der Kanal, über den Protokolle von Filebeat empfangen werden, in SSL gewickelt werden. Weitere Informationen zu den Einstellungen des Beats-Plugins sind geschrieben. .
Filter
Alle interessanten zu verarbeitenden Textprotokolle, die von Exchange generiert werden, haben das CSV-Format mit in der Protokolldatei beschriebenen Feldern. Für das Parsen von CSV-Einträgen bietet Logstash uns drei Plugins an: , csv und grok. Das erste ist das , bietet jedoch nur eine Parsing-Funktion für die einfachsten Protokolle.
Zum Beispiel wird dieser Eintrag aufgrund des Vorhandenseins eines Kommas innerhalb des Feldes in zwei Teile zerlegt, wodurch das Protokoll falsch analysiert wird:
…,"MDB:GUID1, Mailbox:GUID2, Event:526545791, MessageClass:IPM.Note, CreationTime:2020-05-15T12:01:56.457Z, ClientType:MOMT, SubmissionAssistant:MailboxTransportSubmissionEmailAssistant",…
Es kann beim Parsen von Protokollen, z. B. IIS, verwendet werden. In diesem Fall könnte der Filterabschnitt wie folgt aussehen:
filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
    }
  }
}
Die Konfiguration von Logstash ermöglicht die Verwendung von , weshalb wir im Dissect-Plugin nur die Protokolle weiterleiten können, die mit dem Filebeat-Tag IISmarkiert wurden. Innerhalb des Plugins ordnen wir die Werte der Felder ihren Namen zu, entfernen das ursprüngliche Feld message, das den Logeintrag enthielt, und können ein weiteres beliebiges Feld hinzufügen, das beispielsweise den Namen der Anwendung, aus der wir Protokolle sammeln, enthalten kann.
Bei Protokollen von Tracking ist es besser, das CSV-Plugin zu verwenden, da es komplizierte Felder korrekt verarbeiten kann:
filter {
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
}
Innerhalb des Plugins ordnen wir die Werte der Felder ihren Namen zu, entfernen das ursprüngliche Feld message (und die Felder tenant-id und schema-version), die den Logeintrag enthielten, und können ein beliebiges weiteres Feld hinzufügen, das beispielsweise den Namen der Anwendung, aus der wir Protokolle sammeln, enthalten kann.
Am Ende der Filterstufe erhalten wir Dokumente, die im ersten Ansatz bereit für die Visualisierung in Kibana sind. Uns werden die folgenden Dinge fehlen:
- Zahlenfelder werden als Text erkannt, was Operationen mit ihnen unmöglich macht. Genauer gesagt, die Felder
time-takendes IIS-Protokolls sowie der Felderrecipient-countundtotal-bitesdes Tracking-Logs. - Der Standard-Zeitstempel des Dokuments wird die Verarbeitungszeit des Logs enthalten, nicht die Zeit, zu der es auf der Serverseite aufgezeichnet wurde.
- Feld
recipient-addresswird als eine einzige Zeile aussehen, was eine Analyse mit Zählung der Empfänger von E-Mails unmöglich macht.
Es ist Zeit, ein wenig Magie in den Prozess der Logverarbeitung einzufügen.
Die Konvertierung von Zahlenfeldern
Das Plugin dissect hat eine Option convert_datatype, die verwendet werden kann, um ein Textfeld in ein Zahlenformat zu konvertieren. Zum Beispiel so:
dissect {
  …
  convert_datatype => { "time-taken" => "int" }
  …
}
Es ist zu beachten, dass diese Methode nur funktioniert, wenn das Feld tatsächlich eine Zeichenkette enthält. Null-Werte in Feldern werden nicht verarbeitet und führen zu einer Ausnahme.
Für Tracking-Logs sollte die ähnliche Methode zur Konvertierung besser nicht verwendet werden, da die Felder recipient-count und total-bites leer sein können. Zur Konvertierung dieser Felder ist es besser, das Plugin :
mutate {
  convert => [ "total-bytes", "integer" ]
  convert => [ "recipient-count", "integer" ]
}
Die Aufspaltung der recipient_address in einzelne Empfänger
Diese Aufgabe kann ebenfalls mit dem Plugin mutate gelöst werden:
mutate {
  split => ["recipient_address", ";"]
}
Ändern des Zeitstempels
Im Fall eines Tracking-Logs kann die Aufgabe sehr einfach mit dem Plugin gelöst werden, , das helfen wird, im Feld timestamp das Datum und die Uhrzeit im benötigten Format aus dem Feld date-time:
date {
  match => [ "date-time", "ISO8601" ]
  timezone => "Europe/Moscow"
  remove_field => [ "date-time" ]
}
Im Fall von IIS-Logs müssen wir die Daten der Felder kombinieren date und time mit dem Plugin mutate, die benötigte Zeitzone angeben und diesen Zeitstempel in timestamp mit dem Plugin date einfügen:
mutate {
  add_field => { "data-time" => "%{date} %{time}" }
  remove_field => [ "date", "time" ]
}
date {
  match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
  timezone => "UTC"
  remove_field => [ "data-time" ]
}
Ausgabe
Der Abschnitt output wird verwendet, um die verarbeiteten Logs an den Log-Empfänger zu senden. Bei der direkten Übertragung an Elastic wird das Plugin verwendet, , in dem die Adresse des Servers und das Muster des Indexnamens für das Senden des erstellten Dokuments angegeben werden:
output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Die endgültige Konfiguration
Die endgültige Konfiguration wird folgendermaßen aussehen:
input {
  beats {
    port => 5044
  }
}

filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
      convert_datatype => { "time-taken" => "int" }
    }
    mutate {
      add_field => { "data-time" => "%{date} %{time}" }
      remove_field => [ "date", "time" ]
    }
    date {
      match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
      timezone => "UTC"
      remove_field => [ "data-time" ]
    }
  }
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
    mutate {
      convert => [ "total-bytes", "integer" ]
      convert => [ "recipient-count", "integer" ]
      split => ["recipient_address", ";"]
    }
    date {
      match => [ "date-time", "ISO8601" ]
      timezone => "Europe/Moscow"
      remove_field => [ "date-time" ]
    }
  }
}

output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Nützliche Links:
Quelle: habr.com
