

In Anbetracht des Verkaufsstopps in Russland für das Logging- und Analysesystem Splunk stellte sich die Frage, welches Lösung dafür eingesetzt werden kann. Nach intensiver Recherche über verschiedene Optionen habe ich mich für eine Lösung für echte Männer entschieden — „ELK-Stack“. Dieses System erfordert Zeit für die Einrichtung, liefert jedoch letztendlich ein sehr leistungsfähiges System zur Analyse des Status und zur schnellen Reaktion auf Vorfälle der Informationssicherheit in der Organisation. In diesem Artikelzyklus werden wir die grundlegenden (und vielleicht nicht nur) Funktionen des ELK-Stacks untersuchen, wie man Logs parsen kann, Diagramme und Dashboards erstellt und welche interessanten Funktionen anhand von Logs von der Firewall Check Point oder dem Sicherheitsscanner OpenVas umgesetzt werden können. Zunächst einmal sehen wir uns an, was der ELK-Stack eigentlich ist und aus welchen Komponenten er besteht.
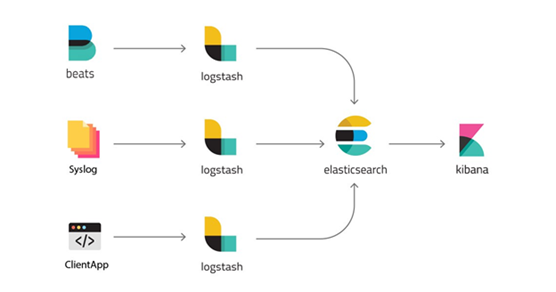
„ELK-Stack“ — ist eine Abkürzung für drei Open-Source-Projekte: Elasticsearch, Logstash und Kibana. Entwickelt von der Firma Elastic zusammen mit allen zugehörigen Projekten. Elasticsearch ist der Kern des gesamten Systems, das die Funktionen einer Datenbank, Such- und Analysesystem kombiniert. Logstash ist eine Datenverarbeitungs-Pipeline auf der Serverseite, die Daten aus mehreren Quellen gleichzeitig erhält, Logs parst und diese dann an die Elasticsearch-Datenbank sendet. Kibana ermöglicht es Benutzern, Daten mit Diagrammen und Grafiken in Elasticsearch zu visualisieren. Außerdem kann die Datenbank über Kibana verwaltet werden. Im Folgenden werden wir jedes System detaillierter betrachten.
Logstash
Logstash ist ein Werkzeug zur Verarbeitung von Logereignissen aus verschiedenen Quellen, mit dem Felder und deren Werte in einer Nachricht extrahiert werden können; außerdem können Filterung und Datenbearbeitung konfiguriert werden. Nach allen Manipulationen leitet Logstash die Ereignisse in den endgültigen Datenspeicher um. Das Werkzeug wird ausschließlich über Konfigurationsdateien konfiguriert.
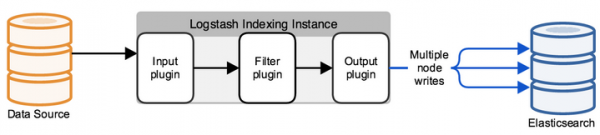
Eine typische Logstash-Konfiguration besteht aus einer oder mehreren Dateien, die mehrere eingehende Informationsströme (input), mehrere Filter für diese Informationen (filter) und mehrere ausgehende Ströme (output) enthalten. Das sieht aus wie eine oder mehrere Konfigurationsdateien, die im einfachsten Fall (der nichts tut) so aussieht:
input {
}

filter {
}

output {
}
Im INPUT konfigurieren wir, auf welchen Port die Protokolle ankommen und über welches Protokoll, oder aus welchem Ordner neue oder fortlaufend hinzuzufügende Dateien gelesen werden. Im FILTER konfigurieren wir den Protokollparser: Feldanalyse, Wertebearbeitung, Hinzufügen neuer Parameter oder Löschen. FILTER ist das Feld zur Steuerung der Nachrichten, die von Logstash mit einer Vielzahl von Bearbeitungsoptionen empfangen werden. Im OUTPUT konfigurieren wir, wohin wir das bereits analysierte Protokoll senden. Falls es sich um Elasticsearch handelt, wird eine JSON-Anfrage gesendet, in der die Felder mit Werten übermittelt werden, oder im Rahmen von Debugging kann in stdout ausgegeben oder in eine Datei geschrieben werden.
ElasticSearch
Ursprünglich ist Elasticsearch eine Lösung für die Volltextsuche, aber mit zusätzlichen Annehmlichkeiten wie einfacher Skalierbarkeit, Replikation und mehr, was das Produkt sehr benutzerfreundlich und zu einer guten Lösung für hoch belastete Projekte mit großen Datenmengen macht. Elasticsearch ist ein nicht-relationales Dokumenten-Storage (NoSQL) im JSON-Format und eine Suchmaschine basierend auf der Volltextsuche von Lucene. Die Hardwareplattform ist die Java Virtual Machine, daher benötigt das System eine große Menge an CPU- und Arbeitsspeicherressourcen zum Betrieb.
Jede eingehende Nachricht, egal ob von Logstash oder über eine API-Anfrage, wird als „Dokument“ indiziert – vergleichbar mit einer Tabelle in relationalen SQL. Alle Dokumente werden im Index gespeichert – vergleichbar mit einer Datenbank in SQL.
Beispiel eines Dokuments in der Datenbank:
{
  "_index": "checkpoint-2019.10.10",
  "_type": "_doc",
  "_id": "yvNZcWwBygXz5W1aycBy",
  "_version": 1,
  "_score": null,
  "_source": {
	"layer_uuid": [
      "dae7f01c-4c98-4c3a-a643-bfbb8fcf40f0",
      "dbee3718-cf2f-4de0-8681-529cb75be9a6"
	],
	"outzone": "External",
	"layer_name": [
  	"TSS-Standard Security",
  	"TSS-Standard Application"
	],
	"time": "1565269565",
	"dst": "103.5.198.210",
	"parent_rule": "0",
	"host": "10.10.10.250",
	"ifname": "eth6",
    ]
}
Die gesamte Arbeit mit der Datenbank erfolgt über JSON-Anfragen mithilfe von REST API, die entweder Dokumente nach Index zurückgeben oder eine Art Statistik im Format: Frage – Antwort bereitstellen. Um alle Antworten auf Anfragen zu visualisieren, wurde Kibana entwickelt, die einen Webdienst darstellt.
Kibana
Kibana ermöglicht das Suchen, Abrufen von Daten und Anfordern von Statistiken aus der Elasticsearch-Datenbank. Auf der Grundlage der Antworten entstehen zahlreiche ansprechende Diagramme und Dashboards. Das System bietet auch Funktionen zur Administration der Elasticsearch-Datenbank. In den kommenden Artikeln werden wir diesen Dienst genauer betrachten. Jetzt zeigen wir ein Beispiel von Dashboards für die Firewall Check Point und den Schwachstellenscanner OpenVas, die erstellt werden können.
Beispiel eines Dashboards für Check Point, das Bild ist klickbar:
Beispiel eines Dashboards für OpenVas, das Bild ist klickbar:
Fazit
Wir haben uns angesehen, aus was genau der ELK-Stackbesteht, haben uns kurz mit den Hauptprodukten vertraut gemacht. Im weiteren Verlauf des Kurses werden wir die Erstellung der Konfigurationsdatei für Logstash, die Anpassung von Dashboards in Kibana, die Einführung in API-Anfragen und die Automatisierung sowie viele weitere Themen behandeln!
Also haltet euch über die Updates auf dem Laufenden (, , , ), .
Quelle: habr.com
