

Wenn Sie eine virtuelle Infrastruktur auf Basis von VMware vSphere (oder einem anderen Technologiestack) administrieren, hören Sie sicherlich oft von Benutzern Beschwerden: „Die virtuelle Maschine arbeitet langsam!“. In diesem Artikelzyklus werde ich Leistungskennzahlen untersuchen und erklären, was und warum es „stockt“ und wie man es verhindert, dass es „stockt“.
Ich werde folgende Aspekte der Leistung virtueller Maschinen betrachten:
- CPU,
- RAM,
- DISK,
- Netzwerk.
Ich beginne mit der CPU.
Für die Leistungsanalyse benötigen wir:
- vCenter Performance Counters – Leistungskennzahlen, deren Grafiken über den vSphere Client angezeigt werden können. Informationen zu diesen Kennzahlen sind in jeder Version des Clients verfügbar ("dicker" Client in C#, Web-Client in Flex und Web-Client in HTML5). In diesem Artikelzyklus verwenden wir Screenshots aus dem C#-Client, einfach weil sie in der Miniaturansicht besser aussehen :)
- ESXTOP – ein Tool, das aus der ESXi-Eingabeaufforderung gestartet wird. Damit können Sie die Leistungskennzahlen in Echtzeit abrufen oder diese Werte für einen bestimmten Zeitraum in eine .csv-Datei exportieren, um sie weiter zu analysieren. Ich werde dieses Tool im Folgenden näher erläutern und einige nützliche Links zu Dokumentationen und Artikeln zu diesem Thema bereitstellen.
Ein wenig Theorie
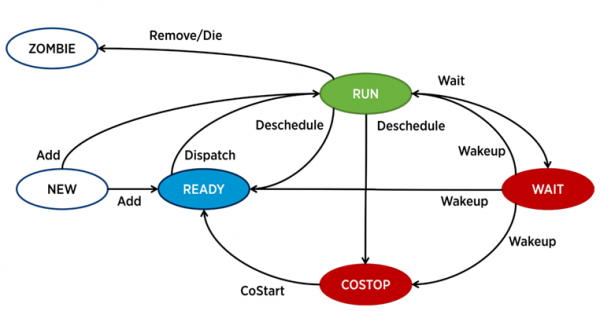
In ESXi ist jeder vCPU (Kern der virtuellen Maschine) für einen separaten Prozess verantwortlich – world in der VMware-Terminologie. Es gibt auch Systemprozesse, aber aus Sicht der Leistungsanalyse von VMs sind diese weniger interessant.
Ein Prozess in ESXi kann sich in einem der vier Zustände befinden:
- Ausführen – der Prozess führt eine nützliche Arbeit aus.
- Warten – der Prozess führt keine Arbeit aus (idle) oder wartet auf Eingabe/Ausgabe.
- Costop – Zustand, der in Mehrkern- virtuellen Maschinen auftritt. Er entsteht, wenn der CPU-Planer des Hypervisors (ESXi CPU Scheduler) nicht in der Lage ist, die gleichzeitige Ausführung auf den physischen Kernen des Servers für alle aktiven Kerne der virtuellen Maschine zu planen. In der physischen Welt arbeiten alle CPU-Kerne parallel, das Gast-Betriebssystem innerhalb der VM rechnet mit einem ähnlichen Verhalten, weshalb der Hypervisor die Kerne der VM, die in der Lage sind, ihren Takt schneller zu beenden, verlangsamen muss. In modernen Versionen von ESXi verwendet der CPU-Planer einen Mechanismus, der als relaxed co-scheduling bezeichnet wird: der Hypervisor berücksichtigt den Unterschied zwischen dem „schnellsten“ und dem „langsamsten“ Kern der virtuellen Maschine (skew). Überschreitet der Unterschied einen bestimmten Schwellenwert, wechselt der „schnelle“ Kern in den Zustand costop. Wenn die Kerne der VM viel Zeit in diesem Zustand verbringen, kann das zu Leistungsproblemen führen.
- Bereit – der Prozess wechselt in diesen Zustand, wenn der Hypervisor nicht in der Lage ist, Ressourcen für seine Ausführung bereitzustellen. Hohe Werte für ready können Leistungsprobleme für die VM verursachen.
Wichtige Leistungskennzahlen der CPU der virtuellen Maschine
CPU Nutzung, %. Zeigt den Prozentsatz der CPU-Nutzung über einen bestimmten Zeitraum an.
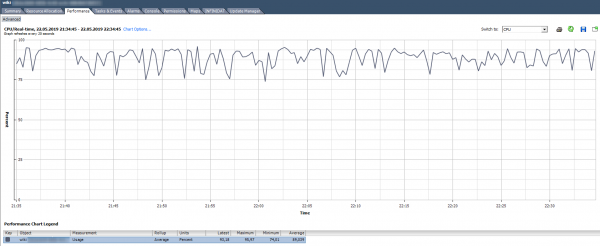
Wie analysieren? Wenn die VM konstant 90 % CPU nutzt oder Spitzen bis zu 100 % hat, dann haben wir Probleme. Diese Probleme können sich nicht nur in einer „langsame“ Ausführung der Anwendung innerhalb der VM äußern, sondern auch in der Erreichbarkeit der VM im Netzwerk. Wenn das Überwachungssystem anzeigt, dass die VM gelegentlich ausfällt, achten Sie auf Spitzen im Diagramm der CPU-Nutzung.
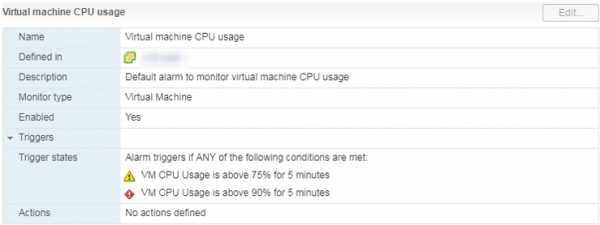
Es gibt einen Standard-Alarme, der die CPU-Auslastung der virtuellen Maschine anzeigt:
Was tun? Wenn die CPU-Nutzung der VM dauerhaft hoch ist, kann es sinnvoll sein, die Anzahl der vCPUs zu erhöhen (leider hilft das nicht immer) oder die VM auf einen Server mit leistungsfähigeren Prozessoren zu migrieren.
CPU-Nutzung in MHz
In den Diagrammen der vCenter-Nutzung in % kann man nur die gesamte virtuelle Maschine sehen, Diagramme nach einzelnen Kernen gibt es nicht (in Esxtop gibt es Werte in % nach Kernen). Für jeden Kern kann man die Nutzung in MHz betrachten.
Wie analysieren? Es kann vorkommen, dass die Anwendung nicht für Mehrkernarchitekturen optimiert ist: Sie nutzt nur einen Kern zu 100 %, während die anderen ungenutzt bleiben. Zum Beispiel startet MS SQL bei den Standard-Backup-Einstellungen den Prozess nur auf einem Kern. Infolgedessen wird die Sicherung nicht aufgrund der langsamen Festplattengeschwindigkeit (darüber hat sich der Benutzer zunächst beschwert) verlangsamt, sondern weil die CPU überlastet ist. Das Problem wurde durch eine Änderung der Parameter gelöst: Das Backup wurde parallel in mehrere Dateien (und damit in mehrere Prozesse) ausgeführt.
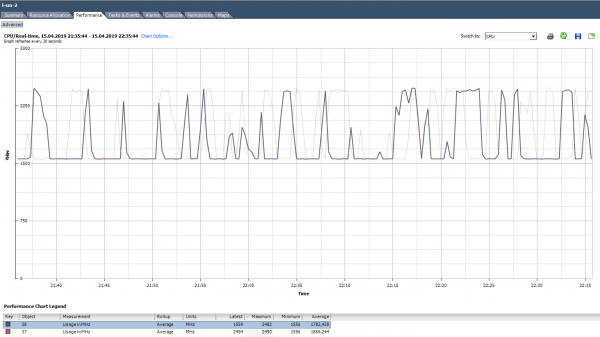
Beispiel für ungleiche Kernlast.
Es gibt auch Situationen (wie im obigen Diagramm), in denen die Kerne ungleichmäßig ausgelastet sind und einige dabei Spitzen von 100 % erreichen. Wie bei der Auslastung nur eines Kerns wird der Alarm für die CPU-Auslastung nicht ausgelöst (er bezieht sich auf die gesamte VM), jedoch wird es Leistungsprobleme geben.
Was tun? Wenn die Software in der virtuellen Maschine die Kerne ungleichmäßig belastet (nur einen Kern oder einen Teil der Kerne nutzt), macht es keinen Sinn, deren Anzahl zu erhöhen. In einem solchen Fall ist es besser, die VM auf einen Server mit leistungsstärkeren Prozessoren zu übertragen.
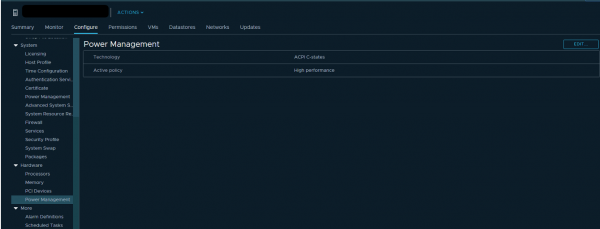
Es kann auch hilfreich sein, die Energieeinstellungen im BIOS des Servers zu überprüfen. Viele Administratoren aktivieren im BIOS den Energiemodus "Höchstleistung" und schalten damit die Energiespartechnologien C-States und P-States aus. In modernen Intel-Prozessoren wird die Turbo-Boost-Technologie verwendet, die die Frequenz einzelner Prozessorkerne auf Kosten anderer Kerne erhöht. Diese funktioniert jedoch nur, wenn die Energiespartechnologien aktiviert sind. Wenn wir sie deaktivieren, kann der Prozessor den Energieverbrauch von Kernen, die nicht belastet sind, nicht senken.
VMware empfiehlt, die Energiespartechnologien auf Servern nicht zu deaktivieren, sondern Modi auszuwählen, die die Energieverwaltung maximal dem Hypervisor überlassen. In den Energieeinstellungen des Hypervisors sollte dabei der Modus "Höchstleistung" ausgewählt werden.
Wenn in Ihrer Infrastruktur einzelne VMs (oder VM-Kerne) eine erhöhte CPU-Frequenz benötigen, kann eine korrekte Einstellung des Energieverbrauchs deren Leistung erheblich verbessern.
CPU Bereit (Readiness)
Wenn der Kernel der VM (vCPU) im Zustand Ready ist, erbringt er keine nützliche Arbeit. Dieser Zustand tritt auf, wenn der Hypervisor keinen freien physischen Kern finden kann, auf den der vCPU-Prozess der virtuellen Maschine zugewiesen werden kann.
Wie analysieren? In der Regel, wenn die Kerne der virtuellen Maschine mehr als 10 % der Zeit im Zustand Ready sind, werden Sie Leistungsprobleme bemerken. Einfach gesagt, wartet die VM mehr als 10 % der Zeit auf die Verfügbarkeit physischer Ressourcen.
In vCenter können zwei Zähler, die mit CPU Ready verbunden sind, eingesehen werden:
- Readiness,
- Ready.
Die Werte beider Zähler können sowohl für die gesamte VM als auch für einzelne Kerne angezeigt werden.
Readiness zeigt den Wert sofort in Prozent an, jedoch nur in Echtzeit (Daten der letzten Stunde, Messintervall 20 Sekunden). Dieser Zähler sollte besser nur zur Fehlersuche „in Echtzeit“ verwendet werden.
Die Werte des Ready-Zählers können auch rückblickend betrachtet werden. Dies ist nützlich, um Muster zu erkennen und eine tiefere Analyse des Problems durchzuführen. Wenn beispielsweise eine virtuelle Maschine zu einem bestimmten Zeitpunkt Leistungsprobleme bekommt, kann man die Intervalle mit erhöhten Werten von CPU Ready mit der Gesamtlast des Servers, auf dem die VM läuft, vergleichen und Maßnahmen zur Reduzierung der Last ergreifen (falls DRS nicht geholfen hat).
Ready wird im Gegensatz zu Readiness nicht in Prozent, sondern in Millisekunden angezeigt. Dies ist ein Summationszähler, das heißt, er zeigt an, wie lange die VM-Kerne während des Messzeitraums im Zustand Ready waren. Um diesen Wert in Prozent umzuwandeln, kann die folgende einfache Formel verwendet werden:
(CPU ready summation value / (chart default update interval in seconds * 1000)) * 100 = CPU ready %
Für die VM im untenstehenden Diagramm ergibt sich beispielsweise der Spitzenwert für Ready für die gesamte virtuelle Maschine wie folgt:

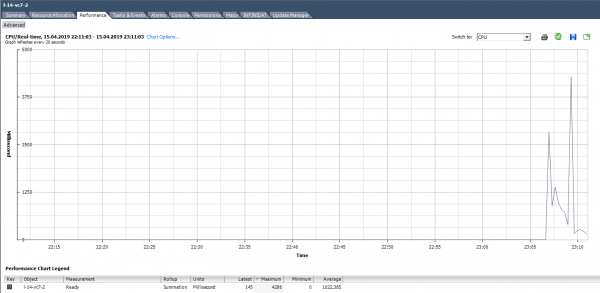
Beim Berechnen des Wertes von Ready in Prozent sollte auf zwei Punkte geachtet werden:
- Der Wert von Ready für die gesamte VM ist die Summe von Ready über die Kerne.
- Messintervall. Für die Echtzeit beträgt es 20 Sekunden, während es beispielsweise bei Tagesdiagrammen 300 Sekunden beträgt.
Bei aktivem Troubleshooting können diese einfachen Punkte leicht übersehen werden, wodurch wertvolle Zeit für die Lösung nicht existierender Probleme verloren gehen kann.
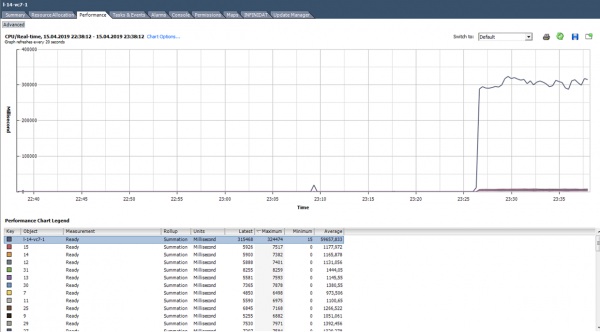
Berechnen wir Ready basierend auf den Daten aus dem nachstehenden Diagramm. (324474/(20*1000))*100 = 1622% für die gesamte VM. Wenn wir die Kerne betrachten, sieht es schon nicht so schlimm aus: 1622/64 = 25% pro Kern. In diesem Fall ist es recht einfach, einen Haken zu erkennen: Der Wert von Ready ist unrealistisch. Aber wenn es um 10–20% für die gesamte VM mit mehreren Kernen geht, kann der Wert pro Kern im Normbereich liegen.
Was tun? Ein hoher Wert für Ready weist darauf hin, dass dem Server CPU-Ressourcen für den normalen Betrieb der virtuellen Maschinen fehlen. In einer solchen Situation bleibt nur, die Überbuchung der CPU (vCPU:pCPU) zu reduzieren. Offensichtlich kann dies erreicht werden, indem die Parameter der bestehenden VMs verringert werden oder indem Teile der VMs auf andere Server migriert werden.
Co-stop
Wie analysieren? Dieser Zähler hat ebenfalls den Typ Summation und wird in Prozent ähnlich wie Ready umgerechnet:
(CPU co-stop Summationswert / (Standard-Updateintervall des Diagramms in Sekunden * 1000)) * 100 = CPU co-stop %
Hier sollte auch auf die Anzahl der Kerne in der VM und auf das Messintervall geachtet werden.
Im Zustand co-stop führt der Kern keine nützliche Arbeit aus. Bei richtiger Auswahl der VM-Größe und normaler Serverlast sollte der co-stop-Zähler nahe null liegen.
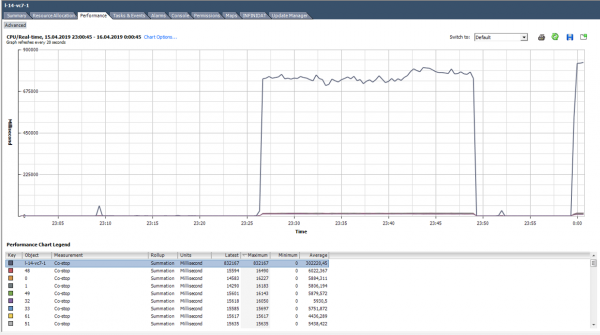
In diesem Fall ist die Last eindeutig abnormal :)
Was tun? Wenn mehrere VMs mit einer großen Anzahl von Kernen auf einem Hypervisor arbeiten und eine CPU-Überbuchung besteht, kann der co-stop-Zähler steigen, was zu Leistungsproblemen dieser VMs führen kann.
Der co-stop wird auch steigen, wenn für aktive Kerne einer VM Threads auf einem physischen Kern des Servers mit aktiviertem Hyper-Threading verwendet werden. Eine solche Situation kann auftreten, wenn die VM mehr Kerne hat, als physisch auf dem Server vorhanden sind, oder wenn die Einstellung „preferHT“ für die VM aktiviert ist. Über diese Einstellung kann man lesen .
Um Leistungsprobleme bei der VM aufgrund eines hohen co-stop zu vermeiden, wählen Sie die Größe der VM gemäß den Empfehlungen des Herstellers der Software, die auf dieser VM läuft, und gemäß den Möglichkeiten des physischen Servers, auf dem die VM läuft.
Fügen Sie keine Kerne zur Reserve hinzu, da dies nicht nur die Leistung der VM selbst, sondern auch die ihrer Nachbarn auf dem Server beeinträchtigen kann.
Weitere nützliche CPU-Metriken
Ausführen – wie viel Zeit (ms) vCPU während des Messerzeitraums im Zustand RUN war, also tatsächlich nützliche Arbeit verrichtet hat.
Idle – wie viel Zeit (ms) während des Messzeitraums vCPU im Leerlauf war. Hohe Leerlaufwerte sind kein Problem, sondern bedeuten nur, dass die vCPU "nichts zu tun hatte".
Warten – wie viel Zeit (ms) während des Messzeitraums vCPU im Wartezustand war. Da dieser Zähler auch IDLE umfasst, sagt ein hoher Wartewert ebenfalls nichts über ein Problem aus. Wenn jedoch der Wartewert hoch und der IDLE-Wert niedrig ist, bedeutet das, dass die VM auf den Abschluss von Ein-/Ausgabeoperationen wartete, was auf ein Leistungsproblem der Festplatte oder bestimmter virtueller Geräte der VM hindeuten kann.
Maximalgrenze – wie viel Zeit (ms) während des Messzeitraums vCPU im Bereit-Zustand wegen eines festgelegten Ressourcenlimits war. Wenn die Leistung unerklärlicherweise niedrig ist, ist es sinnvoll, diesen Zählerwert und das CPU-Limit in den VM-Einstellungen zu überprüfen. Es kann sein, dass der VM Limits zugewiesen wurden, von denen Sie nichts wissen. Dies geschieht beispielsweise, wenn die VM aus einer Vorlage geklont wurde, die ein CPU-Limit hatte.
Swap warten – wie viel Zeit während des Messzeitraums vCPU auf Operationen mit VMkernel Swap gewartet hat. Wenn dieser Zählerwert über null liegt, hat die VM definitiv Leistungsprobleme. Mehr zu SWAP erfahren Sie im Artikel über den Arbeitsspeicher-Zähler.
ESXTOP
Wenn die Leistungszähler in vCenter gut für die Analyse historischer Daten sind, ist die sofortige Analyse von Problemen besser in ESXTOP durchzuführen. Hier werden alle Werte in bearbeitbarer Form angezeigt (nichts muss übersetzt werden), und der minimale Messzeitraum beträgt 2 Sekunden.
Der ESXTOP-Bildschirm für CPU wird mit der Taste „c“ aufgerufen und sieht wie folgt aus:

Zur Vereinfachung können Sie nur die Prozesse der virtuellen Maschinen anzeigen, indem Sie Shift-V drücken.
Um die Metriken für einzelne Kerne der VM anzuzeigen, drücken Sie „e“ und geben Sie die GID der VM von Interesse (30919 im Screenshot unten) ein:
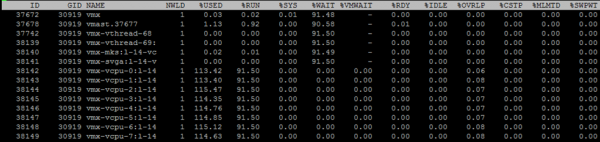
Ich werde kurz die standardmäßig dargestellten Spalten durchgehen. Weitere Spalten können hinzugefügt werden, indem Sie „f“ drücken.
NWLD (Anzahl der Welten) – die Anzahl der Prozesse in der Gruppe. Um die Gruppe zu erweitern und die Metriken für jeden Prozess (zum Beispiel für jeden Kern einer mehrkernigen VM) zu sehen, drücken Sie „e“. Wenn in der Gruppe mehr als ein Prozess vorhanden ist, sind die Metriken für die Gruppe gleich der Summe der Metriken für die einzelnen Prozesse.
%VERWENDET – wie viele CPU-Zyklen der Server von einem Prozess oder einer Gruppe von Prozessen verwendet wird.
%LAUFEN – wie viel Zeit der Prozess während des Messzeitraums im Zustand RUN verbracht hat, d.h. nützliche Arbeit geleistet hat. Unterscheidet sich von %USED, da es Hyper-Threading, Frequenzanpassung und die für Systemaufgaben (%SYS) aufgewendete Zeit nicht berücksichtigt.
%SYS – die für Systemaufgaben aufgewendete Zeit, z.B.: Bearbeitung von Interrupts, Ein-/Ausgabe, Netzwerkbetrieb etc. Der Wert kann hoch sein, wenn die VM viel Ein-/Ausgabe hat.
%OVRLP – wie viel Zeit das physische Kern, auf dem der VM-Prozess läuft, für Aufgaben anderer Prozesse aufgewendet hat.
Diese Metriken stehen in folgender Beziehung zueinander:
%USED = %RUN + %SYS — %OVRLP.
Normalerweise ist die Metrik %USED informativer.
%WAIT – wie viel Zeit der Prozess während des Messzeitraums im Zustand Wait verbracht hat. Dies schließt IDLE ein.
%IDLE – wie viel Zeit der Prozess während des Messzeitraums im Zustand IDLE verbracht hat.
%SWPWT – wie viel Zeit der vCPU während des Messzeitraums auf die VMkernel Swap-Operation gewartet hat.
%VMWAIT – wie viel Zeit der vCPU im Messzeitraum im Zustand des Wartens auf ein Ereignis (in der Regel Ein-/Ausgabe) verbrachte. Es gibt keinen ähnlichen Zähler in vCenter. Hohe Werte weisen auf Probleme mit der Ein-/Ausgabe auf der VM hin.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Wenn die VM keinen VMkernel Swap verwendet, ist es bei der Analyse von Leistungsproblemen sinnvoll, auf %VMWAIT zu schauen, da diese Metrik die Zeit, während der die VM nichts getan hat (%IDLE), nicht berücksichtigt.
%RDY – wie viel Zeit der Prozess während des Messzeitraums im Zustand Ready verbracht hat.
%CSTP – wie viel Zeit der Prozess während des Messzeitraums im Zustand costop verbracht hat.
%MLMTD – wie viel Zeit der vCPU während des Messzeitraums aufgrund einer festgelegten Ressourcengrenze im Zustand Ready verbracht hat.
%WAIT + %RDY + %CSTP + %RUN = 100% – der Kern der VM befindet sich ständig in einem dieser vier Zustände.
CPU auf dem Hypervisor
In vCenter gibt es auch Leistungszähler für die CPU des Hypervisors, aber diese sind nicht besonders interessant – es ist einfach die Summe der Zähler aller VMs auf dem Server.
Am besten lässt sich der Zustand der CPU auf dem Server auf der Zusammenfassungsseite anzeigen:
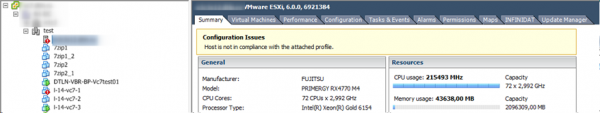
Für Server, genauso wie für virtuelle Maschinen, gibt es einen Standardalarm:
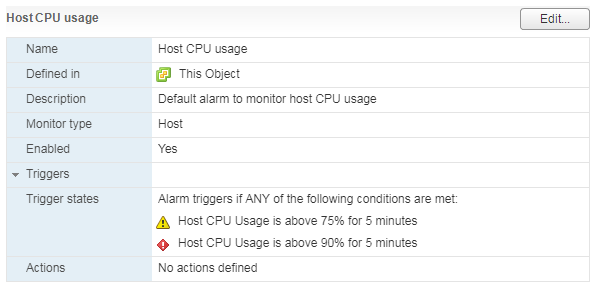
Bei hoher Last auf der CPU des Servers haben die darauf betriebenen VMs Probleme mit der Leistung.
In ESXTOP werden die CPU-Nutzungsdaten des Servers im oberen Bereich des Bildschirms angezeigt. Neben der standardmäßigen CPU-Auslastung, die für Hypervisoren wenig informativ ist, gibt es noch drei weitere Metriken:
CORE UTIL(%) – die Auslastung des Kerns des physischen Servers. Dieser Zähler zeigt, wie viel Zeit der Kern im Messzeitraum mit der Ausführung von Arbeit verbracht hat.
PCPU UTIL(%) – wenn Hyper-Threading aktiviert ist, hat jeder physische Kern zwei Threads (PCPU). Diese Metrik zeigt, wie viel Zeit jeder Thread mit der Ausführung von Arbeit beschäftigt war.
PCPU USED(%) – das Gleiche wie PCPU UTIL(%), berücksichtigt jedoch das Frequency Scaling (entweder Senkung der Kernfrequenz zum Energiesparen oder Erhöhung der Kernfrequenz durch die Turbo-Boost-Technologie) und Hyper-Threading.
PCPU_USED% = PCPU_UTIL% * effektive Kernfrequenz / nominelle Kernfrequenz.
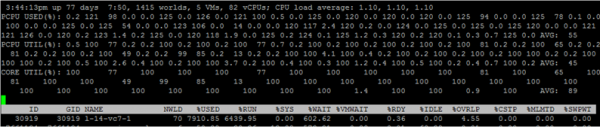
Auf diesem Screenshot ist der USED-Wert für einige Kerne aufgrund der Turbo-Boost-Funktion höher als 100%, da die Kernfrequenz über der nominellen liegt.
Ein paar Worte dazu, wie Hyper-Threading berücksichtigt wird. Wenn Prozesse 100% der Zeit auf beiden Threads des physischen Serverkerns ausgeführt werden und der Kern mit nomineller Frequenz arbeitet, dann:
- Wird die CORE UTIL für den Kern 100% betragen,
- Wird die PCPU UTIL für beide Threads 100% betragen,
- Wird die PCPU USED für beide Threads 50% betragen.
Wenn beide Threads nicht 100% der Zeit im Messzeitraum gearbeitet haben, wird die PCPU USED für die Kerne in den Zeiträumen, in denen die Threads parallel arbeiteten, halbiert.
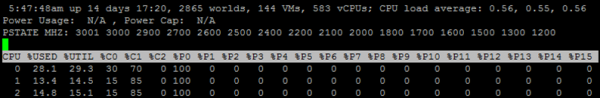
In ESXTOP gibt es auch einen Bildschirm mit den Energiemesswerten der CPU des Servers. Hier kann man sehen, ob der Server Energiespartechnologien verwendet: C-Stati und P-Stati. Der Bildschirm wird mit der Taste „p“ aufgerufen:
Standardprobleme bei der CPU-Leistung
Zum Schluss gehe ich kurz auf typische Ursachen von Leistungproblemen bei CPU-VMs ein und gebe kurze Tipps zur Behebung:
Zu wenig Kernfrequenz. Wenn es nicht möglich ist, die VM auf leistungsstärkere Kerne zu übertragen, kann man versuchen, die Energieeinstellungen zu ändern, damit Turbo Boost effektiver arbeitet.
Falsches Sizing der VM (zu viele/wenige Kerne). Wenn zu wenige Kerne zugewiesen werden, wird die CPU-Auslastung der VM hoch sein. Wenn zu viele vorhanden sind, gibt es hohen Co-Stop.
Eine hohe Überbuchung der CPU auf dem Server. Wenn die VM eine hohe Ready-Zeit hat, senken Sie die CPU-Überbuchung.
Falsche NUMA-Topologie bei großen VMs. Die NUMA-Topologie, die die VM sieht (vNUMA), muss der NUMA-Topologie des Servers (pNUMA) entsprechen. Über die Diagnose und mögliche Lösungen dieses Problems wird beispielsweise im Buch geschrieben . Wenn Sie sich nicht vertiefen möchten und keine Lizenzbeschränkungen für das auf der VM installierte Betriebssystem haben, erstellen Sie auf der VM viele virtuelle Sockel mit einem Kern. Viel verlieren Sie nicht 🙂
Das wäre es von meiner Seite zum Thema CPU. Stellen Sie Fragen. Im nächsten Teil werde ich über den Arbeitsspeicher sprechen.
Nützliche Links
Quelle: habr.com
