

Hallo, ich bin Dmitri Logwinenko – Data Engineer in der Analyseabteilung der Unternehmensgruppe „Vezët“.
Ich werde Ihnen ein bemerkenswertes Werkzeug zur Entwicklung von ETL-Prozessen vorstellen – Apache Airflow. Aber Airflow ist so vielseitig und facettenreich, dass es sich lohnt, auch dann einen Blick darauf zu werfen, wenn Sie nicht mit Datenströmen arbeiten und nur gelegentlich Prozesse starten und deren Ausführung überwachen möchten.
Und ja, ich werde nicht nur erzählen, sondern auch zeigen: Das Programm enthält viel Code, Screenshots und Empfehlungen.
Was man normalerweise sieht, wenn man das Wort Airflow googelt / Wikimedia Commons
Inhaltsverzeichnis
Einführung
Apache Airflow – sozusagen wie Django:
- geschrieben in Python,
- mit einer hervorragenden Administrationsoberfläche,
- unbegrenzt erweiterbar,
— nur besser, und für ganz andere Zwecke gemacht, nämlich (wie in der Einführung geschrieben):
- starten und überwachen von Aufgaben auf einer unbegrenzten Anzahl von Maschinen (so viel wie Celery/Kubernetes und Ihr Gewissen zulassen)
- mit dynamischer Generierung von Workflows aus sehr einfach zu schreibendem und verständlichem Python-Code
- und der Möglichkeit, beliebige Datenbanken und APIs mithilfe sowohl fertiger Komponenten als auch selbstgebauter Plugins (was äußerst einfach ist) zu verknüpfen.
Wir nutzen Apache Airflow so:
- wir sammeln Daten aus verschiedenen Quellen (zahlreiche Instanzen von SQL Server und PostgreSQL, verschiedene APIs mit Anwendungsmetriken, sogar 1C) in DWH und ODS (bei uns ist das Vertica und Clickhouse).
- wie ein fortgeschrittener
Cron, der Prozesse zur Konsolidierung von Daten im ODS startet und deren Wartung überwacht.
Bis vor kurzem deckte ein kleiner Server mit 32 Kernen und 50 GB RAM unsere Bedürfnisse ab. In Airflow laufen dabei:
- mehr als 200 DAGs (das sind die Workflows, in die wir Aufgaben eingegeben haben),
- im Durchschnitt werden pro DAG 70 Aufgaben,
- ausgeführt (auch im Durchschnitt) einmal pro Stunde.
Und wie wir uns erweitert haben, werde ich unten schreiben, jetzt lassen Sie uns die Hauptaufgabe definieren, die wir angehen werden:
Es gibt drei SQL Server, auf jedem mit 50 Datenbanken – Instanzen eines Projekts, entsprechend haben sie eine nahezu identische Struktur (fast überall, muahaha), was bedeutet, dass jede eine Tabelle Orders hat (zum Glück kann man eine Tabelle mit diesem Namen in jedes Geschäft drücken). Wir ziehen Daten ab, indem wir zusätzliche Felder (Quellserver, Quell-Datenbank, ETL-Aufgaben-ID) hinzufügen und werfen sie naiv in, sagen wir, Vertica.
Los geht's!
Der Hauptteil, praktisch (und ein wenig theoretisch)
Warum es uns (und Ihnen) nützt
Als die Bäume groß waren und ich ein einfacher SQL-arbeiter in einem russischen Einzelhandel war, haben wir ETL-Prozesse aka Datenströme mit Hilfe von zwei uns zur Verfügung stehenden Mitteln durchgeführt:
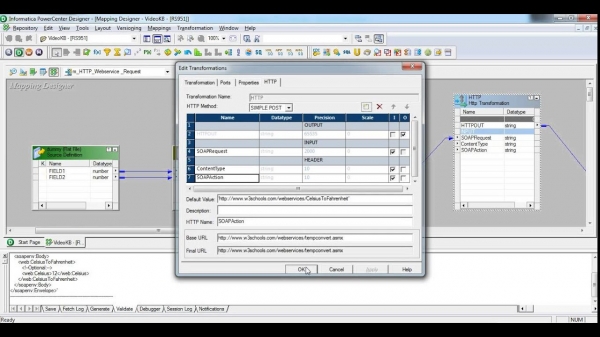
- Informatica Power Center — ein äußerst umfangreiches System, extrem leistungsstark, mit eigener Hardware und eigener Versionierung. Ich habe vielleicht 1 % seiner Möglichkeiten genutzt. Warum? Nun, erstens hat diese Benutzeroberfläche irgendwo aus den Nullerjahren uns psychisch unter Druck gesetzt. Zweitens ist dieses Ding für extrem komplexe Prozesse, leidenschaftliche Wiederverwendung von Komponenten und andere sehr wichtige Enterprise-Features ausgelegt. Über den Preis, der so hoch ist wie das Flügel eines Airbus A380 pro Jahr, schweigen wir.
Achtung, der Screenshot könnte jüngeren Menschen unter 30 etwas weh tun

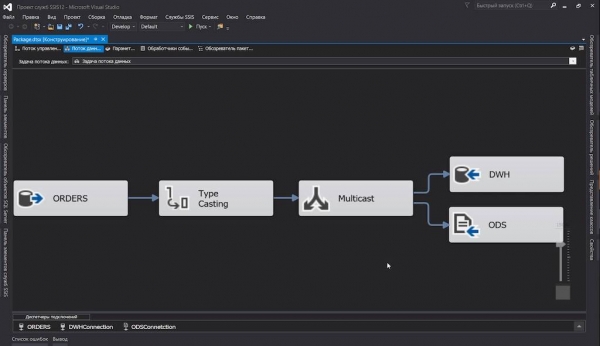
- SQL Server Integration Server — mit diesem Teil haben wir in unseren internen Projektströmen gearbeitet. Nun ja, warum auch nicht: Wir verwenden bereits SQL Server, und es wäre irgendwie unvernünftig, seine ETL-Tools nicht zu nutzen. Alles ist gut daran: die Benutzeroberfläche ist schön, die Ausführungsberichte… Aber nicht dafür lieben wir Softwareprodukte, ach nein, nicht dafür. Es ist möglich, es zu versionieren
dtsx(das einen XML-Dokument darstellt, dessen Knoten beim Speichern gemischt werden) können wir, aber was bringt es? Und ein Paket von Tasks zu erstellen, das hundert Tabellen von einem Server auf einen anderen zieht? Bei hundert stellen Sie fest, dass Ihnen von zwanzig Stück der Zeigefinger abfällt, der auf die Maustaste klickt. Aber es sieht definitiv modischer aus:
Wir haben definitiv nach Auswegen gesucht. Es kam sogar soweit, dass wir einen selbstgeschriebenen SSIS-Paket-Generator hatten… fast ... und dann fand mich ein neuer Job. Und dort sichtete mich Apache Airflow.
Als ich erfuhr, dass die Beschreibungen von ETL-Prozessen einfacher Python-Code sind, hätte ich fast einen Freudentanz aufgeführt. So unterzogen sich die Datenströme der Versionierung und Diff und es wurde zur Angelegenheit von ein oder zwei 13”-Bildschirmen, Tabellen mit identischer Struktur aus Hunderten von Datenbanken in ein Ziel zu werfen.
Als ich herausfand, dass die Beschreibungen von ETL-Prozessen einfacher Python-Code sind, hätte ich fast vor Freude getanzt. So wurden Datenströme versioniert und diffundiert, und es wurde zur Aufgabe von Python-Code, Tabellen mit einer einheitlichen Struktur aus Hunderten von Datenbanken auf einem einzigen Ziel zu konsolidieren, und das auf einem 13-Zoll-Bildschirm.
Wir bauen einen Cluster auf
Lass uns keinen kindischen Kindergarten veranstalten und nicht über absolut offensichtliche Dinge sprechen, wie die Einrichtung von Airflow, der von Ihnen gewählten Datenbank, Celery und anderen in den Dokumenten beschriebenen Themen.
Damit wir sofort mit den Experimenten beginnen können, habe ich skizziert, docker-compose.yml in dem:
- Lass uns im Grunde Airflow: Scheduler, Webserver. Dort wird auch Flower zur Überwachung von Celery-Tasks laufen (weil es bereits in
apache/airflow:1.10.10-python3.7, und wir sind nicht dagegen); - PostgreSQL, in dem Airflow seine Betriebsinformationen (Planerdaten, Ausführungsstatistiken usw.) speichern wird, während Celery die abgeschlossenen Tasks vermerkt;
- Redis, der als Task-Broker für Celery fungieren wird;
- Celery-Arbeiter, der sich mit der direkten Ausführung der Aufgaben beschäftigt.
- In den Ordner
./dagswerden wir unsere Dateien mit der Beschreibung der Dags ablegen. Sie werden zur Laufzeit erfasst, daher ist es nicht notwendig, den gesamten Stack nach jedem kleinen Ereignis neu zu starten.
An einigen Stellen ist der Code in den Beispielen nicht vollständig angegeben (um den Text nicht zu überladen), an anderen Stellen wird er im Verlauf modifiziert. Funktionierende, komplette Codebeispiele können im Repository eingesehen werden. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis als Celery-Broker
  broker:
    image: redis:6.0.5-alpine

  # DB für die Airflow-Metadaten
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Hauptcontainer mit Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery-Arbeiter, wird mit `--scale=n` skaliert
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Hinweise:
- Bei meiner Komposition habe ich mich stark auf das bekannte Image gestützt – unbedingt ansehen. Vielleicht benötigen Sie im Leben nichts anderes.
- Alle Airflow-Einstellungen sind nicht nur über
airflow.cfg, sondern auch über Umgebungsvariablen (Danke an die Entwickler), weshalb ich sie großzügig genutzt habe. - Natürlich ist es nicht produktionsbereit: Ich habe absichtlich keine Heartbeats für die Container gesetzt und mich nicht um Sicherheit gekümmert. Aber das Minimum, das für unsere Experimente geeignet ist, habe ich geschaffen.
- Bitte beachten Sie, dass:
- Der Ordner mit den DAGs muss sowohl für den Scheduler als auch für die Worker zugänglich sein.
- Das gleiche gilt für alle Drittanbieter-Bibliotheken – sie müssen auf den Maschinen mit dem Scheduler und den Workern installiert sein.
Und jetzt ganz einfach:
$ docker-compose up --scale worker=3Nachdem alles gestartet ist, können Sie sich die Webinterfaces ansehen:
- Airflow:
- Flower:
Grundbegriffe
Wenn Sie all diese „DAGs“ nicht verstanden haben, hier ist ein kurzer Begriffskatalog:
- Scheduler — der wichtigste Verantwortliche in Airflow, der dafür sorgt, dass Roboter arbeiten und nicht Menschen: er überwacht den Zeitplan, aktualisiert die DAGs und startet die Tasks.
Früher hatte er in älteren Versionen Probleme mit dem Speicher (nein, keine Amnesie, sondern Speicherlecks) und in den Konfigurationen gab es sogar einen Legacy-Parameter
run_duration— das Intervall seiner Neustarts. Aber jetzt ist alles in Ordnung. - DAG (auch „dag“) — „gerichteter azyklischer Graph“, aber diese Definition sagt den meisten wenig, und im Grunde ist es ein Container für miteinander interagierende Tasks (siehe unten) oder das Pendant zu Package in SSIS und Workflow in Informatica.
Neben DAGs kann es auch Sub-DAGs geben, aber wir werden wahrscheinlich nicht zu ihnen gelangen.
- DAG Run — ein initialisierter DAG, dem ein
execution_datezugewiesen wurde. DAG-Runs eines DAGs können durchaus parallel laufen (wenn Sie Ihre Tasks natürlich idempotent gestaltet haben). - Operator — das sind Codebausteine, die für die Ausführung einer bestimmten Aktion verantwortlich sind. Es gibt drei Typen von Operatoren:
- Aktion, wie beispielsweise unser Lieblings-
PythonOperator, der in der Lage ist, jeden (gültigen) Python-Code auszuführen; - transfer, die Daten von einem Ort zum anderen transportieren, sagen wir,
MsSqlToHiveTransfer; - sensor wird es ermöglichen, auf bestimmte Ereignisse zu reagieren oder die weitere Ausführung des DAGs bis zum Eintreten eines bestimmten Ereignisses zu verlangsamen.
HttpSensorkann einen angegebenen Endpunkt abfragen, und wenn die benötigte Antwort eintrifft, den Transfer startenGoogleCloudStorageToS3Operator. Ein neugieriger Verstand könnte fragen: „Warum? Schließlich kann man Wiederholungen direkt im Operator durchführen!“ Und zwar, um den Task-Pool nicht mit hängenden Operatoren zu belasten. Der Sensor wird aktiviert, prüft und stirbt bis zum nächsten Versuch.
- Aktion, wie beispielsweise unser Lieblings-
- Task — deklarierte Operatoren, unabhängig vom Typ, die dem DAG zugeordnet sind, erlangen den Rang eines Tasks.
- Task instance — wenn der Haupt-Planer entscheidet, dass die Tasks zu den Arbeitsausführenden geschickt werden sollen (direkt vor Ort, wenn wir den
LocalExecutoroder auf einen Remote-Knoten im Falle desCeleryExecutor), weist er ihnen einen Kontext zu (d. h. ein Set von Variablen – Ausführungsparametern), entfaltet die Befehlsvorlagen oder Abfragen und fügt sie in den Pool ein.
Wir generieren Aufgaben
Zuerst skizzieren wir das allgemeine Schema unseres DAGs, und dann werden wir immer mehr ins Detail gehen, denn wir wenden einige nicht triviale Lösungen an.
Also, in einfachster Form könnte ein solcher DAG so aussehen:
von datetime import timedelta, datetime

von airflow import DAG
von airflow.operators.python_operator import PythonOperator

von commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

für conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Lass uns herausfinden:
- Zuerst importieren wir die benötigten Bibliotheken und ein paar weitere Dinge;
sql_server_dssindListe[namedtuple[str, str]]mit den Namen der Verbindungen aus Airflow Connections und den Datenbanken, aus denen wir unsere Tabelle abholen werden;dagist die Deklaration unseres DAGs, die unbedingt inglobals(), sonst findet Airflow ihn nicht. Zudem muss dem DAG gesagt werden:- wie er heißt
ordersdieser Name wird dann im Webinterface angezeigt, - dass er ab Mitternacht am 8. Juli arbeiten wird,
- und dass er ungefähr alle 6 Stunden gestartet werden soll (für die coolen Jungs ist hier anstelle von
timedelta()auchCron-String0 0 0/6 ? * * *, für weniger coole die Ausdrucksweise wie@daily);
- wie er heißt
workflow()wird die Hauptarbeit erledigen, aber nicht jetzt. Jetzt werden wir einfach unseren Kontext im Log ausgeben.- Und jetzt zur einfachen Magie der Erstellung von Tasks:
- gehen wir durch unsere Quellen;
- initialisieren wir
PythonOperator, das unsere Dummy-Implementierung ausführtworkflow(). Vergessen Sie nicht, einen einzigartigen (im Rahmen des DAGs) Task-Namen anzugeben und den DAG zu verknüpfen. Das Flagprovide_contextwird in der Funktion zusätzliche Argumente bereitstellen, die wir sorgfältig mit Hilfe von**context.
gesammelt haben. Das war's vorerst. Was haben wir erhalten:
- einen neuen DAG im Webinterface,
- anderthalb Hundert Tasks, die parallel ausgeführt werden (wenn es die Einstellungen von Airflow, Celery und die Serverkapazitäten erlauben).
Nun, fast erhalten.
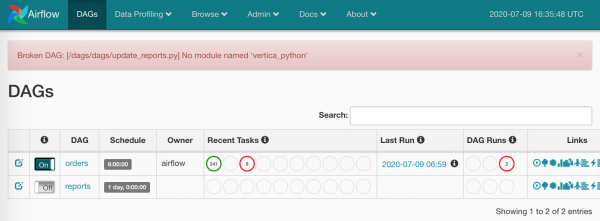
Wer kümmert sich um die Abhängigkeiten?
Um das Ganze zu vereinfachen, habe ich sie in die docker-compose.yml Verarbeitung requirements.txt auf allen Nodes integriert.
Jetzt geht's los:
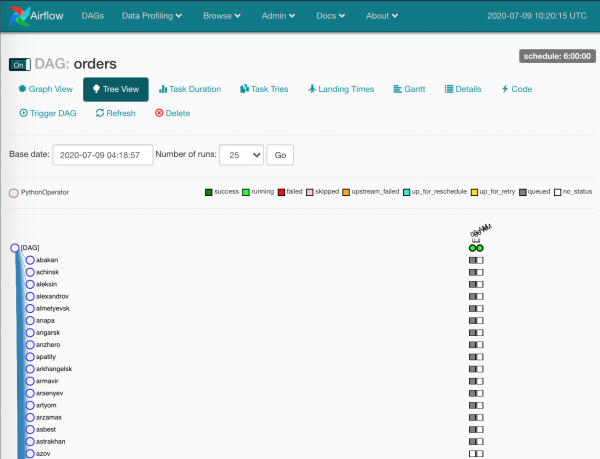
Graue Kästchen – Task-Instanzen, die vom Scheduler bearbeitet werden.
Wir warten kurz, die Worker übernehmen die Aufgaben:
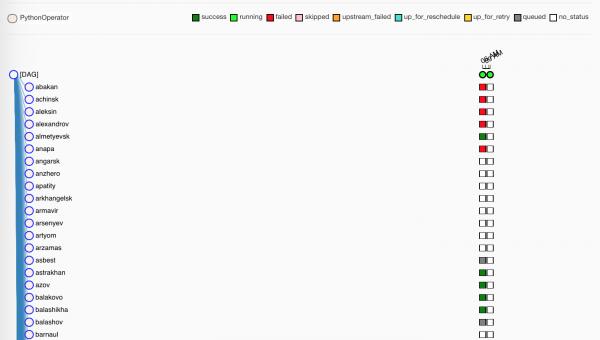
Grüne, das ist klar, – erfolgreich abgeschlossen. Rote – nicht ganz erfolgreich.
Übrigens, auf unserem Produktivsystem gibt es keinen Ordner,
./dagsder zwischen den Maschinen synchronisiert wird – alle DAGs liegen ingitin unserem Gitlab, und Gitlab CI verteilt Updates auf die Maschinen beim Mergen inmaster.
Ein wenig über Flower
Während die Worker unsere Dummy-Tasks abarbeiten, erinnern wir uns an ein weiteres Werkzeug, das uns einiges zeigen kann – Flower.
Die erste Seite mit zusammenfassenden Informationen zu den Worker-Nodes:
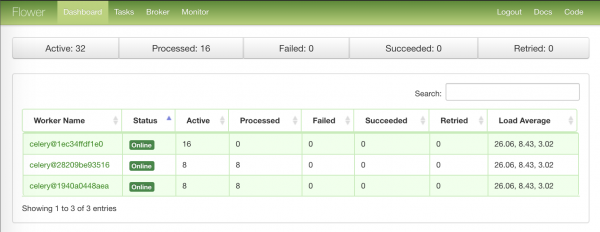
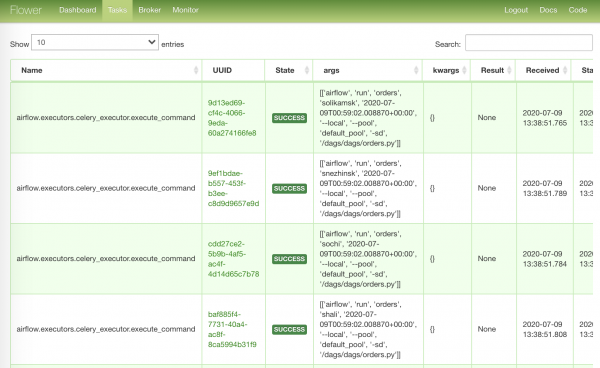
Die informativste Seite mit Aufgaben, die in Arbeit gegangen sind:
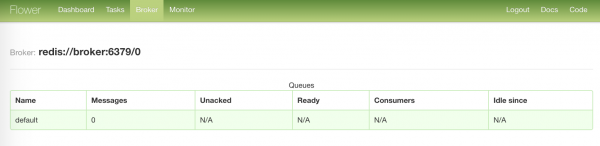
Die langweiligste Seite mit dem Status unseres Brokers:
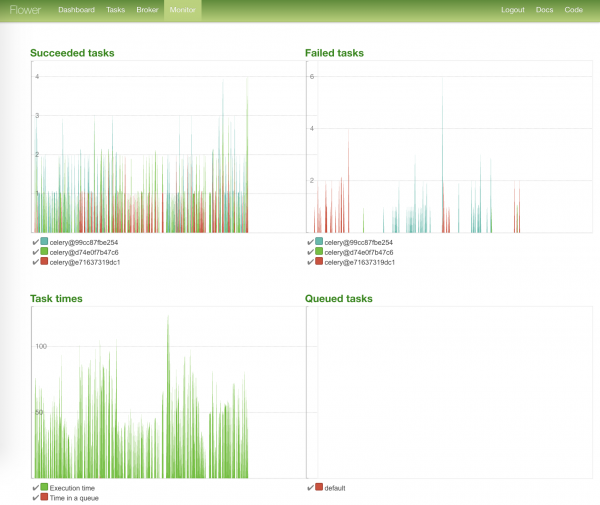
Die eindrucksvollste Seite – mit Diagrammen zum Status der Aufgaben und deren Ausführungszeiten:
Nachladen, was nicht vollständig geladen wurde
So, alle Aufgaben haben gearbeitet, wir können die Verletzten abtransportieren.
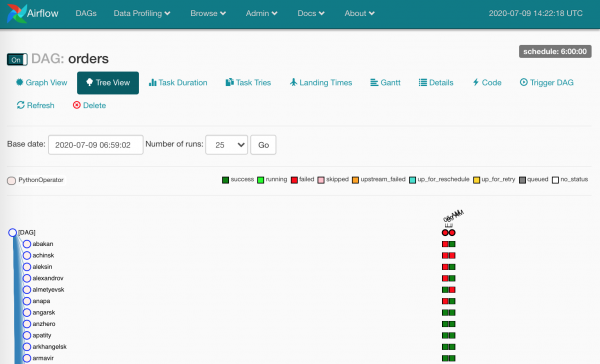
Und es gab zahlreiche Verletzte – aus den unterschiedlichsten Gründen. Im Falle der korrekten Nutzung von Airflow zeigen diese Quadrate, dass die Daten eindeutig nicht angekommen sind.
Es ist notwendig, das Protokoll zu überprüfen und die fehlgeschlagenen Task-Instanzen neu zu starten.
Wenn wir auf ein beliebiges Quadrat klicken, sehen wir die uns zur Verfügung stehenden Aktionen:
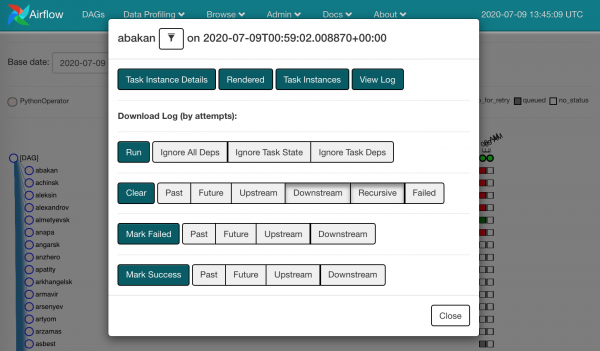
Wir können die fehlgeschlagene Aufgabe löschen. Das bedeutet, wir vergessen, dass dort etwas fehlerhaft war, und dieselbe Task-Instanz wird wieder an den Planer übergeben.
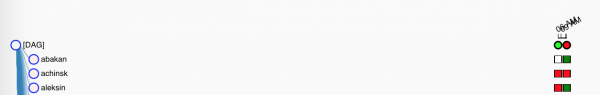
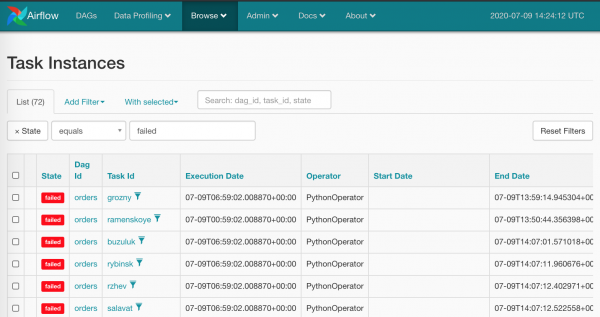
Es ist klar, dass es nicht sehr human ist, mit der Maus bei allen roten Quadraten so zu verfahren – das erwarten wir nicht von Airflow. Natürlich haben wir eine Massenvernichtungswaffe: Browse/Task Instances
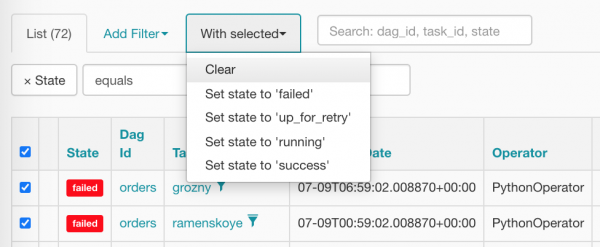
Wir wählen alles auf einmal aus und klicken auf den richtigen Punkt 'Zurücksetzen':
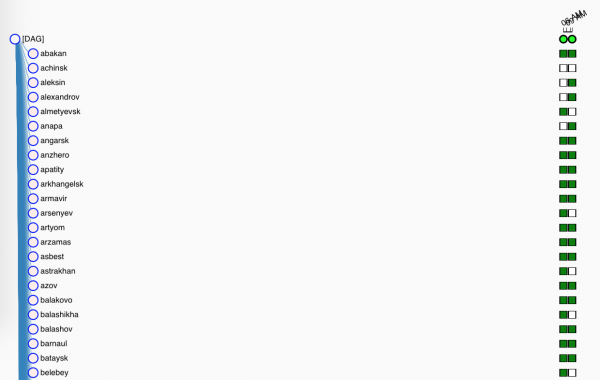
Nach der Bereinigung sehen unsere Aufgaben so aus (sie können es kaum erwarten, dass der Planer sie einplant):
Verbindungen, Hooks und andere Variablen
Es ist höchste Zeit, den nächsten DAG anzusehen, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Sehr geehrte Damen und Herren, die Berichte wurden aktualisiert"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natash, wach auf, wir haben {{ dag.dag_id }} fallen lassen
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Hat nicht jeder irgendwann die Berichterstattung aktualisiert? Es ist wieder so weit: Es gibt eine Liste von Quellen, von wo die Daten abgerufen werden; es gibt eine Liste, wohin sie gelegt werden sollen; vergessen Sie nicht zu signalisieren, wenn alles passiert ist oder kaputtgegangen ist (nun, das betrifft uns nicht, nicht wahr?).
Lassen Sie uns die Datei erneut durchgehen und uns die neuen unverständlichen Dinge ansehen:
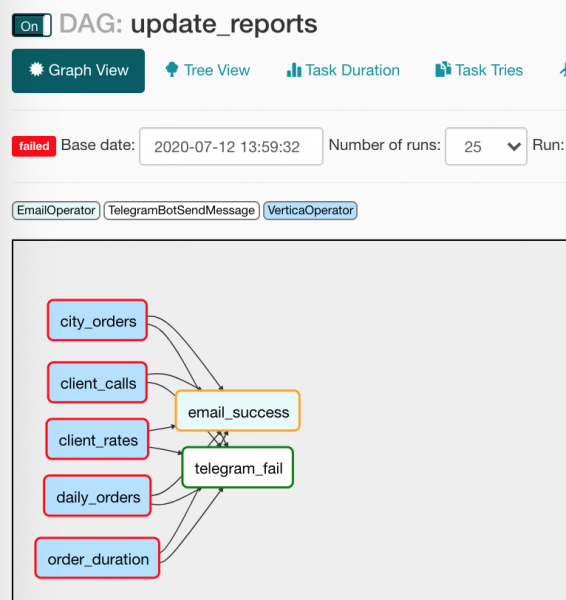
from commons.operators import TelegramBotSendMessage— es gibt nichts, was uns daran hindert, unsere eigenen Operatoren zu erstellen, und genau das haben wir getan, indem wir eine kleine Wrapper-Funktion zum Senden von Nachrichten an Unblockiert erstellt haben. (Über diesen Operator werden wir weiter unten sprechen);default_args={}— der DAG kann dieselben Argumente an alle seine Operatoren weitergeben;to='{{ var.value.all_the_kings_men }}'— das Feldtowird nicht hartkodiert sein, sondern dynamisch mit Jinja und einer Variablen mit einer Liste von E-Mail-Adressen, die ich sorgsam inAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— die Bedingung für den Start des Operator. In unserem Fall wird die E-Mail an die Chefs gesendet, nur wenn alle Abhängigkeiten erfolgreich ausgeführt wurden. erfolgreich;tg_bot_conn_id='tg_main'— die Argumenteconn_idnehmen die Identifikatoren der Verbindungen auf, die wir inAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— Nachrichten in Telegram werden nur verschickt, wenn es fehlgeschlagene Aufgaben gibt;task_concurrency=1— wir verbieten die gleichzeitige Ausführung mehrerer Task-Instanzen einer Aufgabe. Andernfalls würden wir mehrere gleichzeitig erhalten,VerticaOperator(die auf dieselbe Tabelle schauen);report_update >> [email, tg]— alleVerticaOperatorwerden sich beim Versenden der E-Mail und der Nachricht so zusammenschließen:

Da die benachrichtigenden Operatoren unterschiedliche Startbedingungen haben, wird nur einer funktionieren. In der Baumansicht sieht alles etwas weniger übersichtlich aus:

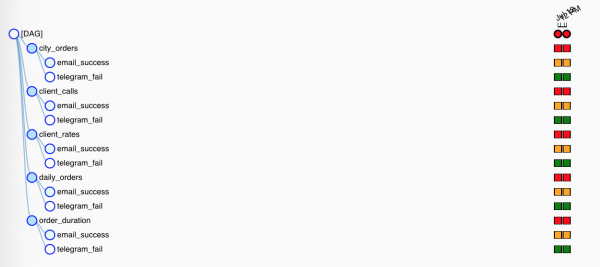
Ich möchte ein paar Worte über Makros und deren Freunde verlieren — von Variablen.
Makros sind Jinja-Platzhalter, die unterschiedliche nützliche Informationen in die Argumente der Operatoren einfügen können. Zum Beispiel so:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} wird in den Inhalt der Kontextvariablen aufgelöst execution_date im Format YYYY-MM-DD: 2020-07-14. Das Angenehme ist, dass die Kontextvariablen an eine bestimmte Instanz der Aufgabe (das Quadrat in der Baumansicht) gebunden sind und beim Neustart entpacken sich die Platzhalter in dieselben Werte.
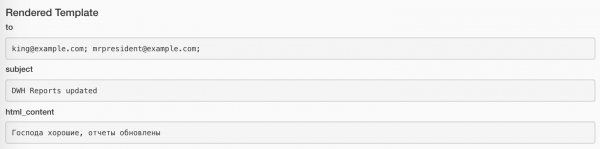
Die zugewiesenen Werte können mit der Schaltfläche Rendered bei jeder Task-Instanz angezeigt werden. So sieht es beim Task für den E-Mail-Versand aus:
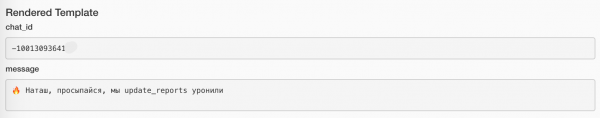
Und so sieht es beim Task für das Senden der Nachricht aus:
Die vollständige Liste der integrierten Makros für die zuletzt verfügbare Version finden Sie hier:
Darüber hinaus können wir mit Plugins eigene Makros deklarieren, aber das ist eine ganz andere Geschichte.
Neben den vordefinierten Elementen können wir auch Werte unserer Variablen einsetzen (ich habe das oben im Code bereits genutzt). Lassen Sie uns in Admin/Variables ein paar Elemente erstellen:
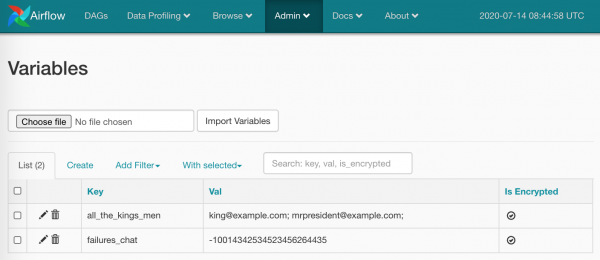
Alles klar, Sie können jetzt verwenden:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Im Wert kann ein Skalar sein, oder auch JSON. Im Falle von JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
wir verwenden einfach den Pfad zum benötigten Schlüssel: {{ var.json.bot_config.bot.token }}.
Ich sage wörtlich nur ein Wort und zeige einen Screenshot über Verbindungen. Hier ist alles ganz einfach: Auf der Seite Admin/Connections erstellen wir eine Verbindung, fügen unsere Logins/Passwörter und spezifischere Parameter hinzu. So:
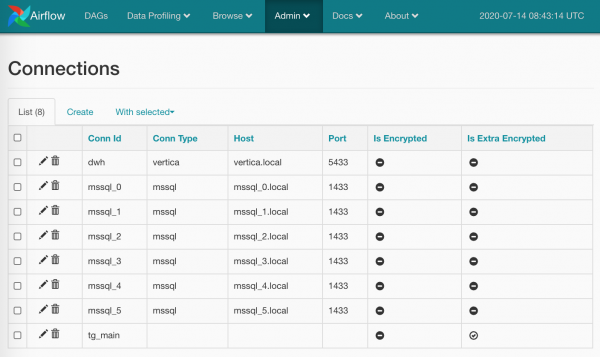
Passwörter können verschlüsselt werden (gründlicher als in der Standardvariante) oder der Verbindungstyp kann nicht angegeben werden (wie ich es für tg_main) gemacht habe - der Punkt ist, dass die Liste der Typen in den Airflow-Modellen eingebettet ist und nicht ohne Eingriff in den Quellcode erweitert werden kann (falls ich etwas nicht gefunden habe - bitte korrigieren Sie mich), aber es wird uns nicht daran hindern, die Anmeldeinformationen einfach nach Namen zu erhalten.
Außerdem können mehrere Verbindungen mit dem gleichen Namen erstellt werden: In diesem Fall wird die Methode BaseHook.get_connection(), die uns Verbindungen nach Namen holt, uns eine zufällige aus mehreren Namensvettern zurückgeben (es wäre logischer, Round Robin zu machen, aber das überlassen wir den Entwicklern von Airflow).
Variablen und Verbindungen sind zweifellos großartige Mittel, aber es ist wichtig, das Gleichgewicht nicht zu verlieren: Welche Teile Ihrer Workflows speichern Sie tatsächlich im Code und welche überlassen Sie Airflow. Einerseits kann es praktisch sein, Werte wie die Mailing-Adresse schnell über die Benutzeroberfläche zu ändern. Anderseits ist es jedoch ein Rückschritt zu Click-Workflow, von dem wir (ich) uns verabschieden wollen.
Arbeiten mit Verbindungen ist eine der Aufgaben Hooks. Generell sind Airflow-Hooks Anschlussstellen zu externen Diensten und Bibliotheken. Zum Beispiel JiraHook öffnet für uns einen Client zur Interaktion mit Jira (wir können Aufgaben hin und her bewegen), während wir mit Hilfe von SambaHook eine lokale Datei in die smb-Stelle pushen können.
Wir bearbeiten einen benutzerdefinierten Operator
Und wir sind nun bereit, einen Blick darauf zu werfen, wie TelegramBotSendMessage
Code commons/operators.py mit dem eigentlichen Operator umgesetzt ist:
von typing import Union

von airflow.operators import BaseOperator

von commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Nachricht an chat_id mit TelegramBotHook senden

    Beispiel:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} fehlgeschlagen :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Sende "{self.message}" an den Chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Hier ist, wie alles andere in Airflow, alles sehr einfach:
- Wir haben von
BaseOperatorvererbt, der viele Airflow-spezifische Dinge implementiert (sehen Sie sich das in Ihrer Freizeit an) - Wir haben die Felder
template_fieldsdeklariert, in denen Jinja nach Makros zur Verarbeitung suchen wird. - Wir haben die richtigen Argumente für
__init__()organisiert und dort, wo nötig, Standardwerte gesetzt. - Wir haben auch an die Initialisierung des Vorgängers gedacht.
- Wir haben den entsprechenden Hook geöffnet
TelegramBotHookund das Client-Objekt von ihm erhalten. - Wir haben die Methode
BaseOperator.execute()überschrieben, die Airflow aufrufen wird, wenn es Zeit ist, den Operator auszuführen – darin implementieren wir die Hauptaktion, ohne das Logging zu vergessen. (Wir loggen uns übrigens direkt instdoutundstderr– Airflow wird alles abfangen, schön verpacken und dort ablegen, wo es hingehört.)
Lassen Sie uns sehen, was wir in commons/hooks.pyhaben. Der erste Teil der Datei, mit dem Hook selbst:
von typing import Union

von airflow.hooks.base_hook import BaseHook
von requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API Hook

    Hinweis: Fügen Sie eine Verbindung mit leerem Verbindungstyp hinzu und vergessen Sie nicht,
    Extra auszufüllen:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Ich weiß nicht einmal, was ich hier erklären soll, ich möchte nur auf wichtige Punkte hinweisen:
- Wir erben, denken über die Argumente nach – in den meisten Fällen wird es nur eines sein:
conn_id; - Wir überschreiben die Standardmethoden: Ich habe mich auf
get_conn()beschränkt, in der ich die Verbindungseinstellungen nach Namen erhalte und ganz einfach den Abschnittextra(dieses Feld für JSON), in dem ich (laut meiner eigenen Anweisung!) das Token des Telegram-Bots eingegeben habe:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Ich erstelle eine Instanz unseres
TelegramBots, wobei ich ihm bereits ein konkretes Token gebe.
Das ist alles. Den Client aus dem Hook kann man mit Hilfe von TelegramBotHook().client oder TelegramBotHook().get_conn().
Und der zweite Teil der Datei, in dem ich ein Mikro-Wrapper für die Telegram REST API mache, um nicht denselben nur für eine Methode sendMessage.
class TelegramBot:
    """Telegram Bot API Wrapper

    Beispiele:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hallo, Liebling')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hallo, Liebling', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Der richtige Weg ist, all dies zu bündeln:
TelegramBotSendMessage,TelegramBotHook,TelegramBots— in ein Plugin zu packen, es in ein öffentliches Repository zu stellen und es Open Source zu machen.
Während wir das alles durchgegangen sind, sind unsere Bericht-Updates erfolgreich abgestürzt und haben mir eine Fehlermeldung in den Kanal gesendet. Ich werde überprüfen, was wieder falsch ist...
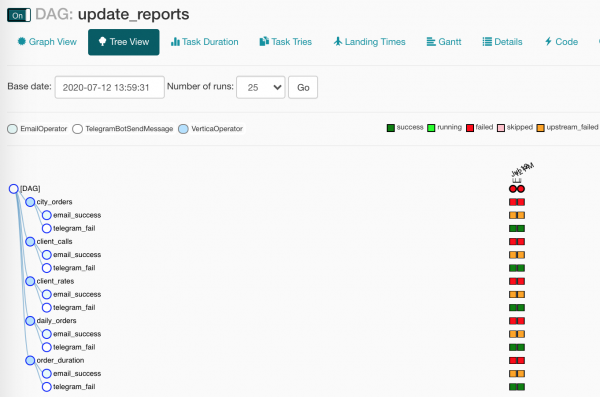
In unserem DAG ist etwas kaputt! Ist das nicht das, was wir erwartet haben? Genau!
Wirst du einschenken?
Fühlen Sie, dass ich etwas übersehen habe? Ich habe doch versprochen, Daten von SQL Server nach Vertica zu übertragen, und dann bin ich vom Thema abgekommen, der Schurke!
Das war ein absichtliches Vergehen, ich musste Ihnen einfach einige Begriffe erklären. Jetzt können wir fortfahren.
Unser Plan war folgender:
- Einen DAG erstellen
- Tasks generieren
- Schauen, wie alles schön aussieht
- Sessions-IDs für die Uploads zuweisen
- Daten aus SQL Server abholen
- Daten in Vertica ablegen
- Statistiken sammeln
Um all dies zu starten, habe ich eine kleine Erweiterung zu unserem docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Dort haben wir folgende Elemente:
- Vertica als Host
dwhmit den Standard-Einstellungen, - drei Instanzen des SQL Servers,
- füllen die Datenbanken mit einigen aktuellen Informationen (bitte schauen Sie auf keinen Fall in die
mssql_init.py!)
Starten Sie alles mit einem etwas komplexeren Befehl als beim letzten Mal:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Was unser wunderbarer Randomizer generiert hat, kann man mithilfe des Punkts Data Profiling/Ad Hoc Query:
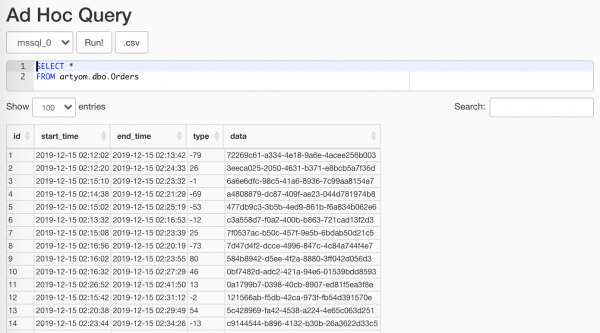
Hauptsache, dies den Analysten nicht zu zeigen.
Auf die ETL-Sitzungen werde ich nicht näher eingehen, da ist alles trivial: Wir erstellen eine Datenbank, darin eine Tabelle, umwickeln alles mit einem Kontextmanager und machen jetzt Folgendes:
with Session(task_name) as session:
    print('Laden', session.id, 'gestart')

    # Lade Workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
from sys import stderr

class Session:
    """ETL-Workflow-Sitzung

    Beispiel:
        mit Session(task_name) als session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Gut gemacht'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'geöffnet')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Sitzung ist nicht geöffnet')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'geschlossen',
              ', erfolgreich: ', self.successful,
              ', geladen: ', self.loaded_rows,
              ', kommentar:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Es ist an der Zeit unsere Daten abzurufen aus unseren etwas mehr als hundert Tabellen. Wir werden dies mit sehr simplen Zeilen tun:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Mit Hilfe des Hooks holen wir aus Airflow
pymssql-Verbindung - Im Abfrage setzen wir eine Einschränkung in Form eines Datums — der Template-Editor wird es entsprechend einfügen.
- Wir füttern unsere Abfrage
pandas, die uns das besorgen wirdDataFrame, der uns später nützlich sein wird.
Ich verwende die Substitution
{dt}anstelle des Abfrageparameters%snicht weil ich ein böser Buratino bin, sondern weilpandaskann nicht umgehen mitpymssqlund reicht dem Letztenparams: Liste, obwohl er es sehr möchteein Tuple.
Beachten Sie auch, dass der Entwicklerpymssqlbeschlossen hat, ihn nicht mehr zu unterstützen, und es ist höchste Zeit, aufpyodbc.
Schauen wir uns an, was Airflow als Argumente für unsere Funktionen bereitgestellt hat:
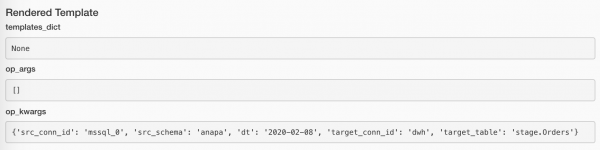
Wenn keine Daten vorliegen, macht es keinen Sinn, fortzufahren. Es ist jedoch auch merkwürdig, die Einzahlung als erfolgreich zu betrachten. Aber das ist auch kein Fehler. A-a-a, was tun?! Doch so:
if df.empty:
    raise AirflowSkipException('Keine Zeilen zu laden')
AirflowSkipException wird Airflow sagen, dass es keinen wirklichen Fehler gibt, und die Aufgabe wird übersprungen. Im Interface wird es kein grünes und kein rotes Quadrat geben, sondern die Farbe pink.
Wir fügen unseren Daten einige Spalten hinzu:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Und zwar:
- Die Datenbank, aus der wir die Bestellungen entnommen haben,
- Die Kennung unserer einladenden Sitzung (diese wird unterschiedlich sein für jede Aufgabe),
- Der Hash von Quelle und Bestellidentifikator – damit wir in der endgültigen Datenbank (wo alles in einer Tabelle zusammengefasst wird) eine eindeutige Bestellidentifikationsnummer haben.
Es bleibt der vorletzte Schritt: Alles in Vertica laden. Und merkwürdigerweise ist einer der effektivsten Wege, dies zu tun – über CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Wir machen einen speziellen Empfänger
StringIO. pandaswird unsereDataFramein Form vonCSV-Zeilen.- Wir eröffnen eine Verbindung zu unserem geliebten Vertica-Hook.
- Und jetzt senden wir mit Hilfe von
copy()unsere Daten direkt nach Vertica!
Wir holen aus dem Treiber, wie viele Zeilen hinzugefügt wurden, und sagen dem Sitzungsmanager, dass alles in Ordnung ist:
session.loaded_rows = cursor.rowcount
session.successful = True
Das ist alles.
Im Produktivsystem erstellen wir die Zieltabelle manuell. Hier habe ich mir eine kleine Automatisierung erlaubt:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Ich erstelle mit Hilfe von
VerticaOperator()ein Datenbankschema und eine Tabelle (wenn sie noch nicht vorhanden sind, selbstverständlich). Wichtig ist, die Abhängigkeiten korrekt zu setzen:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Zusammenfassung
— Also, — sagte das Mäuschen, — ist das nicht wahr, jetzt
Hast du dich überzeugt, dass ich im Wald das furchtbarste Tier bin?
Julia Donaldson, „Der Gruffalo“
Ich denke, wenn ich mit meinen Kollegen einen Wettbewerb veranstalten würde: Wer am schnellsten einen ETL-Prozess von Grund auf erstellt und startet: sie mit ihren SSIS und der Maus und ich mit Airflow… Und dann würden wir noch den Komfort der Wartung vergleichen… Uff, ich denke, du wirst mir zustimmen, dass ich sie in allen Punkten übertreffen werde!
Wenn es etwas ernster sein soll, dann hat Apache Airflow – durch die Beschreibung von Prozessen in Form von Programmcode – meine Arbeit viel einfacher und angenehmer gemacht.
Seine unbegrenzte Erweiterbarkeit: sowohl in Bezug auf Plugins als auch die Neigung zur Skalierbarkeit – ermöglicht es euch, Airflow praktisch in jedem Bereich anzuwenden: sei es im vollständigen Zyklus der Datensammlung, -vorbereitung und -verarbeitung oder beim Raketenstart (zum Mars, natürlich).
Der abschließende Teil, informativ-referenziell
Die Stolpersteine, die wir für Sie gesammelt haben
start_date. Ja, das ist schon ein lokales Meme. Über das Hauptargument im DAGstart_dateführt alles. Kurz gesagt, wenn man dasstart_dateauf das aktuelle Datum setzt und dasschedule_intervalauf einen Tag setzt, wird der DAG morgen nicht früher gestartet.start_date = datetime(2020, 7, 7, 0, 1, 2)Und keine weiteren Probleme.
Mit ihm hängt auch ein weiterer Ausführungsfehler zusammen:
Task is missing the start_date parameter, der meist darauf hinweist, dass du vergessen hast, ihn an den DAG-Operator zu binden.- Alles auf einer Maschine. Ja, sowohl die Datenbanken (von Airflow selbst und unser Wrapper), der Webserver, der Scheduler und die Worker. Und es hat sogar funktioniert. Aber mit der Zeit nahm die Anzahl der Aufgaben bei den Services zu, und als PostgreSQL anfing, eine Antwort über den Index nach 20 ms statt 5 ms zu liefern, haben wir ihn einfach entfernt.
- LocalExecutor. Ja, wir verwenden ihn immer noch, und wir sind schon am Rand des Abgrunds. Der LocalExecutor hat uns bis jetzt gereicht, aber jetzt ist es an der Zeit, mindestens einen Worker hinzuzufügen, und wir müssen uns anstrengen, um auf den CeleryExecutor umzusteigen. Und da man mit ihm auch auf einer Maschine arbeiten kann, gibt es nichts, was uns daran hindert, Celery sogar auf einem Server zu nutzen, der „natürlich nie produktiv geht, ganz ehrlich!“
- Nichtnutzung eingebauter Mittel:
- Connections zur Speicherung von Dienst-Anmeldeinformationen,
- SLA Misses um auf Tasks zu reagieren, die nicht rechtzeitig abgeschlossen wurden,
- XCom zum Austausch von Metadaten (ich sagte Metadaten!) zwischen den DAG-Tasks.Daten!) zwischen den Tasks des DAG.
- Missbrauch von E-Mails. Was soll man dazu sagen? Es wurden Benachrichtigungen für alle Wiederholungen fehlgeschlagener Tasks eingerichtet. Jetzt habe ich in meinem Arbeits-Gmail über 90.000 E-Mails von Airflow, und die Weboberfläche der E-Mail weigert sich, mehr als 100 auf einmal zu entfernen.
Weitere Stolpersteine:
Mittel zur weiteren Automatisierung
Um uns noch mehr zum Denken und weniger zum Arbeiten zu bringen, hat Airflow Folgendes für uns vorbereitet:
- - Es hat immer noch den Status Experimental, was jedoch nicht daran hindert, dass es funktioniert. Damit kann man nicht nur Informationen über DAGs und Tasks erhalten, sondern auch einen DAG stoppen/starten, einen DAG Run oder Pool erstellen.
- - Über die Befehlszeile stehen viele Werkzeuge zur Verfügung, die über die WebUI nicht nur unpraktisch sind, sondern gar nicht vorhanden sind. Zum Beispiel:
backfillwird benötigt, um Instanzen von Tasks erneut auszuführen.
Zum Beispiel, die Analysten kommen und sagen: "Bei Ihnen, mein Herr, gibt es Datenprobleme vom 1. bis 13. Januar! Reparieren, reparieren, reparieren!" Und du sagst:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Datenbankwartung:
initdb,resetdb,upgradedb,checkdb. run, was es ermöglicht, einen einzelnen Task-Instanz zu starten und alle Abhängigkeiten zu ignorieren. Darüber hinaus kann man es überLocalExecutor, selbst wenn man ein Celery-Cluster hat.- Ähnliches macht
test, schreibt jedoch nichts in die Datenbank. connectionserlaubt die massenhafte Erstellung von Verbindungen aus dem Shell.
- – eine ziemlich hardcore Art der Interaktion, die für Plugins gedacht ist und nicht für manuelles Herumspielen. Aber wer hindert uns daran, in
/home/airflow/dags, zu gehen,ipythonzu starten und uns auszutoben? Man könnte zum Beispiel alle Verbindungen mit folgendem Code exportieren:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Verbindung zur Airflow-Metadatenbank. Ich empfehle nicht, darin zu schreiben, aber den Status von Tasks für verschiedene spezifische Metriken kann man wesentlich schneller und einfacher abrufen als über die APIs.
Sagen wir mal, dass nicht alle unsere Tasks idempotent sind und manchmal fehlschlagen können, was in Ordnung ist. Aber mehrere Ausfälle sind schon verdächtig und sollten überprüft werden.
Vorsicht, SQL!
MIT last_executions AS (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' DAY
),
failed AS (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM last_executions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failed
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Links
Und natürlich die ersten zehn Links aus den Google-Suchergebnissen, die den Inhalt des Airflow-Ordners aus meinen Lesezeichen enthalten.
- — Natürlich sollte man mit der offiziellen Dokumentation beginnen, aber wer liest schon Anleitungen?
- — Lesen Sie zumindest die Empfehlungen der Entwickler.
- — Der Anfang: Benutzeroberfläche in Bildern
- — Grundlegende Konzepte werden gut erklärt, falls Sie (zufällig!) etwas nicht verstanden haben.
- — Ein kurzer Leitfaden zur Konfiguration eines Airflow-Clusters.
- — Fast ein ebenso interessanter Artikel, nur mit mehr Formalismus und weniger Beispielen.
- — Über die Zusammenarbeit mit Celery.
- — Über die Idempotenz von Tasks, das Laden nach ID statt nach Datum, Transformationen, Dateistrukturen und andere interessante Dinge.
- — Abhängigkeiten von Tasks und Trigger-Regeln, die ich nur am Rande erwähnt habe.
- — Wie man einige "funktioniert wie vorgesehen"-Probleme des Planers überwindet, verlorene Daten lädt und die Prioritäten von Tasks festlegt.
- — Nützliche SQL-Abfragen zu den Metadaten von Airflow.
- — Es gibt einen nützlichen Abschnitt zum Erstellen eines benutzerdefinierten Sensors.
- — Eine interessante kurze Notiz zum Aufbau der Infrastruktur auf AWS für Data Science.
- — Häufige Fehler (wenn jemand doch die Anleitungen nicht liest).
- — Lächeln Sie, wie Menschen das Speichern von Passwörtern behelfen, obwohl man einfach Verbindungen nutzen könnte.
- — ein stiller DAG-Pass, das Einbringen des Kontextes in Funktionen, wieder über Abhängigkeiten, und außerdem über das Überspringen von Task-Ausführungen.
- — über die Nutzung
StandardargumenteundParameterin Templates sowie über Variablen und Verbindungen. - — eine Erzählung, wie der Scheduler auf Airflow 2.0 vorbereitet wird.
- — ein etwas veralteter Artikel über das Deployment unseres Clusters in
docker-compose. - — dynamische Tasks mit Hilfe von Templates und Kontextübergabe.
- — standardisierte und benutzerdefinierte Benachrichtigungen per E-Mail und Slack.
- — Verzweigungen von Tasks, Makros und XCom.
Und Links, die im Artikel verwendet werden:
- — verfügbare Platzhalter für die Nutzung in Templates.
- — Verbreitete Fehler beim Erstellen von DAGs.
- —
docker-composefür Experimente, Debugging und mehr. - — Python-Wrapper für die Telegram REST API.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish