

KDB+, Produkt des Unternehmens — ist eine in Fachkreisen weithin bekannte, extrem schnelle Spalten-Datenbank, die zur Speicherung von Zeitreihendaten und deren analytischer Verarbeitung entwickelt wurde. Ursprünglich war sie (und ist es immer noch) sehr beliebt in der Finanzindustrie — sie wird von allen Top-10-Investmentbanken sowie vielen bekannten Hedgefonds, Börsen und anderen Organisationen genutzt. In letzter Zeit hat KX beschlossen, die Kundenbasis zu erweitern und bietet nun Lösungen auch in anderen Bereichen an, in denen eine große Menge an Daten zeitlich oder anderweitig geordnet vorliegt — Telekommunikation, Bioinformatik, Fertigung usw. Außerdem sind sie Partner des Teams Aston Martin Red Bull Racing in der Formel 1, wo sie dabei helfen, Daten von den Sensoren der Boliden zu sammeln und Tests im Windkanal zu analysieren. In diesem Artikel möchte ich erläutern, welche Eigenschaften KDB+ so leistungsstark machen, warum Unternehmen bereit sind, viel Geld dafür auszugeben und schließlich, warum es sich tatsächlich nicht um eine Datenbank handelt.
In diesem Artikel werde ich versuchen, im Allgemeinen zu erklären, was KDB+ ist, welche Möglichkeiten und Einschränkungen es hat und welchen Nutzen es für Unternehmen hat, die große Datenmengen verarbeiten möchten. Ich werde nicht auf die Details der Implementierung von KDB+ und auf die Einzelheiten ihrer Programmiersprache Q eingehen. Beide Themen sind sehr umfangreich und verdienen separate Artikel. Viele Informationen zu diesen Themen sind auf der Website code.kx.com zu finden, einschließlich eines Buches über Q — Q For Mortals (siehe Link unten).
Einige Begriffe
- In-Memory-Datenbank. Eine Datenbank, die Daten im Hauptspeicher speichert, um den Zugriff zu beschleunigen. Die Vorteile einer solchen Datenbank sind offensichtlich, während die Nachteile die Möglichkeit von Datenverlust und die Notwendigkeit, viel Speicherplatz auf dem Server zur Verfügung zu haben, umfassen.
- Spalten-Datenbank. Eine Datenbank, in der Daten spaltenweise und nicht zeilenweise gespeichert werden. Der Hauptvorteil einer solchen Datenbank besteht darin, dass Daten aus einer Spalte zusammen auf der Festplatte und im Speicher abgelegt werden, was den Zugriff erheblich beschleunigt. Es ist nicht nötig, Spalten zu laden, die in der Anfrage nicht verwendet werden. Der Hauptnachteil ist, dass das Ändern und Löschen von Datensätzen kompliziert ist.
- Zeitreihe. Daten mit einer Datum- oder Zeitspalte. In der Regel ist bei solchen Daten die zeitliche Reihenfolge wichtig, um leicht bestimmen zu können, welcher Eintrag dem aktuellen vor oder nachfolgt, oder um Funktionen anzuwenden, deren Ergebnisse von der Reihenfolge der Einträge abhängen. Klassische Datenbanken basieren auf einem völlig anderen Prinzip - der Darstellung einer Menge von Einträgen als Menge, bei der die Reihenfolge der Einträge grundsätzlich nicht definiert ist.
- Vektor. Im Kontext von KDB+ ist dies eine Liste von Elementen des gleichen atomaren Typs, z. B. Zahlen. Mit anderen Worten, ein Array von Elementen. Arrays können, im Gegensatz zu Listen, kompakt gespeichert und unter Verwendung von Vektoranweisungen des Prozessors verarbeitet werden.
Historisches Nachschlagewerk
Das Unternehmen KX wurde 1993 von Arthur Whitney gegründet, der zuvor bei Morgan Stanley an der Sprache A+ gearbeitet hatte, einem Nachfolger von APL - einer sehr originellen und zur damaligen Zeit beliebten Sprache in der Finanzwelt. Selbstverständlich setzte Arthur bei KX diesen Geist fort und schuf die vektorisch-funktionale Sprache K, geleitet von Ideen radikalen Minimalismus. Programme in K erscheinen wie eine chaotische Ansammlung von Satzzeichen und speziellen Symbolen, deren Bedeutung vom Kontext abhängt, und jede Operation trägt viel mehr Bedeutung in sich, als dies in herkömmlichen Programmiersprachen der Fall ist. Dadurch benötigt ein Programm in K nur minimalen Platz - einige Zeilen können Seiten Text einer wortreichen Sprache wie Java ersetzen - und ist eine extrem kompakte Umsetzung eines Algorithmus.
Eine Funktion in K, die den Großteil des LL1-Parser-Generators für eine gegebene Grammatik implementiert:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/;1_r),"]";""]]}
Diese Philosophie der extremen Effizienz bei minimalen Bewegungen hat Arthur auch in KDB+ verwirklicht, das 2003 entstand (ich denke, jetzt ist klar, woher das K im Namen stammt) und nichts anderes ist als ein Interpreter der vierten Version der K-Sprache. Über K wurde eine benutzerfreundlichere Version namens Q hinzugefügt. In Q wurde ebenfalls die Unterstützung für einen speziellen SQL-Dialekt – QSQL – integriert sowie Unterstützung für Tabellen als Systemdatentyp, Werkzeuge zur Arbeit mit Tabellen im Speicher und auf der Festplatte usw.
Somit ist KDB+ aus der Sicht des Nutzers einfach ein Interpreter der Sprache Q mit Unterstützung für Tabellen und SQL-ähnliche Ausdrücke im LINQ-Stil aus C#. Dies ist das wichtigste Unterscheidungsmerkmal von KDB+ zu anderen Datenbanken und ihr Hauptvorteil, der oft übersehen wird. Es ist keine Datenbank + unterstützende Sprache, sondern eine vollständige leistungsstarke Programmiersprache + integrierte Unterstützung für Datenbankfunktionen. Diese Unterscheidung wird eine entscheidende Rolle bei der Auflistung aller Vorteile von KDB+ spielen. Zum Beispiel ...
Größe
Nach modernen Maßstäben hat KDB+ einfach eine mikroskopisch kleine Größe. Es handelt sich buchstäblich um eine ausführbare Datei, die kleiner als ein Megabyte ist, und eine kleine Textdatei mit einigen Systemfunktionen. Tatsächlich sind es weniger als ein Megabyte, und für dieses Programm zahlen Unternehmen jährlich Zehntausende von Dollar für einen Prozessor auf dem Server.
- Eine solche Größe ermöglicht es KDB+, auf jeder Hardware hervorragend zu funktionieren – vom Mikrocomputer Pi bis hin zu Servern mit Terabytes an Arbeitsspeicher. Dies hat keinen Einfluss auf die Funktionalität; vielmehr startet Q sofort, was es auch als Skriptsprache verwendbar macht.
- Bei dieser Größe passt der Q-Interpreter vollständig in den Cache des Prozessors, was die Ausführung von Programmen beschleunigt.
- Bei einer solchen Größe des ausführbaren Programms nimmt der Prozess Q vernachlässigbar wenig Speicherplatz ein, man kann sie hunderte Male starten. Dabei kann Q, wenn nötig, auch mit Dutzenden oder Hunderten von Gigabytes Speicher innerhalb eines Prozesses umgehen.
Vielseitigkeit
Q eignet sich hervorragend für die unterschiedlichsten Aufgaben. Der Prozess Q kann als historische Datenbank fungieren und bietet schnellen Zugriff auf Terabytes an Informationen. Wir haben beispielsweise Dutzende historischer Datenbanken, von denen einige einen unkomprimierten Tag Daten speichern, der mehr als 100 Gigabyte umfasst. Dennoch kann eine Abfrage an die Datenbank unter angemessenen Einschränkungen in Zehnteln bis hunderten von Millisekunden durchgeführt werden. Insgesamt haben wir für die Benutzeranfragen einen universellen Timeout von 30 Sekunden, der sehr selten ausgelöst wird.
Mit derselben Leichtigkeit kann Q auch als In-Memory-Datenbank fungieren. Das Hinzufügen neuer Daten zu den Tabellen im Speicher erfolgt so schnell, dass der limitierende Faktor die Benutzeranfragen sind. Die Daten in den Tabellen werden spaltenweise gespeichert, was bedeutet, dass jede Spaltenoperation den Cache des Prozessors optimal nutzt. Darüber hinaus hat KX versucht, alle grundlegenden Operationen wie arithmetische Berechnungen über Vektorinstruktionen des Prozessors zu implementieren, um deren Geschwindigkeit zu maximieren. Q kann auch Aufgaben ausführen, die für Datenbanken untypisch sind – beispielsweise Streaming-Daten verarbeiten und in „Echtzeit“ (mit Latenzen von mehreren Millisekunden bis zu einigen Sekunden, je nach Aufgabe) verschiedene aggregierte Funktionen für Finanzinstrumente über unterschiedliche Zeitintervalle berechnen oder ein Modell der Auswirkungen einer durchgeführten Transaktion auf den Markt erstellen und deren Profilierung fast sofort nach Durchführung der Transaktion durchführen. Bei solchen Aufgaben ist häufig nicht Q selbst die Hauptursache für die Verzögerung, sondern die Notwendigkeit, Daten aus verschiedenen Quellen zu synchronisieren. Die hohe Geschwindigkeit wird dadurch erreicht, dass sich die Daten und die sie verarbeitenden Funktionen im selben Prozess befinden und die Verarbeitung auf die Ausführung mehrerer QSQL-Ausdrücke und Joins reduziert wird, die nicht interpretiert, sondern im Binärcode ausgeführt werden.
Schließlich kann man in Q auch beliebige Serviceprozesse schreiben. Zum Beispiel Gateway-Prozesse, die automatisch Benutzeranfragen an die erforderlichen Datenbanken und Server verteilen. Der Programmierer hat völlige Freiheit, jeden Algorithmus zur Lastverteilung, Priorisierung, Fehlerresistenz, Zugriffsrechten, Quoten und generell alles, was er möchte, zu implementieren. Das Hauptproblem dabei ist, dass man alles selbst umsetzen muss.
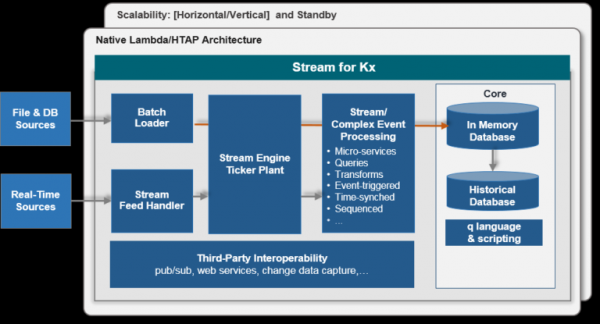
Als Beispiel nenne ich, welche Arten von Prozessen wir haben. Alle werden aktiv genutzt und arbeiten zusammen, um Dutzende verschiedener Datenbanken zu einer Einheit zu verbinden, Daten aus vielen Quellen zu verarbeiten und Hunderte von Benutzern und Anwendungen zu bedienen.
- Connectoren (feedhandler) zu Datenquellen. Diese Prozesse verwenden in der Regel externe Bibliotheken, die in Q geladen werden. Die C-Schnittstelle in Q ist äußerst einfach und ermöglicht es, problemlos Proxy-Funktionen für jede C/C++-Bibliothek zu erstellen. Q ist schnell genug, um beispielsweise gleichzeitig den Datenstrom von FIX-Nachrichten von allen europäischen Börsen zu verarbeiten.
- Datenverteiler (tickerplant), die als Zwischenglied zwischen den Connectoren und den Verbrauchern fungieren. Gleichzeitig schreiben sie die eingehenden Daten in ein spezielles binäres Protokoll, um den Verbrauchern einen robusten Schutz vor Verbindungsverlusten oder Neustarts zu bieten.
- In-Memory-Datenbanken (rdb). Diese Datenbanken bieten den schnellstmöglichen Zugriff auf frische Rohdaten, indem sie sie im Speicher halten. In der Regel sammeln sie über den Tag Daten in Tabellen und setzen diese nachts zurück.
- Persistente Datenbanken (pdb). Diese Datenbanken gewährleisten die Speicherung der täglichen Daten in einer historischen Datenbank. In der Regel speichern sie im Gegensatz zu rdb die Daten nicht im Speicher, sondern verwenden einen speziellen Cache auf der Festplatte während des Tages und kopieren die Daten zur Mitternacht in die historische Datenbank.
- Historische Datenbanken (hdb). Diese Datenbanken ermöglichen den Zugriff auf Daten der vergangenen Tage, Monate und Jahre. Ihre Größe (in Tagen) ist nur durch die Kapazität der Festplatten begrenzt. Die Daten können überall gespeichert werden, insbesondere auf verschiedenen Festplatten zur Beschleunigung des Zugriffs. Es besteht die Möglichkeit, Daten unter Verwendung mehrerer Algorithmen zu komprimieren. Die Struktur der Datenbank ist gut dokumentiert und einfach, die Daten werden chronologisch in regulären Dateien gespeichert, so dass sie auch mit Hilfe des Betriebssystems verarbeitet werden können.
- Datenbanken mit aggregierten Informationen. Sie speichern verschiedene Aggregationen, in der Regel gruppiert nach dem Namen des Instruments und dem Zeitintervall. In-Memory-Datenbanken aktualisieren ihren Zustand mit jeder eingehenden Nachricht, während historische Datenbanken vorab berechnete Daten speichern, um den Zugriff auf historische Daten zu beschleunigen.
- Schließlich Gateway-Prozesse, die Anwendungen und Benutzer bedienen. Q ermöglicht die vollständige asynchrone Verarbeitung eingehender Nachrichten, deren Verteilung auf Datenbanken, die Überprüfung von Zugriffsrechten usw. Ich möchte darauf hinweisen, dass die Nachrichten nicht beschränkt sind und in der Regel keine SQL-Ausdrücke sind, wie das in anderen Datenbanken der Fall ist. Am häufigsten ist der SQL-Ausdruck in einer speziellen Funktion verborgen und wird basierend auf den vom Benutzer angeforderten Parametern konstruiert — es erfolgt eine Zeitkonvertierung, Filterung, die Daten werden normalisiert (zum Beispiel wird der Aktienpreis angepasst, wenn Dividenden ausgeschüttet wurden) usw.
Typische Architektur für einen Datentyp:
Geschwindigkeit
Obwohl Q eine interpretierte Sprache ist, handelt es sich gleichzeitig um eine Vektorsprache. Das bedeutet, dass viele eingebaute Funktionen, insbesondere mathematische, Argumente jeder Form akzeptieren — Zahlen, Vektoren, Matrizen, Listen — und vom Programmierer erwartet wird, dass er das Programm als Operationen auf Arrays umsetzt. In einer solchen Sprache, wenn Sie zwei Vektoren mit einer Million Elementen addieren, spielt es keine Rolle, dass die Sprache interpretiert ist, die Addition wird durch eine superoptimierte binäre Funktion durchgeführt. Da der größte Teil der Zeit in Programmen auf Q für Operationen mit Tabellen aufgebracht wird, die diese grundlegenden vektorisierenden Funktionen nutzen, ergibt sich eine ziemlich respektable Geschwindigkeit, die die Verarbeitung großer Datenmengen sogar in einem einzigen Prozess ermöglicht. Es ähnelt den mathematischen Bibliotheken in Python — obwohl Python selbst eine ziemlich langsame Sprache ist, gibt es viele großartige Bibliotheken wie numpy, die die Verarbeitung numerischer Daten mit der Geschwindigkeit einer kompilierbaren Sprache ermöglichen (übrigens ist numpy ideologisch Q sehr ähnlich).
Darüber hinaus wurde bei KX sehr sorgfältig an der Gestaltung der Tabellen und der Optimierung der Arbeit mit ihnen gearbeitet. Erstens werden mehrere Arten von Indizes unterstützt, die von integrierten Funktionen unterstützt werden und nicht nur auf Tabellen spalten, sondern auch auf beliebige Vektoren angewendet werden können – Gruppierung, Sortierung, Attribut der Einzigartigkeit und spezielle Gruppierung für historische Datenbanken. Indizes werden einfach angelegt und automatisch angepasst, wenn Elemente in eine Spalte/Vektor hinzugefügt werden. Indizes können sowohl auf Tabellen spalten im Speicher als auch auf der Festplatte erfolgreich angewendet werden. Bei der Ausführung einer QSQL-Abfrage werden die Indizes automatisch verwendet, wenn möglich. Zweitens wird der Umgang mit historischen Daten über den Mechanismus der Abbildung von Betriebssystemdateien (memory map) realisiert. Große Tabellen werden niemals vollständig in den Arbeitsspeicher geladen, stattdessen werden die benötigten Spalten direkt in den Arbeitsspeicher abgebildet, und es wird tatsächlich nur der Teil geladen, der benötigt wird (dabei helfen unter anderem die Indizes). Für den Programmierer spielt es keine Rolle, ob die Daten im Speicher sind oder nicht, der Mechanismus der Arbeit mit mmap ist vollständig im Kern von Q verborgen.
KDB+ ist eine nicht-relationale Datenbank, Tabellen können beliebige Daten enthalten, wobei die Reihenfolge der Zeilen in der Tabelle beim Hinzufügen neuer Elemente nicht geändert wird und bei der Formulierung von Abfragen verwendet werden kann und sollte. Dieses Merkmal ist besonders wichtig für die Arbeit mit Zeitreihen (Börsendaten, Telemetrie, Ereignisprotokolle), denn wenn die Daten nach Zeit sortiert sind, muss der Benutzer keine SQL-Tricks anwenden, um die erste oder letzte zeitlich sortierte Zeile oder N Zeilen in der Tabelle zu finden, oder um zu bestimmen, welche Zeile auf die N-te Zeile folgt, usw. Die Verknüpfungen von Tabellen werden noch weiter vereinfacht, zum Beispiel dauert es ungefähr eine Sekunde auf der Festplatte und einige Millisekunden im Speicher, um für 16.000 Transaktionen von VOD.L (Vodafone) den letzten Kurs aus einer Tabelle mit 500 Millionen Elementen zu finden.
Ein Beispiel für einen zeitlichen Join – die Tabelle quote wird in den Arbeitsspeicher abgebildet, daher ist es nicht erforderlich, VOD.L in der where anzugeben, der Index auf der Spalte sym und die Tatsache, dass die Daten nach Zeit sortiert sind, werden implizit verwendet. Fast alle Joins in Q sind gewöhnliche Funktionen und nicht Teil des select-Ausdrucks:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Schließlich ist hervorzuheben, dass die Ingenieure bei KX, beginnend mit Arthur Whitney, wirklich besessen von Effizienz sind und alle Anstrengungen unternehmen, um das Maximum aus den Standardfunktionen von Q herauszuholen und die häufigsten Nutzungsmuster zu optimieren.
Fazit
KDB+ ist vor allem aufgrund ihrer außergewöhnlichen Vielseitigkeit bei Unternehmen beliebt – sie dient sowohl als In-Memory-Datenbank, als auch als Speicher für Terabytes historischer Daten und als Plattform für Datenanalysen. Da die Datenverarbeitung direkt in der Datenbank erfolgt, wird eine hohe Geschwindigkeit erreicht und Ressourcen werden gespart. Eine vollwertige Programmiersprache, die mit Datenbankfunktionen integriert ist, ermöglicht es, auf einer Plattform den gesamten Stack notwendiger Prozesse zu realisieren – von der Datenerfassung bis zur Bearbeitung von Benutzeranfragen.
Zusätzliche Informationen
Nachteile
Ein wesentlicher Nachteil von KDB+/Q ist die hohe Eintrittsbarriere. Die Sprache hat eine ungewöhnliche Syntax, bestimmte Funktionen sind stark überladen (value hat beispielsweise etwa 11 Verwendungsvarianten). Am wichtigsten ist, dass sie einen radikal anderen Ansatz für das Programmieren erfordert. In einer Vektorsprache muss man ständig in Begriffen von Array-Transformationen denken, alle Schleifen über verschiedene Varianten von Funktionalitäten wie map/reduce (die in Q als Adverbien bezeichnet werden) realisieren und niemals versuchen, Einsparungen zu erzielen, indem man vektorielle Operationen durch atomare ersetzt. Zum Beispiel, um den Index des N-ten Vorkommens eines Elements in einem Array zu finden, sollte man Folgendes schreiben:
1. (where element=vector)[N]
obwohl dies im Maßstab von C/Java (= erzeugt einen booleschen Vektor, wo 'where' die Indizes der wahren Elemente darin zurückgibt) wirklich ineffizient aussieht. Aber eine solche Schreibweise macht den Sinn des Ausdrucks klarer, und man verwendet schnelle vektorielle Operationen anstelle langsamer atomarer. Der konzeptionelle Unterschied zwischen einer Vektorsprache und den anderen ist vergleichbar mit dem Unterschied zwischen imperativen und funktionalen Programmieransätzen, und darauf muss man vorbereitet sein.
Einige Benutzer sind auch mit QSQL unzufrieden. Das liegt daran, dass es nur wie echtes SQL aussieht. In der Praxis handelt es sich jedoch lediglich um einen Interpreter für SQL-ähnliche Ausdrücke, der keine Optimierung von Abfragen unterstützt. Der Benutzer muss selbst optimale Abfragen schreiben, und zwar in Q, worauf sich viele nicht vorbereiten können. Andererseits kann man natürlich immer selbst eine optimale Abfrage schreiben, anstatt sich auf den Black-Box-Optimierer zu verlassen.
Ein Vorteil des Buches über Q – Q For Mortals ist kostenlos verfügbar auf , wo auch viele andere nützliche Materialien gesammelt sind.
Ein weiterer großer Nachteil ist die Lizenzgebühr. Das sind Zehntausende von Dollar pro Jahr für einen CPU. Nur große Firmen können sich solche Ausgaben leisten. In letzter Zeit hat KX die Lizenzpolitik flexibler gestaltet und ermöglicht es, nur für die Nutzungszeit zu zahlen oder KDB+ in den Clouds von Google und Amazon zu mieten. Außerdem bietet KX zum Download an (32-Bit-Version oder 64-Bit-Version auf Anfrage).
Wettbewerber
Es gibt ziemlich viele spezialisierte Datenbanken, die auf ähnlichen Prinzipien basieren – spaltenorientiert, in-memory, und auf sehr große Datenmengen ausgelegt. Das Problem ist, dass es sich hierbei um Spezialdatenbanken handelt. Ein herausragendes Beispiel ist Clickhouse. Diese Datenbank hat ein sehr ähnliches Prinzip zur Datenspeicherung auf der Festplatte und zum Aufbau des Index wie KDB+, einige Abfragen führt sie schneller aus als KDB+, wenn auch nicht signifikant. Doch selbst als Datenbank ist Clickhouse spezialisierter als KDB+ – Web-Analytik vs. beliebige Zeitreihen (dieser Unterschied ist sehr wichtig – wegen ihm gibt es zum Beispiel in Clickhouse keine Möglichkeit, die Ordnung der Datensätze zu nutzen). Aber vor allem hat Clickhouse nicht die Universalität von KDB+, einer Sprache, die es ermöglicht, Daten direkt in der Datenbank zu verarbeiten, ohne sie vorher in eine separate Anwendung zu laden, beliebige SQL-Ausdrücke zu erstellen, beliebige Funktionen in der Abfrage anzuwenden und Prozesse zu schaffen, die nicht mit der Ausführung von Funktionen in der historischen Datenbank verbunden sind. Daher ist es schwierig, KDB+ mit anderen Datenbanken zu vergleichen; sie können in bestimmten Nutzungsszenarien besser sein oder einfach besser, wenn es um Aufgaben klassischer Datenbanken geht, aber mir ist kein anderes so effektives und universelles Werkzeug zur Verarbeitung von Zeitdaten bekannt.
Integration mit Python
Um die Arbeit mit KDB+ für Menschen, die mit der Technologie nicht vertraut sind, zu erleichtern, hat KX Bibliotheken zur engen Integration mit Python innerhalb eines Prozesses erstellt. Man kann sowohl jede Python-Funktion aus Q aufrufen als auch umgekehrt – jede Q-Funktion aus Python (insbesondere QSQL-Ausdrücke). Die Bibliotheken konvertieren die Daten bei Bedarf (zur Effizienz nicht immer) von einem Format in das andere. Infolgedessen leben Q und Python in einer so engen Symbiose, dass die Grenzen zwischen ihnen verschwinden. Dadurch hat der Programmierer einerseits vollen Zugriff auf zahlreiche nützliche Python-Bibliotheken und erhält andererseits eine integrierte, schnelle Datenbank in Python für die Arbeit mit großen Datenmengen, was besonders nützlich für diejenigen ist, die sich mit maschinellem Lernen oder Modellierung beschäftigen.
Arbeiten mit Q in Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Links
Unternehmenswebsite —
Entwicklerseite —
Buch Q For Mortals (auf Englisch) —
Artikel über die Anwendung von KDB+/Q von Mitarbeitern von kx —
Quelle: habr.com
