

Wir haben die Struktur unserer PostgreSQL-Datenbank zum Speichern von Korrespondenz erfolgreich entworfen. Ein Jahr ist vergangen, und die Benutzer füllen sie aktiv – inzwischen gibt es Millionen von Einträgen, und… alles hat angefangen, ein wenig zu stocken.
- Teil 2: Sektionierung „live“
Das Problem ist, dass Mit dem Wachstum der Tabellengröße wächst auch die „Tiefe“ der Indizes – auch wenn nur logarithmisch. Aber mit der Zeit zwingt es den Server dazu, für die gleichen Lese-/Schreibaufgaben deutlich mehr Datenblätter zu verarbeiten, als zu Beginn.
Hier kommt die Partitionierung.
in Hilfe, wobei ich anmerken möchte, dass es nicht um Sharding geht, also um die Verteilung von Daten auf verschiedene Datenbanken oder Server. Denn selbst wenn Sie die Daten auf mehrere Server aufteilen, werden Sie das Problem der „Aufblähung“ der Indizes im Laufe der Zeit nicht los. Es ist klar, dass, wenn Sie sich täglich einen neuen Server leisten können, Ihre Probleme bereits auf einer ganz anderen Ebene liegen werden.
Wir werden nicht spezifische Skripte für die Implementierung der Partitionierung „in der Hardware“ betrachten, sondern den Ansatz selbst – was und wie man „in Scheiben schneiden“ sollte und worauf dieses Verlangen hinausläuft.
Konzept
Lassen Sie uns unser Ziel noch einmal definieren: Wir wollen sicherstellen, dass die Menge der gelesenen PostgreSQL-Daten bei jeder Lese-/Schreiboperation heute, morgen und in einem Jahr ungefähr gleich bleibt.
Für alle chronologisch gesammelten Daten (Nachrichten, Dokumente, Protokolle, Archive, …) ist das natürliche Wahlkriterium für die Partitionierung das Datum/Uhrzeit des Ereignisses. In unserem Fall ist ein solches Ereignis der Zeitpunkt des Versendens einer Nachricht.
Wir stellen fest, dass die Benutzer praktisch immer nur mit den „neueren“ solchen Daten arbeiten – sie lesen die letzten Nachrichten, analysieren die letzten Protokolle,… Sicher, sie können auch weiter in der Zeit zurückblättern, aber das tun sie sehr selten.
Aus diesen Einschränkungen wird offensichtlich, dass die optimale Lösung für Nachrichten sein wird, „tägliche“ Partitionen – denn fast immer wird unser Benutzer das lesen, was ihm „heute“ oder „gestern“ zugegangen ist.
Wenn wir im Laufe des Tages praktisch nur in einer Partition schreiben und lesen, führt dies auch zu einer effizienteren Nutzung von Speicher und Festplatte – da alle Indizes der Partition leicht in den Arbeitsspeicher passen, im Gegensatz zu „großen und fetten“ über die gesamte Tabelle.
Schritt-für-Schritt
Insgesamt klingt alles, was oben gesagt wurde, wie ein einziger großer Gewinn. Und er ist erreichbar, aber dafür müssen wir uns anstrengen – denn die Entscheidung, eine der Entitäten zu sektionieren, führt zum Bedarf, auch die damit verbundenen.
Nachrichten, ihre Eigenschaften und Projektionen
Da wir uns entschieden haben, Nachrichten nach Datumsangaben zu schneiden, ist es auch sinnvoll, die davon abhängigen Entitäten-Eigenschaften (Anhänge, Adressatenliste) ebenfalls zu trennen, und zwar nach dem Datum der Nachricht.
Da eine unserer typischen Aufgaben gerade die Ansicht der Nachrichteregister (ungelesene, eingehende, alle) ist, macht es auch Sinn, diese in die Datumssektionierung der Nachrichten einzubeziehen.
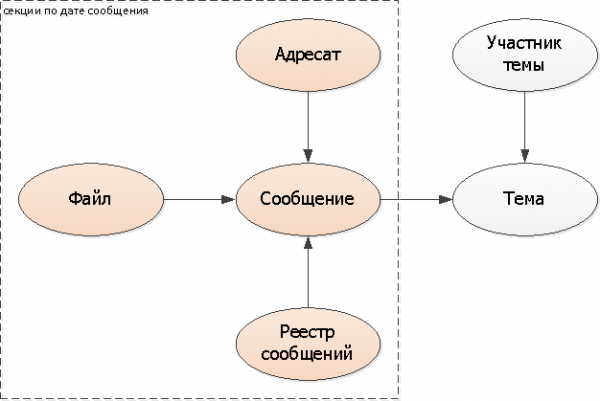
Wir fügen den Sektionierungsschlüssel (das Datum der Nachricht) in alle Tabellen ein: Adressaten, Datei, Register. In der Nachricht selbst kann man diesen nicht hinzufügen, sondern das bestehende Datum und die Uhrzeit verwenden.
Themen
Da das Thema über mehrere Nachrichten hinweg geht, kann man es in diesem Modell nicht einfach teilen, wir müssen uns auf etwas anderes stützen. In unserem Fall passt das Datum der ersten Nachricht in der Korrespondenz also der Zeitpunkt der Erstellung des eigentlichen Themas.
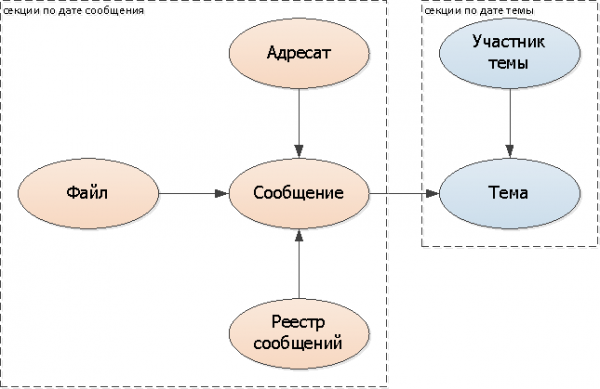
Wir fügen den Sektionierungsschlüssel (das Datum des Themas) in alle Tabellen ein: Thema, Teilnehmer.
Aber nun stehen wir sofort vor zwei Problemen:
- In welcher Sektion soll man nach Nachrichten zum Thema suchen?
- In welcher Sektion soll man das Thema aus der Nachricht suchen?
Natürlich könnte man weiterhin in allen Sektionen suchen, aber das wäre sehr unglücklich und würde all unsere Gewinne zunichte machen. Deshalb, um zu wissen, wo genau man suchen soll, erstellen wir logische Links/Referenzen zu den Sektionen:
- Wir fügen in der Nachricht hinzu ein Feld mit dem Datum des Themas
- zu dem Thema fügen wir hinzu eine Reihe von Nachrichtendaten dieser Korrespondenz (es kann eine separate Tabelle sein, oder auch ein Array von Daten)
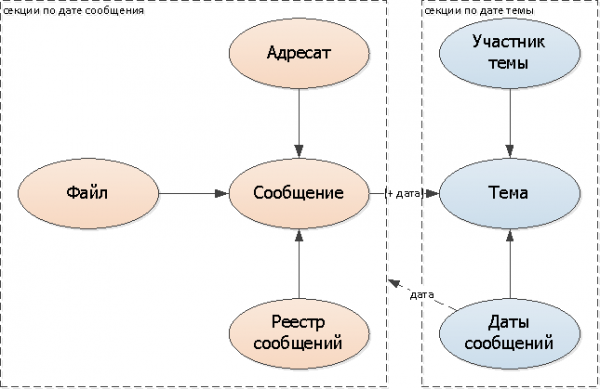
Da es nur wenige Modifikationen der Liste von Nachrichtendaten für jede einzelne Korrespondenz geben wird (denn fast alle Nachrichten fallen in 1-2 benachbarte Tage), werde ich mich genau auf diese Variante konzentrieren.
Insgesamt hat die Struktur unserer Datenbank unter Berücksichtigung der Sektionierung folgende Form angenommen:
Tabellen: RU, bei Abneigung gegen Kyrillisch in den Namen von Tabellen/Feldern besser nicht schauen
-- Abschnitte nach dem Datum der Nachricht
CREATE TABLE "Nachricht_YYYYMMDD"(
  "Nachricht"
    uuid
      PRIMARY KEY
, "Thema"
    uuid
, "DatumThema"
    date
, "Autor"
    uuid
, "DatumUhrzeit" -- nutzen wir als Datum
    timestamp
, "Text"
    text
);

CREATE TABLE "Empfänger_YYYYMMDD"(
  "DatumNachricht"
    date
, "Nachricht"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Nachricht", "Person")
);

CREATE TABLE "Datei_YYYYMMDD"(
  "DatumNachricht"
    date
, "Datei"
    uuid
      PRIMARY KEY
, "Nachricht"
    uuid
, "BLOB"
    uuid
, "Name"
    text
);

CREATE TABLE "RegisterNachrichten_YYYYMMDD"(
  "DatumNachricht"
    date
, "Inhaber"
    uuid
, "TypRegister"
    smallint
, "DatumUhrzeit"
    timestamp
, "Nachricht"
    uuid
, PRIMARY KEY("Inhaber", "TypRegister", "Nachricht")
);
CREATE INDEX ON "RegisterNachrichten_YYYYMMDD"("Inhaber", "TypRegister", "DatumUhrzeit" DESC);

-- Abschnitte nach dem Datum des Themas
CREATE TABLE "Thema_YYYYMMDD"(
  "DatumThema"
    date
, "Thema"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Titel"
    text
);

CREATE TABLE "TeilnehmerThema_YYYYMMDD"(
  "DatumThema"
    date
, "Thema"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Thema", "Person")
);

CREATE TABLE "DatenNachrichtenThema_YYYYMMDD"(
  "DatumThema"
    date
, "Thema"
    uuid
      PRIMARY KEY
, "Datum"
    date
);
Wir sparen ein wenig Geld
Nun, was ist, wenn wir nicht basierend auf der Verteilung der Feldwerte (über Trigger und Vererbung oder PARTITION BY) verwenden, sondern „manuell“ auf Anwendungsseite, dann kann man feststellen, dass der Wert des Partitionierungsschlüssels bereits im Namen der Tabelle selbst gespeichert ist.
Deshalb, wenn Sie so sehr besorgt sind über das Volumen der gespeicherten Daten, dann kann man sich von diesen „überflüssigen“ Feldern befreien und direkt auf bestimmte Tabellen zugreifen. Allerdings müssen in diesem Fall alle Abfragen über mehrere Partitionen auf die Anwendungsseite ausgelagert werden.
Quelle: habr.com
