

Die Essenz der Geschichte über den beliebtesten Paketmanager für Kubernetes könnte durch Emojis dargestellt werden:
- eine Box — das ist Helm (das passendste, was es in der letzten Emoji-Version gibt);
- ein Schloss — Sicherheit;
- eine Figur — Lösung des Problems.
Tatsächlich wird alles ein wenig komplizierter, und die Geschichte ist voller technischer Details darüber, wie man Helm sicher macht.
- Kurze Erklärung, was Helm ist, falls Sie es nicht wussten oder vergessen haben. Welche Probleme er löst und wo er sich im Ökosystem befindet.
- Betrachten wir die Architektur von Helm. Kein Gespräch über Sicherheit und darüber, wie man ein Tool oder eine Lösung sicherer macht, kommt ohne das Verständnis der Architektur der Komponenten aus.
- Diskutieren wir die Komponenten von Helm.
- Die brennendste Frage — die Zukunft — die neue Version von Helm 3.
Alles in diesem Artikel bezieht sich auf Helm 2. Diese Version befindet sich derzeit im Einsatz und wird wahrscheinlich genau die sein, die Sie jetzt verwenden, und in der gibt es Sicherheitsbedrohungen.
Über den Sprecher: Alexander Khayev () ist seit 10 Jahren in der Entwicklung tätig und hilft, den Inhalt zu verbessern und ist dem Komitee beigetreten . Er arbeitet derzeit bei Chainstack als Entwicklungsleiter — eine Hybride zwischen Entwicklungsleiter und einer Person, die für die Lieferung der Endprodukte verantwortlich ist. Das heißt, er ist am „Schlachtfeld“, wo alles von der Produktentwicklung bis zum Betrieb stattfindet.
Chainstack ist ein kleines, aktiv wachsendes Start-up, dessen Aufgabe es ist, den Kunden zu ermöglichen, sich um Infrastruktur und die Komplexität des Betriebs dezentralisierter Anwendungen keine Gedanken zu machen. Das Entwicklungsteam befindet sich in Singapur. Fragen Sie Chainstack nicht, ob sie Kryptowährung kaufen oder verkaufen können, sondern schlagen Sie vor, über Unternehmens-Blockchain-Frameworks zu sprechen, und man wird Ihnen gerne antworten.
Helm
Es ist ein Paketmanager (Charts) für Kubernetes. Der klarste und vielseitigste Weg, Anwendungen in ein Kubernetes-Cluster zu bringen.
Es geht natürlich um einen strukturierteren und industriellen Ansatz, als das Erstellen eigener YAML-Manifeste und das Schreiben kleiner Hilfsprogramme.
Helm ist das Beste, was zurzeit verfügbar und beliebt ist.
Warum Helm? Zunächst, weil es von der CNCF unterstützt wird. Cloud Native ist eine große Organisation und die Muttergesellschaft der Projekte Kubernetes, etcd, Fluentd und anderer.
Eine weitere wichtige Tatsache ist, dass Helm ein sehr beliebtes Projekt ist. Als ich im Januar 2019 darüber nachdachte, wie man Helm sicher machen kann, hatte das Projekt tausend Sterne auf GitHub. Bis Mai waren es 12.000.
Viele interessieren sich für Helm, deshalb sind die Kenntnisse über seine Sicherheit auch nützlich, selbst wenn Sie ihn bisher nicht verwenden. Sicherheit ist wichtig.
Das Hauptteam von Helm wird von Microsoft Azure unterstützt, daher ist dies ein recht stabiles Projekt im Vergleich zu vielen anderen. Die Veröffentlichung von Helm 3 Alpha 2 Mitte Juli zeigt, dass an dem Projekt viele Leute arbeiten, die den Wunsch und die Kraft haben, Helm weiterzuentwickeln und zu verbessern.
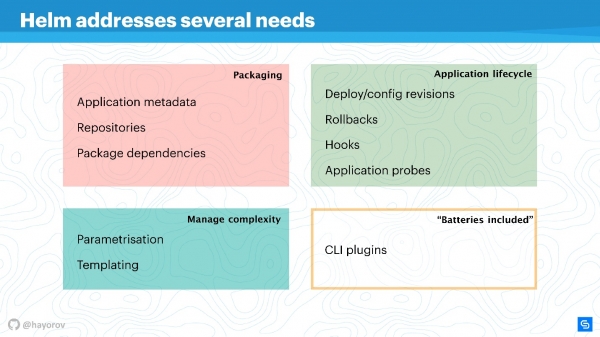
Helm löst mehrere grundlegende Probleme des Anwendungsmanagements in Kubernetes.
- Anwendungspaketierung. Selbst eine „Hello, World“-Anwendung auf WordPress besteht bereits aus mehreren Diensten, die man zusammen paketieren möchte.
- Management der Komplexität, die mit der Verwaltung dieser Anwendungen einhergeht.
- Der Lebenszyklus, der nach der Installation oder Bereitstellung der Anwendung nicht endet. Die Anwendung lebt weiter, sie muss aktualisiert werden, und dabei hilft Helm, indem es die richtigen Maßnahmen und Richtlinien bereitstellt.
Paketierung ist verständlich strukturiert: Es gibt Metadaten, die vollständig mit der Funktionsweise eines herkömmlichen Paketmanagers für Linux, Windows oder MacOS übereinstimmen. Das bedeutet Repository, Abhängigkeiten von verschiedenen Paketen, Metainformationen für Anwendungen, Einstellungen, Konfigurationseigenschaften, Informationsindizierung usw. All dies ermöglicht Helm, um für Anwendungen zur Verfügung gestellt und verwendet zu werden.
Komplexitätsmanagement. Wenn Sie viele gleichartige Anwendungen haben, benötigen Sie Parameterisierung. Daraus ergeben sich Vorlagen, aber um nicht selbst einen Weg zur Erstellung von Vorlagen zu erfinden, kann man nutzen, was Helm von Haus aus bietet.
Management des Anwendungslebenszyklus — das ist meiner Meinung nach die interessanteste und ungelöste Frage. Das ist der Grund, warum ich mich damals für Helm entschieden habe. Wir mussten den Lebenszyklus der Anwendung überwachen; wir wollten unsere CI/CD- und Anwendungszyklen in dieses Paradigma überführen.
Helm ermöglicht:
- das Management von Bereitstellungen, definiert den Begriff der Konfiguration und Revision;
- Rollback erfolgreich durchzuführen;
- Hooks für verschiedene Ereignisse zu verwenden;
- Zusätzliche Prüfungen von Anwendungen hinzuzufügen und auf deren Ergebnisse zu reagieren.
überführt werden. Zudem Helm hat „Batterien“ — eine riesige Anzahl an leckeren Dingen, die man als Plugins einfügen kann, um das Leben zu erleichtern. Plugins können selbst geschrieben werden, sie sind recht isoliert und erfordern keine strikte Architektur. Wenn Sie etwas umsetzen möchten, empfehle ich, dies in Form eines Plugins zu tun und dann vielleicht in den upstream einzubinden.
Helm basiert auf drei grundlegenden Konzepten:
- Chart Repo — eine Beschreibung und ein Array von Parametern, die für Ihr Manifest möglich sind.
- Konfiguration — das sind die Werte, die angewendet werden (Text, Zahlenwerte usw.).
- Release fasst die beiden oberen Komponenten zusammen, und zusammen verwandeln sie sich in ein Release. Releases können versioniert werden, was eine Organisation des Lebenszyklus ermöglicht: klein zum Zeitpunkt der Installation und groß zum Zeitpunkt des Upgrades, Downgrades oder Rollbacks.
Architektur von Helm
Im Diagramm wird konzeptionell die hochgradige Architektur von Helm dargestellt.
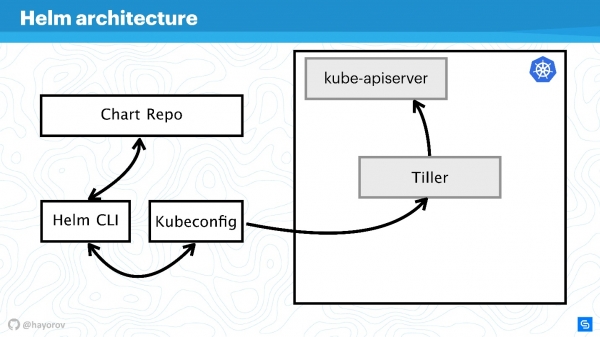
Ich erinnere daran, dass Helm etwas ist, das mit Kubernetes verbunden ist. Daher kommen wir nicht ohne einen Kubernetes-Cluster aus (Rechteck). Die Komponente kube-apiserver befindet sich auf dem Master. Ohne Helm haben wir Kubeconfig. Helm bringt ein kleines binäres Tool, wenn man so will, das Helm CLI, das auf Computer, Laptop, Mainframe – alles, was man braucht – installiert wird.
Aber das reicht nicht aus. Helm hat eine serverseitige Komponente namens Tiller. Er vertritt die Interessen von Helm innerhalb des Clusters, es ist eine Anwendung innerhalb des Kubernetes-Clusters, wie jede andere auch.
Die nächste Komponente, Chart Repo – ein Repository mit Charts. Es gibt ein offizielles Repository und möglicherweise ein privates Repository eines Unternehmens oder Projekts.
Interaktion
Lassen Sie uns betrachten, wie die Komponenten der Architektur interagieren, wenn wir eine Anwendung mit Helm installieren möchten.
- Wir sagen
Helm install, sprechen das Repository (Chart Repo) an und erhalten das Helm-Chart.
- Das Helm-Tool (Helm CLI) interagiert mit Kubeconfig, um herauszufinden, mit welchem Cluster es sprechen soll.
- Nachdem es diese Informationen erhalten hat, wendet sich das Tool an Tiller, der sich in unserem Cluster bereits als Anwendung befindet.
- Tiller wendet sich an den Kube-apiserver, um Aktionen in Kubernetes durchzuführen, um some Objekte (Dienste, Pods, Repliken, Geheimnisse usw.) zu erstellen.
Als nächstes werden wir das Diagramm komplexer gestalten, um den Angriffsvektor zu erkennen, dem die gesamte Helm-Architektur ausgesetzt sein kann. Und dann versuchen wir, sie zu schützen.
Angriffsvektor
Der erste potenziell schwache Punkt – privilegierte API—Nutzer. Im Rahmen des Schemas ist dies ein Hacker, der Administratorzugriff auf die Helm CLI erhalten hat.
Ein nicht privilegierter API-Benutzer kann ebenfalls eine Gefahr darstellen, wenn er sich in der Nähe befindet. Ein solcher Benutzer hat einen anderen Kontext, zum Beispiel kann er in einem bestimmten Namespace des Clusters in den Kubeconfig-Einstellungen verankert sein.
Der interessanteste Angriffsvektor könnte der Prozess sein, der sich innerhalb des Clusters in der Nähe von Tiller befindet und auf ihn zugreifen kann. Dies kann ein Webserver oder Mikrodienst sein, der die Netzwerkumgebung des Clusters sieht.
Eine exotische, aber zunehmend beliebte Angriffsvariante ist mit dem Chart Repo verbunden. Ein von einem böswilligen Autor erstelltes Chart kann unsichere Ressourcen enthalten, die Sie aus Vertraulichkeit ausführen. Alternativ könnte er das Chart, das Sie aus dem offiziellen Repository herunterladen, manipulieren und beispielsweise eine Ressource in Form von Richtlinien erstellen und sich damit Zugang verschaffen.
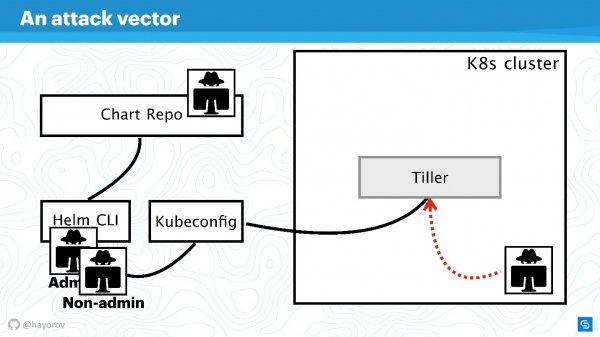
Wir werden versuchen, uns gegen Angriffe von all diesen vier Seiten zu verteidigen und herauszufinden, wo die Architektur von Helm Probleme hat und wo möglicherweise nicht.
Lassen Sie uns das Schema vergrößern, mehr Elemente hinzufügen, aber alle grundlegenden Bestandteile beibehalten.
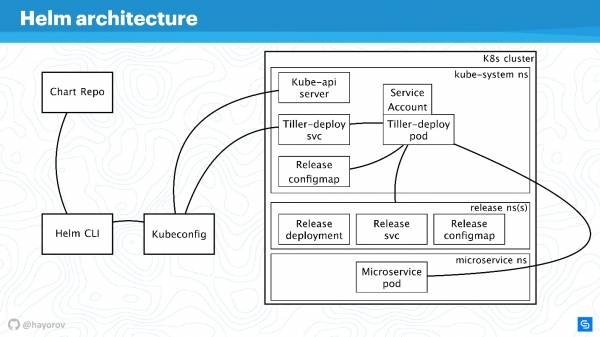
Die Helm CLI kommuniziert mit dem Chart Repo, interagiert mit Kubeconfig und die Arbeit wird an das Cluster im Tiller-Komponenten weitergegeben.
Tiller wird durch zwei Objekte repräsentiert:
- Tiller-deploy svc, das einen bestimmten Dienst bereitstellt;
- Tiller-deploy pod (im Schema in einem einzigen Exemplar in einer Replik), auf dem die gesamte Last ausgeführt wird, das auf das Cluster zugreift.
Für die Interaktion werden verschiedene Protokolle und Schemas verwendet. Aus Sicht der Sicherheit sind die am interessantesten:
- Der Mechanismus, mit dem die Helm CLI auf das Chart Repo zugreift: welches Protokoll, gibt es eine Authentifizierung und was kann man damit machen.
- Das Protokoll, über das die Helm CLI mithilfe von kubectl mit Tiller kommuniziert. Es handelt sich um einen RPC-Server, der innerhalb des Clusters installiert ist.
- Selbst Tiller ist für Mikrodienste, die sich im Cluster befinden, zugänglich und interagiert mit dem Kube-apiserver.
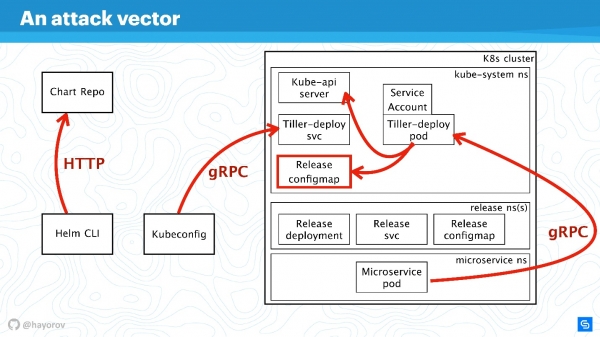
Lassen Sie uns all diese Richtungen der Reihe nach besprechen.
RBAC
Es ist sinnlos, über die Sicherheit von Helm oder einem anderen Dienst innerhalb des Clusters zu sprechen, wenn RBAC nicht aktiviert ist.
Es scheint, dass dies nicht die neueste Empfehlung ist, aber ich bin mir sicher, dass viele RBAC selbst in der Produktion noch nicht aktiviert haben, weil es viel Aufwand bedeutet und man vieles einrichten muss. Dennoch fordere ich Sie auf, dies zu tun.
— Anwalt-Website für RBAC. Dort finden Sie eine große Anzahl an interessanten Materialien, die Ihnen helfen, RBAC einzurichten, zeigen, warum es gut ist und wie man im Grunde damit im Produktionsbetrieb lebt.
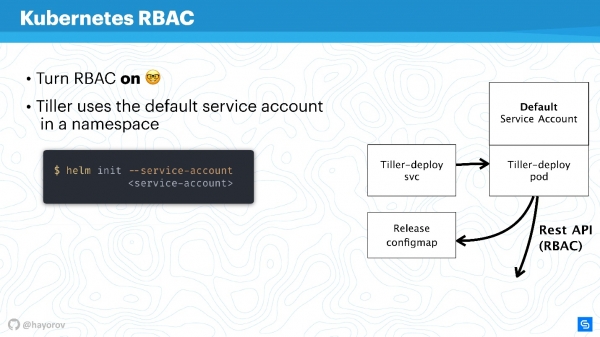
Ich werde versuchen zu erklären, wie Tiller und RBAC funktionieren. Tiller arbeitet innerhalb des Clusters unter einem bestimmten Dienstkonto. In der Regel, wenn RBAC nicht konfiguriert ist, ist dies ein Superbenutzer. In der Standardkonfiguration ist Tiller Administrator. Deshalb hört man oft, dass Tiller ein SSH-Tunnel zu Ihrem Cluster ist. Tatsächlich ist es so, deshalb kann man ein separates spezialisiertes Dienstkonto anstelle des Standarddienstkontos in dem oben gezeigten Diagramm verwenden.
Wenn Sie Helm initialisieren und es zum ersten Mal auf dem Server installieren, können Sie ein Dienstkonto mit --service-accountangeben. Dies ermöglicht es, einen Benutzer mit dem minimal notwendigen Rechtssatz zu verwenden. Allerdings müssen Sie eine solche "Girlande" erstellen: Role und RoleBinding.
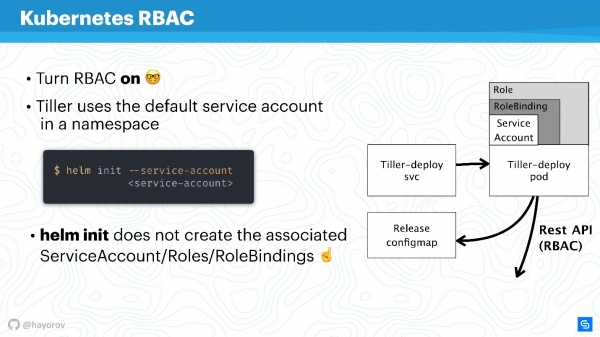
Leider wird Helm dies nicht für Sie erledigen. Sie oder Ihr Kubernetes-Administrator müssen im Voraus ein Set von Role und RoleBinding für das Dienstkonto vorbereiten, um Helm zu übergeben.
Es stellt sich die Frage – was ist der Unterschied zwischen Role und ClusterRole? Der Unterschied besteht darin, dass ClusterRole für alle Namespaces gilt, im Gegensatz zu normalen Role und RoleBinding, die nur für einen spezifischen Namespace funktionieren. Sie können Richtlinien sowohl für das gesamte Cluster und alle Namespaces als auch personalisiert für jeden einzelnen Namespace einrichten.
Es sei erwähnt, dass RBAC ein weiteres großes Problem lösen kann. Viele beklagen sich, dass Helm leider keine Multitenancy unterstützt. Wenn mehrere Teams das Cluster nutzen und Helm verwenden, ist es im Prinzip unmöglich, Richtlinien einzurichten und den Zugriff innerhalb dieses Clusters zu begrenzen, weil es ein bestimmtes Dienstkonto gibt, unter dem Helm arbeitet, und es alle Ressourcen aus diesem Konto im Cluster erstellt, was manchmal sehr unpraktisch ist. Das ist in der Tat so – sowohl die binäre Datei selbst als auch der Prozess, Helm Tiller hat kein Konzept für Multitenancy..
Es gibt jedoch einen hervorragenden Weg, um Tiller mehrmals im Cluster zu starten. Damit gibt es keine Probleme, Tiller kann in jedem Namespace gestartet werden. So können Sie RBAC nutzen, Kubeconfig als Kontext verwenden und den Zugriff auf ein spezielles Helm begrenzen.
Das wird folgendermaßen aussehen.
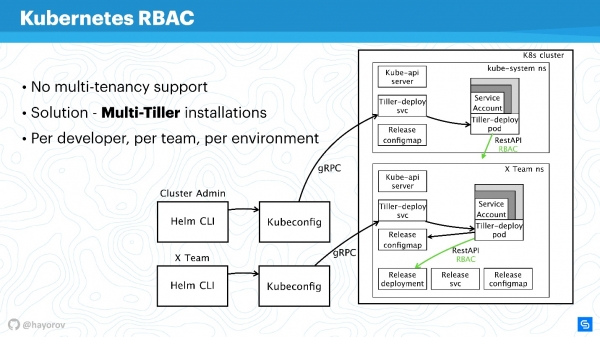
Zum Beispiel gibt es zwei Kubeconfig mit Kontext für verschiedene Teams (zwei Namespaces): X Team für das Entwicklerteam und den Admin-Cluster. Der Admin-Cluster hat ein umfassendes Tiller, das sich im Kube-system Namespace befindet, entsprechend mit einem erweiterten Service-Account. Und einen separaten Namespace für das Entwicklerteam, das seine Dienste in diesen speziellen Namespace bereitstellen kann.
Dies ist ein praktikabler Ansatz, Tiller ist nicht so hungrig, dass es Ihre Budgetierung stark beeinflussen könnte. Es ist eine der schnellen Lösungen.
Scheuen Sie sich nicht, Tiller separat zu konfigurieren und Kubeconfig mit dem Kontext für das Team, einen bestimmten Entwickler oder die Umgebung: Dev, Staging, Production bereitzustellen (es ist zweifelhaft, dass alles in einem Cluster sein wird, aber es ist möglich, dies zu tun).
Lassen Sie uns unsere Geschichte fortsetzen, indem wir von RBAC zu ConfigMaps wechseln.
ConfigMaps
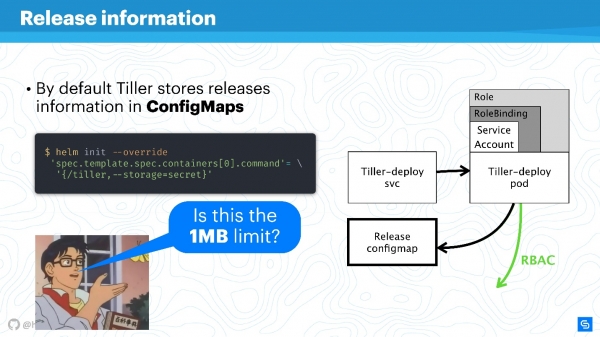
Helm verwendet ConfigMaps als Datenspeicher. Als wir über die Architektur sprachen, gab es keinen Datenbank, die Informationen über Releases, Konfigurationen, Rollbacks usw. speichert. Dafür werden ConfigMaps verwendet.
Das Hauptproblem mit ConfigMaps ist bekannt – sie sind in der Regel unsicher, weil in ihnen es unmöglich ist, sensible Daten zu speichern. Es geht um alles, was nicht über den Dienst hinaus gelangen sollte, wie zum Beispiel Passwörter. Der derzeit nativste Weg für Helm ist es, von ConfigMaps zu Secrets überzugehen.
Das ist ganz einfach. Sie überschreiben die Tiller-Einstellung und geben an, dass der Speicher Secrets sein werden. Dann erhalten Sie bei jedem Deployment kein ConfigMap, sondern ein Secret.
Sie könnten einwenden, dass Secrets – ein seltsames Konzept – nicht besonders sicher sind. Es ist jedoch wichtig zu verstehen, dass dies von den Entwicklern von Kubernetes selbst behandelt wird. Seit Version 1.10, also schon seit einiger Zeit, gibt es die Möglichkeit, zumindest in öffentlichen Clouds den richtigen Speicher für Secrets anzuschließen. Das Team arbeitet derzeit daran, den Zugriff auf Secrets für einzelne Pods oder andere Entitäten noch besser zu steuern.
Es ist besser, den Speicher von Helm auf Secrets umzustellen und diese wiederum zentral abzusichern.
Natürlich wird es ein Speicherlimit von 1 MB geben. Helm verwendet hier etcd als verteiltes Speichersystem für ConfigMaps. Dort wurde entschieden, dass dies ein geeigneter Datenchunk für Replikationen usw. ist. Dazu gibt es eine interessante Diskussion auf Reddit, ich empfehle, diese am Wochenende zu lesen oder eine Zusammenfassung zu finden. .
Chart-Repos
Charts sind besonders anfällig für soziale Angriffe und könnten zur Quelle von „Man in the Middle“-Attacken werden, insbesondere wenn eine Standardlösung verwendet wird. Zuallererst handelt es sich um Repositories, die über HTTP bereitgestellt werden.
Man muss definitiv das Helm-Repo über HTTPS bereitstellen – das ist die beste Option und kostet nicht viel.
Achten Sie darauf, dass Mechanismus zur Signierung von Charts. Die Technologie ist erschreckend einfach. Es ist dasselbe, was Sie auf GitHub verwenden, eine gewöhnliche PGP-Maschine mit öffentlichen und privaten Schlüsseln. Richten Sie es ein und seien Sie sich sicher, die richtigen Schlüssel zu haben und alles zu signieren, damit es wirklich Ihr Chart ist.
Außerdem, Der Helm-Client unterstützt TLS (nicht im Sinne von HTTP auf der Serverseite, sondern für mutual TLS). Sie können Server- und Client-Schlüssel verwenden, um zu kommunizieren. Ehrlich gesagt verwende ich einen solchen Mechanismus nicht, weil ich mutuale Zertifikate nicht mag. Im Prinzip, – das Hauptelement zur Bereitstellung von Helm-Repo für Helm 2 – unterstützt auch Basic Auth. Basic Auth kann verwendet werden, wenn es bequemer und angenehmer ist.
Es gibt auch ein Plugin , das es ermöglicht, Chart-Repos in Google Cloud Storage zu hosten. Das ist ziemlich praktisch, funktioniert hervorragend und ist ausreichend sicher, da alle beschriebenen Mechanismen verwendet werden.
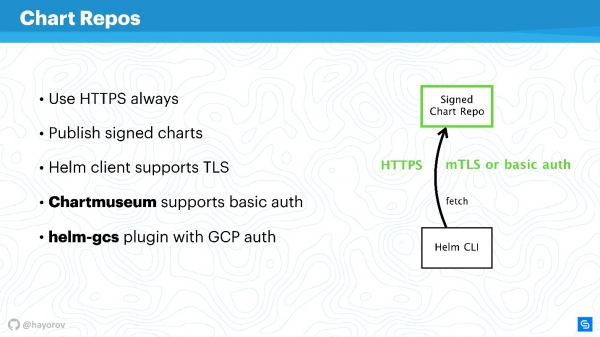
Wenn Sie HTTPS oder TLS aktivieren, mTLS verwenden und Basic Auth aktivieren, um die Risiken weiter zu minimieren, erhalten Sie eine sichere Kommunikationsverbindung zwischen Helm CLI und Chart Repo.
gRPC-API
Der nächste Schritt ist sehr verantwortungsvoll – Tiller abzusichern, der sich im Cluster befindet und einerseits ein Server ist, andererseits selbst auf andere Komponenten zugreift und versucht, sich als etwas anderes auszugeben.
Wie ich bereits sagte, ist Tiller ein Dienst, der gRPC bereitstellt, der Helm-Client greift über gRPC darauf zu. Standardmäßig ist TLS natürlich deaktiviert. Warum dies so gemacht wurde, ist eine diskussionswürdige Frage, ich denke, um die anfängliche Konfiguration zu vereinfachen.
Für die Produktion und sogar für Staging empfehle ich, TLS für gRPC zu aktivieren.
Meiner Meinung nach ist es, im Gegensatz zu mTLS für Charts, hier angemessen und sehr einfach — Sie generieren die PQI-Infrastruktur, erstellen ein Zertifikat, starten Tiller und übergeben das Zertifikat während der Initialisierung. Danach können Sie alle Helm-Befehle ausführen, indem Sie sich mit dem generierten Zertifikat und dem privaten Schlüssel identifizieren.
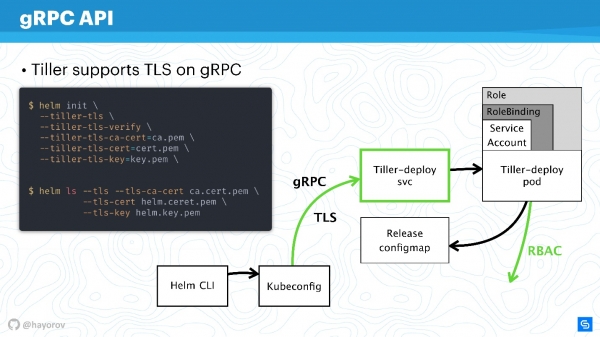
Damit sichern Sie sich gegen alle Anfragen an Tiller von außerhalb des Clusters ab.
So haben wir den Verbindungskanal zu Tiller gesichert, bereits über RBAC gesprochen und die Berechtigungen des Kubernetes apiserver angepasst, und die Domäne, mit der er interagieren kann, eingeschränkt.
Geschützter Helm
Schauen wir uns das finale Schema an. Es ist die gleiche Architektur mit denselben Pfeilen.
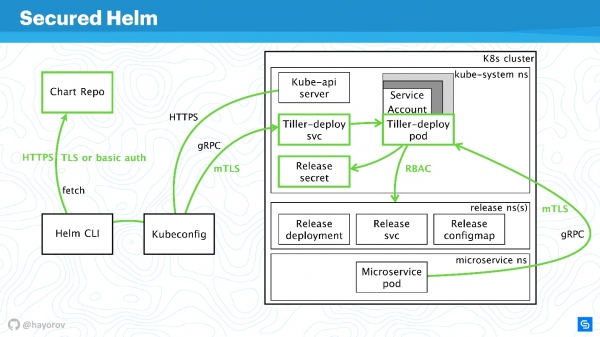
Alle Verbindungen können jetzt ohne Bedenken grün gezeichnet werden:
- für das Chart Repo verwenden wir TLS oder mTLS und Basic Auth;
- mTLS für Tiller, und es ist als gRPC-Dienst mit TLS eingerichtet, wobei wir Zertifikate verwenden;
- im Cluster wird ein spezieller Service-Account mit Role und RoleBinding verwendet.
Wir haben den Cluster deutlich gesichert, aber jemand hat schlau gesagt:
„Die absolut sichere Lösung kann nur eines sein — ein abgeschalteter Computer, der sich in einem Betonkasten befindet und von Soldaten bewacht wird.“
Es gibt verschiedene Möglichkeiten, Daten zu manipulieren und neue Angriffsvektoren zu finden. Ich bin jedoch überzeugt, dass diese Empfehlungen es ermöglichen, einen grundlegenden industriellen Sicherheitsstandard umzusetzen.
Bonus
Dieser Teil bezieht sich nicht direkt auf die Sicherheit, wird aber ebenfalls nützlich sein. Ich zeige einige interessante Dinge, von denen nur wenige wissen. Zum Beispiel, wie man Charts sucht — offizielle und inoffizielle.
Im Repository Derzeit gibt es etwa 300 Charts und zwei Streams: stable und incubator. Wer beiträgt, weiß genau, wie schwierig es ist, aus dem incubator in das stable zu gelangen und wie einfach es ist, aus dem stable herauszufallen. Allerdings ist dies nicht das beste Werkzeug, um Charts für Prometheus und alles, was Ihnen gefällt, zu suchen, aus einem einfachen Grund — es ist kein Portal, wo es bequem ist, Pakete zu suchen.
Aber es gibt einen Dienst , mit dem das Finden von Charts viel einfacher ist. Das Wichtigste ist, dass dort viel mehr externe Repositories verfügbar sind und fast 800 Charts zur Verfügung stehen. Außerdem können Sie Ihr eigenes Repository anschließen, wenn Sie aus bestimmten Gründen Ihre Charts nicht in stable einfügen möchten.
Probieren Sie hub.helm.sh aus und lassen Sie uns gemeinsam daran arbeiten. Dieser Dienst gehört zum Helm-Projekt, und Sie können sogar zur Benutzeroberfläche beitragen, wenn Sie Frontend-Entwickler sind und das Erscheinungsbild einfach verbessern möchten.
Ich möchte Ihre Aufmerksamkeit auf Integration der Open Service Broker API. Es klingt kompliziert und unverständlich, löst aber Probleme, mit denen jeder konfrontiert ist. Lassen Sie mich das anhand eines einfachen Beispiels erläutern.
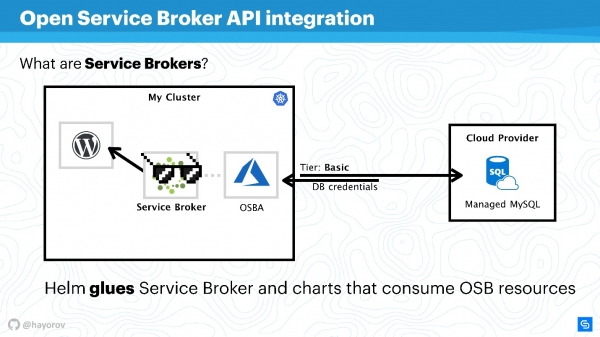
Angenommen, wir haben einen Kubernetes-Cluster, in dem wir eine klassische Anwendung — WordPress — betreiben möchten. In der Regel benötigt man dafür eine Datenbank. Es gibt viele verschiedene Lösungen, zum Beispiel könnte man seinen eigenen stateful-Service betreiben. Das ist nicht sehr praktisch, aber viele machen das so.
Andere, wie wir bei Chainstack, nutzen verwaltete Datenbanken, wie MySQL oder PostgreSQL, für Server. Deshalb befindet sich unsere DB irgendwo in der Cloud.
Aber es ergibt sich ein Problem: Wir müssen unseren Dienst mit der Datenbank verbinden, einen Datenbank-Flavor erstellen, Anmeldeinformationen übergeben und diese verwalten. All das geschieht normalerweise manuell durch einen Systemadministrator oder Entwickler. Das ist kein Problem, wenn es nur wenige Anwendungen gibt. Wenn es viele sind, braucht man einen Kombi-Anbieter. So einen Kombi-Anbieter gibt es — das ist der Service Broker. Er ermöglicht die Verwendung eines speziellen Plugins für den öffentlichen Cloud-Cluster und das Anfordern von Ressourcen beim Anbieter über Broker, als wäre es eine API. Dazu können die nativen Mittel von Kubernetes verwendet werden.
Das ist sehr einfach. Man kann beispielsweise Managed MySQL in Azure mit einem Basis-Tier anfordern (das kann man anpassen). Mit der Azure-API wird die Datenbank erstellt und einsatzbereit gemacht. Sie müssen sich nicht darum kümmern, darum kümmert sich das Plugin. Zum Beispiel gibt OSBA (Azure-Plugin) die Anmeldeinformationen an den Dienst zurück und übergibt diese an Helm. So können Sie WordPress mit der Cloud-MySQL nutzen, ohne sich um verwaltete Datenbanken und stateful-Services kümmern zu müssen.
Man könnte sagen, dass Helm als Kleber fungiert, der auf der einen Seite das Bereitstellen von Diensten ermöglicht und auf der anderen Seite die Ressourcen von Cloud-Anbietern konsumiert.
Man kann sein eigenes Plugin schreiben und diese ganze Geschichte on-premise nutzen. Dann hätten Sie einfach Ihr eigenes Plugin für den Unternehmens-Cloud-Anbieter. Ich empfehle, diesen Ansatz auszuprobieren, insbesondere wenn Sie in großem Maßstab arbeiten und schnell Dev-, Staging- oder die gesamte Infrastruktur für ein Feature bereitstellen möchten. Das wird das Leben Ihrer Operations oder DevOps erleichtern.
Eine weitere Entdeckung, die ich bereits erwähnt habe, ist das helm-gcs-Plugin, das es ermöglicht, Google-Buckets (Objektspeicher) zur Speicherung von Helm-Charts zu nutzen.
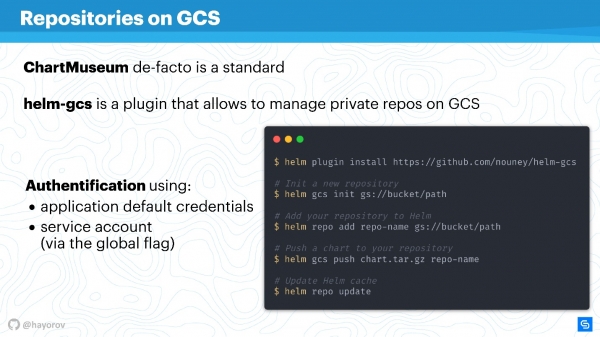
Es sind nur vier Befehle nötig, um damit zu beginnen:
- Plugin installieren;
- es initialisieren;
- Einen Pfad zu dem Bucket angeben, der sich in GCP befindet;
- Charts auf die standardmäßige Weise veröffentlichen.
Der Vorteil ist, dass die native Methode von GCP für die Authentifizierung verwendet wird. Sie können einen Dienstkonto, ein Entwicklerkonto – alles, was Sie möchten. Es ist sehr bequem und kostet nichts im Betrieb. Wenn Sie, wie ich, die opsless-Philosophie propagieren, wird es besonders praktisch, vor allem für kleine Teams.
Alternativen
Helm ist nicht die einzige Lösung zur Verwaltung von Diensten. Dazu gibt es viele Fragen, vielleicht ist das der Grund, warum so schnell die dritte Version erschienen ist. Natürlich gibt es Alternativen.
Das können sowohl spezialisierte Lösungen wie Ksonnet oder Metaparticle sein. Sie können auch Ihre klassischen Infrastrukturmanagement-Tools (Ansible, Terraform, Chef usw.) für dieselben Zwecke verwenden, über die ich gesprochen habe.
Schließlich gibt es die Lösung , deren Beliebtheit wächst.
Operator Framework ist die Hauptalternative zu Helm, der man Aufmerksamkeit schenken sollte.
Es ist nativ für CNCF und Kubernetes, aber die Einstiegshürde ist viel höher, Sie müssen mehr programmieren und weniger Manifeste beschreiben.
Es gibt verschiedene Addons wie Draft, Scaffold. Diese erleichtern das Leben erheblich, indem sie beispielsweise Entwicklern den Zyklus des Sendens und Startens von Helm zum Deployen einer Testumgebung vereinfachen. Ich würde sie als Leistungsverbesserer bezeichnen.
Hier ist ein anschauliches Diagramm, wo sich was befindet.
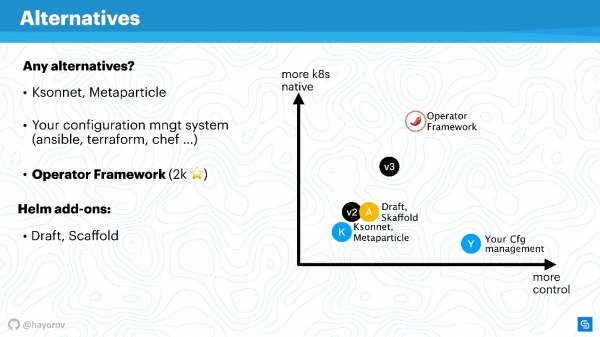
Auf der Abszisse ist Ihr persönlicher Kontrollgrad über das Geschehen, auf der Ordinate der Grad der Nativität von Kubernetes. Helm Version 2 befindet sich irgendwo in der Mitte. In Version 3 sind sowohl die Kontrolle als auch die Nativität nicht enorm verbessert, aber dennoch besser. Lösungen der Ebene Ksonnet sind immer noch unterlegen im Vergleich zu Helm 2. Dennoch sollten Sie einen Blick darauf werfen, um zu wissen, was es noch in dieser Welt gibt. Natürlich wird Ihr Konfigurationsmanager unter Ihrer Kontrolle stehen, ist aber absolut nicht nativ für Kubernetes.
Operator Framework ist absolut nativ für Kubernetes und erlaubt eine viel elegantere und gründlichere Verwaltung (aber denken Sie an die Einstiegshürde). Es ist eher für spezialisierte Anwendungen geeignet und zur Erstellung eines Managements dafür, als für einen Massenkompostierer zum Verpacken einer großen Anzahl von Anwendungen mit Helm.
Leistungsverbesserer verbessern lediglich die Kontrolle, ergänzen den Workflow oder schneiden Ecken in CI/CD-Pipelines.
Die Zukunft von Helm
Die gute Nachricht ist, dass Helm 3 verfügbar wird. Die Alpha-Version 3.0.0-alpha.2 ist bereits veröffentlicht und kann ausprobiert werden. Sie ist ziemlich stabil, aber die Funktionalität ist noch eingeschränkt.
Warum braucht man Helm 3? In erster Linie geht es darum, Tiller zu eliminieren, wie ein Bestandteil. Das ist, wie Sie bereits verstehen, ein riesiger Schritt nach vorne, denn aus Sicht der Sicherheitsarchitektur wird alles vereinfacht.
Als Helm 2 entwickelt wurde, das war zu Zeiten von Kubernetes 1.8 oder sogar früher, waren viele Konzepte unreif. Zum Beispiel wird das Konzept von CRD jetzt aktiv umgesetzt, und Helm wird CRD nutzen, um Strukturen zu speichern. Es wird möglich sein, nur den Client zu verwenden, ohne den Serverteil zu benötigen. Entsprechend können die nativen Kubernetes-Befehle für die Arbeit mit Strukturen und Ressourcen verwendet werden. Das ist ein großer Fortschritt.
Es wird Unterstützung für native OCI-Repositorys geben (Open Container Initiative). Das ist eine große Initiative, und Helm ist vor allem daran interessiert, eigene Charts bereitzustellen. Es geht so weit, dass zum Beispiel Docker Hub viele OCI-Standards unterstützt. Ich wage keine Vorhersage, aber möglicherweise werden die klassischen Anbieter von Docker-Repositories beginnen, Ihnen die Möglichkeit zu geben, Ihre Helm-Charts bereitzustellen.
Eine für mich umstrittene Sache ist die Unterstützung für Lua, als Templating-Engine zum Schreiben von Skripten. Ich bin kein großer Fan von Lua, aber das wird eine völlig optionale Möglichkeit sein. Ich habe das dreimal überprüft – die Verwendung von Lua wird nicht zwingend sein. Daher kann jeder, der möchte, Lua verwenden, und diejenigen, die Go mögen – schließen Sie sich unserem großen Lager an und nutzen Sie go-tmpl dafür.
Endlich das, was mir eindeutig gefehlt hat – das Erscheinen von Schemata und die Validierung von Datentypen. Es wird keine Probleme mehr mit int oder string geben, es wird nicht notwendig sein, null in doppelte Anführungszeichen zu setzen. Es wird ein JSON-Schema geben, das es ermöglicht, dies ausdrücklich für Werte zu beschreiben.
Das ereignisgesteuerte Modellwird stark überarbeitet. Es wurde bereits konzeptionell beschrieben. Schauen Sie sich den Branch Helm 3 an, und Sie werden sehen, wie viele Ereignisse, Hooks und anderes hinzugefügt wurden, was die Prozesse des Deployments stark vereinfachen und gleichzeitig mehr Kontrolle darüber geben wird.
Helm 3 wird einfacher, sicherer und interessanter sein, nicht weil wir Helm 2 nicht mögen, sondern weil Kubernetes fortschrittlicher wird. Dementsprechend kann Helm die Entwicklungen von Kubernetes nutzen und großartige Manager für Kubernetes schaffen.
Eine weitere gute Nachricht ist, dass Alexander Khayev wird erzählen, Wir erinnern daran, dass die Konferenz zur Integration von Entwicklungs-, Test- und Produktionsprozessen in Moskau stattfinden wird am 30. September und 1. Oktober. Bis zum 20. August kann man noch und über seine Erfahrungen bei der Lösung Herausforderungen des DevOps-Ansatzes berichten.
Halten Sie sich über die Checkpoints der Konferenz und Neuigkeiten auf dem Laufenden in der und .
Quelle: habr.com
