

Im Herbst 2019 fand in der iOS-Abteilung von Cloud Mail.ru ein lang erwartetes Ereignis statt. Die Hauptdatenbank für die permanente Speicherung des Anwendungszustands wurde eine für die mobile Welt recht exotische (LMDB). Unter dem Cut finden Sie eine detaillierte Übersicht in vier Teilen. Zuerst werden wir die Gründe für diese unkonventionelle und schwierige Wahl erörtern. Dann gehen wir zu den drei Säulen der Architektur von LMDB über: speicherabgebildete Dateien, B+-Bäume, Copy-on-Write-Ansatz zur Umsetzung von Transaktionssicherheit und Multi-Versioning. Schließlich widmen wir uns praktischen Aspekten. Dabei betrachten wir, wie man auf der Grundlage einer niedrigstufigen Key-Value-API ein Schema einer Datenbank mit mehreren Tabellen, einschließlich Indizes, entwerfen und implementieren kann.
Inhalt
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivation zur Einführung
Einst war es im Jahr 2015 unser Anliegen, eine Metrik darüber zu erheben, wie oft die Benutzeroberfläche unserer Anwendung laggt. Wir taten dies nicht ohne Grund. Es gab immer wieder Beschwerden, dass die Anwendung manchmal auf Benutzeraktionen nicht reagiert: Tasten funktionieren nicht, Listen lassen sich nicht scrollen usw. Über die Messmethodik auf AvitoTech, daher hier nur die Größenordnung.
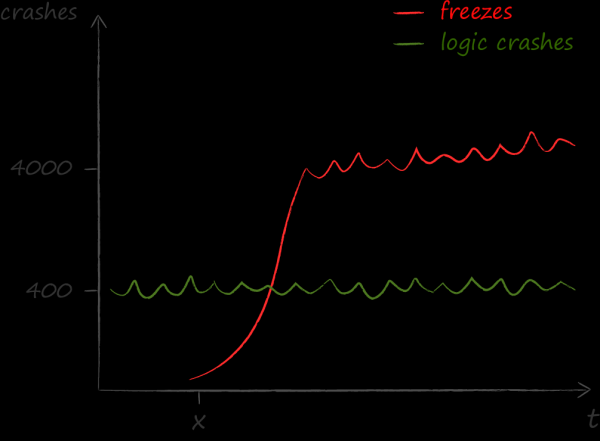
Die Ergebnisse der Messungen waren für uns eine kalte Dusche. Es stellte sich heraus, dass die durch Hänger verursachten Probleme erheblich größer sind als andere. Während vor der Erkenntnis dieser Tatsache der Hauptindikator für die technische Qualität "crash free" war, verschob sich nach diesem Fokus Nachdem wir
ein Dashboard mit Hängern erstellt quantitative und zwei Threads einen Artikel auf Habré Im aktuellen Kontext möchte ich die Aspekte der Lösung hervorheben, die die Wahl der Datenbank beeinflusst haben.
Das actorbasierte Organisationsmodell des Systems geht davon aus, dass Mehrfach-Threading zu seiner zweiten Essenz wird. Die Objekte des Modells überqueren dabei gerne die Grenzen der Threads. Und sie tun dies nicht gelegentlich und irgendwo, sondern praktisch ständig und überall.
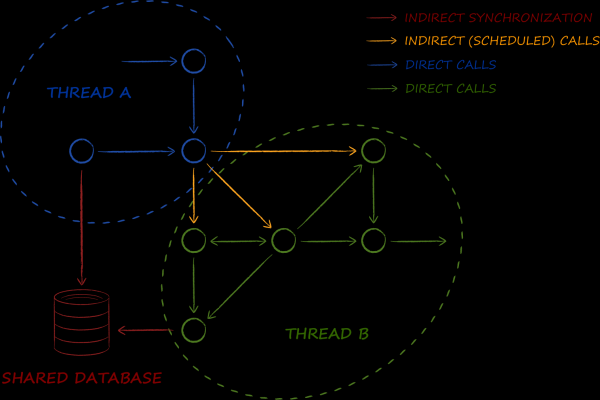
Die Datenbank ist eines der grundlegendsten Komponenten im dargestellten Schema. Ihre Hauptaufgabe besteht in der Umsetzung des Makropatterns . Während sie im Unternehmensumfeld zur Synchronisation von Daten zwischen Services eingesetzt wird, geschieht dies im Falle der Actor-Architektur – zwischen Threads. Daher benötigten wir eine solche Datenbank, deren Nutzung in der Multi-Thread-Umgebung nicht einmal minimale Schwierigkeiten mit sich bringt. Das bedeutet konkret, dass die aus ihr erhaltenen Objekte mindestens threadsicher sein sollten und idealerweise vollkommen unveränderlich. Wie bekannt ist, können Letztere gleichzeitig von mehreren Threads verwendet werden, ohne auf irgendwelche Sperren zurückgreifen zu müssen, was sich positiv auf die Leistung auswirkt.
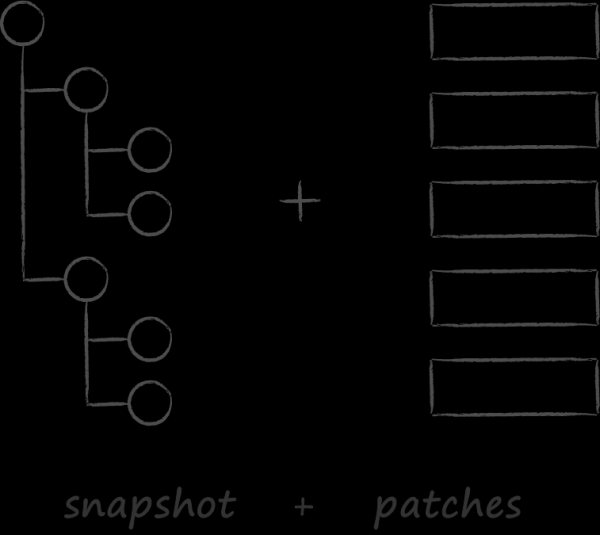 Ein weiterer bedeutender Faktor, der die Wahl der Datenbank beeinflusste, ist unsere Cloud-API. Sie wurde von dem Synchronisationsansatz inspiriert, der in git übernommen wurde. Wie dieses zielt auch unser Ansatz auf , was für Cloud-Kunden mehr als passend erscheint. Es war geplant, dass sie nur einmal den gesamten Zustand der Cloud herunterladen und dann in den überwiegenden meisten Fällen die Synchronisation durch das Einspielen von Änderungen erfolgen wird. Leider befindet sich diese Möglichkeit noch immer nur im theoretischen Bereich, und in der Praxis haben die Kunden nicht gelernt, mit Patches umzugehen. Dafür gibt es eine Reihe objektiver Gründe, die wir der Übersichtlichkeit halber außen vor lassen. Derzeit sind die lehrreichen Ergebnisse der Lektion darüber, was passiert, wenn die API „A“ sagt und ihr Verbraucher nicht „B“ sagt, von viel größerem Interesse.
Wenn Sie sich also git vorstellen, das beim Ausführen des Befehls pull anstelle der Anwendung von Patches auf einen lokalen Snapshot dessen vollständigen Status mit dem vollständigen Serverstatus vergleicht, haben Sie eine ziemlich präzise Vorstellung davon, wie die Synchronisation in Cloud-Clients erfolgt. Es ist nicht schwer zu erraten, dass dafür zwei DOM-Bäume im Speicher mit Metainformationen über alle Server- und lokalen Dateien alloziert werden müssen. Das bedeutet, dass, wenn ein Benutzer 500.000 Dateien in der Cloud speichert, zur Synchronisation zwei Bäume mit 1 Million Knoten rekonstruiert und zerstört werden müssen. Jeder Knoten ist schließlich ein Aggregat, das einen Graph von Unterobjekten enthält. Vor diesem Hintergrund sind die Ergebnisse der Profilierung nicht überraschend. Es hat sich herausgestellt, dass selbst ohne Berücksichtigung der Algorithmik von Merges allein das Erstellen und anschließende Zerstören einer großen Anzahl kleiner Objekte bereits ins Geld geht. Die Situation wird dadurch verschärft, dass die grundlegende Synchronisationsoperation in eine große Anzahl von Benutzerszenarien integriert ist. Als Ergebnis dokumentieren wir das zweite wichtige Kriterium bei der Auswahl einer Datenbank – die Möglichkeit, CRUD-Operationen ohne dynamische Allokation von Objekten durchzuführen.
Die anderen Anforderungen sind traditioneller und ihre vollständige Liste sieht folgendermaßen aus.
- Thread-Sicherheit.
- Multiprozessorfähigkeit. Diktierte den Wunsch, dieselbe Instanz der Datenbank für die Synchronisation des Status nicht nur zwischen Threads, sondern auch zwischen der Hauptanwendung und iOS-Extensions zu verwenden.
- Die Möglichkeit, gespeicherte Entitäten als nicht veränderbare Objekte darzustellen.
- Keine dynamischen Allokationen im Rahmen von CRUD-Operationen.
- Unterstützung der grundlegenden Eigenschaften von Transaktionen : Atomarität, Konsistenz, Isolation und Zuverlässigkeit.
- Geschwindigkeit bei den beliebtesten Anwendungsfällen.
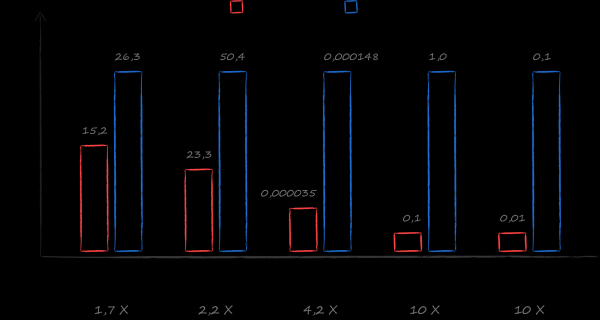
Eine gute Wahl mit diesem Anforderungssatz war und ist SQLite. Im Rahmen der Erforschung von Alternativen bin ich auf ein Buch gestoßen . Unter ihrer Leitung wurde ein Benchmark erstellt, der die Geschwindigkeit der Arbeit mit verschiedenen Datenbanken in realen Cloud-Szenarien vergleicht. Das Ergebnis übertraf die kühnsten Erwartungen. Bei den beliebtesten Anwendungsfällen — dem Abrufen eines Cursors für eine sortierte Liste aller Dateien und einer sortierten Liste aller Dateien für ein bestimmtes Verzeichnis — war LMDB zehnmal schneller als SQLite. Die Wahl wurde offensichtlich.
2. Positionierung von LMDB
LMDB ist eine sehr kleine Bibliothek (nur 10K Zeilen), die die grundlegendste Schicht von Datenbanken — das Speichersystem — implementiert.
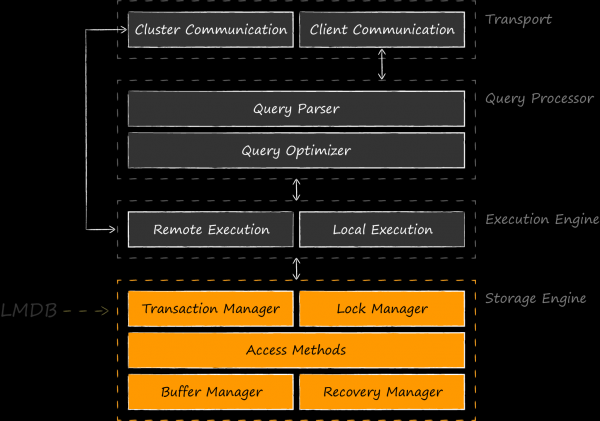
Das dargestellte Diagramm zeigt, dass es nicht korrekt ist, LMDB mit SQLite zu vergleichen, das auch höhere Ebenen implementiert, ähnlich wie man SQLite nicht mit Core Data vergleichen sollte. Es wäre gerechter, gleichwertige Speicher-Engines wie BerkeleyDB, LevelDB, Sophia, RocksDB usw. zu vergleichen. Es gibt sogar Entwicklungen, bei denen LMDB als Komponenten-Storage-Engine für SQLite dient. Ein erstes solches Experiment fand 2012 statt. von dem Autor von LMDB . , das so faszinierend war, dass sein Vorhaben von OSS-Enthusiasten aufgegriffen wurde und in Form von Fortsetzung fand. Im Januar 2020 stellte der Autor dieses Projekts, Den Shearer, es auf der LinuxConfAu vor.
Die Hauptanwendung von LMDB findet sich als Engine für Anwendungsdatenbanken. Die Bibliothek verdankt ihr Dasein Entwicklern , die mit BerkeleyDB als Basis für ihr Projekt sehr unzufrieden waren. Ausgehend von der bescheidenen Bibliothek , konnte Howard Chu eine der heute populärsten Alternativen schaffen. Dieser Geschichte sowie der internen Struktur von LMDB widmete er seinen sehr intensiven Vortrag . Ein gutes Beispiel für die erfolgreiche Nutzung des Speichers teilte Leonid Jurjew (aka ) von Positive Technologies in seinem Vortrag auf dem Highload 2015 . Darin erläutert er LMDB im Kontext einer ähnlichen Aufgabe zur Implementierung von ReOpenLDAP, während LevelDB einer vergleichenden Kritik unterzogen wurde. Nach der Implementierung entstand bei Positive Technologies sogar ein aktiv entwickelter Fork , der mit sehr interessanten Funktionen, Optimierungen und .
. LMDB wird auch oft als Speicher ohne Modifikationen verwendet. Zum Beispiel hat der Browser Mozilla Firefox für eine Reihe von Bedürfnissen, und ab Version 9 bevorzuge Xcode Die Engine hat sich auch in der Welt der mobilen Entwicklung bemerkbar gemacht. Seine Verwendung findet man an verschiedenen Stellen.
Die Engine hat auch in der Welt der mobilen Entwicklung Aufmerksamkeit erregt. Ihre Verwendung ist nachzuvollziehen. im iOS-Client für Telegram. LinkedIn ist sogar noch weiter gegangen und hat LMDB als Standardspeicher für das eigens entwickelte Daten-Cache-Framework Rocket Data ausgewählt, was in seinem Artikel im Jahr 2016.
LMDB kämpft erfolgreich um einen Platz in der Nische, die BerkeleyDB nach der Übernahme durch Oracle hinterlassen hat. Die Bibliothek wird für ihre Geschwindigkeit und Zuverlässigkeit geliebt, selbst im Vergleich zu ähnlichen Lösungen. Wie bekannt ist, gibt es kein kostenloses Mittagessen, und es ist wichtig, den Trade-off zu betonen, mit dem man bei der Wahl zwischen LMDB und SQLite konfrontiert wird. Das obige Diagramm veranschaulicht, wodurch die erhöhte Geschwindigkeit erreicht wird. Erstens, wir zahlen nicht für zusätzliche Abstraktionsschichten über dem Speichersystem. Es versteht sich von selbst, dass man in einer guten Architektur nicht um sie herumkommt, und sie werden unweigerlich im Anwendungscode erscheinen, aber sie werden viel schlanker sein. Sie enthalten keine Funktionen, die von der spezifischen Anwendung nicht benötigt werden, wie z.B. die Unterstützung für SQL-Abfragen. Zweitens ergibt sich die Möglichkeit, die Abbildung von Anwendungsoperationen auf Anforderungen an das Speichersystem optimal umzusetzen. Wenn SQLite von den durchschnittlichen Anforderungen einer durchschnittlichen Anwendung ausgeht, sind Sie als Anwendungsentwickler bestens über die grundlegenden Lastszenarien informiert. Für eine leistungsfähigere Lösung müssen Sie höhere Kosten sowohl für die Entwicklung der ursprünglichen Lösung als auch für deren nachfolgende Unterstützung in Kauf nehmen.
3. Die drei Säulen von LMDB
Wenn wir LMDB aus der Vogelperspektive betrachten, ist es an der Zeit, tiefer einzutauchen. Die nächsten drei Abschnitte widmen sich der Analyse der grundlegenden Säulen, auf denen die Architektur des Speichers ruht:
- Speicherabbilddateien als Mechanismus zur Arbeit mit der Festplatte und zur Synchronisation interner Datenstrukturen.
- B+-Baum als Organisation der Struktur der gespeicherten Daten.
- Copy-on-Write als Ansatz zur Gewährleistung der ACID-Eigenschaften von Transaktionen und Multi-Versioning.
3.1. Säule Nr. 1. Speicherabbilddateien
Die in den Speicher abgebildeten Dateien sind ein so wichtiger architektonischer Bestandteil, dass sie sogar im Namen des Speichers auftauchen. Die Fragen der Caching- und Synchronisierung des Zugriffs auf die gespeicherten Informationen liegen vollständig in der Verantwortung des Betriebssystems. LMDB enthält keinerlei Caches. Dies ist eine bewusste Entscheidung des Autors, da das direkte Lesen von Daten aus den abgebildeten Dateien zahlreiche Umwege in der Implementierung der Engine vermeidet. Im Folgenden sind einige der vielen Punkte aufgeführt.
- Die Aufrechterhaltung der Konsistenz der Daten im Speicher beim Zugriff aus mehreren Prozessen liegt in der Verantwortung des Betriebssystems. Im nächsten Abschnitt wird diese Mechanik im Detail und mit Bildern behandelt.
- Das Fehlen von Caches befreit LMDB vollständig von den Overhead-Kosten, die mit dynamischen Allokationen verbunden sind. Das Lesen von Daten stellt in der Praxis lediglich die Einrichtung eines Zeigers auf die richtige Adresse im virtuellen Speicher dar und nicht mehr. Das klingt nach Science-Fiction, aber im Quellcode des Speichers sind alle Aufrufe von salloc in der Funktion zur Konfiguration des Speichers konzentriert.
- Das Fehlen von Caches bedeutet auch das Fehlen von Sperren, die mit der Synchronisierung ihres Zugriffs verbunden sind. Leser, von denen jederzeit beliebig viele existieren können, begegnen auf ihrem Weg zu den Daten keinem einzigen Mutex. Dadurch hat die Leseleistung eine ideale lineare Skalierbarkeit entsprechend der CPU-Anzahl. In LMDB unterliegen nur modifizierende Operationen der Synchronisierung. Es kann immer nur einen Schreiber gleichzeitig geben.
- Die minimale Logik von Caching und Synchronisierung befreit den Code von äußerst komplizierten Fehlern, die durch den Betrieb in einer Mehrfadenumgebung entstehen können. Auf der Usenix OSDI 2014 fanden sich zwei interessante Datenbankforschungen: und . Aus ihnen kann man sowohl Informationen über die beispiellose Zuverlässigkeit von LMDB als auch über die praktisch makellose Implementierung der ACID-Eigenschaften von Transaktionen entnehmen, die in SQLite übertroffen werden.
- Die Minimalität von LMDB erlaubt es, dass ihre Maschinenrepräsentation vollständig im L1-Cache des Prozessors untergebracht werden kann, was sich in den entsprechend hohen Geschwindigkeitsmerkmalen niederschlägt.
Leider ist die Situation mit den im Speicher angezeigten Dateien unter iOS nicht so rosig, wie man es sich wünschen würde. Um die damit verbundenen Nachteile gezielter zu besprechen, ist es notwendig, die allgemeinen Prinzipien der Implementierung dieses Mechanismus in Betriebssystemen in Erinnerung zu rufen.
Allgemeine Informationen zu im Speicher angezeigten Dateien
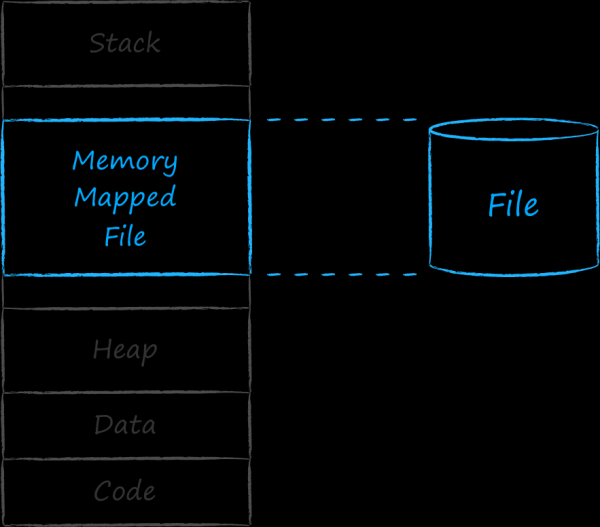 Mit jeder ausführbaren Anwendung assoziiert das Betriebssystem eine Entität namens Prozess. Jederem Prozess wird ein zusammenhängender Adressbereich zugewiesen, in dem er alles unterbringt, was er für seine Arbeit benötigt. In den niedrigsten Adressen befinden sich Abschnitte mit Code sowie fest kodierten Daten und Ressourcen. Darauf folgt ein aufsteigender Block des dynamischen Adressraums, der uns unter dem Namen Heap gut bekannt ist. In ihm stehen die Adressen von Entitäten, die während der Programmausführung entstehen. Oben befindet sich der Speicherbereich, der vom Stack der Anwendung genutzt wird. Dieser wächst und schrumpft, anders ausgedrückt, seine Größe hat ebenfalls eine dynamische Natur. Damit der Stack und der Heap sich nicht gegenseitig in die Quere kommen, sind sie an verschiedenen Enden des Adressraums angesiedelt. Zwischen diesen beiden dynamischen Abschnitten gibt es ein Loch. Die Adressen in diesem mittleren Abschnitt nutzt das Betriebssystem zur Assoziation verschiedener Entitäten mit dem Prozess. Insbesondere kann es einem kontinuierlichen Adresssatz eine Datei auf der Festplatte zuordnen. Eine solche Datei wird als im Speicher angezeigte Datei bezeichnet.
Der dem Prozess zugewiesene Adressraum ist gewaltig. Theoretisch ist die Anzahl der Adressen nur durch die Größe des Zeigers begrenzt, die sich aus der Bitanzahl des Systems ergibt. Wenn ihm 1:1 physischer Speicher zugeordnet wäre, würde der erste Prozess sofort den gesamten Arbeitsspeicher aufbrauchen, und von Multitasking könnte keine Rede sein.
Jedoch wissen wir aus eigener Erfahrung, dass moderne Betriebssysteme gleichzeitig beliebig viele Prozesse ausführen können. Das ist möglich, weil sie den Prozessen nur auf dem Papier eine Menge Speicher zuweisen, in der Praxis jedoch nur den Teil in den Hauptspeicher laden, der im Moment benötigt wird. Daher wird der mit dem Prozess verknüpfte Speicher als virtuell bezeichnet.
Das Betriebssystem organisiert den virtuellen und physischen Speicher in Form von Seiten einer bestimmten Größe. Sobald eine Seite des virtuellen Speichers benötigt wird, lädt das Betriebssystem sie in den physischen Speicher und stellt eine Zuordnung in einer speziellen Tabelle her. Wenn keine freien Slots vorhanden sind, wird eine der zuvor geladenen Seiten auf die Festplatte kopiert, und die geforderte nimmt ihren Platz ein. Dieses Verfahren, auf das wir bald zurückkommen werden, wird als Swapping bezeichnet. Die untenstehende Abbildung illustriert den beschriebenen Prozess. Dort wurde die Seite A mit der Adresse 0 geladen und auf die Seite des Hauptspeichers mit der Adresse 4 platziert. Diese Tatsache spiegelt sich in der Zuordnungstabelle im Feld Nummer 0 wider.
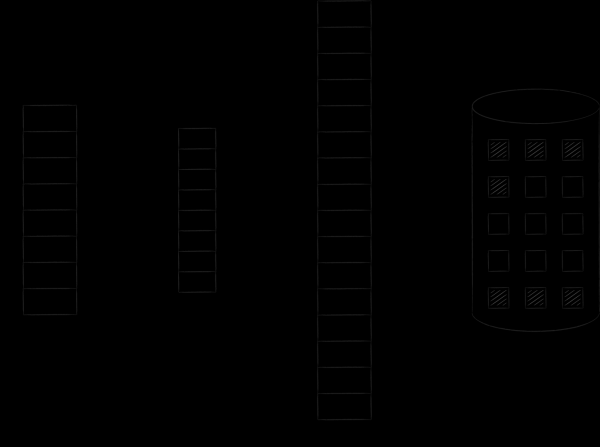
Die Geschichte der in den Speicher angezeigten Dateien ist genau die gleiche. Logisch gesehen scheinen sie kontinuierlich und vollständig im virtuellen Adressraum platziert zu sein. Dennoch gelangen sie nur seitenweise und auf Anfrage in den physischen Speicher. Änderungen an solchen Seiten werden mit der Datei auf der Festplatte synchronisiert. So kann man Datei-Ein-/Ausgaben durchführen, indem man einfach mit Bytes im Speicher arbeitet – alle Änderungen werden automatisch vom Betriebssystem-Kern in die ursprüngliche Datei übertragen.
Die folgende Abbildung demonstriert, wie LMDB seinen Zustand synchronisiert, während es mit der Datenbank aus verschiedenen Prozessen arbeitet. Indem wir den virtuellen Speicher verschiedener Prozesse auf dieselbe Datei abbilden, verpflichten wir de facto das Betriebssystem, bestimmte Blöcke ihrer Adressräume transitiv untereinander zu synchronisieren, auf die LMDB zugreift.
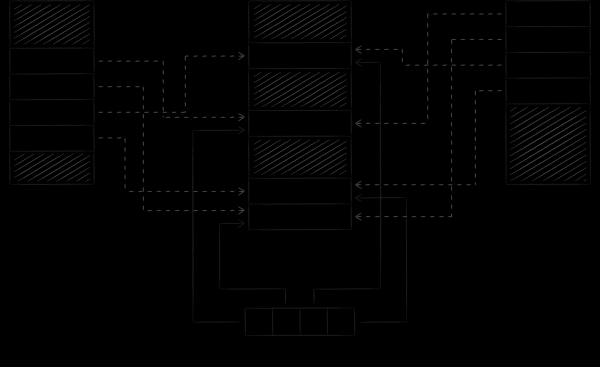
Ein wichtiger Punkt ist, dass LMDB standardmäßig die Datei mit den Daten über den Systemaufruf write modifiziert, während die Datei selbst im nur-Lese-Modus abgebildet wird. Dieser Ansatz hat zwei wichtige Konsequenzen.
Die erste Folge ist für alle Betriebssysteme allgemein. Ihr Inhalt besteht darin, einen Schutz vor unbeabsichtigter Beschädigung der Datenbank durch fehlerhaften Code hinzuzufügen. Wie bekannt ist, können die ausführenden Anweisungen eines Prozesses auf Daten aus jedem Teil seines Adressraums zugreifen. Gleichzeitig bedeutet das Abbilden einer Datei im Lese-Schreib-Modus, dass jede Anweisung sie zusätzlich modifizieren kann. Wenn dies versehentlich geschieht, etwa beim Versuch, ein Element eines Arrays an einem nicht bestehenden Index zu überschreiben, könnte dies dazu führen, dass die auf diese Adresse abgebildete Datei versehentlich verändert wird, was zu einer Beschädigung der Datenbank führt. Wenn die Datei jedoch im schreibgeschützten Modus abgebildet ist, führt der Versuch, den entsprechenden Adressraum zu ändern, zu einem Programmabbruch mit einem Signal SIGSEGV, und die Datei bleibt intakt.
Die zweite Folge ist bereits spezifisch für iOS. Weder der Autor noch irgendwelche anderen Quellen erwähnen dies ausdrücklich, aber ohne ihn wäre LMDB für die Arbeit in diesem mobilen Betriebssystem ungeeignet. Der nächsten Abschnitt widmet sich dieser Thematik.
Die Spezifik der in den Speicher abgebildeten Dateien in iOS
Auf der WWDC 2018 gab es einen hervorragenden Vortrag . Darin wird erläutert, dass in iOS alle Seiten, die sich im physischen Speicher befinden, in eine der 3 Typen eingeteilt sind: dirty, compressed und clean.
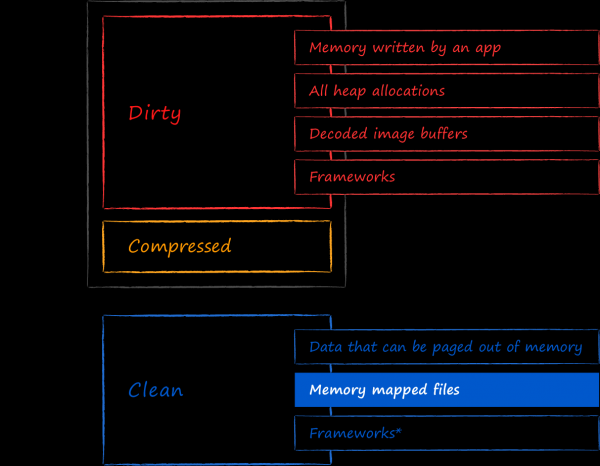
Clean Memory sind alle Seiten, die schmerzlos aus dem physischen Speicher ausgelagert werden können. Die darin enthaltenen Daten können bei Bedarf wieder aus ihren ursprünglichen Quellen geladen werden. Read-Only Memory-mapped Dateien fallen genau in diese Kategorie. iOS hat keine Angst, jederzeit die auf die Datei abgebildeten Seiten aus dem Speicher auszulagern, da sie garantiert mit der Datei auf der Festplatte synchronisiert sind.
In den Dirty Memory fallen alle modifizierten Seiten, unabhängig davon, wo sie ursprünglich gespeichert waren. Insbesondere werden auch die über das Schreiben auf den zugehörigen virtuellen Speicher modifizierten Memory-mapped Dateien so klassifiziert. Wenn man LMDB mit dem Flag MDB_WRITEMAP, öffnet, kann man sich persönlich davon überzeugen, nachdem Änderungen vorgenommen wurden.
Sobald die Anwendung zu viel physischen Speicher belegt, komprimiert iOS die dirty Seiten. Der Gesamtumfang des Speichers, der von dirty und komprimierten Seiten belegt wird, wird als sogenannter Memory Footprint der Anwendung bezeichnet. Wenn dieser einen bestimmten Schwellenwert erreicht, wird der Systemdaemon OOM-Killer aktiv und beendet den Prozess zwangsweise. Das ist eine Besonderheit von iOS im Vergleich zu Desktop-Betriebssystemen. Im Gegensatz zu diesen ist in iOS kein Absenken des Memory Footprints durch das Swapping von Seiten aus dem physischen Speicher auf die Festplatte vorgesehen. Die Gründe hierfür sind nur Spekulation. Möglicherweise ist der Prozess des intensiven Verschiebens von Seiten auf die Festplatte und zurück zu energieintensiv für mobile Geräte, oder iOS spart die Ressourcen für das Überschreiben von Zellen auf SSDs, oder vielleicht waren die Designer mit der allgemeinen Systemleistung nicht zufrieden, wo alles ständig geswappt wird. Wie dem auch sei, Fakt ist Fakt.
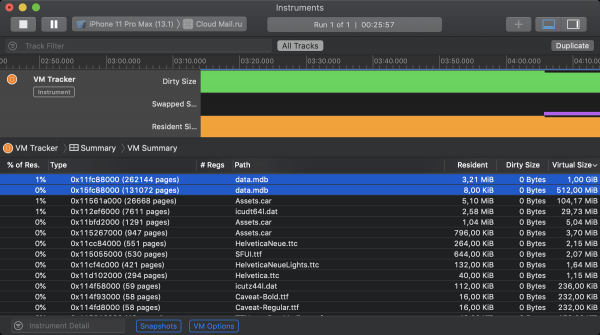
Die gute Nachricht, die bereits zuvor erwähnt wurde, ist, dass LMDB standardmäßig keinen mmap-Mechanismus für die Aktualisierung von Dateien verwendet. Das bedeutet, dass die angezeigten Daten von iOS als saubere Speicherinhalte klassifiziert werden und nicht zum Memory Footprint beitragen. Das lässt sich mit dem Xcode-Tool namens VM Tracker überprüfen. Auf dem untenstehenden Screenshot ist der Zustand des virtuellen Speichers der iOS-Anwendung für Cloud während der Ausführung dargestellt. Zu Beginn wurden 2 Instanzen von LMDB initialisiert. Der ersten wurde erlaubt, ihre Datei im virtuellen Speicher auf 1 GiB abzubilden, der zweiten auf 512 MiB. Obwohl beide Speicher einen bestimmten Umfang an residentem Speicher belegen, trägt keine von ihnen zur dirty Größe bei.
Und jetzt zu den schlechten Nachrichten. Durch den Swapping-Mechanismus in 64-Bit-Desktop-Betriebssystemen kann jeder Prozess so viel virtuelles Adressraum einnehmen, wie der freie Platz auf der Festplatte für sein potenzielles Swapping zulässt. Der Wechsel von Swapping zu Kompression in iOS reduziert das theoretische Maximum radikal. Jetzt müssen alle laufenden Prozesse im Haupt- (d. h. RAM) Speicher untergebracht werden, und alle, die nicht hinein passen, unterliegen der Zwangsbeendigung. Dies wird sowohl in der oben genannten als auch in der weitergehenden... , als auch in Folglich begrenzt iOS rigoros die Größe des Speichers, der über mmap zugewiesen werden kann. Hier ist. Man kann die empirischen Grenzwerte des Speicherplatzes betrachten, der auf verschiedenen Geräten mit diesem Systemaufruf zugewiesen werden konnte. Bei den modernsten iOS-Smartphones wurden 2 Gigabyte bereitgestellt, während die Top-Versionen des iPads sogar 4 Gigabyte erhielten. In der Praxis ist es jedoch notwendig, sich nach den ältesten unterstützten Modelle zu orientieren, wo die Situation sehr trist ist. Schlimmer noch, wenn man den Speicherstatus der Anwendung im VM Tracker betrachtet, stellt man fest, dass LMDB nicht die einzige ist, die sich um den speichermape Speicher bemüht. Gute Teile werden von den System-Allocatoren, Ressourcen-Dateien, Bildbearbeitungsframeworks und anderen kleineren Räubern in Anspruch genommen.
Nach den Ergebnissen der Experimente in der Cloud kamen wir zu den folgenden Kompromisswerten für den zugewiesenen LMDB-Speicher: 384 Megabyte für 32-Bit-Geräte und 768 Megabyte für 64-Bit-Geräte. Nach Verbrauch dieses Volumens beginnen alle modifizierenden Operationen mit dem Code MDB_MAP_FULL. Solche Fehler beobachten wir in unserem Monitoring, aber sie sind so selten, dass sie in diesem Stadium vernachlässigt werden können.
Eine nicht offensichtliche Ursache für den übermäßigen Speicherverbrauch durch den Speicher könnte die langanhaltenden Transaktionen sein. Um zu verstehen, wie diese beiden Phänomene zusammenhängen, hilft uns die Betrachtung der verbleibenden zwei Grundlagen von LMDB.
3.2. Grundlage Nr. 2. B+-Baum
Um Tabellen über einem Key-Value-Speicher zu emulieren, müssen die folgenden Operationen in der API des Speichers vorhanden sein:
- Einfügen eines neuen Elements.
- Suchen eines Elements mit einem bestimmten Schlüssel.
- Löschen eines Elements.
- Iterieren über Schlüsselintervalle in der Reihenfolge ihrer Sortierung.
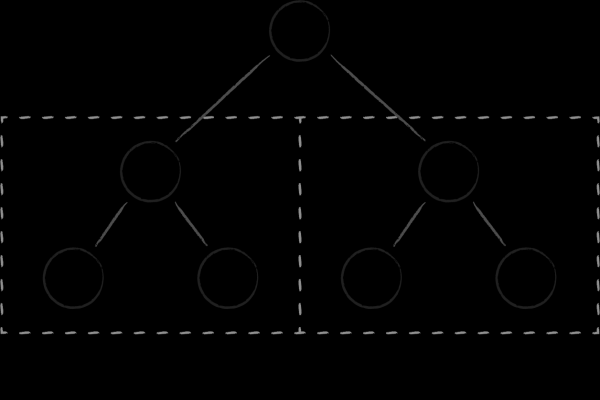 Die einfachste Datenstruktur, mit der alle vier Operationen leicht umgesetzt werden können, ist der binäre Suchbaum. Jeder Knoten stellt einen Schlüssel dar, der das gesamte Teilmengen der untergeordneten Schlüssel in zwei Teilbäume unterteilt. Im linken werden die Schlüssel gesammelt, die kleiner als der übergeordnete sind, und im rechten die, die größer sind. Der Erhalt einer geordneten Menge von Schlüsseln erfolgt durch einen der klassischen Baumdurchläufe.
Binarbäume haben zwei grundlegende Nachteile, die sie als Datenspeicher auf Festplatten ineffizient machen. Erstens ist der Grad ihrer Ausgewogenheit unvorhersehbar. Es besteht ein nicht unerheblicher Risikos, Bäume zu erhalten, bei denen die Höhe der verschiedenen Zweige stark variieren kann, was die algorithmische Komplexität der Suche im Vergleich zu den Erwartungen erheblich verschlechtert. Zweitens raubt die Fülle an Querverweisen zwischen den Knoten den Binarbäumen die Lokalität im Speicher. Nahegelegene Knoten (in Bezug auf die Verbindungen zwischen ihnen) können sich auf völlig verschiedenen Seiten im virtuellen Speicher befinden. Dies führt dazu, dass selbst für eine einfache Durchquerung mehrerer benachbarter Knoten im Baum eine vergleichbare Anzahl von Seiten besucht werden muss. Dies ist ein Problem, selbst wenn wir über die Effizienz von Binarbäumen als In-Memory-Datenstruktur nachdenken, da die ständige Rotation von Seiten im Cache des Prozessors teuer wird. Wenn es darum geht, häufig die mit den Knoten verbundenen Seiten von der Festplatte zu laden, wird die Situation noch schlimmer. .
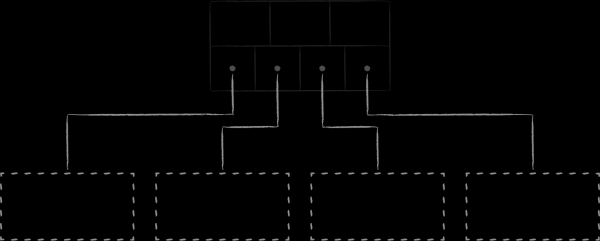 B-Bäume, die eine Evolution der Binarbäume darstellen, lösen die im vorherigen Absatz genannten Probleme. Erstens sind sie selbstbalancierend. Zweitens unterteilt jeder Knoten eine Vielzahl von Tochter-Schlüsseln nicht in 2, sondern in M geordnete Teilmengen, wobei M ziemlich groß sein kann, im Bereich von mehreren Hundert bis hin zu Tausenden.
Durch diese Struktur:
- Befinden sich in jedem Knoten eine große Anzahl bereits geordneter Schlüssel, wodurch die Bäume sehr niedrig werden.
- Der Baum erlangt die Eigenschaft der Lokalität der Speicherung im Speicher, da nahegelegene Schlüssel aufgrund ihrer Werte auf natürliche Weise nahe beieinander in einem oder benachbarten Knoten angeordnet sind.
- Die Anzahl der transitiven Knoten verringert sich beim Herabsteigen im Baum während der Suchoperation.
- Die Anzahl der zu lesenden Zielknoten bei Range-Abfragen verringert sich, da jeder von ihnen bereits eine große Anzahl geordneter Schlüssel enthält.
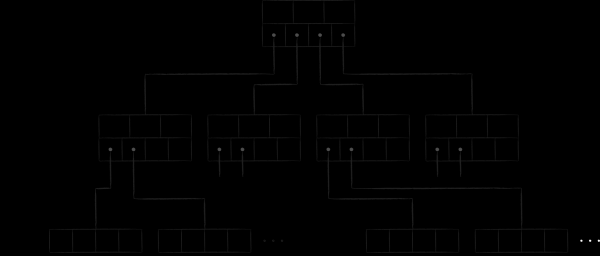
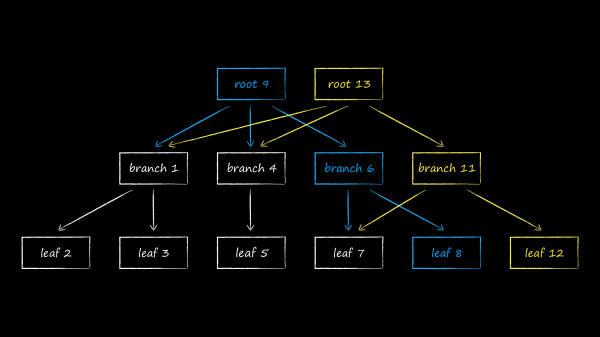
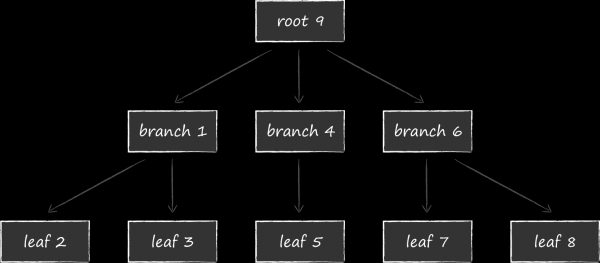
In LMDB wird eine der Varianten des B-Baums, das B+-Baum, zur Speicherung von Daten verwendet. In der obigen Abbildung sind drei Arten von Knoten dargestellt, die darin vorkommen:
- An der Spitze befindet sich die Wurzel (root). Sie verkörpert nichts anderes als das Konzept einer Datenbank innerhalb des Speichers. Innerhalb einer LMDB-Instanz können mehrere Datenbanken erstellt werden, die sich den abgebildeten virtuellen Adressraum teilen. Jede von ihnen beginnt mit ihrer eigenen Wurzel.
- Am unteren Ende befinden sich die Blätter (leaf). Nur sie enthalten die in der Datenbank gespeicherten Schlüssel-Wert-Paare. Das ist das Besondere an B+-Bäumen. Während ein regulärer B-Baum die Value-Teile in den Knoten aller Ebenen speichert, speichert die B+-Variation nur auf der untersten Ebene. Nachdem wir diesen Fakt festgestellt haben, werden wir den verwendeten Baumtyp in LMDB einfach B-Baum nennen.
- Zwischen der Wurzel und den Blättern befinden sich 0 oder mehr technische Ebenen mit Navigationsknoten (branch). Ihre Aufgabe besteht darin, die sortierte Menge der Schlüssel auf die Blätter zu verteilen.
Physisch sind die Knoten Blöcke von vordefinierter Länge im Speicher. Ihre Größe ist ein Vielfaches der Seitengröße des Speichers im Betriebssystem, über die wir zuvor gesprochen haben. Unten ist die Struktur eines Knotens dargestellt. Im Header befinden sich Metainformationen, die offensichtlichste für unser Beispiel ist die Prüfziffer. Danach folgen Informationen über die Offsets, die angeben, wo sich die Datenspeicher befinden. Bei den Daten kann es sich um Schlüssel handeln, wenn wir von den Navigationsknoten sprechen, oder um komplette Schlüssel-Wert-Paare im Fall der Blätter. Mehr über die Struktur der Seiten kann in der Arbeit gelesen werden .
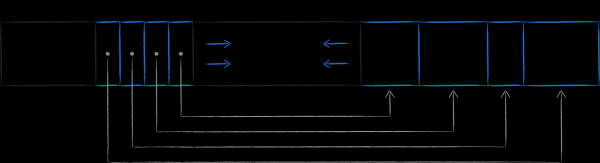
Nachdem wir uns mit dem inneren Inhalt der Seitenknoten beschäftigt haben, werden wir den B-Baum von LMDB nachfolgend vereinfacht darstellen.
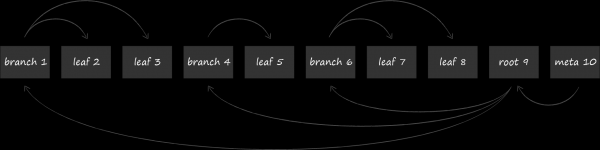
Die Seiten mit den Knoten sind auf der Festplatte nacheinander angeordnet. Seiten mit höheren Nummern befinden sich näher am Ende der Datei. Die sogenannte Metaseite (meta page) enthält Informationen über die Offsets, die angeben, wo die Wurzeln aller Bäume zu finden sind. Beim Öffnen der LMDB-Datei scannt das System die Datei seitenweise vom Ende zum Anfang auf der Suche nach einer gültigen Metaseite und findet darüber die existierenden Datenbanken.
Jetzt, da man ein Verständnis für die logische und physikalische Struktur der Datenorganisation hat, kann man sich dem dritten Grundpfeiler von LMDB widmen. Mit seiner Hilfe erfolgen alle Modifikationen des Speichers transaktional und isoliert voneinander, wodurch der Datenbank insgesamt auch die Eigenschaft der Multi-Versionierung verliehen wird.
3.3. Grundpfeiler Nr. 3. Copy-on-Write
Einige Operationen mit dem B-Baum erfordern eine Reihe von Änderungen in seinen Knoten. Ein Beispiel ist das Hinzufügen eines neuen Schlüssels zu einem Knoten, der bereits seine maximale Kapazität erreicht hat. In diesem Fall muss zunächst der Knoten in zwei Teile geteilt werden und zweitens muss ein Verweis auf den neuen abgezweigten Kindknoten im übergeordneten Knoten hinzugefügt werden. Dieser Prozess ist potenziell sehr gefährlich. Wenn aus irgendeinem Grund (Absturz, Stromausfall usw.) nur ein Teil der Änderungen aus der Reihe durchgeführt wird, bleibt der Baum in einem inkonsistenten Zustand.
Eine der traditionellen Lösungen zur Gewährleistung der Ausfallsicherheit einer Datenbank besteht darin, neben dem B-Baum eine zusätzliche Datenspeicherstruktur, das Transaktionsprotokoll, auch bekannt als Write-Ahead Log (WAL), hinzuzufügen. Dabei handelt es sich um eine Datei, in die die beabsichtigte Operation strikt vor der Modifikation des eigentlichen B-Baums geschrieben wird. So kann, wenn während einer Selbstdiagnose Datenkorruption festgestellt wird, die Datenbank das Protokoll zur Wiederherstellung heranziehen.
LMDB hat für die Bereitstellung von Ausfallsicherheit einen anderen Ansatz gewählt, der als Copy-on-Write bezeichnet wird. Dabei werden anstelle der Aktualisierung von Daten auf einer bestehenden Seite diese zunächst vollständig kopiert, und alle Modifikationen werden bereits in der Kopie vorgenommen.
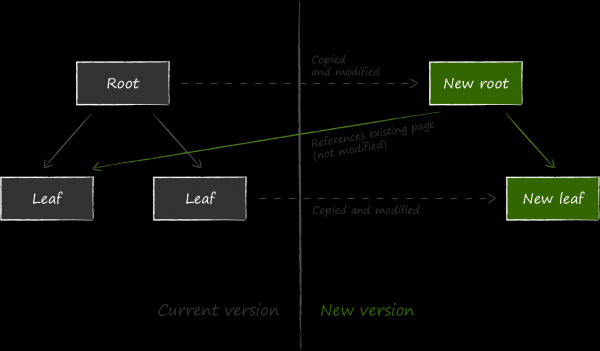
Um sicherzustellen, dass die aktualisierten Daten verfügbar sind, muss der Verweis auf den nun relevanten Knoten im übergeordneten Knoten geändert werden. Da auch dieser modifiziert werden muss, wird er ebenfalls zuerst kopiert. Der Vorgang setzt sich rekursiv bis zur Wurzel fort. Zuletzt werden die Daten auf der Metadatei geändert.
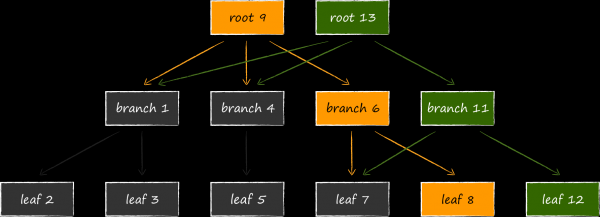
Wenn während des Aktualisierungsprozesses ein unerwartetes Ende des Prozesses auftritt, wird entweder die neue Meta-Seite nicht erstellt oder sie wird bis zum Ende nicht auf die Festplatte geschrieben, sodass ihre Prüfziffer ungültig ist. In beiden Fällen sind die neuen Seiten unerreichbar, während die alten nicht betroffen sind. Dies erspart LMDB die Notwendigkeit, ein Write Ahead Log zur Aufrechterhaltung der Datenkonsistenz zu führen. Die oben beschriebene Datenstruktur auf der Festplatte übernimmt gleichzeitig deren Funktion. Das Fehlen eines expliziten Transaktionslogs ist eines der Merkmale von LMDB, das hohe Lesegeschwindigkeiten gewährleistet.
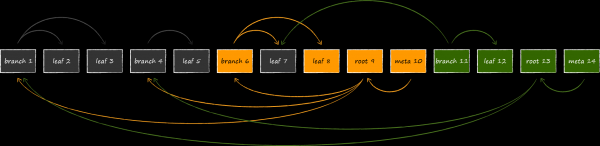
Die entstehende Struktur, die als Append-Only B-Baum bezeichnet wird, sorgt ganz natürlich für die Isolierung von Transaktionen und Mehrversionierung. In LMDB ist mit jeder offenen Transaktion der aktuelle Baumwurzelpflicht verknüpft. Solange die Transaktion nicht abgeschlossen ist, werden die Seiten des zugehörigen Baums niemals geändert oder für neue Datenversionen wiederverwendet. So kann man so lange arbeiten, wie man möchte mit genau dem Datensatz, der zum Zeitpunkt der Eröffnung der Transaktion relevant war, selbst wenn das Speicher währenddessen weiterhin aktiv aktualisiert wird. Das ist das Wesen der Mehrversionierung, die LMDB zur idealen Datenquelle für uns alle macht. UICollectionView. Wenn eine Transaktion geöffnet wird, muss der Speicherbedarf der Anwendung nicht erhöht werden, indem man hastig die relevanten Daten in eine in-memory Struktur überträgt, aus Angst, beim Wortbruch mitten im Nichts zu stehen. Dieses Merkmal hebt LMDB vorteilhaft von SQLite ab, das nicht mit einer solchen umfassenden Isolierung aufwarten kann. Wenn zwei Transaktionen im letzteren geöffnet werden und ein Datensatz in einer von ihnen gelöscht wird, kann dieser Datensatz in der zweiten verbleibenden nicht mehr abgerufen werden.
Die Kehrseite der Medaille ist ein potenziell wesentlich höherer Verbrauch an virtuellem Speicher. Auf der Folie ist dargestellt, wie die Datenbankstruktur aussehen wird, wenn sie gleichzeitig mit 3 geöffneten Lese-Transaktionen, die auf verschiedene Versionen der Datenbank blicken, modifiziert wird. Da LMDB keine Knoten, die von den Wurzeln aktueller Transaktionen erreichbar sind, wiederverwenden kann, bleibt dem Speicher nichts anderes übrig, als einen weiteren vierten Wurzelknoten im Speicher zu platzieren und die modifizierbaren Seiten erneut zu klonen.
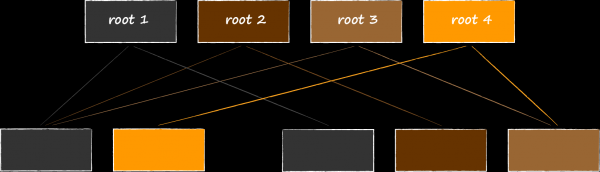
Es ist nicht lästig, sich an den Abschnitt über speicherkartierte Dateien zu erinnern. Obwohl der zusätzliche Verbrauch an virtuellem Speicher uns nicht allzu sehr beunruhigen sollte, da er keinen Beitrag zur Speicherauslastung der Anwendung leistet. Es wurde jedoch festgestellt, dass iOS bei der Zuteilung äußerst sparsam ist, und wir können nicht wie auf einem Server oder Desktop einfach einen LMDB-Bereich von 1 Terabyte bereitstellen und uns keine Gedanken über diese Besonderheit machen. Soweit möglich, sollten wir versuchen, die Lebensdauer der Transaktionen so kurz wie möglich zu gestalten.
4. Entwurf des Datenschemas über die Key-Value-API
Wir beginnen die Analyse der API mit den grundlegenden Abstraktionen, die von LMDB bereitgestellt werden: Umgebung und Datenbanken, Schlüssel und Werte, Transaktionen und Cursors.
Anmerkung zu den Code-Listings
Alle Funktionen in der öffentlichen API von LMDB geben das Ergebnis ihrer Arbeit in Form eines Fehlercodes zurück, aber in allen nachfolgenden Listings wird diese Überprüfung zugunsten der Knappheit weggelassen. In der Praxis haben wir für die Interaktion mit dem Speicher unsere C++-Wrapper , in dem Fehler als C++-Ausnahmen materialisiert werden.
Als schnellster Weg, LMDB in ein Projekt für iOS oder macOS einzubinden, schlage ich mein CocoaPod vor .
4.1. Grundlegende Abstraktionen
Umgebung (environment)
Struktur MDB_env ist das Speicherreservoir des internen Zustands von LMDB. Die Funktionalitäten mit dem Präfix mdb_env ermöglichen es, einige seiner Eigenschaften zu konfigurieren. Im einfachsten Fall sieht die Initialisierung der Engine folgendermaßen aus.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);In der Mail.ru Cloud-Anwendung haben wir die Standardwerte lediglich bei zwei Parametern geändert.
Der erste Punkt betrifft die Größe des virtuellen Adressraums, in den die Speicherdaten abgebildet werden. Leider kann der spezifische Wert selbst auf demselben Gerät von Ausführung zu Ausführung erheblich variieren. Um diese Besonderheit von iOS zu berücksichtigen, wird der maximale Speicherplatz dynamisch festgelegt. Beginnend mit einem bestimmten Wert wird er schrittweise halbiert, bis die Funktion mdb_env_open ein Ergebnis zurückgibt, das sich von ENOMEMunterscheidet. Theoretisch gibt es auch einen entgegengesetzten Weg — zunächst dem Engine ein Minimum an Speicher zuzuweisen und dann, beim Auftreten von Fehlern, dessen Größe zu erhöhen. Dieser Ansatz ist jedoch viel komplizierter. Der Grund liegt darin, dass der Prozess der Speicherumverteilung (remap) durch die Funktion MDB_MAP_FULLmdb_env_set_map_size alle Entitäten (Cursors, Transaktionen, Schlüssel und Werte), die zuvor von der Engine erhalten wurden, ungültig macht. Diese Wendung im Code zu berücksichtigen, führt zu einer erheblichen Komplexität. Wenn Ihnen jedoch virtueller Speicher sehr wichtig ist, könnte dies ein Grund sein, einen Fork in Betracht zu ziehen, der weit voraus ist, , bei dem unter den angekündigten Features "automatische Anpassung der Datenbankgröße im laufenden Betrieb" enthalten ist. Der zweite Parameter, dessen Standardwert für uns nicht geeignet war, regelt die Mechanik der Thread-Sicherheit. Leider gibt es mindestens in iOS 10 Probleme mit der Unterstützung von Thread-Local Storage. Aus diesem Grund wird im obigen Beispiel das Speicher-Handle mit dem Flag
MDB_NOTLS geöffnet. Außerdem mussten wir auch dieC++-Wrapper Die Datenbank ist eine separate Instanz eines B-Baums, über den wir oben gesprochen haben. Ihre Öffnung erfolgt innerhalb einer Transaktion, was zunächst etwas seltsam erscheinen mag. MDB_txn *txn; MDB_dbi dbi; mdb_txn_begin(env, NULL, MDB_RDONLY, &txn); mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi); mdb_txn_abort(txn);
Datenbanken
In der Tat ist eine Transaktion in LMDB eine Entität des Speichers und nicht einer bestimmten Datenbank. Dieses Konzept ermöglicht atomare Operationen an Entitäten, die sich in verschiedenen Datenbanken befinden. Theoretisch eröffnet dies die Möglichkeit, Tabellen in Form verschiedener Datenbanken zu modellieren, aber ich habe mich damals für einen anderen Weg entschieden, der weiter unten detailliert beschrieben ist.
Schlüssel und WerteMDB_val
Schlüssel und Werte
Struktur MDB_val modelliert das Konzept sowohl von Schlüsseln als auch von Werten. Das Speicherformat hat nicht den leisesten Schimmer von ihrer Semantik. Für es ist etwas, was das andere ist, einfach ein Array von Bytes fester Größe. Die maximale Größe eines Schlüssels beträgt 512 Bytes.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Mit Hilfe des Comparators sortiert das Speicherformat die Schlüssel in aufsteigender Reihenfolge. Wenn man ihn nicht durch einen eigenen ersetzt, wird der Standard verwendet, der sie byteweise in lexikografischer Reihenfolge sortiert.
Transaktionen
Das Transaktionssystem wird ausführlich beschrieben in , daher wiederhole ich hier kurz ihre Hauptmerkmale:
- Unterstützung aller grundlegenden Eigenschaften : Atomarität, Konsistenz, Isolation und Zuverlässigkeit. Ich kann nicht umhin zu bemerken, dass es in Bezug auf die Haltbarkeit unter macOS und iOS einen Fehler gibt, der in MDBX behoben wurde. Weitere Details können in ihrem .
- Ansatz zur Multithreaded-Verarbeitung wird durch das Schema „ein einzelner Schreiber / mehrere Leser“ beschrieben. Schreiber blockieren einander, blockieren jedoch nicht die Leser. Leser blockieren weder Schreiber noch einander.
- Unterstützung für verschachtelte Transaktionen.
- Unterstützung der Multi-Versionierung.
Die Multi-Versionierung in LMDB ist so gut, dass ich sie gerne in der Praxis demonstrieren möchte. Der unten stehende Code zeigt, dass jede Transaktion genau mit der Version der Datenbank arbeitet, die zum Zeitpunkt ihrer Eröffnung aktuell war, und dabei vollständig von allen nachfolgenden Änderungen isoliert bleibt. Die Initialisierung des Speichers und das Hinzufügen eines Testeintrags sind nicht besonders interessant, daher wurden diese Rituale im Spoiler verborgen.
Hinzufügen eines Testeintrags
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Wir öffnen 2 Transaktionen, von denen jede
// die Version der Datenbank mit einem Datensatz betrachtet.
mdb_txn_begin(env, NULL, 0, &txn1); // Lese- und Schreibmodus
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // Nur lesen
// Im Rahmen der ersten Transaktion entfernen wir den bestehenden Datensatz aus der Datenbank.
mdb_del(txn1, dbi, &key, NULL);
// Wir bestätigen die Löschung.
mdb_txn_commit(txn1);
// Wir öffnen die dritte Transaktion, die auf
// die aktuelle Version der Datenbank schaut, in der der Datensatz bereits nicht mehr existiert.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Wir stellen sicher, dass der Datensatz mit dem gesuchten Schlüssel bereits nicht mehr existiert.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Wir beenden die Transaktion.
mdb_txn_abort(txn3);
// Wir stellen sicher, dass wir im Rahmen der zweiten Transaktion, die zum Zeitpunkt
// des Vorhandenseins des Datensatzes geöffnet wurde, ihn nach wie vor über den Schlüssel finden können.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Wir überprüfen, dass wir mit dem Schlüssel keine beliebigen Müll, sondern valide Daten erhalten haben.
assert(*(int *)val.mv_data == 997);
// Wir beenden die Transaktion, die zwar mit einer veralteten, aber konsistenten Datenbank arbeitet.
mdb_txn_abort(txn2);Optional empfehle ich, den gleichen Trick mit SQLite auszuprobieren und zu sehen, was dabei herauskommt.
Die Multi-Versionierung bringt sehr angenehme Vorteile für iOS-Entwickler mit sich. Mit dieser Eigenschaft lässt sich die Geschwindigkeit der Aktualisierung der Datenquelle für Bildschirmformulare ganz einfach und unbeschwert regeln, basierend auf den Überlegungen zum Benutzererlebnis. Zum Beispiel nehmen wir eine Funktion der Mail.ru Cloud-Anwendung, wie das automatische Laden von Inhalten aus der systemeigenen Mediengalerie. Bei einer guten Verbindung kann der Client mehrere Fotos pro Sekunde auf den Server hochladen. Wenn wir nach jedem Upload aktualisieren, UICollectionView mit Medieninhalten in der Cloud des Benutzers, können wir an 60 fps und flüssigem Scrollen während dieses Prozesses vergessen. Um häufige Bildschirmaktualisierungen zu verhindern, muss die Geschwindigkeit der Datenänderungen in der Grundlage UICollectionViewDataSource.
Wenn die Datenbank keine Multi-Versionierung unterstützt und nur mit dem aktuellen, gültigen Zustand arbeiten kann, ist es notwendig, eine stabil zeitlich festgelegte Momentaufnahme der Daten zu erstellen, indem sie entweder in eine in-memory Datenstruktur oder in eine temporäre Tabelle kopiert wird. Jeder dieser Ansätze ist sehr kostenintensiv. Bei einem in-memory Speicher entstehen sowohl Speicher- als auch Zeitkosten, die durch die Speicherung konstruierter Objekte und durch übermäßige ORM-Transformationen verursacht werden. Was die temporäre Tabelle betrifft, so ist dies ein noch teureres Vergnügen, das nur in nicht trivialen Fällen sinnvoll ist.
Die Multi-Versionierung von LMDB löst das Problem der Aufrechterhaltung einer stabilen Datenquelle sehr elegant. Es reicht aus, einfach eine Transaktion zu öffnen, und voilà – solange wir diese nicht abschließen, ist der Datensatz garantiert fixiert. Die Logik der Aktualisierungsgeschwindigkeit liegt jetzt vollständig in der Hand der Präsentationsschicht, ohne bedeutende Ressourcenüberschüsse.
Cursors
Cursors bieten einen Mechanismus für die geordnete Iteration über Schlüssel-Wert-Paare mittels Traversieren eines B-Baums. Ohne sie wäre es unmöglich, Tabellen in der Datenbank effizient zu modellieren, auf die wir übergehen werden.
4.2. Modellierung von Tabellen
Die Eigenschaft der Ordnung der Schlüssel erlaubt es, auf Basis grundlegender Abstraktionen eine hochgradige Struktur wie eine Tabelle zu konstruieren. Lassen Sie uns diesen Prozess am Beispiel der Haupttabelle eines Cloud-Kunden betrachten, in der Informationen über alle Dateien und Ordner des Benutzers zwischengespeichert sind.
Schema der Tabelle
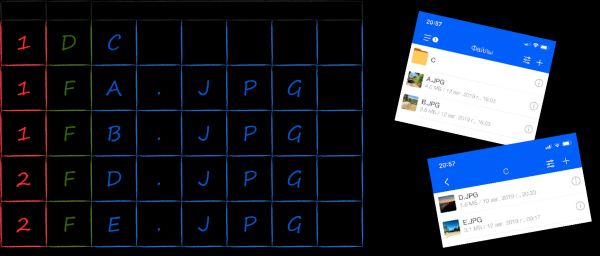
Ein häufiges Szenario, für das die Struktur der Tabelle mit einem Ordnersystem entworfen werden sollte, ist die Abfrage aller Elemente, die sich innerhalb eines bestimmten Verzeichnisses befinden. Ein gutes Modell zur Organisation der Daten für effiziente Anfragen dieser Art ist . Um es über einem Key-Value-Speicher zu implementieren, müssen die Schlüssel der Dateien und Ordner so sortiert werden, dass sie basierend auf der Zugehörigkeit zum übergeordneten Verzeichnis gruppiert werden. Darüber hinaus, um den Inhalt des Verzeichnisses im gewohnten Windows-Format anzuzeigen (zuerst Ordner, dann Dateien, wobei beide alphabetisch sortiert sind), müssen die entsprechenden zusätzlichen Felder in den Schlüssel aufgenommen werden.
Das Bild unten zeigt, wie die Darstellung der Schlüssel als Byte-Array aussehen kann, basierend auf der gestellten Aufgabe. Zunächst werden die Bytes mit der ID des übergeordneten Verzeichnisses (rot) platziert, gefolgt von den Typen (grün) und schließlich mit den Namen (blau). Durch die Standardvergleichsfunktion von LMDB im lexikografischen Ordner werden sie in der erforderlichen Weise sortiert. Die sequenzielle Durchlauf der Schlüssel mit demselben roten Präfix liefert uns die zugehörigen Werte in der Reihenfolge, in der sie im Benutzerinterface (rechts) ausgegeben werden sollen, ohne dass eine zusätzliche Nachbearbeitung erforderlich ist.
Serialisierung von Schlüsseln und Werten
In der Welt gibt es viele Methoden zur Serialisierung von Objekten. Da wir keine anderen Anforderungen als Geschwindigkeit hatten, haben wir uns für die schnellste mögliche Methode entschieden – den Speicher-Dump, der von einer Instanz der C-Struktur belegt wird. So kann der Schlüssel eines Verzeichniselements durch die folgende Struktur modelliert werden. NodeKey.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
Zur Speicherung NodeKey muss im Objekt MDB_val der Zeiger auf die Daten an die Adresse des Anfangs der Struktur ausgerichtet werden, und ihre Größe wird durch die Funktion sizeof.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = sizeof(NodeKey),
        .mv_data = (void *)key
    };
}
Im ersten Kapitel über die Kriterien zur Auswahl einer Datenbank habe ich die Minimierung dynamischer Allokationen im Rahmen von CRUD-Operationen als wichtigen Faktor erwähnt. Der Code der Funktion serialize zeigt, wie man im Fall von LMDB diese bei der Einfügung neuer Einträge in die Datenbank vollständig vermeiden kann. Das vom Server erhaltene Byte-Array wird zunächst in Stapelstrukturen umgewandelt und dann trivial in den Speicher geschrieben. Da auch innerhalb von LMDB keine dynamischen Allokationen stattfinden, kann mit einer fantastischen Situation für iOS gearbeitet werden – für die Datenverarbeitung vom Netz bis zur Festplatte wird nur Stapelspeicher verwendet!
Sortierung von Schlüsseln durch einen binären Vergleichsoperator
Die Reihenfolge der Schlüssel wird durch eine spezielle Funktion festgelegt, die als Komparator bezeichnet wird. Da die Engine nichts über die Semantik der enthaltenen Bytes weiß, bleibt dem Standardkomparator nichts anderes übrig, als die Schlüssel lexikografisch zu sortieren, wobei ein Byte-für-Byte-Vergleich verwendet wird. Seine Verwendung zur Sortierung von Strukturen ist vergleichbar mit dem Rasieren mit einem Schnittholz. Dennoch finde ich diese Methode in einfachen Fällen akzeptabel. Die Alternative wird gleich weiter unten beschrieben, und hier möchte ich ein paar Stolpersteine erwähnen, die auf diesem Weg liegen.
Das erste, woran man sich erinnern sollte, ist die Repräsentation primitiver Datentypen im Speicher. So werden auf allen Apple-Geräten ganzzahlige Variablen im Format . Das bedeutet, dass das am wenigsten signifikante Byte links steht, und es ist nicht möglich, ganze Zahlen mithilfe ihres Byte-Vergleichs zu sortieren. Zum Beispiel führt der Versuch, dies mit einer Reihe von Zahlen von 0 bis 511 zu tun, zu folgendem Ergebnis.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Um dieses Problem zu lösen, müssen ganze Zahlen im Schlüssel in ein für den Byte-Vergleich geeignete Format gespeichert werden. Die erforderliche Umwandlung ermöglichen Funktionen aus der Familie der hton* (insbesondere htons für die zwei Byte-Zahlen aus dem Beispiel).
Das Format der String-Darstellung in der Programmierung ist, wie bekannt, ganzzahlig. Wenn die Semantik von Strings sowie die verwendete Codierung zu ihrer Darstellung im Speicher impliziert, dass mehr als ein Byte auf ein Zeichen fallen kann, sollte man von der Verwendung des Standardkomparators besser gleich absehen.
Das zweite, was man im Kopf behalten sollte, sind die des Compilers für die Felder einer Struktur. Aufgrund dieser können im Speicher zwischen den Feldern Bytes mit Müllwerten entstehen, was natürlich den Byte-Vergleich durcheinanderbringt. Um den Müll zu beseitigen, muss man entweder die Felder in einer streng bestimmten Reihenfolge deklarieren, wobei die Ausrichtungsregeln im Hinterkopf behalten werden müssen, oder im Struktur-Declaration-Attribut packed.
Die Sortierung der Schlüssel durch einen externen Komparator
Die Logik des Schlüsselsvergleichs kann sich als zu komplex für den binären Komparator erweisen. Einer der vielen Gründe dafür ist das Vorhandensein technischer Felder innerhalb der Strukturen. Ich veranschauliche ihr Auftreten am Beispiel des uns bereits bekannten Schlüssels für ein Verzeichniselement.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
Trotz seiner Einfachheit benötigt er in den überwiegenden meisten Fällen zu viel Speicher. Der Puffer nimmt 256 Byte ein, obwohl die durchschnittlichen Namen von Dateien und Ordnern selten 20-30 Zeichen überschreiten.
Eine der Standardmethoden zur Optimierung der Datensatzgröße besteht darin, ihn auf die tatsächliche Größe "zuzuschneiden". Dabei wird das Prinzip verfolgt, dass der Inhalt aller variablen Längenfelder am Ende der Struktur im Puffer gespeichert und deren Längen in separaten Variablen gehalten werden. In Übereinstimmung mit diesem Ansatz wird der Schlüssel NodeKey wie folgt transformiert.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Bei der Serialisierung wird als Datengröße nicht sizeof die gesamte Struktur, sondern die Größe aller Felder fester Länge plus die Größe des tatsächlich verwendeten Teils des Puffers angegeben.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Durch die durchgeführte Umstrukturierung haben wir einen erheblichen Platzersparnis durch die Schlüssel erzielt. Aufgrund des technischen Feldes nameLength, ist der standardmäßige binäre Komparator nicht mehr für den Vergleich der Schlüssel geeignet. Wenn wir ihn nicht durch unseren eigenen ersetzen, wird die Länge des Namens bei der Sortierung wichtiger sein als der Name selbst.
LMDB ermöglicht es, für jede Datenbank eine eigene Vergleichsfunktion für die Schlüssel festzulegen. Dies geschieht durch die Funktion mdb_set_compare strictly before opening. Aus offensichtlichen Gründen darf die Funktion während der gesamten Lebensdauer der Datenbank nicht verändert werden. Der Komparator erhält zwei Schlüssel im binären Format und gibt das Ergebnis des Vergleichs zurück: kleiner (-1), größer (1) oder gleich (0). Der Pseudocode für NodeKey sieht so aus.
int compare(MDB_val * const a, MDB_val * const b) {
NodeKey * const aKey = (NodeKey * const)a->mv_data;
NodeKey * const bKey = (NodeKey * const)b->mv_data;
return // ...
}Solange alle Schlüssel in der Datenbank vom gleichen Typ sind, ist eine bedingungslose Umwandlung ihrer byteweisen Darstellung in den Typ der Anwendungsstruktur des Schlüssels zulässig. Hier gibt es jedoch einen Nuance, die weiter unten im Unterabschnitt "Datensätze lesen" behandelt wird.
Serialisierung von Werten
Der Umgang mit den Schlüsseln der gespeicherten LMDB-Datensätze erfolgt äußerst intensiv. Ihr Vergleich untereinander findet im Rahmen jeder Anwendungsoperation statt, und die Geschwindigkeit des Comparators beeinflusst die gesamte Leistung der Lösung. In einer idealen Welt sollte der Standard-Binärkomparator für den Vergleich der Schlüssel ausreichend sein, aber wenn man schon seinen eigenen verwenden muss, sollte der Deserialisierungsprozess der Schlüssel so schnell wie möglich sein.
Der Wertteil des Datensatzes (Wert) interessiert die Datenbank nicht besonders. Die Umwandlung aus der Byte-Darstellung in ein Objekt erfolgt nur dann, wenn dies bereits vom Anwendungscode benötigt wird, beispielsweise für die Anzeige auf dem Bildschirm. Da dies relativ selten geschieht, sind die Anforderungen an die Geschwindigkeit dieses Verfahrens nicht so kritisch, und bei dessen Umsetzung sind wir in viel größerem Maße frei, uns nach der Benutzerfreundlichkeit zu orientieren. Zum Beispiel verwenden wir zur Serialisierung von Metadaten zu noch nicht geladenen Dateien NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Es gibt jedoch Fälle, in denen die Leistung dennoch von Bedeutung ist. Beispielsweise verwenden wir beim Speichern von Metainformationen über die File-Struktur der Benutzer-Cloud immer noch denselben Speicher-Dump von Objekten. Das Besondere an der Aufgabe, ihre serialisierte Darstellung zu erstellen, ist die Tatsache, dass die Elemente des Verzeichnisses durch eine Hierarchie von Klassen modelliert werden.
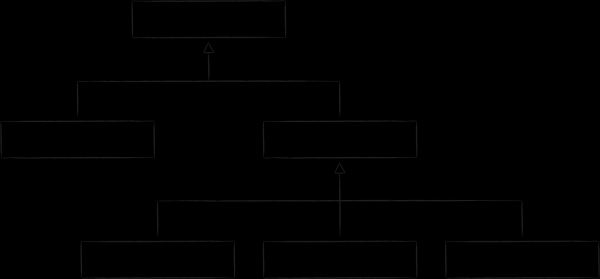
Für die Implementierung in C werden spezifische Felder der Nachkommen in separate Strukturen ausgegliedert, und ihre Verbindung zur Basisklasse erfolgt über ein Feld vom Typ union. Der aktuelle Inhalt der Vereinigung wird über das technische Attribut type festgelegt.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Hinzufügen und Aktualisieren von Datensätzen
Die serialisierten Schlüssel und Werte können im Speicher hinzugefügt werden. Dafür wird die Funktion verwendet mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);Im Konfigurationsschritt kann dem Speicher erlaubt oder verboten werden, mehrere Datensätze mit dem gleichen Schlüssel zu speichern. Wenn Duplikate von Schlüsseln verboten sind, kann beim Einfügen eines Datensatzes festgelegt werden, ob ein Update eines bereits bestehenden Datensatzes zulässig ist oder nicht. Wenn das Überschreiben nur aufgrund eines Fehlers im Code passieren kann, kann man sich absichern, indem man ein Flag angibt. NOOVERWRITE.
Lesen von Datensätzen
Die Funktion ist für das Lesen von Datensätzen in LMDB vorgesehen. mdb_get. Wenn das Schlüssel-Wert-Paar zuvor mit dumpierten Strukturen dargestellt wurde, sieht dieser Prozess wie folgt aus.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Der gezeigte Listing zeigt, wie die Serialisierung durch das Dumpen von Strukturen es ermöglicht, dynamische Allokationen nicht nur beim Schreiben, sondern auch beim Lesen von Daten zu vermeiden. Der von der Funktion erhaltene mdb_get Pointer zeigt genau auf die Adresse des virtuellen Speichers, wo die Datenbank die byteweise Darstellung des Objekts speichert. Tatsächlich erhalten wir eine Art ORM, die nahezu kostenlos eine sehr hohe Lesegeschwindigkeit ermöglicht. Trotz der Eleganz des Ansatzes sollten einige damit verbundene Besonderheiten beachtet werden.
- Für readonly-Transaktionen bleibt der Pointer auf die Struktur-Wert-Daten bis zum Abschluss der Transaktion gültig. Wie bereits erwähnt, bleiben die B-Baum-Seiten, auf denen sich das Objekt befindet, dank des Prinzips copy-on-write unverändert, solange mindestens eine Transaktion darauf verweist. Gleichzeitig können, sobald die letzte damit verbundene Transaktion abgeschlossen ist, die Seiten für neue Daten wiederverwendet werden. Wenn es notwendig ist, dass Objekte die sie erzeugende Transaktion überdauern, müssen sie jedoch kopiert werden.
- Für readwrite-Transaktionen ist der Pointer auf die erhaltene Struktur-Wert-Daten nur bis zur ersten modifizierenden Prozedur (Schreiben oder Löschen von Daten) gültig.
- Obwohl die Struktur
NodeValuenicht vollständig, sondern gekürzt ist (siehe den Abschnitt „Sortierung der Schlüssel durch externen Comparator“), kann über den Pointer problemlos auf ihre Felder zugegriffen werden. Wichtig ist, ihn nicht dereferenzieren! - Unter keinen Umständen darf die Struktur über den erhaltenen Zeiger modifiziert werden. Alle Änderungen müssen ausschließlich über die Methode vorgenommen werden.
mdb_putEs ist jedoch so, dass es trotz aller Bemühungen nicht möglich sein wird, da der Speicherbereich, in dem sich diese Struktur befindet, im Modus readonly gemappt ist. - Das Remapping der Datei in den Adressraum des Prozesses soll beispielsweise die maximale Größe des Speichers mit Hilfe der Funktion erhöhen.
alle Entitäten (Cursors, Transaktionen, Schlüssel und Werte), die zuvor von der Engine erhalten wurden, ungültig macht. Diese Wendung im Code zu berücksichtigen, führt zu einer erheblichen Komplexität. Wenn Ihnen jedoch virtueller Speicher sehr wichtig ist, könnte dies ein Grund sein, einen Fork in Betracht zu ziehen, der weit voraus ist,dies invalidiert vollständig alle Transaktionen und die damit verbundenen Entitäten im Allgemeinen sowie die Zeiger auf die gelesenen Objekte im Einzelnen.
Schließlich gibt es eine weitere Eigenschaft, die so tückisch ist, dass eine Erklärung ihres Wesens nicht einfach in einen weiteren Punkt passt. In dem Kapitel über B-Bäume habe ich das Schema der Anordnung ihrer Seiten im Speicher vorgestellt. Daraus geht hervor, dass die Adresse des Anfangs des Puffers mit den serialisierten Daten absolut beliebig sein kann. Deshalb kann der Zeiger darauf, der in der Struktur erhalten wird, MDB_val und auf einen Zeiger auf die Struktur übertragen wird, im Allgemeinen ungerade sein. Gleichzeitig erfordern die Architekturen einiger Chips (im Fall von iOS handelt es sich um armv7), dass die Adresse beliebiger Daten ein Vielfaches der Maschinenwortgröße oder anders gesagt der Bitbreite des Systems ist (bei armv7 sind das 32 Bit). Mit anderen Worten, eine Operation wie *(int *foo)0x800002 wird als Flucht betrachtet und führt zu einem Urteil über EXC_ARM_DA_ALIGN.Es gibt zwei Möglichkeiten, ein so trübes Schicksal zu vermeiden.
Die erste besteht darin, die Daten vorher in eine eindeutig ausgerichtete Struktur zu kopieren. Zum Beispiel wird dies auf einem benutzerdefinierten Comparator wie folgt aussehen.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return // ...
}
Ein alternativer Weg besteht darin, den Compiler im Voraus zu informieren, dass Strukturen mit Schlüssel und Wert möglicherweise nicht ausgerichtet sind, mit dem Attribut aligned(1).Auf ARM kann derselbe Effekt auch mit dem Attribut packed erzielt werden. Da es außerdem die Optimierung des von der Struktur beanspruchten Platzes fördert, scheint mir dieser Weg vorzuziehen, auch wenn er zu höheren Kosten für den Datenzugriff führt.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Range-Anfragen.
Zum Iterieren über eine Gruppe von Datensätzen in LMDB gibt es die Cursor-Abstraktion. Wie man damit arbeitet, werden wir am Beispiel der uns bereits bekannten Tabelle mit den Metadaten der Benutzer-Cloud erläutern.
Im Rahmen der Anzeige einer Dateiliste im Verzeichnis müssen alle Schlüssel gefunden werden, die mit den untergeordneten Dateien und Ordnern assoziiert sind. In den vorherigen Abschnitten haben wir die Schlüssel sortiert, NodeKey so dass sie zunächst nach der ID des übergeordneten Verzeichnisses geordnet sind. Technisch gesehen reduziert sich die Aufgabe, den Inhalt eines Ordners abzurufen, darauf, den Cursor auf die obere Grenze der Schlüsselgruppe mit dem angegebenen Präfix zu setzen und dann bis zur unteren Grenze zu iterieren.
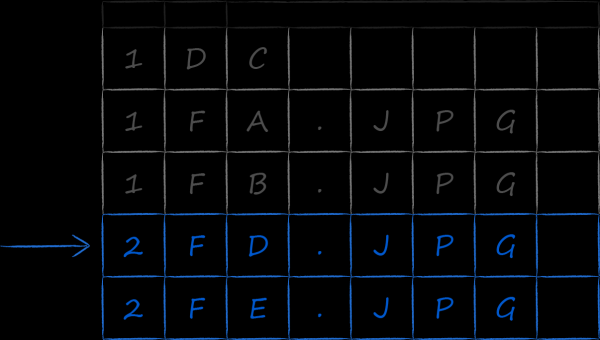
Die obere Grenze kann "direkt" durch sequentielles Suchen gefunden werden. Dazu wird der Cursor zu Beginn der gesamten Schlüsselliste in der Datenbank gesetzt und dann inkrementiert, bis sich unter ihm der Schlüssel mit der ID des übergeordneten Verzeichnisses befindet. Dieser Ansatz hat zwei offensichtliche Nachteile:
- Die lineare Komplexität der Suche, obwohl, wie bekannt, in Bäumen im Allgemeinen und insbesondere in B-Bäumen die Suche in logarithmischer Zeit durchgeführt werden kann.
- Es werden unnötig alle Seiten aus der Datei in den Hauptspeicher geladen, die vor der gesuchten Seite liegen, was extrem teuer ist.
Glücklicherweise bietet die API von LMDB einen effizienten Weg, den Cursor initial zu positionieren. Dazu muss ein Schlüssel gebildet werden, dessen Wert ohne Zweifel kleiner oder gleich dem Schlüssel ist, der sich an der oberen Grenze des Intervalls befindet. Zum Beispiel können wir in Bezug auf die Liste oben einen solchen Schlüssel erstellen, bei dem das Feld parentId gleich 2 ist und alle anderen mit Nullen ausgefüllt sind. Dieser teilweise ausgefüllte Schlüssel wird in die Funktion mdb_cursor_get mit dem angegebenen Operation MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Wenn die obere Grenze der Schlüsselgruppe gefunden wurde, iterieren wir weiter, bis entweder ein Schlüssel mit einem anderen begegnet oder die Schlüssel ganz aufgebraucht sind. parentIddo { rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT); // Verarbeitung... } while (MDB_NOTFOUND != rc && // Ende der Tabelle überprüfen IsTargetKey(key)); // Ende der Schlüsselgruppe überprüfen
do {
    rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
    // Verarbeitung...
} while (MDB_NOTFOUND != rc && // Ende der Tabelle überprüfen
         IsTargetKey(key));    // Ende der Schlüsselliste überprüfen
Was erfreulich ist, ist, dass wir im Rahmen der Iteration mit mdb_cursor_get nicht nur den Schlüssel, sondern auch den Wert erhalten. Wenn zur Erfüllung der Auswahlkriterien auch Felder aus dem Wertteil des Datensatzes überprüft werden müssen, sind diese ohne zusätzliche Umstände durchaus zugänglich.
4.3. Modellierung von Beziehungen zwischen Tabellen
Bis zum aktuellen Zeitpunkt konnten wir alle Aspekte des Designs und der Arbeit mit einer einseitigen Datenbank betrachten. Man kann sagen, dass eine Tabelle eine Sammlung von sortierten Datensätzen ist, die aus ähnlichen Schlüssel-Wert-Paaren bestehen. Wenn man den Schlüssel als Rechteck und den damit verbundenen Wert als Quader darstellt, erhält man ein visuelles Schema der Datenbank.

In der realen Welt gelingt es jedoch selten, dies mit so wenig Aufwand zu tun. Oftmals erfordert es in einer Datenbank erstens mehrere Tabellen und zweitens, dass die Auswahl in einer anderen Reihenfolge als dem Primärschlüssel erfolgt. Fragen zur Erstellung und Verknüpfung dieser Tabellen sind das Thema dieses letzten Abschnitts.
Indextabellen
In der Cloud-Anwendung gibt es einen Abschnitt „Galerie“. In diesem werden Mediendateien aus der gesamten Cloud angezeigt, sortiert nach Datum. Für eine optimale Umsetzung dieser Auswahl muss neben der Haupttabelle eine weitere mit neuen Schlüsseln angelegt werden. Diese wird ein Feld für das Erstellungsdatum der Datei enthalten, das als primäres Sortierkriterium dient. Da die neuen Schlüssel auf dieselben Daten verweisen wie die Schlüssel in der Haupttabelle, werden sie als Indexpunkte bezeichnet. Auf dem Bild unten sind sie orange markiert.
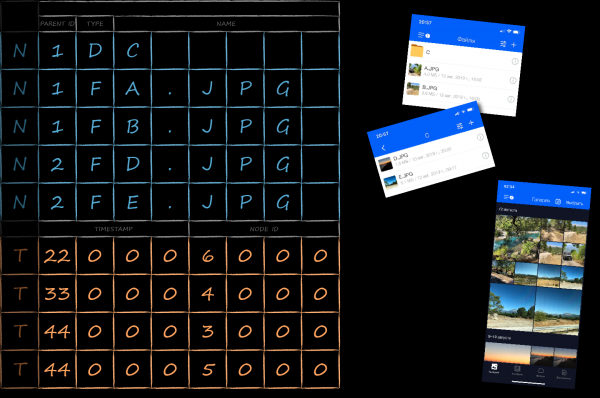
Um innerhalb einer Datenbank die Schlüssel verschiedener Tabellen voneinander zu trennen, wurde allen ein zusätzliches technisches Feld tableId hinzugefügt. Wenn wir dieses Feld zur Priorität für die Sortierung machen, erreichen wir eine Gruppierung der Schlüssel zuerst nach Tabellen und dann innerhalb der Tabellen nach eigenen Regeln.
Der Indexschlüssel verweist auf dieselben Daten wie der Primärschlüssel. Eine direkte Umsetzung dieser Eigenschaft durch die Assoziation einer Kopie des Wertteils des Primärschlüssels ist ungeeignet, und zwar aus mehreren Gründen:
- aus Sicht des Speicherplatzes, da Metadaten recht umfangreich sein können.
- aus Sicht der Leistung, da die Knoten beim Aktualisieren der Metadaten doppelt umgeschrieben werden müssen.
- Aus Sicht der Code-Unterstützung, wenn wir vergessen, die Daten für einen der Schlüssel zu aktualisieren, werden wir einen schwer fassbaren Bug in der Dateninkonsistenz im Speicher erhalten.
Lass uns nun ansehen, wie wir diese Mängel beseitigen können.
Organisation der Verbindungen zwischen Tabellen
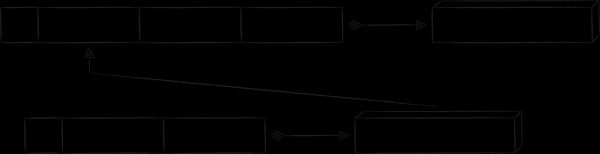
Für die Verknüpfung der Indextabelle mit der Haupttabelle eignet sich gut das Muster „Schlüssel als Wert“. Wie der Name schon sagt, fungiert eine Kopie des Wertes des Primärschlüssels als Wertteil des Indexeintrags. Dieser Ansatz beseitigt alle oben genannten Nachteile, die mit der Speicherung einer Kopie des Wertteils des Hauptdatensatzes verbunden sind. Der einzige Nachteil ist, dass man zur Abfrage des Wertes über den Indexschlüssel zwei Datenbankabfragen anstelle von einer durchführen muss. Schematisch sieht das resultierende Datenbankschema folgendermaßen aus.
Ein weiteres Muster zur Organisation der Verbindungen zwischen Tabellen ist „überschüssiger Schlüssel“. Das Wesen dieses Musters besteht darin, dem Schlüssel zusätzliche Attribute hinzuzufügen, die nicht zur Sortierung, sondern zur Rekonstruktion des verbundenen Schlüssels benötigt werden. In der Mail.ru Cloud-Anwendung gibt es reale Beispiele für seine Nutzung, aber um eine tiefere Einarbeitung in den Kontext spezifischer iOS-Frameworks zu vermeiden, werde ich ein fiktives, aber verständlicheres Beispiel anführen.
In den cloudbasierten mobilen Clients gibt es eine Seite, auf der alle Dateien und Ordner angezeigt werden, denen der Benutzer anderen Personen Zugriff gewährt hat. Da es relativ wenige solcher Dateien gibt, jedoch viele spezifische Informationen zu ihrer Öffentlichkeit vorhanden sind (wer Zugriff hat, mit welchen Rechten usw.), wäre es nicht rational, deren Wertteil im Hauptdatensatz zu belasten. Wenn man jedoch solche Dateien offline anzeigen möchte, muss man sie irgendwo speichern. Eine natürliche Lösung wäre, dafür eine separate Tabelle einzuführen. Im untenstehenden Schema hat ihr Schlüssel das Präfix „P“, und der Platzhalter „propname“ kann durch das konkretere „öffentliche Informationen“ ersetzt werden.
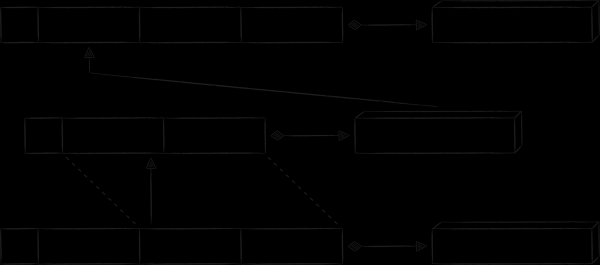
Alle einzigartigen Metadaten, für deren Speicherung die neue Tabelle erstellt wurde, werden in den value-Teil des Datensatzes verschoben. Gleichzeitig möchte man die Daten zu Dateien und Ordnern, die bereits in der Haupttabelle gespeichert sind, nicht duplizieren. Stattdessen werden im Schlüssel „P“ redundante Daten in Form der Felder „node ID“ und „timestamp“ hinzugefügt. Dank dieser kann man einen Indizes-Schlüssel konstruieren, über den man den Primärschlüssel abrufen kann, mit dem man schließlich die Metadaten des Knotens erhält.
Schlussfolgerung
Die Ergebnisse der Implementierung von LMDB bewerten wir positiv. Nach der Implementierung ist die Anzahl der Anwendungsabstürze um 30 % zurückgegangen.
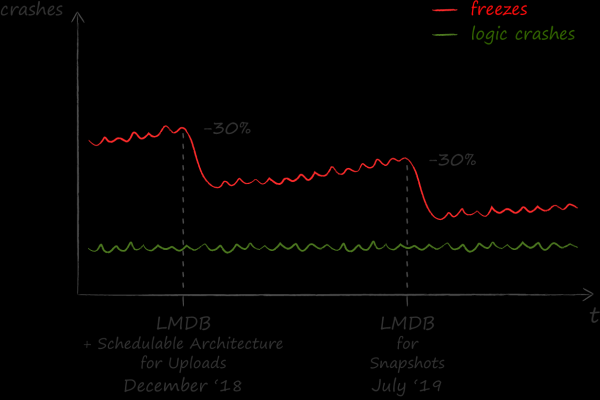
Die Ergebnisse der geleisteten Arbeit fanden auch über das iOS-Team hinaus Zustimmung. Derzeit hat einer der Hauptabschnitte „Dateien“ in der Android-App ebenfalls auf die Verwendung von LMDB umgestellt, und andere Teile sind in Arbeit. Die Programmiersprache C, in der das Key-Value-Speichersystem implementiert wurde, war eine gute Unterstützung, um ursprünglich eine plattformübergreifende Anwendungsschicht in C++ darum zu erstellen. Für die nahtlose Verbindung der entstandenen C++-Bibliothek mit dem plattformabhängigen Code in Objective-C und Kotlin wurde ein Code-Generator verwendet. von Dropbox, aber das ist schon eine ganz andere Geschichte.
Quelle: habr.com
