

Berkeley Packet Filter (BPF) ist eine Kernel-Technologie von Linux, die seit Jahren immer wieder in den Schlagzeilen englischsprachiger Fachzeitschriften steht. Konferenzen sind voll mit Vorträgen über die Anwendung und Entwicklung von BPF. David Miller, der Maintainer des Linux-Netzwerkstapels, nennt seinen Vortrag auf den Linux Plumbers 2018 (XDP ist eine der Möglichkeiten, BPF zu nutzen). Brendan Gregg hält Vorträge mit dem Titel . Toke Høiland-Jørgensen , dass der Kernel nun ein Mikrokernel ist. Thomas Graf bewirbt die Idee, dass .
Bislang gibt es auf Habr kein systematisches Dokument zur Beschreibung von BPF, daher werde ich in einer Reihe von Artikeln versuchen, die Geschichte dieser Technologie zu erzählen, die Architektur und Entwicklungstools zu beschreiben, die Anwendungsbereiche und Nutzungspraxis von BPF zu skizzieren. In diesem nullten Artikel der Reihe wird die Geschichte und Architektur des klassischen BPF behandelt und die Geheimnisse der Funktionsweise enthüllt tcpdump, seccomp, strace, und vieles mehr.
Die Entwicklung von BPF wird von der Linux-Netzgemeinschaft gesteuert, und die meisten bestehenden Anwendungen von BPF betreffen Netzwerke. Mit Erlaubnis von , habe ich die Reihe "BPF für die Allerkleinsten" genannt, zu Ehren der großartigen Reihe .
Ein kurzer Verlauf der Geschichte von BPF (c)
Die moderne BPF-Technologie ist eine verbesserte und erweiterte Version der alten Technologie mit dem gleichen Namen, die heutzutage zur Vermeidung von Verwirrung als klassisches BPF bezeichnet wird. Auf der Grundlage des klassischen BPF wurden die bekannte Utility tcpdump, der Mechanismus seccomp, sowie die weniger bekannte Modul xt_bpf für iptables und der Klassifizierer cls_bpf. Im modernen Linux werden klassische BPF-Programme automatisch in die neue Form übersetzt, jedoch ist die API aus Sicht des Benutzers gleich geblieben und neue Anwendungen des klassischen BPF, wie wir in diesem Artikel sehen werden, sind nach wie vor vorhanden. Aus diesem Grund habe ich entschieden, gerade mit einem Artikel über das klassische BPF zu beginnen, da es klarer wird, wie und warum es sich in die moderne Form entwickelt hat.
Am Ende der 1980er Jahre interessierten sich Ingenieure des renommierten Lawrence Berkeley Laboratory dafür, wie man Netzwerkpakete auf der damals modernen Hardware der späten 80er Jahre richtig filtern kann. Die Grundidee der Filterung, die ursprünglich in der Technologie CSPF (CMU/Stanford Packet Filter) implementiert wurde, bestand darin, überflüssige Pakete so früh wie möglich zu filtern, d.h. im Kernelraum, da dies das Kopieren überflüssiger Daten in den Benutzerspeicher vermeidet. Um die Sicherheit der Laufzeit für die Ausführung von Benutzercode im Kernelraum zu gewährleisten, wurde eine virtuelle Maschine — Sandbox — verwendet.
Die virtuellen Maschinen für die bestehenden Filter waren jedoch für den Betrieb auf Maschinen mit Stack-Architektur konzipiert und arbeiteten auf neuen RISC-Maschinen nicht so effizient. Infolgedessen wurde von Ingenieuren der Berkeley Labs eine neue Technologie BPF (Berkeley Packet Filters) entwickelt, deren Architektur der virtuellen Maschine auf dem Prozessor Motorola 6502 basierte — dem Arbeitstier so bekannter Produkte wie oder . Die neue virtuelle Maschine erhöhte die Leistung der Filter im Vergleich zu den bestehenden Lösungen um ein Vielfaches.
Architektur der BPF-Maschine
Wir werden uns mit der Architektur praxisnah vertrautmachen, indem wir Beispiele durchgehen. Zunächst sei jedoch gesagt, dass die Maschine über zwei für den Benutzer verfügbare 32-Bit-Register verfügte, einen Akku A und ein Indexregister X, 64 Byte Speicher (16 Worte), die für Lese- und Schreiboperationen verfügbar waren, sowie ein kleines Befehlssystem zur Arbeit mit diesen Objekten. In den Programmen waren auch Sprungbefehle verfügbar, um bedingte Ausdrücke zu implementieren, jedoch durfte zur Sicherstellung des rechtzeitigen Programmabschlusses nur vorwärts gesprungen werden, d.h. es war insbesondere verboten, Schleifen zu erstellen.
Das allgemeine Schema des Maschinenstarts ist wie folgt. Der Benutzer erstellt ein Programm für die BPF-Architektur und lädt es mithilfe eines irgendeines Kernmechanismus (z.B. Systemaufruf) und verbindet das Programm mit einem Ereignis-Generator im Kernel (z.B. ein Ereignis ist das Eintreffen eines neuen Pakets an der Netzwerkkarte). Bei Auftreten eines Ereignisses startet das Kernel das Programm (z.B. im Interpreter), wobei der Speicher der Maschine entspricht. einem Speicherregion des Kernels (z. B. die Daten des empfangenen Pakets).
Das oben Gesagte reicht aus, um mit der Analyse von Beispielen zu beginnen: Wir werden uns mit dem System und dem Format der Kommandos nach Bedarf vertraut machen. Wenn Sie jedoch sofort das Befehlssystem der virtuellen Maschine lernen und alles über ihre Möglichkeiten erfahren möchten, können Sie den ursprünglichen Artikel lesen. und/oder die erste Hälfte der Datei aus der Dokumentation des Kernels. Darüber hinaus können Sie die Präsentation studieren , in der McCanne, einer der Autoren von BPF, über die Entstehungsgeschichte spricht. libpcap.
Wir kommen nun zu den wesentlichen Anwendungsbeispielen des klassischen BPF in Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Die Entwicklung von BPF fand parallel zur Entwicklung des Frontends für die Paketfilterung – dem bekannten Tool tcpdump. Da dies das älteste und bekannteste Beispiel für die Verwendung des klassischen BPF ist, das auf vielen Betriebssystemen verfügbar ist, beginnen wir unser Studium der Technologie damit.
(Alle Beispiele in diesem Artikel habe ich unter Linux 5.6.0-rc6. Die Ausgabe einiger Befehle wurde zur besseren Lesbarkeit bearbeitet.)
Beispiel: Überwachen von IPv6-Paketen
Angenommen, wir möchten alle IPv6-Pakete auf dem Interface betrachten eth0. Dazu können wir das Programm tcpdump mit dem einfachsten Filter ip6:
$ sudo tcpdump -i eth0 ip6Dabei tcpdump kompiliert den Filter ip6 in Bytecode der BPF-Architektur und sendet ihn an den Kernel (siehe Details im Abschnitt ). Der geladene Filter wird für jedes Paket ausgeführt, das durch das Interface eth0geht. Wenn der Filter einen nicht-null-Wert zurückgibt n, werden die n Bytes des Pakets in den Benutzerbereich kopiert und wir sehen sie in der Ausgabe. tcpdump.
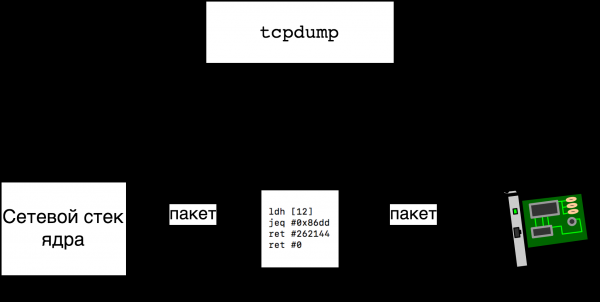
Es stellt sich heraus, dass wir leicht herausfinden können, welchen Bytecode wir an den Kernel gesendet haben tcpdump , indem wir ihn mit der Option tcpdumpausführen: -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
In der ersten Zeile führen wir den Befehl ldh [12]aus, der als "lade in das Register A ein Halbwort (16 Bit), das sich an Adresse 12 befindet" entschlüsselt wird, und die einzige Frage ist – auf welchen Speicher adressieren wir? Die Antwort liegt darin, dass an der Adresse x das (x+1)-te Byte des analysierten Netzwerkpakets beginnt. Wir lesen Pakete vom Ethernet-Interface eth0, und das ist , wie das Paket aussieht (der Einfachheit halber gehen wir davon aus, dass das Paket keine VLAN-Tags enthält):
       6              6          2
|Ziel MAC|Quell MAC|Ether Type|...|
Nach der Ausführung des Befehls ldh [12] wird im Register A das Feld Ether Type — der Typ des in diesem Ethernet-Frame übertragenen Pakets. In Zeile 1 vergleichen wir den Inhalt des Registers A (Pakettyp) mit 0x86dd, und das ist der Typ IPv6, der uns interessiert. In Zeile 1 gibt es neben dem Vergleichsbefehl zwei weitere Spalten — jt 2 und jf 3 — die Labels, zu denen im Falle eines erfolgreichen Vergleichs gewechselt werden soll (A == 0x86dd) und im Falle eines Misserfolgs. Im Erfolgsfall (IPv6) gehen wir zu Zeile 2, im Misserfolgsfall — zu Zeile 3. In Zeile 3 endet das Programm mit Code 0 (Paket nicht kopieren), in Zeile 2 endet das Programm mit Code 262144 (kopiere mir maximal 256 Kilobyte des Pakets).
Ein komplizierteres Beispiel: wir schauen uns TCP-Pakete über den Zielport an
Wir sehen uns an, wie der Filter aussieht, der alle TCP-Pakete mit Zielport 666 kopiert. Wir betrachten den Fall von IPv4, da der Fall von IPv6 einfacher ist. Nach dem Studium dieses Beispiels können Sie als Übung selbstständig den Filter für IPv6 untersuchen (ip6 and tcp dst port 666) und den Filter für den allgemeinen Fall (tcp dst port 666). Der für uns interessante Filter sieht folgendermaßen aus:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Was die Zeilen 0 und 1 tun, wissen wir bereits. In Zeile 2 haben wir geprüft, dass es sich um ein IPv4-Paket handelt (Ether Type = 0x800) und laden in das Register A das 24. Byte des Pakets. Unser Paket sieht aus wie
       14            8      1     1
|ethernet header|ip fields|ttl|protocol|...
das bedeutet, dass wir in das Register A das Protocol-Feld des IP-Headers laden, was logisch ist, denn wir wollen nur TCP-Pakete kopieren. Wir vergleichen das Protocol mit 0x6 () in Zeile 3.
In den Zeilen 4 und 5 laden wir das Halbwörter, die sich an Adresse 20 befinden, und überprüfen mit dem Befehl jset ob eines der drei — in der gegebenen Maske jset sind die drei obersten Bits gelöscht. Zwei der drei Bits sagen uns, ob das Paket Teil eines fragmentierten IP-Pakets ist, und wenn ja, ob es sich um das letzte Fragment handelt. Das dritte Bit ist reserviert und sollte null sein. Wir wollen weder unvollständige noch beschädigte Pakete überprüfen, daher prüfen wir alle drei Bits.
Zeile 6 ist die interessanteste in diesem Listing. Der Ausdruck ldxb 4*([14]&0xf) bedeutet, dass wir in das Register laden. X die vier niedrigsten Bits des fünfzehnten Bytes des Pakets, multipliziert mit 4. Die vier niedrigsten Bits des fünfzehnten Bytes sind das Feld der IPv4-Header, in dem die Headerlänge in Wörtern gespeichert ist, weshalb man später mit 4 multiplizieren muss. Interessanterweise ist der Ausdruck 4*([14]&0xf) eine Bezeichnung für einen speziellen Adressierungsmodus, der nur in dieser Form und nur für das Register verwendet werden kann X, d.h. wir können weder sagen ldb 4*([14]&0xf) weder ldxb 5*([14]&0xf) (wir können nur einen anderen Offset angeben, zum Beispiel ldxb 4*([16]&0xf)). Es ist klar, dass dieses Adressierungsschema in BPF genau eingeführt wurde, um die Länge des IPv4-Headers in X (Indexregister) abzurufen.
Somit versuchen wir in Zeile 7, ein halbes Wort von der Adresse (X+16)zu laden. Wenn man bedenkt, dass 14 Bytes den Ethernet-Header einnehmen und X die Länge des IPv4-Headers enthalten, verstehen wir, dass in A der Zielport von TCP geladen wird:
       14           X           2             2
|Ethernet-Header|IP-Header|Quellport|Zielport|
Schließlich vergleichen wir in Zeile 8 den Zielport mit dem gesuchten Wert und geben in den Zeilen 9 oder 10 das Ergebnis zurück – das Paket kopieren oder nicht.
Tcpdump: Laden
In den vorherigen Beispielen haben wir absichtlich nicht im Detail darauf eingegangen, wie wir den BPF-Bytecode in den Kernel zum Filtern von Paketen laden. Allgemein gesagt, tcpdump e wurde auf viele Systeme portiert und zur Arbeit mit Filtern die Bibliothek verwendet. . Kurz gesagt, um einen Filter über eine Schnittstelle zu setzen mit libpcap, muss man Folgendes tun:
- einen Deskriptor vom Typ
pcap_taus dem Schnittstellennamen erstellen: , - die Schnittstelle aktivieren: ,
- den Filter kompilieren: ,
- den Filter verbinden: .
Um zu sehen, wie die Funktion pcap_setfilter in Linux implementiert ist, verwenden wir strace (einige Zeilen wurden entfernt):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
In den ersten beiden Zeilen der Ausgabe erstellen wir zum Lesen aller Ethernet-Frames und binden ihn an die Schnittstelle eth0. Aus wissen wir, dass der Filter ip aus vier BPF-Anweisungen bestehen wird, und in der dritten Zeile sehen wir, wie wir mithilfe der Option des Systemaufrufs setsockopt den Filter der Länge 4 laden und anschließen. Das ist unser Filter.
Es ist erwähnenswert, dass im klassischen BPF das Laden und Verbinden von Filtern immer als atomare Operation erfolgt, während in der neuen Version von BPF das Laden des Programms und das Verknüpfen mit dem Ereignisgenerator zeitlich getrennt sind.
Die verborgene Wahrheit
Eine etwas umfassendere Version der Ausgabe sieht so aus:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Ressource vorübergehend nicht verfügbar)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Wie bereits erwähnt, laden wir in Zeile 5 unseren Filter und verbinden ihn mit dem Socket, aber was passiert in den Zeilen 3 und 4? Es stellt sich heraus, dass dies libpcap sich um uns kümmert – damit in die Ausgabe unseres Filters keine Pakete gelangen, die ihm nicht entsprechen, verbindet die Bibliothek Platzhalterfilter ret #0 (alle Pakete verwerfen), versetzt den Socket in den nicht-blockierenden Modus und versucht, alle Pakete auszulesen, die von früheren Filtern übrig geblieben sein könnten.
Zusammenfassend lässt sich sagen, dass man zur Paketfilterung unter Linux mithilfe des klassischen BPF einen Filter in Form einer Struktur vom Typ struct sock_fprog und einen geöffneten Socket benötigt, nach dem der Filter über einen Systemaufruf an den Socket angehängt werden kann. setsockopt.
Interessanterweise kann der Filter an jeden Socket angehängt werden, nicht nur an roh. Hier ist ein Programm, das alles abschneidet, außer den ersten beiden Bytes aller eingehenden UDP-Datagramme. (Kommentare habe ich im Code hinzugefügt, um den Artikel nicht zu überladen.)
Mehr über die Verwendung setsockopt zur Verbindung von Filtern finden Sie in , und wie man eigene Filter der Art struct sock_fprog ohne Hilfe tcpdump werden wir im Abschnitt .
Klassisches BPF und das 21. Jahrhundert
BPF wurde 1997 in Linux integriert und blieb lange Zeit eine zuverlässige Lösung libpcap ohne wesentliche Änderungen (linuxspezifische Änderungen natürlich, , aber sie änderten nicht das Gesamtbild). Erste ernsthafte Anzeichen dafür, dass BPF sich weiterentwickeln würde, traten 2011 auf, als Eric Dumazet vorschlug, einen Just In Time Compiler in den Kernel einzufügen – einen Compiler zur Übersetzung von BPF-Bytecode in nativen x86_64 Code.
Der JIT-Compiler war die erste in der Reihe von Änderungen: Im Jahr 2012 wurde die Möglichkeit eingeführt, Filter für , mithilfe von BPF, im Januar 2013 wurde Modul xt_bpf, der es ermöglicht, Regeln für iptables mithilfe von BPF zu schreiben, und im Oktober 2013 wurde auch ein Modul cls_bpf, das das Schreiben von Verkehrsklassifizierern mit BPF ermöglicht.
Wir werden all diese Beispiele bald genauer betrachten, doch zuerst ist es nützlich für uns, zu lernen, wie man beliebige Programme für BPF schreibt und kompiliert, da die Möglichkeiten, die von der Bibliothek bereitgestellt werden, libpcap begrenzt sind (ein einfaches Beispiel: ein generierter Filter, libpcap kann nur zwei Werte zurückgeben – 0 oder 0x40000) oder sind, wie im Falle von seccomp, nicht anwendbar.
BPF programmieren mit eigenen Händen
Lernen wir das binäre Format der BPF-Anweisungen kennen, es ist sehr einfach:
   16    8    8     32
| code | jt | jf |  k  |
Jede Anweisung umfasst 64 Bit, wobei die ersten 16 Bit der Befehlscode sind, gefolgt von zwei acht Bit langen Sprüngen, jt und jf, und 32 Bit für das Argument, K, dessen Zweck von Anweisung zu Anweisung variiert. Zum Beispiel hat die Anweisung ret, die das Programm beendet, den Code 6, und der Rückgabewert wird aus der Konstante Kentnommen. In C wird eine BPF-Anweisung durch die Struktur
struct sock_filter {
        __u16   code;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
und ein ganzes Programm wird in Form der Struktur
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
So können wir bereits Programme schreiben (wir nehmen an, dass wir die Codes der Anweisungen aus ). So würde der Filter aussehen: ip6 aus :
struct sock_filter code[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(code),
        .filter = code,
};
Programm prog können wir legal im Aufruf verwenden
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Programme als Maschinencodes zu schreiben ist nicht sehr praktisch, aber manchmal notwendig (zum Beispiel zur Fehlersuche, für die Erstellung von Unit-Tests, das Schreiben von Artikeln in Habr usw.). Zur Vereinfachung werden in der Datei <linux/filter.h> Hilfsmakros definiert – dasselbe Beispiel wie oben könnte so umgeschrieben werden
struct sock_filter code[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Diese Variante ist jedoch auch nicht besonders praktisch. Das dachten sich auch die Programmierer des Linux-Kernels und deshalb findet man im Verzeichnis des Kernels einen Assembler und Debugger für die Arbeit mit klassischem BPF.
Die Assemblersprache ist sehr ähnlich wie der Debug-Auszug, tcpdump, aber zusätzlich können wir symbolische Labels angeben. Zum Beispiel, hier ist ein Programm, das alle Pakete außer TCP/IPv4 fallen lässt:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Der Assembler generiert standardmäßig Code im Format , ,..., für unser Beispiel mit TCP ergibt sich
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Zur Vereinfachung der C-Programmierer kann ein anderes Ausgabeformat verwendet werden:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Dieser Text kann in die Definition der Struktur vom Typ struct sock_filter, wie wir zu Beginn dieses Abschnitts gemacht haben.
Erweiterungen von Linux und netsniff-ng
Neben den Standard-BPF-Anweisungen unterstützen Linux und tools/bpf/bpf_asm auch . Grundsätzlich dienen die Anweisungen dazu, auf die Felder der Struktur struct sk_buff, die ein Netzwerkpaket im Kernel beschreibt, zuzugreifen. Es gibt jedoch auch Anweisungen anderer Art, wie zum Beispiel ldw cpu , die das Ergebnis der Ausführung der Kernel-Funktion A raw_smp_processor_id() , in ein Register lädt. (In der neuen Version von BPF wurden diese nicht standardmäßigen Erweiterungen durch Bereitstellung von Kernel-Helper-Programmen zur Speicherzugriffs-, Struktur- und Ereignisgenerierung erweitert.) Hier ist ein interessantes Beispiel für einen Filter, bei dem wir nur die Header von Paketen in den Userspace kopieren, unter Verwendung der Erweiterungpoff , Payload-Offset:ld poff ret a
BPF-Erweiterungen können nicht inverwendet werden, aber das ist ein guter Grund, sich mit dem Paket von Dienstprogrammen tcpdumpnetsniff-ng , einen BPF-Assembler namens , das unter anderem ein fortschrittliches Programm enthält, das neben der Filterung mit BPF auch einen effizienten Verkehrsgenerator enthält, und fortschrittlicher ist alsbpfc tools/bpf/bpf_asm. Das Paket enthält eine recht detaillierte Dokumentation, siehe auch die Links am Ende des Artikels. Nun können wir BPF-Programme beliebiger Komplexität schreiben und sind bereit, uns neue Beispiele anzusehen, das erste davon ist die Technologie seccomp, die es ermöglicht, mithilfe von BPF-Filtern eine Vielzahl von Systemaufrufargumenten, die diesem Prozess und seinen Nachkommen zur Verfügung stehen, zu verwalten.Die erste Version von seccomp wurde 2005 in den Kernel eingeführt und erfreute sich nicht großer Beliebtheit, da sie nur die Möglichkeit bot, die Anzahl der für den Prozess verfügbaren Systemaufrufe auf folgende zu beschränken:
seccomp
sigreturn
, und der Prozess, der gegen die Regeln verstößt, wurde mit Hilfe von lesen, schreiben, exit und SIGKILL, getötet. SIGKILL. Allerdings wurde 2012 die Möglichkeit hinzugefügt, BPF-Filter in seccomp zu verwenden, die es ermöglichen, eine Vielzahl von erlaubten Systemaufrufen zu definieren und sogar Überprüfungen ihrer Argumente durchzuführen. (Interessant ist, dass einer der ersten Nutzer dieser Funktionalität Chrome war, und derzeit wird von den Leuten aus Chrome ein KRSI-Mechanismus entwickelt, der auf einer neuen Version von BPF basiert und die Anpassung der Linux-Sicherheitsmodule ermöglicht.) Links zur zusätzlichen Dokumentation finden Sie am Ende des Artikels.
Es sei darauf hingewiesen, dass es auf Habr bereits Artikel über die Verwendung von seccomp gab, vielleicht möchte jemand sie vor (oder anstelle) der Lektüre der folgenden Abschnitte lesen. Im Artikel werden Beispiele für die Verwendung von seccomp sowohl in der Version von 2007 als auch in der Version mit BPF (die Filter werden mit Hilfe von libseccomp generiert) gegeben, die Verbindung zwischen seccomp und Docker erklärt und viele nützliche Links bereitgestellt. Im Artikel wird speziell erläutert, wie man schwarze oder weiße Listen von Systemaufrufen für Daemons unter der Kontrolle von systemd hinzufügt.
Als Nächstes werden wir uns anschauen, wie man Filter für seccomp in reinem C und mit der Hilfe der Bibliothek libseccomp schreibt und lädt und welche Vor- und Nachteile jede Variante hat, und zum Schluss sehen wir uns an, wie seccomp von dem Programm verwendet wird. strace.
Filter für seccomp schreiben und laden
Wir wissen bereits, wie man BPF-Programme schreibt, und daher betrachten wir zunächst die Programmieroberfläche von seccomp. Einen Filter kann man auf Prozessebene setzen, wobei alle untergeordneten Prozesse die Einschränkungen erben. Dies geschieht durch den Systemaufruf :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)wo &filter — das ist der Zeiger auf die uns bereits bekannte Struktur struct sock_fprog, also das BPF-Programm.
Wie unterscheiden sich die Programme für seccomp von den Programmen für Sockets? Durch den übergebenen Kontext. Im Fall von Sockets wurde uns ein Speicherbereich übergeben, der das Paket enthält, während uns im Fall von seccomp eine Struktur des Typs übergeben wird.
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Hier nr — das ist die Nummer des aufgerufenen Systemaufrufs, arch — die aktuelle Architektur (darüber mehr weiter unten), args — bis zu sechs Argumente des Systemaufrufs, und instruction_pointer — dies ist ein Verweis auf eine Benutzerdokumentation, die diesen Systemaufruf ausgeführt hat. Um beispielsweise die Nummer des Systemaufrufs in ein Register zu laden, müssen wir sagen A ldw [0]
Für Seccomp-Programme gibt es weitere Besonderheiten, wie beispielsweise, dass der Zugriff auf den Kontext nur mit 32-Bit-Ausrichtung möglich ist und es nicht erlaubt ist, ein Halbwort oder ein Byte zu laden – beim Versuch, einen Filter zu ladenldh [0] EINVAL Systemaufruf seccomp gibt zurück . Die Prüfung der geladenen Filter erfolgt über die Funktionseccomp_check_filter() (Rest von Division) und sie jetzt für Seccomp-BPF-Programme nicht verfügbar ist, da ihre Hinzufügung mod die ABI beschädigen würde.) ld [0] jeq #304, bad jeq #176, bad jeq #239, bad jeq #279, bad good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */ bad: ret #0
überprüft die schwarze Liste von vier Systemaufrufen mit den Nummern 304, 176, 239, 279. Was sind das für Systemaufrufe? Wir können nicht genau sagen, da wir nicht wissen, für welche Architektur das Programm geschrieben wurde. Daher beginnen die Autoren von Seccomp
alle Programme mit einer Überprüfung der Architektur (die aktuelle Architektur wird im Kontext als Feld angegebenstruct seccomp_data ). Mit der Architektureprüfung würde der Anfang des Beispiels so aussehen: arch Strukturen ld [4] jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64und dann würden unsere Systemaufrufnummern bestimmte Werte erhalten.
Wir schreiben und laden Filter für Seccomp mitDas Schreiben von Filtern in Maschinencodes oder für den BPF-Assembler ermöglicht vollständige Kontrolle über das Ergebnis, aber manchmal ist es auch vorzuziehen, tragbaren und/oder lesbaren Code zu haben. Dabei hilft uns die Bibliothek
, die eine standardisierte Schnittstelle zum Schreiben von schwarzen oder weißen Filtern bietet. libseccomp
Lassen Sie uns beispielsweise ein Programm schreiben, das eine Binärdatei nach Wahl des Benutzers ausführt, indem wir zuvor die schwarze Liste der Systemaufrufe aus dem oben genannten Artikel
(das Programm wurde zur besseren Lesbarkeit vereinfacht, die vollständige Version ist zu finden sys_numbers ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
mit 40+ Systemaufrufnummern, die blockiert werden sollen. Dann initialisieren wir den Kontext ctx aus über 40 Systemaufrufen zur Blockierung. Dann initialisieren wir den Kontext ctx und sagen der Bibliothek, dass wir erlauben möchten (SCMP_ACT_ALLOW) alle Systemaufrufe standardmäßig (Schwarze Listen zu erstellen ist einfacher). Dann fügen wir nacheinander alle Systemaufrufe aus der schwarzen Liste hinzu. Als Reaktion auf einen Systemaufruf aus der Liste fordern wir SCMP_ACT_TRAP, in diesem Fall sendet seccomp dem Prozess das Signal SIGSYS , mit der Beschreibung, welcher Systemaufruf die Regeln verletzt hat. Schließlich laden wir das Programm in den Kernel mit Hilfe von seccomp_load, das das Programm kompilieren wird und es mit Hilfe des Systemaufrufs dem Prozess anbindet. seccomp(2).
Um das Programm erfolgreich zu kompilieren, muss es mit der Bibliothek verlinkt werden libseccomp, zum Beispiel:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Beispiel für einen erfolgreichen Start:
$ .\/seccomp_lib echo ok
ok
Beispiel eines blockierten Systemaufrufs:
$ sudo .\/seccomp_lib mount -t bpf bpf \/tmp
Schlechter Systemaufruf
Verwenden Sie strace, um weitere Details zu erfahren:
$ sudo strace -e seccomp .\/seccomp_lib mount -t bpf bpf \/tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ getötet von SIGSYS (Core-Dump erstellt) +++
Schlechter Systemaufruf
woher wir erfahren können, dass das Programm wegen der Verwendung eines verbotenen Systemaufrufs beendet wurde mount(2).
Insgesamt haben wir einen Filter mit Hilfe der Bibliothek geschrieben, libseccomp, wobei wir nicht-trivialen Code in vier Zeilen untergebracht haben. Im obigen Beispiel kann die Ausführungszeit bei einer großen Anzahl von Systemaufrufen erheblich gesenkt werden, da die Überprüfung einfach eine Liste von Vergleichen ist. Zur Optimierung wurde kürzlich in libseccomp ein , der die Unterstützung für das Filterattribut SCMP_FLTATR_CTL_OPTIMIZE, hinzufügt. Wenn Sie dieses Attribut auf 2 setzen, wird der Filter in ein Programm für binäre Suche umgewandelt.
Wenn Sie sehen möchten, wie Filter mit binärer Suche konzipiert sind, schauen Sie sich das an , das solche Programme in BPF-Assembler für eine Reihe von Systemaufrufnummern generiert, beispielsweise:
$ echo 1 3 6 8 13 | .\/generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Nichts wesentlich Schnelleres zu schreiben wird möglich sein, da BPF-Programme keine Sprünge über Einrückungen machen können (wir können beispielsweise nicht jmp A oder jmp [label+X]) und daher sind alle Sprünge statisch.
seccomp und strace
Alle kennen das Dienstprogramm strace — ein unverzichtbares Werkzeug bei der Untersuchung des Verhaltens von Prozessen unter Linux. Viele wissen jedoch auch von bei der Verwendung dieses Dienstprogramms. Es ist so, dass strace implementiert wird durch ptrace(2), und in diesem Mechanismus können wir nicht angeben, bei welcher bestimmten Menge von Systemaufrufen wir den Prozess anhalten müssen, d.h. zum Beispiel die Befehle
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
und
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
in etwa derselben Zeit ablaufen, obwohl wir im zweiten Fall nur einen Systemaufruf verfolgen möchten.
Neue Option --seccomp-bpf, die in strace Version 5.3 hinzugefügt wurde, ermöglicht es, den Prozess erheblich zu beschleunigen, und die Startzeit unter Nachverfolgung eines Systemaufrufs ist bereits mit der normalen Startzeit vergleichbar:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Hier gibt es natürlich eine kleine Täuschung, da wir nicht den Hauptsystemaufruf dieses Befehls nachverfolgen. Wenn wir beispielsweise newfsstat, dann strace verlangsamen würden, wäre es so stark wie ohne --seccomp-bpf.)
Wie funktioniert diese Option? Ohne sie strace wird sich mit dem Prozess verbinden und ihn mithilfe von PTRACE_SYSCALL. Wenn der gesteuerte Prozess einen (beliebigen) Systemaufruf ausführt, wird die Kontrolle übergeben strace, die die Argumente des Systemaufrufs betrachtet und ihn mithilfe von PTRACE_SYSCALL. Nach einer Weile beendet der Prozess den Systemaufruf, und beim Verlassen wird die Kontrolle wieder an strace, die die Rückgabewerte überprüft und den Prozess mithilfe von PTRACE_SYSCALL, usw.
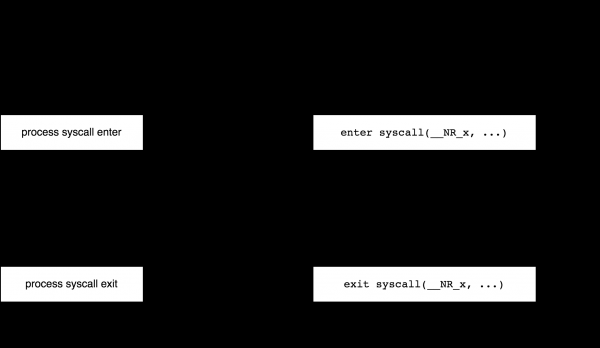
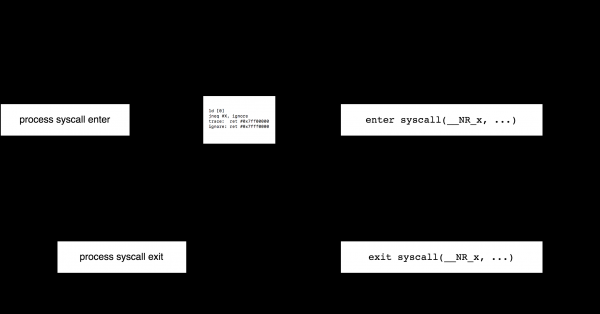
Mit seccomp kann dieser Prozess jedoch genau so optimiert werden, wie wir es wünschen. Wenn wir nur auf den Systemaufruf Xsehen wollen, können wir einen BPF-Filter schreiben, der für X den Wert zurückgibt SECCOMP_RET_TRACE, und für nicht interessante Aufrufe — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
In diesem Fall strace startet ursprünglich den Prozess als PTRACE_CONT, bei jedem Systemaufruf wird unser Filter abgearbeitet, wenn der Systemaufruf nicht X, fährt der Prozess fort, aber wenn dies X, wird seccomp die Kontrolle übergeben strace, die die Argumente betrachtet und den Prozess als PTRACE_SYSCALL startet (da es in seccomp keine Möglichkeit gibt, das Programm beim Verlassen des Systemaufrufs zu starten). Wenn der Systemaufruf zurückkehrt, strace wird der Prozess mithilfe von PTRACE_CONT neu gestartet und wartet auf neue Nachrichten von seccomp.
Bei Verwendung der Option --seccomp-bpf Es gibt zwei Einschränkungen. Erstens ist es nicht möglich, sich an einem bereits bestehenden Prozess anzuschließen (Option -p des Programms strace), da dies von seccomp nicht unterstützt wird. Zweitens gibt es keine Möglichkeit, nicht auf Kindprozesse zuzugreifen, da seccomp-Filter von allen Kindprozessen ohne Möglichkeit zur Deaktivierung geerbt werden.
Ein wenig mehr Details dazu, wie genau strace arbeitet mit seccomp erfahren werden können aus . Für uns ist die interessanteste Tatsache, dass klassisches BPF in Form von seccomp nach wie vor Anwendung findet.
xt_bpf
Lassen Sie uns nun zurück in die Welt der Netzwerke gehen.
Hintergrund: Vor langer Zeit, im Jahr 2007, wurde in den Kernel Modul xt_u32 für netfilter eingeführt. Es wurde nach dem Vorbild des noch älteren Traffic-Klassifikators cls_u32 geschrieben und erlaubte das Schreiben beliebiger binärer Regeln für iptables mit Hilfe der folgenden einfachen Operationen: 32 Bit aus dem Paket laden und eine Reihe von arithmetischen Operationen durchführen. Zum Beispiel,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Lädt 32 Bit des IP-Headers, beginnend mit Offset 6, und wendet eine Maske an 0xFF (nimm das niedrigste Byte). Dies ist das Feld protocol des IP-Headers und wir vergleichen es mit 1 (ICMP). In einer Regel können viele Prüfungen kombiniert werden und man kann auch den Operator @ verwenden — um X Bytes nach rechts zu verschieben. Zum Beispiel überprüft die Regel
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"ob die TCP-Sequenznummer nicht gleich ist. 0x29Ich werde nicht weiter ins Detail gehen, da bereits klar ist, dass das Schreiben solcher Regeln von Hand nicht sehr bequem ist. Im Artikel , gibt es mehrere Links mit Beispielen zur Verwendung und Generierung von Regeln für xt_u32. Siehe auch die Links am Ende dieses Artikels.
Seit 2013 kann anstelle des Moduls xt_u32 ein auf BPF basierendes Modul verwendet werden. xt_bpfAllen, die bis hierher gelesen haben, sollte das Prinzip seiner Funktionsweise bereits klar sein: BPF-Bytecode als iptables-Regeln ausführen. Eine neue Regel kann zum Beispiel so erstellt werden:
iptables -A INPUT -m bpf --bytecode -j LOGhier <байткод> ist der Code im Ausgabeformat des Assembler bpf_asm z.B.
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
In diesem Beispiel filtern wir alle UDP-Pakete. Der Kontext für das BPF-Programm im Modul xt_bpfzeigt natürlich auf die Daten des Pakets, im Fall von iptables — auf den Anfang des IPv4-Headers. Der Rückgabewert aus dem BPF-Programm false was bedeutet, dass das Paket nicht übereinstimmt.
Es ist klar, dass das Modul xt_bpf kompliziertere Filter unterstützt als im obigen Beispiel. Lassen Sie uns echte Beispiele von Cloudflare ansehen. Bis vor kurzem verwendeten sie ein Modul xt_bpf zum Schutz vor DDoS-Angriffen. In dem Artikel erklären sie, wie (und warum) sie BPF-Filter generieren und veröffentlichen Links zu einem Set von Tools zur Erstellung solcher Filter. Zum Beispiel kann man mit dem Tool bpfgen ein BPF-Programm erstellen, das DNS-Anfragen nach dem Namen habr.com:
$ .\/bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
Im Programm laden wir zunächst die Adresse des Anfangs der Zeichenkette X x04habrx03comx00 innerhalb des UDP-Datagramms und überprüfen dann die Anfrage: 0x04686162 <-> "x04hab" Ein wenig später veröffentlichte Cloudflare den Code des Compilers p0f -> BPF. In dem Artikel usw.
Introducing the p0f BPF compiler $ .\/bpfgen p0f -- 4:64:0:0:*,0::ack+:0 39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0, 84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6, ...
Aktuell nutzt Cloudflare nicht mehr, da sie auf XDP umgestiegen sind — eine der Varianten der neuen Version von BPF, siehe xt_bpfL4Drop: XDP DDoS Mitigations .
cls_bpf
für die Datenverkehrskontrollsubsystem in Linux, der Ende 2013 in Linux hinzugefügt wurde und konzeptionell den alten ersetzt hat. cls_bpf Wir werden jedoch nicht jetzt die Funktionsweise cls_u32.
beschreiben, da uns das aus der Sicht des Wissens über klassisches BPF nichts bringt — wir kennen bereits die gesamte Funktionalität. Außerdem werden wir in den folgenden Artikeln über Extended BPF mehrfach auf diesen Klassifizierer stoßen. cls_bpfEin weiterer Grund, nicht über die Verwendung von klassischem BPF zu berichten,
liegt darin, dass im Vergleich zu Extended BPF in diesem Fall der Anwendungsbereich erheblich eingeengt wird: Klassische Programme können den Inhalt von Paketen nicht ändern und keinen Zustand zwischen Aufrufen speichern. cls_bpf Es ist also Zeit, sich von klassischem BPF zu verabschieden und in die Zukunft zu blicken.
Abschied vom klassischen BPF
Abschied von classic BPF
Wir haben uns angeschaut, wie die in den frühen neunziger Jahren entwickelte BPF-Technologie ein Vierteljahrhundert überdauert hat und bis heute neue Anwendungen findet. Ähnlich wie der Übergang von Stack-Maschinen zu RISC, der den Anstoß zur Entwicklung des klassischen BPF gab, fand in den 2000er Jahren der Übergang von 32-Bit- zu 64-Bit-Maschinen statt, wodurch das klassische BPF allmählich veraltet ist. Darüber hinaus sind die Möglichkeiten des klassischen BPF stark eingeschränkt; abgesehen von der veralteten Architektur fehlt uns die Möglichkeit, den Zustand zwischen Aufrufen von BPF-Programmen zu speichern, es gibt keine direkte Interaktion mit dem Benutzer und keine Möglichkeit zur Interaktion mit dem Kernel, abgesehen vom Lesen einer begrenzten Anzahl von Feldern der Struktur. sk_buff und das Ausführen einfacher Hilfsfunktionen, das Inhaltsverzeichnis von Paketen kann nicht verändert und umgeleitet werden.
Tatsächlich bleibt im Moment vom klassischen BPF in Linux nur die API-Schnittstelle übrig, während im Kernel alle klassischen Programme, sei es Socket-Filter oder Seccomp-Filter, automatisch in ein neues Format, das Extended BPF, übersetzt werden. (Wir werden in dem nächsten Artikel erklären, wie genau das geschieht.)
Der Übergang zu einer neuen Architektur begann 2013, als Alexey Starovoitov ein Update-Schema für BPF vorschlug. 2014 erschienen die entsprechenden Patches Weitere Artikel in dieser Reihe werden über die Architektur und Anwendungen der neuen Technologie berichten, die ursprünglich als internal BPF, dann als extended BPF und jetzt einfach als BPF bekannt ist.
Steven McCanne und Van Jacobson, "The BSD Packet Filter: Eine neue Architektur für die Benutzer-Ebene Packet Capture",
Links
- Steven McCanne, "libpcap: Eine Architektur und Optimierungsmethodik für die Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - IPtable U32 Match Tutorial
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- Einführung des BPF-Tools:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - bpf_cls
https://blog.cloudflare.com/introducing-the-bpf-tools/ Ein Überblick über seccomp::http://man7.org/linux/man-pages/man8/tc-bpf.8.html- habr: Container und Sicherheit: seccomp
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Berkeley Packet Filters (BPF) — das ist eine Technologie des Linux-Kernels, die seit mehreren Jahren ständig in den Schlagzeilen englischsprachiger Technikausgaben steht.
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ , das unter anderem ein fortschrittliches Programm enthält, das neben der Filterung mit BPF auch einen effizienten Verkehrsgenerator enthält, und fortschrittlicher ist als:http://netsniff-ng.org/
Quelle: habr.com
