

Hallo! Ich bin Wadim Madison, ich leite die Entwicklung der Systemplattform von Avito. Oft wurde bereits darüber gesprochen, wie wir im Unternehmen von einer monolithischen Architektur zu Mikrodiensten übergehen. Es ist an der Zeit, zu teilen, wie wir unsere Infrastruktur transformiert haben, um das Beste aus Mikrodiensten herauszuholen und uns darin nicht zu verlieren. Wie uns PaaS dabei hilft, wie wir den Deployment-Prozess vereinfacht und das Erstellen eines Mikrodienstes auf einen Klick reduziert haben – lesen Sie weiter. Nicht alles, was ich unten schreibe, ist bei Avito vollständig umgesetzt, teilweise ist es, wie wir unsere Plattform weiterentwickeln.
(Und am Ende dieses Artikels werde ich von der Möglichkeit berichten, an einem dreitägigen Seminar über Mikrodienste von dem Experten Chris Richardson teilzunehmen).
Wie wir zu Mikrodiensten gekommen sind
Avito ist eines der größten Kleinanzeigenportale der Welt, auf dem täglich über 15 Millionen neue Anzeigen geschaltet werden. Unser Backend verarbeitet mehr als 20.000 Anfragen pro Sekunde. Derzeit haben wir mehrere Hundert Mikrodienste.
Wir haben seit mehreren Jahren eine Mikrodienstarchitektur aufgebaut. Wie genau – unsere Kollegen haben das in Details auf unserer Sektion auf RIT++ 2017. Auf CodeFest 2017 (siehe ), haben Sergey Orlov und Michail Prokopchuk ausführlich erklärt, warum wir überhaupt zu Mikrodiensten wechseln mussten und welche Rolle Kubernetes dabei spielte. Jetzt tun wir alles, um die Skalierungskosten, die mit dieser Architektur verbunden sind, zu minimieren.
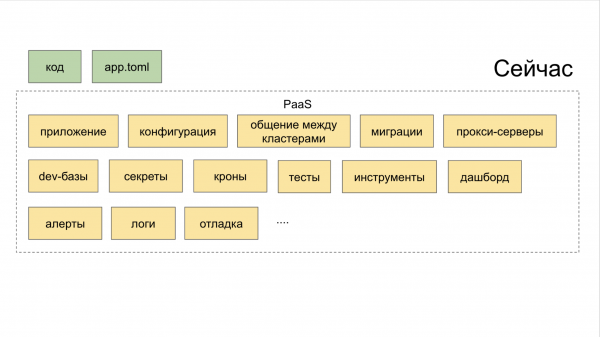
Ursprünglich haben wir kein Ökosystem geschaffen, das uns umfassend bei der Entwicklung und dem Start von Mikrodiensten unterstützt. Wir haben einfach einige bewährte Open-Source-Lösungen gesammelt, sie bei uns gestartet und dem Entwickler empfohlen, sich damit auseinanderzusetzen. Letztendlich musste er in Dutzende von Orten (Dashboards, interne Dienste) gehen, was ihn in seinem Bestreben bestärkte, weiterhin Code im alten monolithischen Stil zu schreiben. In den unten stehenden Diagrammen sind die Bereiche, in denen der Entwickler mehr oder weniger selbst tätig wird, in Grün dargestellt, die Automatisierung in Gelb.
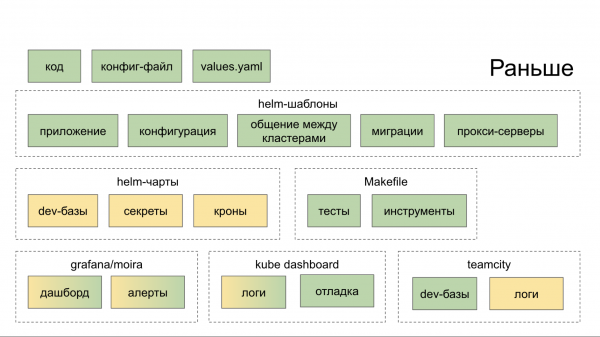
Jetzt wird in der CLI-Utility PaaS mit einem Befehl ein neuer Dienst erstellt, während mit weiteren zwei eine neue Datenbank hinzugefügt und in die Stage deployt wird.
Wie man die Ära der 'Mikrodienstfragmentierung' überwindet
Bei einer monolithischen Architektur waren die Entwickler gezwungen, sich mit den Änderungen der Nachbarn auseinanderzusetzen, um die Konsistenz des Produkts zu gewährleisten. Bei der Arbeit mit der neuen Architektur hängen die Kontexte der Dienste nicht mehr voneinander ab.
Darüber hinaus erfordert eine effektive Mikrodienstarchitektur die Etablierung zahlreicher Prozesse, nämlich:
• Logging;
• Anfrageverfolgung (Jaeger);
• Fehleraggregation (Sentry);
• Status, Nachrichten, Ereignisse aus Kubernetes (Event Stream Processing);
• Race Limit / Circuit Breaker (Hystrix kann verwendet werden);
• Überwachung der Dienstverknüpfungen (wir verwenden Netramesh);
• Monitoring (Grafana);
• Build (TeamCity);
• Kommunikation und Benachrichtigung (Slack, E-Mail);
• Aufgabenverfolgung; (Jira)
• Erstellung von Dokumentationen.
Um sicherzustellen, dass das System beim Skalieren seine Integrität nicht verliert und effizient bleibt, haben wir die Organisation der Mikrodienste bei Avito neu gestaltet.
Wie wir mit Mikrodiensten umgehen
Eine einheitliche "Partei-Politik" unter den zahlreichen Mikrodiensten von Avito wird unterstützt durch:
- die Aufteilung der Infrastruktur in Schichten;
- das Konzept von Platform as a Service (PaaS);
- das Monitoring von allem, was mit Mikrodiensten passiert.
Die Abstraktionsschichten der Infrastruktur bestehen aus drei Schichten. Lassen Sie uns von oben nach unten gehen.
A. Obere Schicht — Service Mesh. Zunächst haben wir Istio ausprobiert, aber es stellte sich heraus, dass es zu viele Ressourcen verbraucht, was bei unserem Volumen zu teuer wird. Daher entwickelte der leitende Ingenieur im Architekturteam, Alexander Lukyantschenko, eine eigene Lösung — (verfügbar im Open Source), die wir derzeit im Produktionsbetrieb verwenden und die mehrere Male weniger Ressourcen verbraucht als Istio (aber nicht alle Funktionen bietet, mit denen Istio aufwarten kann).
B. Mittlere Schicht — Kubernetes. Darauf installieren und betreiben wir die Mikrodienste.
C. Untere Schicht — Bare Metal. Wir verwenden keine Clouds und keine Dinge wie OpenStack, sondern arbeiten vollständig auf Bare Metal.
Alle Schichten werden durch PaaS verbunden. Diese Plattform besteht wiederum aus drei Teilen.
I. Generatoren, die über ein CLI-Tool gesteuert werden. Dieses hilft dem Entwickler, Mikrodienste richtig und mit minimalem Aufwand zu erstellen.
II. Konsolidierter Collector mit Kontrolle aller Werkzeuge über ein gemeinsames Dashboard.
III. Speicher. Es wird mit Planern verbunden, die automatisch Trigger für wichtige Aktionen setzen. Mit einem solchen System bleibt keine Aufgabe unbewältigt, nur weil jemand vergessen hat, sich eine Aufgabe in Jira zu setzen. Dazu verwenden wir ein internes Tool namens Atlas.
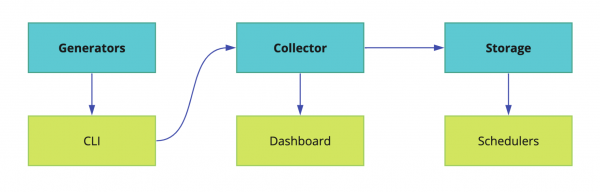
Die Umsetzung von Mikrodiensten bei Avito erfolgt ebenfalls nach einem einheitlichen Schema, das die Kontrolle über sie in jeder Entwicklungs- und Veröffentlichungsphase erleichtert.
Wie der Standard-Entwicklungspipeline eines Mikrodienstes aufgebaut ist
Im Allgemeinen sieht die Kette zur Erstellung eines Mikrodienstes wie folgt aus:
CLI-push → Continuous Integration → Bake → Deployment → Automatisierte Tests → Canary-Tests → Squeeze Testing → Produktion → Wartung.
Lassen Sie uns diese Schritte genau in dieser Reihenfolge durchgehen.
CLI-push
• Erstellung des Mikrodienstes.
Wir haben lange daran gearbeitet, jeden Entwickler darin zu schulen, Mikrodienste zu erstellen. Dazu haben wir ausführliche Anleitungen in Confluence verfasst. Aber die Schemas änderten sich und wurden ergänzt. Das Ergebnis — der Flaschenhals entstand zu Beginn des Prozesses: Der Start von Mikrodiensten benötigte erheblich mehr Zeit als zulässig, und trotzdem traten beim Erstellen häufig Probleme auf.
Schließlich haben wir eine einfache CLI-Anwendung entwickelt, die die Hauptschritte bei der Erstellung eines Mikrodienstes automatisiert. Tatsächlich ersetzt sie den ersten git push. Hier ist, was sie konkret macht.
— Erstellt den Dienst schrittweise nach einem Template im „Wizard“-Modus. Wir haben Vorlagen für die wichtigsten Programmiersprachen im Backend von Avito: PHP, Golang und Python.
— Mit einem einzigen Befehl wird die Umgebung für die lokale Entwicklung auf einem bestimmten Computer bereitgestellt — Minikube wird gestartet, Helm-Diagramme werden automatisch generiert und in Kubernetes lokal gestartet.
— Stellt die benötigte Datenbank bereit. Der Entwickler muss nicht IP, Benutzername und Passwort kennen, um auf die benötigte DB zuzugreifen — egal ob lokal, auf Staging oder in der Produktion. Dabei wird die Datenbank sofort in einer ausfallsicheren Konfiguration mit Lastverteilung bereitgestellt.
— Führt eine Live-Build durch. Angenommen, der Entwickler hat etwas im Mikrodienst über seine IDE geändert. Das Tool erkennt die Änderungen im Dateisystem und baut die Anwendung (für Golang) basierend darauf neu und startet sie neu. Für PHP geben wir einfach das Verzeichnis innerhalb des Pods durch und dort erfolgt das live-reload „automatisch“.
— Generiert Autotests. In Form von Vorlagen, die jedoch gut verwendbar sind.
• Microservice-Deployment.
Das Deployment des Microservices war bisher etwas mühsam. Es wurden zwingend folgende Dinge benötigt:
I. Dockerfile.
II. Konfiguration.
III. Helm-Chart, das allein schon umfangreich ist und Folgendes umfasst:
— die Charts selbst;
— Vorlagen;
— spezifische Werte unter Berücksichtigung verschiedener Umgebungen.
Wir haben den Schmerz des Umwandelns von Kubernetes-Manifests überwunden, und jetzt werden sie automatisch generiert. Aber das Wichtigste ist, dass wir das Deployment bis ins Extrem vereinfacht haben. Ab sofort haben wir ein Dockerfile, und der gesamte Konfigurationsaufwand wird von Entwicklern in einer einzigen kurzen Datei app.toml festgelegt.
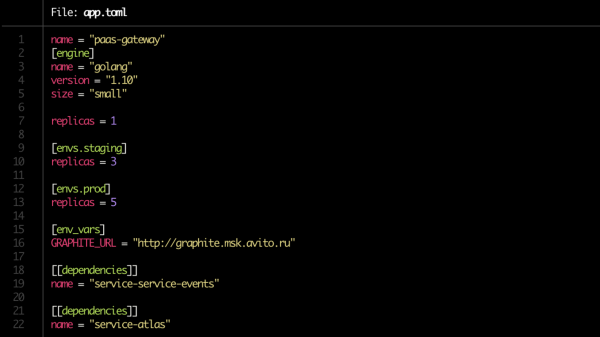
Und im app.toml ist es jetzt auch ganz einfach. Wir geben an, wie viele Kopien des Services hochgefahren werden sollen (auf dem Dev-Server, in der Staging-Umgebung, in der Produktion) und spezifizieren die Abhängigkeiten. Beachten Sie die Zeile size = "small" im Block [engine]. Das ist das Limit, das dem Service über Kubernetes zugewiesen wird.
Darauf basierend werden automatisch alle notwendigen Helm-Charts generiert und die Verbindungen zu Datenbanken hergestellt.
• Grundlegende Validierung. Solche Überprüfungen sind ebenfalls automatisiert.
Es muss überwacht werden:
— ob ein Dockerfile vorhanden ist;
— ob ein app.toml vorhanden ist;
— ob Dokumentation vorhanden ist;
— ob die Abhängigkeiten in Ordnung sind;
— ob die Alarmregeln festgelegt sind.
Zum letzten Punkt: Der Service-Eigentümer gibt selbst an, welche Produktmetriken überwacht werden sollen.
• Vorbereitung der Dokumentation.
Bislang ein problematischer Punkt. Eigentlich das Naheliegende, ist aber gleichzeitig ein rekordverdächtig „häufig vergessenes“, also ein verwundbares Glied in der Kette.
Es ist notwendig, dass für jeden Microservice eine Dokumentation vorliegt. Diese umfasst folgende Blöcke.
I. Kurze Beschreibung des Services.Nur wenige Sätze darüber, was er tut und wozu er benötigt wird.
II. Link zum Architekturschema.Es ist wichtig, dass beim flüchtigen Blick darauf sofort klar wird, ob Sie Redis beispielsweise zum Caching oder als Hauptdatenspeicher im persistenten Modus verwenden. Bei Avito ist das momentan ein Link zu Confluence.
III. Runbook.Eine kurze Anleitung zum Start des Services und zu den Feinheiten im Umgang mit ihm.
IV. FAQ,in der es gut wäre, Probleme vorwegzunehmen, mit denen Ihre Kollegen beim Arbeiten mit dem Service konfrontiert werden könnten.
V. Beschreibung der Endpunkte für die API.. Falls Sie zufällig keine Zielpunkte angegeben haben, werden wahrscheinlich Ihre Kollegen, deren Mikrodienste mit Ihrem verbunden sind, dafür bezahlen. Derzeit verwenden wir dafür Swagger und unsere Lösung mit dem Namen brief.
VI. Etiketten. Oder Marker, die anzeigen, zu welchem Produkt, welcher Funktionalität oder welchem organisatorischen Teil des Unternehmens der Dienst gehört. Sie helfen, schnell zu verstehen, ob Sie beispielsweise eine Funktionalität entwickeln, die Ihre Kollegen vor einer Woche für dasselbe Business-Unit ausgegeben haben.
VII. Besitzer oder Besitzer des Dienstes. In den meisten Fällen kann ihm – oder ihnen – mithilfe von PaaS automatisch zugeordnet werden, aber zur Sicherheit verlangen wir vom Entwickler, diese manuell anzugeben.
Schließlich ist es eine gute Praxis, die Dokumentation zu überprüfen, ähnlich wie bei einem Code-Review.
Kontinuierliche Integration
- Vorbereitung der Repositories.
- Erstellung der Pipeline in TeamCity.
- Festlegung der Berechtigungen.
- Suche nach den Besitzern des Dienstes. Hier gibt es ein hybrides Schema – manuelle Etikettierung und minimale Automatisierung von PaaS. Vollautomatische Schemas verursachen Fehler bei der Übertragung von Diensten zur Unterstützung in ein anderes Entwicklungsteam oder beispielsweise, wenn der Entwickler des Dienstes gekündigt hat.
- Registrierung des Dienstes in Atlas (siehe oben). Mit all seinen Besitzern und Abhängigkeiten.
- Überprüfung der Migrationen. Wir überprüfen, ob potenziell gefährliche dabei sind. Beispielsweise tritt bei einer von ihnen ein alter table auf oder etwas anderes, das die Kompatibilität des Datenschemas zwischen verschiedenen Versionen des Dienstes beeinträchtigen könnte. Dann wird die Migration nicht ausgeführt, sondern in die Warteschlange gesetzt – PaaS muss den Dienstbesitzer benachrichtigen, wenn es sicher ist, sie anzuwenden.
Bake
Die nächste Phase besteht darin, die Dienste vor dem Deployment zu packen.
- Erstellung der Anwendung. Klassischerweise – in ein Docker-Image.
- Generierung von Helm-Charts für den Dienst selbst und die damit verbundenen Ressourcen. Unter anderem für Datenbanken und Cache. Diese werden automatisch entsprechend der app.toml-Konfiguration erstellt, die in der Phase des CLI-Pushs formuliert wurde.
- Erstellung von Tickets an die Administratoren zur Öffnung von Ports (wenn dies erforderlich ist).
- Durchführung von Unit-Tests und Berechnung der Codeabdeckung. Wenn die Codeabdeckung unter dem festgelegten Schwellenwert liegt, wird der Service wahrscheinlich nicht weiter - zur Bereitstellung - bestehen. Liegt die Abdeckung an der Grenze des Zulässigen, erhält der Service einen "pessimistischen" Faktor: Wenn sich der Wert der Metrik im Laufe der Zeit nicht verbessert, wird der Entwickler benachrichtigt, dass es im Bereich der Tests keinen Fortschritt gibt (und etwas dagegen unternommen werden sollte).
- Berücksichtigung von Einschränkungen bei Speicher und CPU. Hauptsächlich schreiben wir Mikrodienste in Golang und führen sie in Kubernetes aus. Daraus ergibt sich eine Besonderheit des Golang: Standardmäßig werden beim Start alle Kerne auf dem Rechner genutzt, es sei denn, die Variable GOMAXPROCS wird explizit gesetzt, und wenn mehrere solcher Dienste auf einem Rechner gestartet werden, beginnen sie, um Ressourcen zu konkurrieren und behindern sich gegenseitig. In den folgenden Grafiken ist zu sehen, wie die Ausführungszeit variiert, wenn die Anwendung ohne Wettbewerb und im Ressourcenwettbewerb ausgeführt wird. (Die Quellcodes der Grafiken liegen ).
Ausführungszeit, weniger ist besser. Maximum: 643ms, Minimum: 42ms. Das Foto ist klickbar.
Zeit für den Vorgang, weniger ist besser. Maximum: 14091 ns, Minimum: 151 ns. Das Foto ist klickbar.
In der Vorbereitungsphase der Builds kann diese Variable entweder explizit gesetzt werden oder es kann die Bibliothek von den Jungs bei Uber.
Bereitstellung
• Prüfung der Konventionen. Bevor du beginnst, die Builds des Dienstes in die vorgesehenen Umgebungen zu liefern, muss Folgendes geprüft werden:
— API-Endpunkte.
— Übereinstimmung der Antworten der API-Endpunkte mit dem Schema.
— Format der Protokolle.
— Setzen von Headern bei Anfragen an den Dienst (das erledigt derzeit netramesh)
— Setzen eines Eigentümerkodex bei der Versendung von Nachrichten an den Bus (Event-Bus). Dies ist notwendig, um die Kohärenz der Dienste über den Bus hinweg zu verfolgen. In den Bus können sowohl idempotente Daten gesendet werden, die die Kohärenz der Dienste nicht erhöhen (was gut ist), als auch Geschäftsdaten, die die Kohärenz der Dienste verstärken (was sehr schlecht ist!). Und in dem Moment, wenn diese Kohärenz zum Problem wird, hilft das Verständnis darüber, wer den Bus schreibt und liest, die Dienste richtig zu trennen.
Während es bei Avito noch nicht viele Konventionen gibt, wächst der Pool. Je mehr solcher Vereinbarungen in einer für das Team verständlichen und bequemen Form vorliegen, desto einfacher ist es, die Konsistenz zwischen den Mikrodiensten aufrechtzuerhalten.
Synthetic Tests
• Testen in einem geschlossenen Kreislauf. Dafür verwenden wir derzeit die Open-Source- . Zuerst zeichnet er die tatsächliche Last auf den Dienst auf, dann emuliert er sie genau im geschlossenen System.
• Lasttests. Wir bemühen uns, alle Dienste auf optimale Leistung zu bringen. Jede Version jedes Dienstes muss Lasttests unterzogen werden — nur so können wir die aktuelle Leistung des Dienstes und den Unterschied zu den vorherigen Versionen desselben Dienstes verstehen. Wenn die Leistung nach einem Update des Dienstes um das anderthalbfache gesunken ist, ist das ein eindeutiges Signal für die Verantwortlichen: Es ist notwendig, in den Code einzutauchen und die Situation zu beheben.
Auf den gesammelten Daten basieren wir zum Beispiel, um das Auto-Scaling richtig zu implementieren und schließlich zu verstehen, wie skalierbar der Dienst überhaupt ist.
Bei Lasttests überprüfen wir, ob der Ressourcenverbrauch den festgelegten Beschränkungen entspricht. Dabei konzentrieren wir uns vor allem auf Extremwerte.
a) Wir betrachten die Gesamtlaste.
— Zu gering — wahrscheinlich funktioniert etwas überhaupt nicht, wenn die Last plötzlich um mehrere Faktoren gesunken ist.
— Zu hoch — Optimierung erforderlich.
b) Wir betrachten die RPS-Schwelle.
Hier sehen wir sowohl den Unterschied zwischen der aktuellen und der vorherigen Version als auch die Gesamtzahl. Wenn der Dienst 100 RPS ausgibt — dann ist er entweder schlecht geschrieben oder es ist seine Spezifikation, aber in jedem Fall ist das ein Grund, den Dienst sehr genau zu überprüfen.
Wenn jedoch die RPS zu hoch sind, könnte es einen Fehler geben und einer der Endpoints führt keine nützliche Nutzlast mehr aus, sondern wird nur durch irgendetwas ausgelöst. public void UserUpdate(User user)
Canary-Tests
Nachdem die synthetischen Tests durchlaufen wurden, testen wir die Funktionsweise des Mikrodienstes mit einer kleinen Anzahl von Benutzern. Wir beginnen vorsichtig mit einem sehr geringen Anteil der geschätzten Zielgruppe des Dienstes — weniger als 0,1 %. In dieser Phase ist es sehr wichtig, dass im Monitoring die richtigen technischen und produktbezogenen Metriken erfasst werden, um Probleme im Dienst so schnell wie möglich aufzuzeigen. Die minimale Dauer des Canary-Tests beträgt 5 Minuten, in der Regel 2 Stunden. Für komplexe Dienste legen wir die Zeit manuell fest.
Wir analysieren:
— metrikenspezifisch für die Sprache, insbesondere php-fpm-Worker;
— Fehler in Sentry;
— Antwortstatus;
— Antwortzeiten (response time), genau und durchschnittlich;
— Latenz;
— bearbeitete und unbehandelte Ausnahmen;
— produktbezogene Metriken.
Squeeze Testing
Squeeze Testing wird auch als "Ausdrück-Test" bezeichnet. Die Methode wurde bei Netflix eingeführt. Ihr Prinzip besteht darin, dass wir zunächst einen Instanz mit echtem Traffic bis zur Ausfallgrenze beladen und damit sein Limit festlegen. Anschließend fügen wir einen weiteren Instanz hinzu und belasten dieses Paar erneut bis zum Maximum; wir beobachten ihre Obergrenze und die Differenz zum ersten „Squeeze“. So fügen wir schrittweise weitere Instanzen hinzu und berechnen die Muster in den Änderungen.
Die Daten von Tests durch „Ausdrücken“ fließen ebenfalls in eine gemeinsame Metrikdatenbank, in der wir entweder die Ergebnisse der künstlichen Belastung anreichern oder sie vollständig durch „synthetische“ Daten ersetzen.
Produktion
• Skalierung. Beim Rollout eines Dienstes in die Produktion überwachen wir, wie er skalierbar ist. Nur die CPU-Werte zu überwachen, ist nach unserer Erfahrung nicht effektiv. Auto-Scaling mit Benchmarking von RPS funktioniert theoretisch, jedoch nur für bestimmte Dienste, beispielsweise Online-Streaming. Daher konzentrieren wir uns in erster Linie auf spezifische produktbezogene Metriken der Anwendung.
Letztendlich analysieren wir bei der Skalierung:
— die Werte von CPU und RAM,
— die Anzahl der Anfragen in der Warteschlange,
— die Antwortzeiten,
— Vorhersagen basierend auf gesammelten historischen Daten.
Bei der Skalierung eines Dienstes ist es ebenfalls wichtig, seine Abhängigkeiten zu überwachen, um zu vermeiden, dass wir den ersten Dienst in der Kette skalieren, während die von ihm angesprochenen Dienste unter der Last zusammenbrechen. Um eine akzeptable Last für den gesamten Pool von Diensten zu bestimmen, schauen wir uns die historischen Daten des „nächsten“ abhängigen Dienstes (in Kombination mit CPU- und RAM-Werten sowie app-spezifischen Metriken) an und vergleichen sie mit den historischen Daten des initiierenden Dienstes und so weiter durch die gesamte „Abhängigkeitskette“ von oben nach unten.
Wartung
Nachdem der Mikrodienst in Betrieb genommen wurde, können wir Trigger darauf setzen.
Hier sind typische Situationen, in denen die Trigger ausgelöst werden.
— Potenziell gefährliche Migrationen wurden festgestellt.
— Sicherheitsupdates wurden veröffentlicht.
— Der Dienst wurde lange nicht aktualisiert.
— Die Last auf den Dienst hat merklich abgenommen oder einige seiner produktbezogenen Metriken überschreiten die Norm.
— Der Dienst entspricht nicht mehr den neuen Anforderungen der Plattform.
Ein Teil der Trigger ist für die Stabilität des Betriebs verantwortlich, ein anderer Teil fungiert als Systemwartungsfunktion – zum Beispiel, wenn ein bestimmter Dienst schon lange nicht mehr bereitgestellt wurde und sein Basis-Image die Sicherheitsüberprüfung nicht bestanden hat.
Dashboard
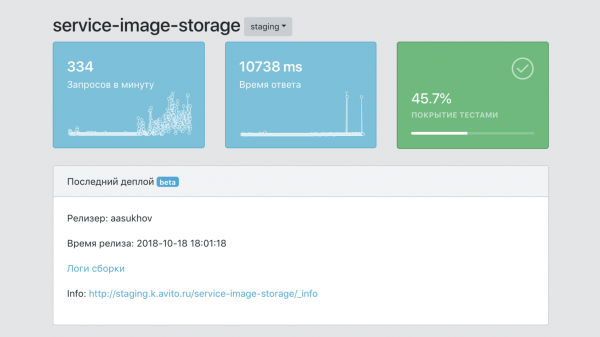
Kurz gesagt ist das Dashboard das Steuerpult unserer gesamten PaaS.
- Ein zentraler Informationspunkt über den Dienst, mit Daten zu seiner Testabdeckung, der Anzahl seiner Images, der Anzahl der Produktionskopien, Versionen usw.
- Ein Werkzeug zur Datenfilterung nach Diensten und Labels (Markierungen zur Zugehörigkeit zu Geschäftseinheiten, Produktfunktionen usw.)
- Ein Mittel zur Integration mit Infrastrukturtools für Tracing, Logging und Monitoring.
- Ein zentraler Dokumentationspunkt für Dienste.
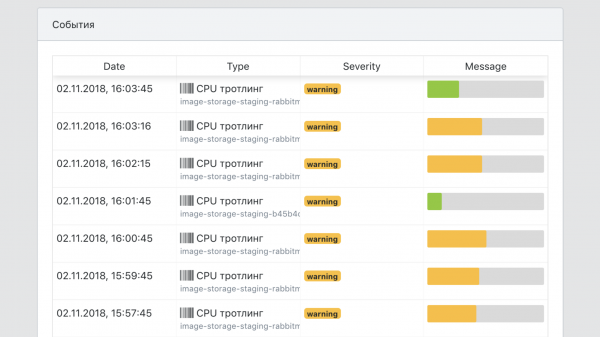
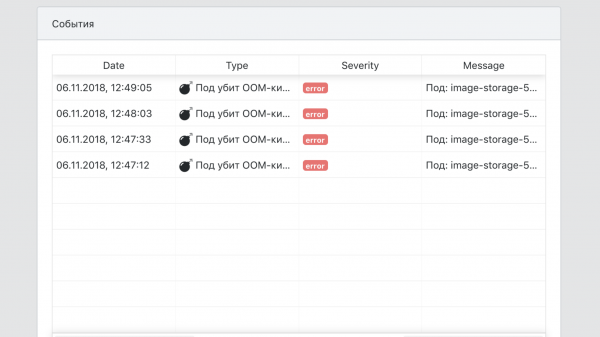
- Ein zentraler Überblick über alle Ereignisse in Bezug auf die Dienste.
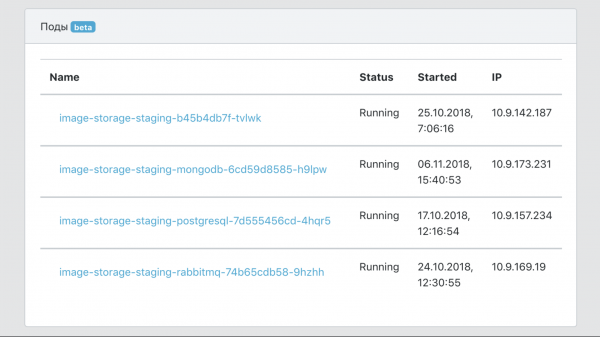
Insgesamt
Vor der Einführung von PaaS konnte ein neuer Entwickler mehrere Wochen damit verbringen, sich mit allen Tools vertraut zu machen, die erforderlich sind, um einen Mikrodienst in die Produktion zu bringen: Kubernetes, Helm – entsprechend unseren internen Besonderheiten in TeamCity, den Einstellungen zur Verbindung mit Datenbanken und Caches in einer fehlertoleranten Weise usw. Jetzt dauert es nur noch einige Stunden – das Quickstart-Dokument zu lesen und den Dienst selbst zu erstellen.
Ich habe zum Thema einen Vortrag auf der HighLoad++ 2018 gehalten, das kann man sich ansehen. und .
Bonus-Track für diejenigen, die bis zum Ende gelesen haben.
Wir bei Avito organisieren ein internes dreitägiges Training für Entwickler von , einem Experten für Mikroservicearchitektur. Wir möchten einer der Leser dieses Beitrags die Möglichkeit geben, daran teilzunehmen. Die Trainingsagenda ist veröffentlicht.
Das Training findet vom 5. bis 7. August in Moskau statt. Es sind Werktage, die vollständig belegt sein werden. Mittagessen und Training finden in unserem Büro statt, die Reise und Unterkunft müssen von dem ausgewählten Teilnehmer selbst getragen werden.
Die Anmeldung zur Teilnahme ist möglich . Von Ihnen: eine Antwort auf die Frage, warum gerade Sie am Training teilnehmen müssen, und Informationen zur Kontaktaufnahme. Antworten Sie auf Englisch, da Chris den Teilnehmer, der am Training teilnehmen wird, selbst auswählt.
Wir werden den Namen des Trainingsteilnehmers in einem Update zu diesem Beitrag und in den sozialen Netzwerken von Avito für Entwickler (AvitoTech in , , ) spätestens am 19. Juli bekannt geben.
Quelle: habr.com
