

Hallo!
Mein Name ist Michael, ich bin stellvertretender IT-Direktor bei der Firma „Sportmaster“. Ich möchte eine Geschichte darüber teilen, wie wir mit den Schwierigkeiten während der Pandemie umgegangen sind.
In den ersten Tagen der neuen Realität kam der gewohnte Offline-Handelsformat von „Sportmaster“ zum Stillstand, und die Belastung unseres Online-Kanals, insbesondere im Bereich der Lieferungen an die Kundenadresse, stieg enorm um das Zehnfache. Innerhalb weniger Wochen haben wir unser riesiges Offline-Geschäft in ein Online-Geschäft umgewandelt und den Service an die Bedürfnisse unserer Kunden angepasst.
Im Grunde genommen wurde das, was zuvor unser zweitrangiges Geschäft war, zur Hauptgeschäftstätigkeit. Die Bedeutung jeder Online-Bestellung stieg extrem. Wir mussten jeden Rubel, den der Kunde in die Firma brachte, erhalten.
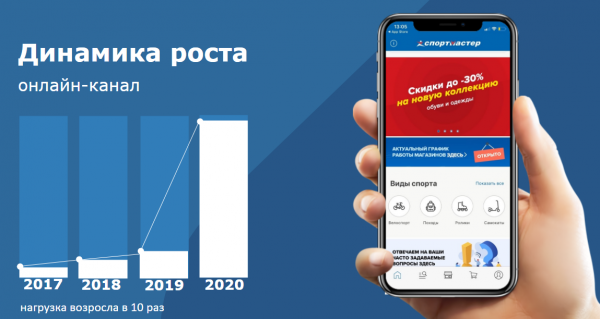
Um schnell auf die Anfragen der Kunden zu reagieren, haben wir ein zusätzliches Kontaktzentrum in der Zentrale des Unternehmens eröffnet und können jetzt etwa 285.000 Anrufe pro Woche entgegennehmen. Gleichzeitig haben wir 270 Geschäfte auf ein neues Format für kontaktlesse und sichere Arbeit umgestellt, was es den Kunden ermöglichte, ihre Bestellungen zu erhalten und die Mitarbeiter ihre Arbeitsplätze zu behalten.
Während des Transformationsprozesses traten bei uns zwei Hauptprobleme auf. Erstens wurde die Belastung unserer Online-Ressourcen spürbar erhöht (wie wir damit umgegangen sind, wird Sergey erzählen). Zweitens hat der Strom seltener (vor COVID) Operationen um ein Vielfaches zugenommen, was wiederum einen großen Bedarf an schneller Automatisierung erforderte. Um dieses Problem zu lösen, mussten wir schnell Ressourcen von vorherigen Hauptbereichen umschichten. Wie wir damit umgegangen sind, wird Elena erzählen.
Betrieb von Online-Diensten
Sergei Kolesnikov, verantwortlich für den Betrieb des Online-Shops und der Mikrodienste
Seitdem unsere Einzelhandelsgeschäfte für Besucher geschlossen wurden, haben wir ein Wachstum von Metriken wie der Anzahl der Benutzer, der Anzahl der Bestellungen, die in unserer App aufgegeben werden, und der Anzahl der Anfragen an die Anwendungen verzeichnet.
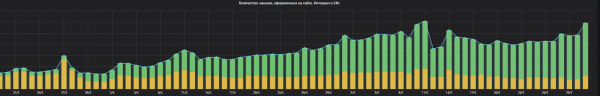 Anzahl der Bestellungen vom 18. bis 31. März
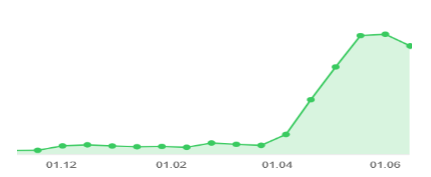 Anzahl der Anfragen an Mikrodienste für die Online-Zahlung
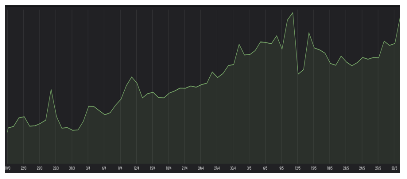 Anzahl der über die Website aufgegebenen Bestellungen
Im ersten Diagramm sehen wir, dass das Wachstum etwa das 14-Fache betrug, im zweiten etwa das 4-Fache. Die aussagekräftigste Metrik in diesem Zusammenhang betrachten wir als die Reaktionszeit unserer Anwendungen.
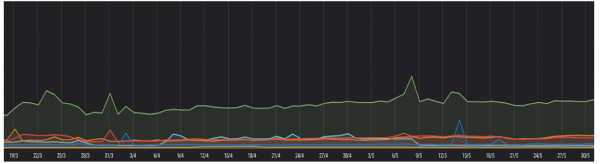
In diesem Diagramm sehen wir die Reaktion von Frontends und Anwendungen, und wir haben festgestellt, dass wir kein nennenswertes Wachstum bemerkt haben.
Dies hängt in erster Linie damit zusammen, dass wir Ende 2019 mit den Vorbereitungsarbeiten begonnen haben. Jetzt sind unsere Dienste reserviert, und wir haben die Fehlertoleranz auf der Ebene der physischen Server, der Virtualisierungssysteme, Docker und der darin enthaltenen Dienste gewährleistet. Gleichzeitig ermöglichen unsere Serverressourcen, mehrfaches Volumen zu bewältigen.
Das Hauptinstrument, das uns in dieser ganzen Geschichte geholfen hat, war unser Überwachungssystem. Vor nicht allzu langer Zeit hatten wir jedoch kein einheitliches System, das es ermöglichte, Metriken auf allen Ebenen zu sammeln, von der physischen Hardware bis zu den Geschäftsmessdaten.
Formell gab es die Überwachung im Unternehmen, jedoch war sie in der Regel verstreut und lag in der Verantwortung spezifischer Abteilungen. Tatsächlich hatten wir bei einem Vorfall fast nie ein einheitliches Verständnis davon, was genau passiert war, es gab keine Information, und oft führte dies dazu, dass wir im Kreis liefen, um das Problem zu finden und zu lokalisieren, um es anschließend zu beheben.
Irgendwann dachten wir nach und entschieden, dass es genug ist — wir brauchen ein einheitliches System, um das gesamte Bild vollständig zu sehen. Die Haupttechnologien in unserem Stack sind Zabbix als Alert- und Metrik-Speicherzentrale, Prometheus zur Sammlung und Speicherung von Anwendungsmetriken, Stack ELK für Logging und Speicherung von Daten des gesamten Überwachungssystems sowie Grafana für die Visualisierung, Swagger, Docker und andere nützliche und Ihnen vertraute Dinge.
Dabei nutzen wir nicht nur die verfügbaren Technologien auf dem Markt, sondern entwickeln auch einige Dinge selbst. Zum Beispiel erstellen wir Dienste zur Integration von Systemen miteinander, sprich eine Art API zur Sammlung von Metriken. Zudem arbeiten wir an eigenen Überwachungsystemen — auf der Ebene der Geschäftsmessdaten verwenden wir UI-Tests. Außerdem haben wir einen Bot in Telegram für die Benachrichtigung der Teams.
Außerdem bemühen wir uns, das Überwachungssystem für die Teams zugänglich zu machen, damit sie ihre Metriken selbst speichern und damit arbeiten können, einschließlich der Einrichtung von Alerts für bestimmte, in einem engeren Rahmen relevante Metriken.
Im Rahmen des gesamten Systems streben wir nach Proaktivität und einer möglichst schnellen Lokalisierung von Vorfällen. Zudem hat die Anzahl unserer Mikrodienste und Systeme in letzter Zeit erheblich zugenommen, wodurch auch die Zahl der Integrationen steigt. Im Rahmen der Optimierung des Diagnoseprozesses von Vorfällen auf Integrationsebene entwickeln wir ein System, das es ermöglicht, systemübergreifende Prüfungen durchzuführen und Ergebnisse zu liefern, um die wesentlichen Probleme im Zusammenhang mit Importen und der Interaktion zwischen den Systemen zu identifizieren.
Natürlich gibt es noch viel Raum für Wachstum und Entwicklung in Bezug auf den Betrieb der Systeme, und wir arbeiten aktiv daran. Mehr Informationen über unser Überwachungssystem können Sie hier lesen. .
Technische Tests
Sergej Orlow, leitet das Kompetenzzentrum für Web- und mobile Entwicklung
Seit der Schließung der physischen Geschäfte stehen wir vor verschiedenen Herausforderungen in der Entwicklung. Zuallererst der Anstieg der Last an sich. Es ist klar, dass, wenn keine entsprechenden Maßnahmen ergriffen werden, die Systeme bei hoher Last mit einem traurigen Knall in einen Kürbis verwandelt werden können, oder die Leistung ganz eint vallen, oder sie ihre Funktionsfähigkeit vollständig verlieren.
Der zweite Aspekt, der etwas weniger offensichtlich ist, besteht darin, dass das System unter hoher Last sehr schnell geändert werden musste, um sich an die Veränderungen der Geschäftsprozesse anzupassen. Manchmal mehrmals am Tag. In vielen Unternehmen gibt es die Regel, dass bei großen Marketingaktivitäten keine Änderungen am System vorgenommen werden sollten. Überhaupt keine, lass es einfach laufen, wenn es funktioniert.
Bei uns gab es im Grunde genommen einen endlosen Black Friday, währenddessen das System dennoch geändert werden musste. Und jede Fehler, jedes Problem, jede Störung im System würde das Geschäft sehr teuer zu stehen kommen.
Um vorzugreifen, kann ich sagen, dass wir erfolgreich mit diesen Herausforderungen umgehen konnten, alle Systeme haben die Last standgehalten, ließen sich leicht skalieren, und es gab keine globalen technischen Störungen.
Es gibt vier Schlüsselbereiche, auf denen die Fähigkeit des Systems beruht, hohe plötzliche Lasten zu bewältigen. Der erste ist das Monitoring, über das Sie oben gelesen haben. Ohne ein gut strukturiertes Monitoring-System ist es nahezu unmöglich, Engpässe im System zu finden. Ein gutes Monitoring-System ist wie bequeme Alltagskleidung, es sollte bequem und auf Sie abgestimmt sein.
Der zweite Aspekt ist das Testen. Wir nehmen diesen Punkt sehr ernst: Wir schreiben klassische Unit-Tests, Integrationstests, Lasttests und viele andere für jedes System. Außerdem entwickeln wir eine Teststrategie und bemühen uns, das Testniveau so zu steigern, dass manuelle Überprüfungen nicht mehr notwendig sind.
Der dritte Schlüsselbereich ist die CI/CD-Pipeline. Die Prozesse für den Aufbau, das Testen und die Bereitstellung von Anwendungen müssen so weit wie möglich automatisiert sein; es sollte keine manuellen Eingriffe geben. Das Thema CI/CD-Pipeline ist ziemlich tief, und ich werde es nur am Rande streifen. Es ist erwähnenswert, dass wir eine CI/CD-Pipeline-Checkliste haben, nach der jede Produktteam mithilfe von Kompetenzcentern vorgeht.
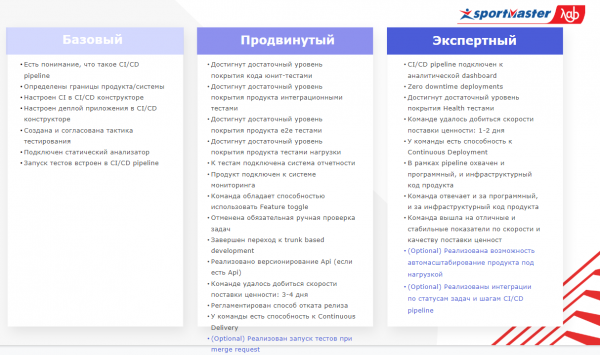 Hier ist die Checkliste
Auf diese Weise werden viele Ziele erreicht. Dazu gehört die Versionierung der API, das Feature Toggle, um Releases zu vermeiden, die im Nachhinein als überflüssig erscheinen, und das Erreichen eines Testabdeckungsniveaus, bei dem das Testen vollständig automatisiert ist und die Deployments nahtlos ablaufen.
Der vierte Schlüsselbereich sind die architektonischen Prinzipien und technischen Lösungen. Man kann viel und lange über die Architektur sprechen, aber ich möchte einige Prinzipien hervorheben, auf die ich besonderen Wert legen möchte.
Zunächst müssen spezialisierte Werkzeuge für bestimmte Aufgaben ausgewählt werden. Ja, das klingt offensichtlich, und es ist klar, dass Nägel mit einem Hammer eingeschlagen werden sollten, während spezielle Schraubenzieher zum Zerlegen von Armbanduhren verwendet werden. Aber in unserer Zeit streben viele Werkzeuge nach Universalität, um den maximalen Nutzerkreis zu erfassen: Datenbanken, Caches, Frameworks und anderes. Nehmen wir zum Beispiel die Datenbank MongoDB; sie arbeitet mit Multi-Dokument-Transaktionen, während die Datenbank Oracle mit JSON arbeitet. Und es könnte scheinen, dass alles für alles verwendet werden kann. Aber wenn wir für Leistung plädieren, müssen wir die Stärken und Schwächen jedes Werkzeugs genau verstehen und nur die für unsere Aufgabenklasse geeigneten verwenden.
Zweitens muss jede Erhöhung der Komplexität beim Entwerfen von Systemen gerechtfertigt sein. Wir müssen dies ständig im Hinterkopf behalten, das Prinzip des low coupling ist allgemein bekannt. Ich glaube, dass es sowohl auf der Ebene eines einzelnen Services, als auch auf der Ebene des gesamten Systems und der architektonischen Landschaft angewendet werden muss. Auch die Fähigkeit zur horizontalen Skalierung jeder Systemkomponente unter Last ist wichtig. Wenn man diese Fähigkeit besitzt, stellt die Skalierung keine Schwierigkeit dar.
Wenn es um technische Lösungen geht, haben wir die Produktteams gebeten, ein frisches Set an Empfehlungen, Ideen und Lösungen zu erstellen, die sie im Vorfeld der nächsten Lastwelle umgesetzt haben.
Caches
Es ist wichtig, den Auswahlprozess für lokale und verteilte Caches bewusst zu gestalten. Manchmal macht es Sinn, sowohl lokale als auch verteilte Caches innerhalb eines Systems zu nutzen. Zum Beispiel haben wir Systeme, bei denen ein Teil der Daten im Grunde genommen ein Schaufelcache ist, das heißt, die Quelle der Aktualisierungen befindet sich außerhalb des Systems, und das System verändert diese Daten nicht. Für einen solchen Ansatz verwenden wir den lokalen Caffeine Cache.
Es gibt jedoch Daten, die das System aktiv während des Betriebs ändert, und hier wenden wir bereits einen verteilten Cache mit Hazelcast an. Dieser Ansatz ermöglicht es uns, die Vorteile des verteilten Caches dort zu nutzen, wo sie wirklich benötigt werden, und die Betriebskosten für den Austausch von Daten im Hazelcast-Cluster zu minimieren, dort, wo wir darauf verzichten können. Über Caches haben wir viel geschrieben. und .
Darüber hinaus hat der Wechsel des Serialisierers zu Kryo in Hazelcast einen erheblichen Vorteil für uns gebracht. Der Übergang von ReplicatedMap zu IMap + Near Cache in Hazelcast hat es uns ermöglicht, die Datenbewegung im Cluster zu minimieren.
Ein kleiner Tipp: Bei der massenhaften Invalidation des Caches kann manchmal die Taktik des Aufwärmens des zweiten Caches mit anschließendem Wechsel sinnvoll sein. Auf den ersten Blick sollte dieser Ansatz zu einem doppelten Speicherverbrauch führen, aber in der Praxis hat sich der Speicherverbrauch in den Systemen, in denen dies praktiziert wurde, verringert.
Reaktiver Stack
Wir nutzen den reaktiven Stack bereits in einer beträchtlichen Anzahl von Systemen. In unserem Fall handelt es sich um Webflux oder Kotlin mit Coroutinen. Besonders gut eignet sich der reaktive Stack dort, wo wir langsame Eingabe-Ausgabebetriebe erwarten. Zum Beispiel Aufrufe langsamer Dienste, die Arbeit mit dem Dateisystem oder Speichersystemen.
Das wichtigste Prinzip ist, blockierende Aufrufe zu vermeiden. Unter der Haube der reaktiven Frameworks laufen nur wenige aktive Dienst-Threads. Wenn wir uns unvorsichtig einen direkten blockierenden Aufruf erlauben, wie beispielsweise einen Aufruf des JDBC-Treibers, wird das System einfach zum Stillstand kommen.
Streben Sie an, Fehler in eigene Runtime-Exceptions umzuwandeln. Der tatsächliche Ausführungsfluss des Programms weicht den reaktiven Frameworks ab, und die Ausführung von Code wird nicht-linear. Infolgedessen ist es sehr schwierig, Probleme anhand von Stack-Traces zu diagnostizieren. Eine Lösung wäre, klare objektive Runtime-Exceptions für jeden Fehler zu schaffen.
Elasticsearch
Bei der Verwendung von Elasticsearch sollten Sie keine ungenutzten Daten auswählen. Dies ist grundsätzlich ein sehr einfacher Rat, wird jedoch häufig vergessen. Wenn Sie mehr als zehntausend Datensätze auf einmal abrufen müssen, sollten Sie Scroll verwenden. Im Vergleich dazu ähnelt dies einem Cursor in einer relationalen Datenbank.
Verwenden Sie postfilter nicht ohne Notwendigkeit. Bei großen Datenmengen in der Hauptauswahl belastet diese Operation die Datenbank erheblich.
Verwenden Sie Bulk-Operationen, wo dies anwendbar ist.
API
Bei der Gestaltung von APIs sollten Sie die Anforderungen zur Minimierung der übermittelten Daten berücksichtigen. Dies ist besonders relevant in Verbindung mit dem Frontend: An dieser Schnittstelle verlassen wir unsere Rechenzentren und arbeiten bereits auf der Verbindung zum Kunden. Wenn es dort die kleinsten Probleme gibt, führt ein zu hohes Verkehrsdatenaufkommen zu einem negativen Benutzererlebnis.
Und schließlich, werfen Sie nicht einen Haufen Daten auf, gehen Sie klar auf den Vertrag zwischen Verbrauchern und Anbietern ein.
Organisatorische Transformation
Eroshkina Elena, stellvertretende IT-Direktorin
In dem Moment, als die Quarantäne eintrat und die Notwendigkeit bestand, den Online-Ausbau und die Einführung von Omnichannel-Diensten rasch zu steigern, waren wir bereits im Prozess der organisatorischen Transformation.
Ein Teil unserer Struktur wurde auf die Prinzipien und Praktiken des produktbasierten Ansatzes umgestellt. Es bildeten sich Teams, die nun für den Betrieb und die Entwicklung jedes Produkts verantwortlich sind. Die Mitarbeiter in diesen Teams sind zu 100% eingebunden und organisieren ihre Arbeit nach Scrum oder Kanban, je nachdem, was ihnen am besten passt, richten den Bereitstellungsprozess ein, implementieren technische Praktiken, Qualitätsmanagementpraktiken und vieles mehr.
Zum Glück befand sich der größte Teil solcher Produktteams von uns gerade im Bereich Online- und Omnichannel-Dienste. Dies ermöglichte es uns, in kürzester Zeit (ernsthaft, innerhalb von nur zwei Tagen) in den Modus der Fernarbeit zu wechseln, ohne an Effizienz zu verlieren. Der eingerichtete Prozess erlaubte es uns, schnell auf die neuen Arbeitsbedingungen zu reagieren und ein ausreichend hohes Tempo für die Bereitstellung neuer Funktionalitäten aufrechtzuerhalten.
Darüber hinaus mussten wir die Teams verstärken, die an der Front des Online-Geschäfts tätig sind. Zu diesem Zeitpunkt wurde klar, dass wir dies nur mit internen Ressourcen erreichen konnten. Etwa 50 Personen wechselten innerhalb von zwei Wochen ihren Arbeitsbereich und integrierten sich in die Arbeit an einem für sie neuen Produkt.
Dafür waren keine speziellen Managementanstrengungen erforderlich, da wir neben der Organisation unserer eigenen Prozesse, der technischen Verfeinerung des Produkts und der Qualitätssicherungspraktiken auch unsere Teams in Selbstorganisation schulen — um ihren eigenen Produktionsprozess ohne administrative Ressourcen zu steuern.
Wir konnten unsere Managementressourcen genau dort konzentrieren, wo es in diesem Moment erforderlich war — bei der Koordination mit dem Geschäft: Was ist für unseren Kunden jetzt wichtig, welche Funktionalitäten müssen zuerst umgesetzt werden, was muss getan werden, um unsere Kapazität für die Lieferung und Verarbeitung von Bestellungen zu erhöhen. All dies und ein klares Rollenmodell haben es uns ermöglicht, während dieses Zeitraums unsere Produktionsströme zur Wertschöpfung mit dem zu belasten, was wirklich wichtig und notwendig ist.
Es ist klar, dass wir bei Remote-Arbeit und dem rasanten Tempo der Veränderungen, bei dem die Geschäftskennzahlen von der Beteiligung jedes Einzelnen abhängen, uns nicht nur auf interne Empfindungen wie „Läuft bei uns alles gut? Ja, sieht ganz gut aus“ verlassen können. Es sind objektive Leistungsmetriken erforderlich. Diese haben wir, sie sind für jeden zugänglich, der sich für die Kennzahlen der Produktteams interessiert. Zunächst für das Team selbst, das Geschäft, die angrenzenden Abteilungen und das Management.
Alle zwei Wochen findet mit jedem Team eine Statusbesprechung statt, in der für 10 Minuten die Metriken analysiert, Engpässe im Produktionsprozess identifiziert und gemeinsame Lösungen erarbeitet werden: Was kann getan werden, um diese Engpässe zu beseitigen. Hier kann auch sofort um Unterstützung durch das Management gebeten werden, falls ein identifiziertes Problem außerhalb des Einflussbereichs der Teams liegt, oder um die Expertise von Kollegen, die möglicherweise bereits mit einem ähnlichen Problem konfrontiert waren.
Dennoch verstehen wir, dass wir für eine exponentielle Beschleunigung (genau dieses Ziel setzen wir uns) noch viel lernen und in unsere tägliche Arbeit integrieren müssen. Im Moment setzen wir den produktorientierten Ansatz auf andere Teams und neue Produkte um. Dazu mussten wir ein für uns neues Format der Online-Schule für Methodologen erlernen.
Methodologen, Menschen, die Teams helfen, Prozesse aufzubauen, Kommunikation zu verbessern und die Effizienz der Arbeit zu steigern, sind im Wesentlichen Veränderungsagenten. Momentan arbeiten die Absolventen unseres ersten Jahrgangs mit Teams und helfen ihnen, erfolgreich zu werden.
Ich denke, dass die aktuelle Situation uns Möglichkeiten und Perspektiven eröffnet, die wir vielleicht selbst noch nicht vollständig realisiert haben. Aber die Erfahrungen und Praktiken, die wir gerade jetzt sammeln, bestätigen, dass wir den richtigen Entwicklungspfad gewählt haben, wir werden in Zukunft diese neuen Chancen nicht verpassen und können ebenso effektiv auf die Herausforderungen reagieren, die vor "Sportmaster" stehen werden.
Das DBMS Tarantool ist ein attraktives, zukunftsträchtiges Produkt zur Erstellung von hochbelasteten Anwendungen.
In dieser schwierigen Zeit haben wir die wichtigsten Grundsätze formuliert, auf denen die Softwareentwicklung basiert, die, glaube ich, für jedes Unternehmen, das damit beschäftigt ist, relevant sein werden.
Menschen. Das ist das Fundament. Die Mitarbeiter sollten Freude an ihrer Arbeit haben, die Ziele des Unternehmens und die Ziele der Produkte, an denen sie arbeiten, verstehen. Und natürlich sollten sie sich beruflich weiterentwickeln können.
Technologie. Es ist notwendig, dass das Unternehmen reif an die Arbeit mit seinem Technologie-Stack herangeht und dort Kompetenzen aufbaut, wo es wirklich nötig ist. Das klingt sehr einfach und offensichtlich, wird aber oft ignoriert.
Prozesse. Es ist wichtig, die Arbeit der Produktteams und Kompetenzzentren richtig zu strukturieren und die Zusammenarbeit mit dem Geschäft aufzubauen, um mit ihm als Partner zu arbeiten.
Im Allgemeinen haben wir etwa so überlebt. Die Hauptthese der Moderne hat sich einmal mehr bestätigt, laut auf die Stirn klopfend.
Selbst wenn du ein riesiges Offline-Geschäft mit vielen Geschäften und zahlreichen Städten bist, entwickle dein Online-Angebot. Es ist nicht nur ein zusätzlicher Vertriebskanal oder eine schöne Anwendung, über die man auch etwas kaufen kann (und auch, weil die Konkurrenz ebenfalls schön aussieht). Es ist kein Notfallreserverad, das hilft, einen Sturm zu überstehen.
Es ist eine zwingende Notwendigkeit. Auf die sollten nicht nur deine technischen Kapazitäten und Infrastruktur, sondern auch die Menschen und Prozesse vorbereitet sein. Denn schnell Speicher, Platz und neue Instanzen hinzuzufügen, kann man innerhalb von ein paar Stunden. Aber die Menschen und Prozesse müssen vorher darauf vorbereitet werden.
Quelle: habr.com
