

Am 9. Januar wurde die Version Pandas 1.0.0rc veröffentlicht. Die vorherige Version der Bibliothek ist 0.25.
Die erste Hauptversion enthält viele großartige Neuerungen, darunter verbesserte automatische Zusammenfassungen von DataFrames, mehr Ausgabeformate, neue Datentypen und sogar eine neue Dokumentationswebsite.
Alle Änderungen können angesehen werden , in diesem Artikel werden wir uns jedoch auf eine kurze, weniger technische Übersicht der wichtigsten Punkte beschränken.
Die Bibliothek kann wie gewohnt installiert werden mit pip, aber da zum Zeitpunkt des Schreibens der Artikel Pandas 1.0 noch Release Candidate, muss die Version ausdrücklich angegeben werden:
pip install --upgrade pandas==1.0.0rc0Seien Sie vorsichtig: Da es sich um ein wichtiges Release handelt, kann das Update alten Code brechen!
Übrigens, mit dieser Version wird die Unterstützung für Python 2 vollständig eingestellt (was einen guten Grund darstellen könnte, — Anmerkung des Übersetzers.). Pandas 1.0 benötigt mindestens Python 3.6+, also wenn Sie sich nicht sicher sind, überprüfen Sie bitte, welche Version Sie installiert haben:
$ pip --version
pip 19.3.1 von /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Die Version von Pandas lässt sich am einfachsten so prüfen:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Verbessertes Auto-Summieren mit DataFrame.info
Mein Lieblingsneuerung ist die Aktualisierung der Methode DataFrame.info. Die Funktion ist viel lesbarer geworden, was den Datenanalyseprozess noch einfacher macht:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 Einträge, 0 bis 2
Datenkolonnen (insgesamt 3 Spalten):
 #   Spalte  Nicht-Null-Zählung  Dtype
---  ------  -----------------  -----
 0   A       3 nicht-null      int64
 1   B       3 nicht-null      objekt
 2   C       3 nicht-null      objekt
dtypes: int64(1), objekt(2)
Speicherverbrauch: 200.0+ Bytes
Tabelle im Markdown-Format ausgeben
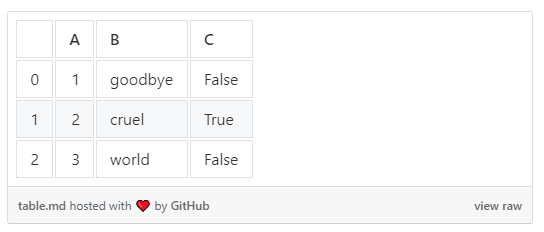
Eine nicht minder erfreuliche Neuerung ist die Möglichkeit, DataFrames mit Hilfe von DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Das erleichtert die Veröffentlichung von Tabellen auf Websites wie Medium mittels GitHub Gists erheblich.
Neue Typen für Strings und boolesche Werte
In das Release von Pandas 1.0 wurden auch neue experimentelle Typen hinzugefügt. Deren API kann sich noch ändern, also verwenden Sie es mit Vorsicht. Aber insgesamt empfiehlt Pandas, die neuen Typen überall dort zu nutzen, wo es sinnvoll ist.
Bislang muss die Umwandlung ausdrücklich erfolgen:
>>> B = pd.Series(["auf Wiedersehen", "grausam", "Welt"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 Einträge, 0 bis 2
Datenkolonnen (insgesamt 3 Spalten):
 #   Spalte  Nicht-Null-Zählung  Dtype
---  ------  ------------------  -----
 0   A       3 nicht-null       int64
 1   B       3 nicht-null       string
 2   C       3 nicht-null       bool
dtypes: int64(1), object(1), string(1)
Speicherverbrauch: 200.0+ Bytes
Beachten Sie, wie die Spalte Dtype neue Typen anzeigt — string und bool.
Die nützlichste Eigenschaft des neuen String-Typs ist die Möglichkeit, nur String-Spalten aus DataFrames auszuwählen. Dies kann die Analyse von Textdaten erheblich vereinfachen:
df.select_dtypes("string")Früher konnten String-Spalten nicht ohne explizite Angabe der Namen ausgewählt werden.
Mehr über die neuen Typen kann man lesen .
Danke, dass Sie bis zum Ende gelesen haben! Eine vollständige Liste der Änderungen, wie bereits erwähnt, finden Sie .
Quelle: habr.com
