

Das Semantic Web und Linked Data sind ähnlich wie der nahe Weltraum: Es gibt dort kein Leben. Um dorthin für einen mehr oder weniger längeren Zeitraum zu gehen ... nun, ich weiß nicht, was man euch in der Kindheit auf die Frage "Ich möchte Astronaut werden" geantwortet hat. Aber man kann das Geschehen auch von der Erde aus beobachten; es ist viel einfacher, Hobbyastronom oder sogar Profi zu werden.
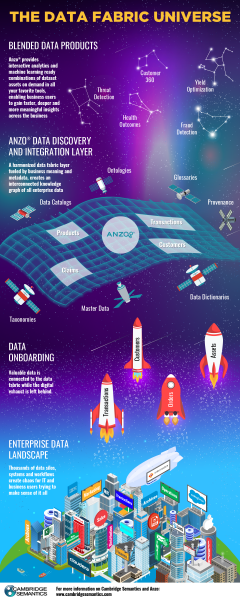
In diesem Artikel geht es um frische Trends aus der Welt der RDF-Speicher, nicht älter als einige Monate. Die Metapher im ersten Absatz wurde von einem episch großen Werbebild unterhalb inspiriert.
Episches Bild
I. GraphQL für den Zugriff auf RDF
, dass GraphQL den Anspruch erhebt, eine universelle Sprache für den Zugriff auf Datenbanken zu sein. Wie sieht es jedoch mit der Möglichkeit aus, über GraphQL auf RDF zuzugreifen?
„Out of the box“ bieten folgende Möglichkeiten:
- Stardog (, );
- Produkte von TopQuadrant (, ).
Wenn das Speicher keine solche Möglichkeit bietet, kann man sie selbst umsetzen, indem man einen entsprechenden „Resolver“ schreibt. So wurde es beispielsweise im französischen Projekt gemacht. Oder man kann mittlerweile einfach .
ausprobieren. Aus Sicht eines orthodoxen Anhängers des Semantic Web und Linked Data ist all dies natürlich enttäuschend, da es anscheinend für Integrationen gedacht ist, die um die nächsten Daten-Silos aufgebaut werden, und nicht für Plattformen (selbstverständlich RDF-Speicher) geeignet sind.
Die Eindrücke aus dem Vergleich von GraphQL mit SPARQL bleiben gemischt.
- Einerseits wirkt GraphQL wie ein entfernter Verwandter von SPARQL: Es werden typische REST-Probleme wie Überabfragen und Fragmentierung gelöst – ohne die man wahrscheinlich nicht einmal als Abfragesprachegezählt werden könnte, selbst wenn es nur für das Web ist;
- andererseits enttäuscht die strenge Schema-Anforderungen von GraphQL. Entsprechend erscheint seine „Introspektivität“ im Vergleich zur vollständigen Reflexivität von RDF als sehr eingeschränkt. Und es gibt keinen passenden Analogie zu property paths, weshalb nicht einmal klar ist, warum es „Graph-” heißt.
II. Adapter für MongoDB
Ein Trend, der komplementär zu dem vorherigen ist.
- In Stardog kann man jetzt – insbesondere alles auf demselben GraphQL – die Darstellung von MongoDB-Daten in virtuellen RDF-Grafen konfigurieren;
- GraphDB ermöglicht es seit kurzem, SPARQL-Elemente in MongoDB-Abfragen einzufügen.
Im weiteren Sinne kann man über Adapter für JSON-Quellen sprechen, die mehr oder weniger „on-the-fly“ das in diesen Quellen gespeicherte JSON als RDF darstellen, und man kann sich an das schon lange existierende erinnern, das man anpassen kann, , zu Apache Jena.
Zusammenfassend lässt sich sagen, dass RDF-Speicher eine vollständige Bereitschaft für Integrationen und den Betrieb unter Bedingungen der „polyglotten Persistenz“ zeigen. Es ist jedoch bekannt, dass dieser Trend schon lange nicht mehr angesagt ist, und ihm folgt Multimodelle. Wie steht es um Multimodelle in der Welt der RDF-Speicher?
Kurz gesagt: gar nicht. Dem Thema multimodale Datenbanken sollte ein eigener Artikel gewidmet werden, aber derzeit kann festgestellt werden, dass es keine multimodalen Datenbanken gibt, die auf einem Graphmodell basieren (eine Variante davon könnte RDF sein). Über eine geringe Multimodalität – die Unterstützung alternativer Graphmodelle durch RDF-Speicher – wird im .
III. OLTP vs. OLAP
Gartner selbst , dass Multimodalität eine conditio sine qua non in erster Linie für operationale Datenbanken ist. Das ist auch verständlich: In einer Situation der „polyglotten Persistenz“ treten die Hauptprobleme mit der Transaktionalität auf.
Doch wo stehen RDF-Speicher auf der OLTP-OLAP-Skala? Ich würde so antworten: weder hier noch dort. Um zu kennzeichnen, wofür sie gedacht sind, braucht es eine dritte Abkürzung. Als Vorschlag würde ich OLIP — Online Intellectual Processing.
Doch dennoch:
- Die in GraphDB umgesetzten Integrationsmechanismen mit MongoDB sind nicht zuletzt vorgesehen, um Probleme mit der Schreibgeschwindigkeit zu umgehen;
- Stardog geht sogar noch weiter und komplett die Engine neu, wiederum mit dem Ziel, die Schreibgeschwindigkeit zu erhöhen.
Lassen Sie mich nun einen neuen Akteur auf dem Markt vorstellen. Von den Machern von IBM Netezza und Amazon Redshift — . Das Bild aus der Werbung für das Produkt wurde zu Beginn des Artikels veröffentlicht. AnzoGraph positioniert sich als GOLAP-Lösung. Wie gefällt Ihnen SPARQL mit Fensterfunktionen? —
SELECT ?month (COUNT(?event) OVER (PARTITION BY ?month) AS ?events) WHERE { … }IV. RocksDB
Oben wurde bereits von Stardog 7 Beta verwiesen, in der erwähnt wurde, dass Stardog beabsichtigt, RocksDB als zugrunde liegendes Speichersystem zu nutzen — ein „Key-Value“-Speicher, ein Facebook-Fork von Googles LevelDB. Warum sollte man bereits von einem Trend sprechen?
Erstens, laut , migrieren nicht nur RDF-Speicher zu RocksDB. Es gibt Projekte, die RocksDB als Speichermotor in ArangoDB, MongoDB, MySQL und MariaDB, Cassandra verwenden.
Zweitens werden auf RocksDB Projekte (d. h. keine Produkte) zu diesem Thema entwickelt.
Zum Beispiel nutzt eBay RocksDB in für sein „Wissen graf“. Übrigens ist es interessant zu lesen: die Abfragesprache begann als ein hauseigenes Format, hat sich aber kürzlich mehr und mehr wie SPARQL entwickelt. Wie im Witz: so viele Wissensgraphen wir erstellen, es wird immer RDF.
Ein weiteres Beispiel ist der vor einigen Monaten entstandene . Vor seiner Entstehung musste man für historische Informationen zu Wikidata über auf die Standard-Mediawiki-API zugreifen. Jetzt ist vieles mit reinem SPARQL möglich. „Unter der Haube“ läuft dort auch RocksDB. Übrigens hat WDHQS anscheinend jemand gemacht, der beim Import von Freebase in den Google Knowledge Graph tätig war.
V. Unterstützung von LPG
Ich erinnere an den Hauptunterschied zwischen LPG-Grafen und RDF-Grafen.
In LPG können an Instanzen von Kanten skalarische Eigenschaften angehängt werden, während sie in RDF nur an „Typen“ von Kanten angehängt werden können (dafür können sie jedoch nicht nur skalare Eigenschaften, sondern auch normale Beziehungen haben). Diese Einschränkung von RDF im Vergleich zu LPG durch bestimmte Modellierungstechniken. Die Einschränkung von LPG im Vergleich zu RDF ist schwerer zu überwinden, aber LPG-Grafen ähneln mehr als RDF-Grafen den Bildern aus Hararis Lehrbuch, weshalb die Menschen sie wollen.
Offensichtlich zerfällt die Aufgabe der „Unterstützung von LPG“ in zwei Teile:
- Änderungen am RDF-Modell vornehmen, die es ermöglichen, LPG-Konstruktionen zu imitieren;
- Änderungen an der Abfragesprache für RDF vornehmen, um auf die Daten in diesem geänderten Modell zuzugreifen, — oder die Möglichkeit zur Abfrage dieses Modells in gängigen Abfragesprachen für LPG realisieren.
V.1. Datenmodell
Hier gibt es mehrere mögliche Ansätze.
V.1.1. Singleton-Eigenschaft
Der direkteste Ansatz zur Harmonisierung von RDF und LPG ist wahrscheinlich :
- Statt zum Beispiel des Prädikats
:isMarriedTowerden die Prädikate:isMarriedTo1,:isMarriedTo2usw. - Dann werden diese Prädikate zum Subjekt neuer Tripel:
:isMarriedTo1 :since "2013-09-13"^^xsd:dateu. a. - Die Verbindung dieser Instanzen von Prädikaten mit dem allgemeinen Prädikat wird durch Tripel der Art
:isMarriedTo1 rdf:singletonPropertyOf :isMarriedTo. - Offensichtlich gilt,
rdf:singletonPropertyOf rdfs:subPropertyOf rdf:type, aber denken Sie darüber nach, warum man nicht einfach schreiben sollte:isMarriedTo1 rdf:type :isMarriedTo.
Die Aufgabe der „Unterstützung von LPG“ wird hier auf der Ebene von RDFS gelöst. Diese Lösung erfordert Änderungen im entsprechenden Einige Änderungen könnten von RDF-Speichern erforderlich sein, die das Anhängen von Folgerungen unterstützen. Bis dahin kann die Singleton-Eigenschaft einfach als eine weitere Modellierungstechnik betrachtet werden.
V.1.2. Reifikation richtig gemacht
Weniger naive Ansätze ergeben sich aus dem Bewusstsein, dass Eigenschaftsinstanzen durchaus mit Tripeln instanziiert werden können. Wenn wir etwas über Tripel sagen können, haben wir auch die Möglichkeit, über Instanzen von Eigenschaften zu sprechen.
Der solideste dieser Ansätze ist , auch bekannt als RDR, im Inneren von Blazegraph. Von Anfang an für sich und AnzoGraph gewählt. Die Solidität des Ansatzes wird durch die Tatsache bestimmt, dass er entsprechende Änderungen in beinhaltet. Die Essenz ist jedoch äußerst einfach. In der Turtle-Serialisierung von RDF kann man nun etwa Folgendes schreiben:
<> :since "2013-09-13"^^xsd:date .V.1.3. Andere Ansätze
Man kann sich um formale Semantik keine Sorgen machen und einfach annehmen, dass Tripel einige Identifikatoren haben, die selbstverständlich URIs sind, und neue Tripel mit diesen URIs bilden. Man müsste nur den Zugriff auf diese URIs in SPARQL ermöglichen. So Stardog.
In Allegrograph auf intermediärem Wege. Es ist bekannt, dass Tripel-Identifikatoren in Allegrograph , aber bei der Implementierung von Triple-Attributen nach außen sind sie nicht sichtbar. Doch auch zur formalen Semantik ist es noch ein weiter Weg. Bemerkenswert ist, dass die Tripelattribute keine URIs sind und dass die Werte dieser Attribute ebenfalls nur Literale sein können. Anhänger von LPG erhalten genau das, was sie wollten. In einem eigens entwickelten NQX-Format sieht ein Beispiel, das dem oben genannten für RDF* ähnelt, so aus:
:bob :marriedTo :alice {"since" : "2013-09-13"}V.2. Abfragesprachen
Nachdem LPG auf Modell-Ebene unterstützt wurde, sollte es ermöglicht werden, Anfragen an die Daten in einem solchen Modell zu stellen.
- Blazegraph unterstützt für Abfragen zu RDF* und Eine Abfrage in SPARQL* sieht wie folgt aus:
SELECT * { <> :since ?since }- Anzograph unterstützt auch und plant die Unterstützung von , der Abfragesprache in Neo4j.
- Stardog unterstützt sein eigenes SPARQL und Gremlin. In SPARQL kann die URI des Tripels und die "Meta-Information" etwa mit folgender Konstruktion abgerufen werden:
SELECT * {
    BIND (stardog:identifier(:bob, :isMarriedTo, ?wife) AS ?id)
    ?id :since ?since
}- Allegrograph unterstützt ebenfalls sein eigenes SPARQL:
SELECT * { ("since" ?since) franz:attributesNameValue ( :bob :marriedTo ?wife ) }Übrigens unterstützte GraphDB eine Zeit lang Tinkerpop/Gremlin, unterstützte dabei aber kein LPG. In Version 8.0 oder 8.1 wurde dies eingestellt.
VI. Verschärfung der Lizenzen
In letzter Zeit gab es keine Verstärkung im Schnittpunkt der Mengen "triplestore of choice" und "open source triplestore". Neue RDF-Speicher mit offenem Quellcode sind immer noch weit davon entfernt, eine gute Wahl für den täglichen Gebrauch zu sein, und der Quellcode neuer RDF-Speicher, die man gerne nutzen würde (wie AnzoGraph), ist geschlossen. Man könnte sogar von einem Rückgang sprechen...
Natürlich wird der offene Quellcode nicht einfach geschlossen, aber einige Speicher mit offenem Quellcode werden allmählich nicht mehr als wünschenswerte Wahl betrachtet. Virtuoso, das eine Open-Source-Edition hat, ist meiner Meinung nach voller Bugs. Blazegraph wurde von AWS gekauft und bildet die Grundlage für Amazon Neptune; jetzt ist unklar, ob es noch einen weiteren Release geben wird. Es bleibt nur Jena...
Wenn der offene Quellcode jedoch nicht besonders wichtig ist und man einfach nur ausprobieren möchte, sieht es auch weniger rosig aus als früher. Zum Beispiel:
- Stardog die Verbreitung einer kostenlosen Version (allerdings ist die Testphase der normalen Version auf das Doppelte gewachsen);
- in , wo früher ein kostenloser Basisplan gewählt werden konnte, ist die Registrierung neuer Benutzer eingestellt worden.
Insgesamt wird der Weltraum für den durchschnittlichen IT-Nutzer immer unzugänglicher, und seine Erschließung wird zum Geschäft der Unternehmen.
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish