

Anmerkung des Übersetzers.: Diese lehrreiche Geschichte von Omio – dem europäischen Reiseaggregator – führt die Leser von den grundlegenden Theorien zu spannenden praktischen Feinheiten in der Kubernetes-Konfiguration. Das Kennenlernen solcher Fälle hilft nicht nur, den Horizont zu erweitern, sondern auch, nicht triviale Probleme zu vermeiden.
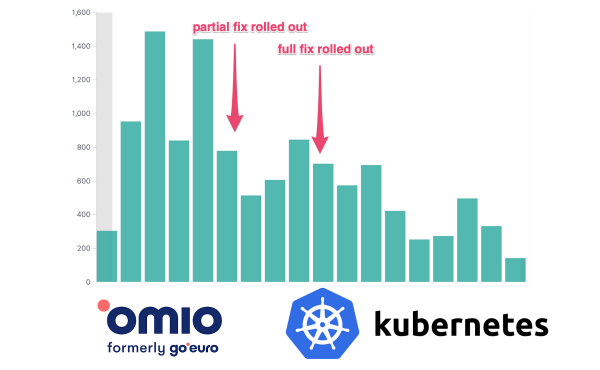
Haben Sie schon einmal erlebt, dass eine Anwendung "eingefroren" war, nicht mehr auf Statusanfragen (health checks) reagierte und Sie nicht die Ursache dieses Verhaltens verstehen konnten? Eine mögliche Erklärung hängt mit dem Limit der CPU-Ressourcenquoten zusammen. Darum geht es in diesem Artikel.
TL;DR:
Wir empfehlen dringend, auf CPU-Limits in Kubernetes zu verzichten (oder CFS-Quoten im Kubelet zu deaktivieren), wenn eine Linux-Kernelversion mit einem CFS-Quota-Bug verwendet wird. Im Kernel gibt es einen schwerwiegenden und Bug, der zu übermäßigem Drosseln und Verzögerungen führt..
Bei Omio wird die gesamte Infrastruktur von Kubernetes verwaltet.Alle unsere stateful und stateless Workloads laufen ausschließlich auf Kubernetes (wir verwenden Google Kubernetes Engine). In den letzten sechs Monaten haben wir zufällige Leistungsprobleme beobachtet. Anwendungen frieren ein oder hören auf, auf health checks zu reagieren, verlieren die Netzwerkverbindung usw. Dieses Verhalten hat uns lange Zeit ratlos gemacht, und schließlich haben wir uns entschieden, das Problem intensiv anzugehen.
Zusammenfassung des Artikels:
- Einige Worte über Container und Kubernetes;
- Wie CPU-Requires und Limits implementiert sind;
- Wie CPU-Limits in Umgebungen mit mehreren Kernen wirken;
- Wie man CPU-Drosselung überwacht;
- Lösungen für das Problem und Tipps.
Einige Worte über Container und Kubernetes
Kubernetes ist im Wesentlichen der moderne Standard in der Welt der Infrastruktur. Seine Hauptaufgabe ist die Orchestrierung von Containern.
Container
Früher mussten wir Artefakte wie Java JARs/WARs, Python Eggs oder ausführbare Dateien erstellen, um diese später auf Servern auszuführen. Um sie jedoch zum Funktionieren zu bringen, mussten wir zusätzliche Arbeit leisten: Laufzeitumgebungen (Java/Python) installieren, die erforderlichen Dateien an den richtigen Stellen platzieren und die Kompatibilität mit einer bestimmten Version des Betriebssystems sicherstellen. Mit anderen Worten, man musste der Konfigurationsverwaltung große Aufmerksamkeit schenken (was häufig zu Konflikten zwischen Entwicklern und Systemadministratoren führte).
Container haben alles verändert. Jetzt fungiert das Artefakt als Container-Image. Es kann als eine Art erweitete ausführbare Datei betrachtet werden, die nicht nur das Programm, sondern auch eine vollständige Laufzeitumgebung (Java/Python/…) sowie die notwendigen Dateien/Pakete enthält, vorinstalliert und bereit zur Ausführung. Container können auf verschiedenen Servern bereitgestellt und gestartet werden, ohne dass zusätzliche Maßnahmen erforderlich sind.
Darüber hinaus arbeiten Container in einer eigenen Sandbox-Umgebung. Sie verfügen über einen eigenen virtuellen Netzwerkadapter, ein Dateisystem mit eingeschränktem Zugriff, eine eigene Prozesshierarchie, eigene CPU- und Speicherkapazitätsbeschränkungen usw. All dies wird durch ein spezielles Subsystem des Linux-Kernels – Namespaces – ermöglicht.
Kubernetes
Wie bereits erwähnt, ist Kubernetes ein Container-Orchestrator. Er funktioniert folgendermaßen: Sie stellen ihm einen Pool von Maschinen zur Verfügung und sagen dann: „Hey, Kubernetes, starte zehn Instanzen meines Containers mit 2 Prozessoren und 3 GB RAM pro Einheit und halte sie am Laufen!“. Kubernetes kümmert sich um den Rest. Er findet verfügbare Kapazitäten, startet die Container und startet sie bei Bedarf neu, rollt Updates bei Versionswechseln aus usw. Im Grunde genommen ermöglicht Kubernetes, sich von der Hardware abzukoppeln und macht die Vielfalt der Systeme für die Bereitstellung und den Betrieb von Anwendungen nutzbar.
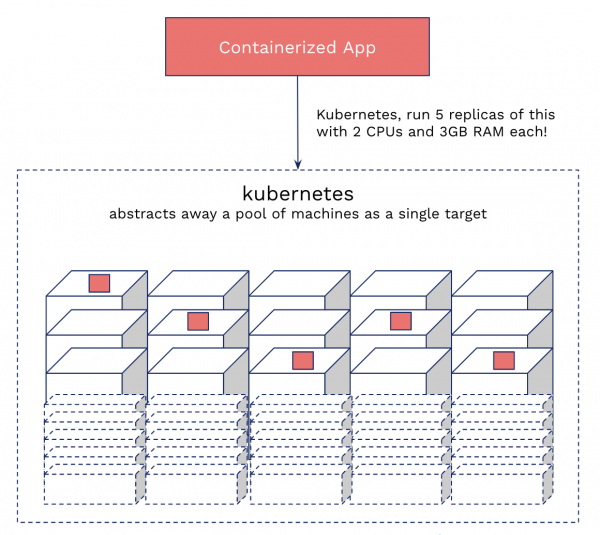
Kubernetes aus der Sicht eines einfachen Bürgers
Was sind Requests und Limits in Kubernetes?
Okay, wir haben die Container und Kubernetes geklärt. Außerdem wissen wir, dass mehrere Container auf einer Maschine laufen können.
Man kann eine Analogie zu einer Wohngemeinschaft ziehen. Ein geräumiger Raum (Maschinen/Knoten) wird genommen und an mehrere Mieter (Container) vermietet. Kubernetes fungiert als Immobilienmakler. Die Frage ist, wie man die Mieter von Konflikten untereinander abhalten kann? Was ist, wenn einer von ihnen beschließt, das Badezimmer für einen halben Tag zu besetzen?
Genau hier kommen Requests und Limits ins Spiel. CPU Request ist ausschließlich für die Planung gedacht. Es ist eine Art „Wunschliste“ des Containers und wird verwendet, um den am besten geeigneten Knoten zu finden. Gleichzeitig kann CPU Begrenzung mit einem Mietvertrag verglichen werden – sobald wir einen Knoten für den Container gefunden haben, kann dieser nicht die festgelegten Grenzen überschreiten. Und hier entsteht das Problem…
Wie Requests und Limits in Kubernetes umgesetzt sind
Kubernetes verwendet einen integrierten Kernmechanismus zur Drosselung (Throttling), um CPU-Limits umzusetzen. Wenn eine Anwendung das Limit überschreitet, wird das Throttling aktiviert (d.h. sie erhält weniger CPU-Zeit). Requests und Limits für den Arbeitsspeicher sind anders organisiert, weshalb sie leichter erkannt werden können. Es reicht aus, den letzten Status des Pod-Neustarts zu überprüfen: Ist er nicht „OOMKilled“? Bei CPU-Throttling ist es nicht so einfach, da K8s nur Metriken zur Nutzung anzeigt, nicht zu cgroups.
CPU-Anfrage
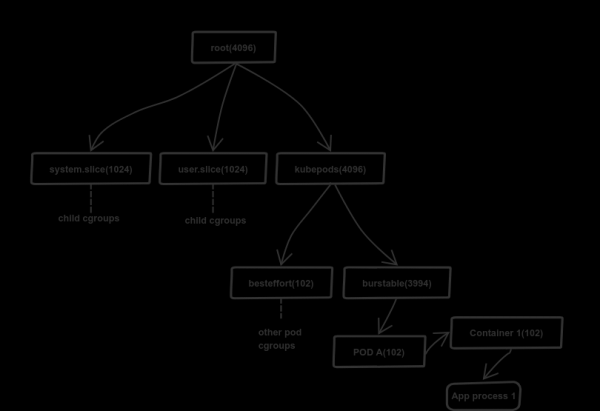
Wie die CPU-Anfrage umgesetzt ist
Zur Vereinfachung betrachten wir den Prozess am Beispiel einer Maschine mit 4-Kern-CPU.
K8s verwendet den Mechanismus der Kontrollgruppen (cgroups) zur Verwaltung der Ressourcenzuteilung (Speicher und CPU). Dafür steht ein hierarchisches Modell zur Verfügung: Ein Nachkomme erbt die Limits der übergeordneten Gruppe. Details zur Ressourcenzuteilung werden im virtuellen Dateisystem gespeichert (/sys/fs/cgroup). Im Falle des Prozessors ist das /sys/fs/cgroup/cpu,cpuacct/*.
K8s verwendet die Datei cpu.share zur Zuteilung von Prozessorrressourcen. In unserem Fall erhält die Wurzel-Kontrollgruppe 4096 Anteile der CPU-Ressourcen – 100% der verfügbaren CPU-Leistung (1 Kern = 1024; das ist ein fester Wert). Die Wurzelgruppe verteilt die Ressourcen proportional entsprechend den Anteilen der Nachkommen, die in cpu.sharevermerkt sind, und diese verfahren ihrerseits ähnlich mit ihren Nachkommen usw. In einem typischen Kubernetes-Knoten hat die Wurzel-Kontrollgruppe drei Nachkommen: system.slice, user.slice und kubepods. Die ersten beiden Untergruppen werden zur Ressourcenzuteilung zwischen kritischen Systemlasten und Benutzerprogrammen außerhalb von K8s verwendet. Die letzte – kubepods – wird von Kubernetes zur Ressourcenzuteilung zwischen Pods erstellt.
In der obigen Abbildung ist zu sehen, dass die erste und zweite Untergruppe jeweils 1024 Anteile erhalten haben, während der Untergruppe kubepod 4096 Anteile zugewiesen wurden. Wie ist das möglich: Die Wurzelgruppe hat nur 4096 Anteile zur Verfügung, während die Summe der Anteile ihrer Nachkommen diese Zahl erheblich übersteigt (6144)? Die Sache ist, dass der Wert eine logische Bedeutung hat, weshalb der Linux-Scheduler (CFS) ihn für die proportionale Zuteilung von CPU-Ressourcen verwendet. In unserem Fall erhalten die ersten beiden Gruppen jeweils 680 reale Anteile (16,6% von 4096), während kubepod die verbleibenden 2736 Anteile erhält. Im Falle von Leerlauf werden die ersten beiden Gruppen die zugewiesenen Ressourcen nicht verwenden.
Glücklicherweise gibt es im Scheduler einen Mechanismus, der den Verlust ungenutzter CPU-Ressourcen vermeidet. Er überträgt «untätige» Kapazitäten in einen globalen Pool, aus dem sie an Gruppen verteilt werden, die zusätzliche Prozessorleistung benötigen (die Übertragung erfolgt in Chargen, um Verluste durch Rundung zu vermeiden). Ein ähnliches Verfahren wird auch auf alle Nachfahren der Nachfahren angewandt.
Dieser Mechanismus sorgt für eine faire Verteilung der Prozessorleistung und überwacht, dass kein Prozess Ressourcen von anderen «stehlt».
CPU-Limit
Obwohl die Konfigurationen von Limits und Requests in K8s ähnlich aussehen, ist ihre Implementierung grundlegend unterschiedlich: Es ist die irreführendste und am wenigsten dokumentierte Komponente.
K8s nutzt zur Umsetzung von Limits. Ihre Einstellungen werden in den Dateien cfs_period_us und cfs_quota_us im cgroup-Verzeichnis festgelegt (dort befindet sich auch die Datei cpu.share).
Im Gegensatz zu cpu.share, basiert die Quote auf der Zeitperiode, nicht auf der verfügbaren Prozessorleistung. cfs_period_us legt die Dauer der Periode (Epoche) fest – dies sind immer 100.000 µs (100 ms). In K8s gibt es die Möglichkeit, diesen Wert zu ändern, allerdings ist dies bislang nur in der Alpha-Version verfügbar. Der Scheduler verwendet die Epoche, um verbrauchte Quoten zurückzusetzen. Die zweite Datei, cfs_quota_us, legt die verfügbare Zeit (Quote) in jeder Epoche fest. Beachten Sie, dass sie ebenfalls in Mikrosekunden angegeben wird. Die Quote kann die Dauer der Epoche überschreiten; mit anderen Worten, sie kann mehr als 100 ms betragen.
Lassen Sie uns zwei Szenarien auf 16-Kern-Maschinen (die häufigste Art von Computern bei uns in Omio) betrachten:
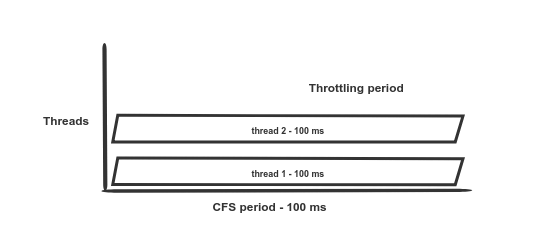
Szenario 1: 2 Threads und ein Limit von 200 ms. Ohne Drosselung
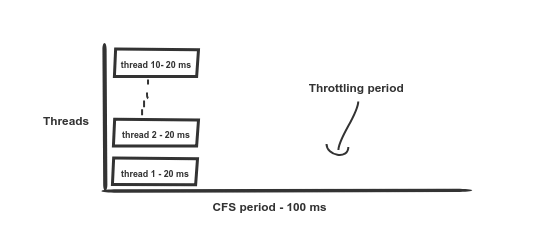
Szenario 2: 10 Threads und ein Limit von 200 ms. Die Drosselung beginnt nach 20 ms, der Zugriff auf die CPU-Ressourcen wird nach weiteren 80 ms wiederhergestellt.
Angenommen, Sie haben das CPU-Limit auf 2 Kerne festgelegt; Kubernetes wandelt diesen Wert in 200 ms um. Das bedeutet, dass der Container maximal 200 ms CPU-Zeit ohne Drosselung verwenden kann.
Und hier wird es interessant. Wie oben erwähnt, beträgt die verfügbare Quote 200 ms. Wenn Sie gleichzeitig zehn Threads auf einer 12-Kern-Maschine (siehe Abbildung zu Szenario 2) ausführen, während alle anderen Pods untätig sind, wird die Quote bereits nach 20 ms erschöpft sein (da 10 * 20 ms = 200 ms), und alle Threads dieses Pods werden «drosseln» (throttle) auf die nächsten 80 ms. Die Situation wird durch den bereits erwähnten , aufgrund dessen übermäßiges Throttling auftritt und der Container nicht einmal das vorhandene Kontingent nutzen kann.
Wie bewertet man das Throttling in Pods?
Treten Sie einfach in den Pod ein und führen Sie cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— die Gesamtzahl der Planungsperioden; -
nr_throttled— die Anzahl der gedrosselten Perioden;nr_periods; -
throttled_time— die kumulierte Throttled-Zeit in Nanosekunden.
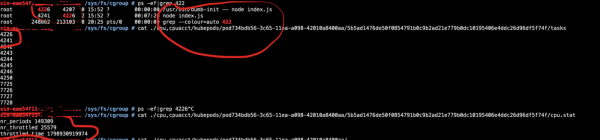
Was passiert eigentlich?
Am Ende haben wir ein hohes Throttling in allen Anwendungen. Manchmal ist es um das 1,5-fache stärker als berechnet!
Dies führt zu verschiedenen Fehlern – Problemen mit der Bereitschaftsprüfung, hängenbleibenden Containern, Verbindungsabbrüchen und Zeitüberschreitungen innerhalb der Dienstaufrufe. Letztendlich äußert sich dies in einer erhöhten Verzögerung und einer steigenden Anzahl von Fehlern.
Die Lösung und die Konsequenzen
Hier ist alles ganz einfach. Wir haben auf CPU-Limits verzichtet und die Betriebssystem-Kernel in den Clustern auf die neueste Version aktualisiert, in der der Bug behoben wurde. Die Anzahl der Fehler (HTTP 5xx) in unseren Diensten ist sofort deutlich gesunken:
HTTP 5xx Fehler
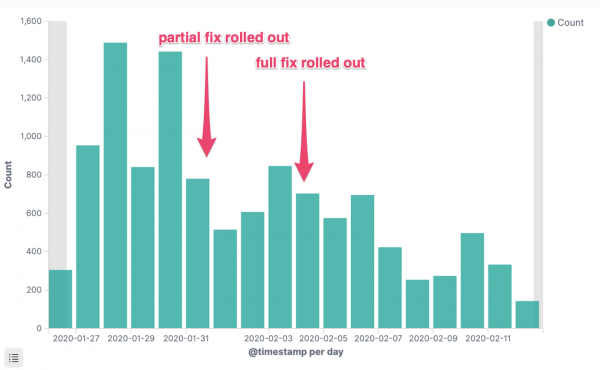
HTTP 5xx Fehler eines kritischen Dienstes
Antwortzeit p95
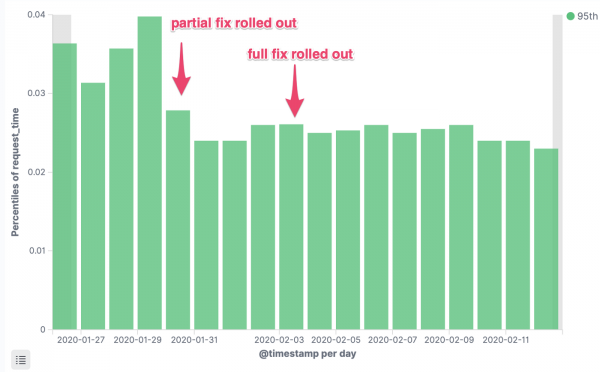
Verzögerung bei Anfragen eines kritischen Dienstes, 95. Perzentil
Betriebskosten
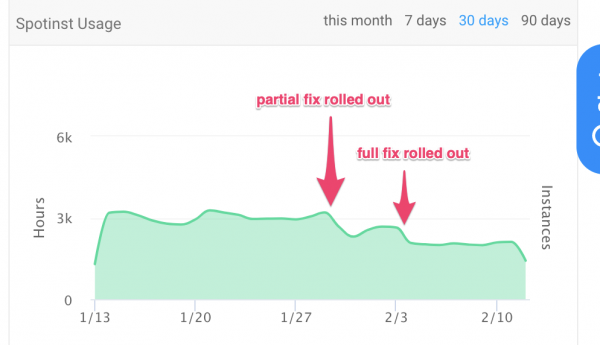
Anzahl der verbrauchten Instanzstunden
Wo liegt der Haken?
Wie zu Beginn des Artikels erwähnt:
Man kann eine Analogie zu einer Wohngemeinschaft ziehen… Kubernetes fungiert als Immobilienverwalter. Aber wie kann man die Mieter daran hindern, Konflikte miteinander zu haben? Was, wenn einer von ihnen beschließt, das Badezimmer für einen halben Tag zu besetzen?
Hier liegt das Problem. Ein nachlässiger Container kann alle verfügbaren CPU-Ressourcen des Systems aufbrauchen. Wenn Sie einen soliden Anwendungsstapel haben (zum Beispiel richtig konfigurierte JVM, Go, Node VM), ist das kein Problem: Unter solchen Bedingungen kann man lange Zeit arbeiten. Wenn die Anwendungen jedoch schlecht oder gar nicht optimiert sind (FROM java:latest), kann die Situation außer Kontrolle geraten. Bei uns in Omio haben wir automatisierte Basis-Dockerfiles mit angemessenen Standardeinstellungen für die wichtigsten Programmiersprachen, sodass dieses Problem nicht aufgetreten ist.
Wir empfehlen, die Metriken zu überwachen. (Nutzung, Saturierung und Fehler), API-Verzögerungen und Häufigkeit des Auftretens von Fehlern. Achten Sie darauf, dass die Ergebnisse Ihren Erwartungen entsprechen.
Links
Das ist unsere Geschichte. Die folgenden Materialien haben sehr geholfen, zu verstehen, was passiert:
- ;
- ;
- ;
- ;
- — suchen Sie nach „cpu throttling“.
Fehlerberichte zu Kubernetes:
- ;
- ;
- .
Hatten Sie ähnliche Probleme in Ihrer Praxis oder verfügen Sie über Erfahrungen im Zusammenhang mit Throttling in containerisierten Produktionsumgebungen? Teilen Sie Ihre Geschichte in den Kommentaren!
P.S. vom Übersetzer
Lesen Sie auch in unserem Blog:
- «»;
- «»;
- «».
Quelle: habr.com
