

Die Berufe Data Scientist und Data Engineer werden oft verwechselt. Jede Firma hat ihre eigene spezifische Art der Datenverarbeitung, unterschiedliche Analyseziele und unterschiedliche Auffassungen darüber, welche Aufgaben die Spezialisten übernehmen sollten, weshalb auch die Anforderungen variieren.
Wir klären, was der Unterschied zwischen diesen Spezialisten ist, welche geschäftlichen Aufgaben sie lösen, über welche Fähigkeiten sie verfügen und wie viel sie verdienen. Das Material ist umfangreich, weshalb wir es in zwei Publikationen aufgeteilt haben.
Im ersten Artikel erzählt Elena Gerasimova, Leiterin des Fachbereichs „“ bei Netology, welchen Unterschied es zwischen Data Scientist und Data Engineer gibt und mit welchen Werkzeugen sie arbeiten.
Wie sich die Rollen von Ingenieuren und Wissenschaftlern unterscheiden
Ein Data Engineer ist ein Fachmann, der auf der einen Seite die Infrastruktur für die Datenverarbeitung entwickelt, testet und pflegt: Datenbanken, Speicher und Systeme zur Massenverarbeitung. Auf der anderen Seite ist er dafür verantwortlich, die Daten für die Verwendung durch Analysten und Data Scientists zu bereinigen und aufzubereiten, sprich, er erstellt Datenverarbeitungs-Pipelines.
Ein Data Scientist erstellt und trainiert prädiktive (und nicht nur prädiktive) Modelle mithilfe von Algorithmen des maschinellen Lernens und neuronalen Netzen, um dem Unternehmen zu helfen, versteckte Muster zu finden, Ereignisentwicklungen vorherzusagen und wichtige Geschäftsprozesse zu optimieren.
Der Hauptunterschied zwischen Data Scientist und Data Engineer liegt darin, dass sie in der Regel unterschiedliche Ziele verfolgen. Beide arbeiten daran, dass die Daten zugänglich und von hoher Qualität sind. Der Data Scientist sucht Antworten auf seine Fragen und prüft Hypothesen im Datenökosystem (zum Beispiel auf Basis von Hadoop), während der Data Engineer eine Pipeline zur Wartung des vom Data Scientist erstellten maschinellen Lernalgorithmus im Spark-Cluster innerhalb desselben Ökosystems erstellt.
Der Data Engineer bringt dem Unternehmen Wert, indem er im Team arbeitet. Seine Aufgabe besteht darin, ein wichtiges Bindeglied zwischen verschiedenen Akteuren zu sein: von Entwicklern bis zu geschäftlichen Nutzern von Berichten, und die Produktivität der Analysten — von Marketing- und Produktanalysen bis hin zu BI — zu steigern.
Der Data Scientist hingegen beteiligt sich aktiv an der Unternehmensstrategie und an der Gewinnung von Insights, der Entscheidungsfindung, der Implementierung von Automatisierungsalgorithmen, der Modellierung und der Generierung von Werten aus Daten.
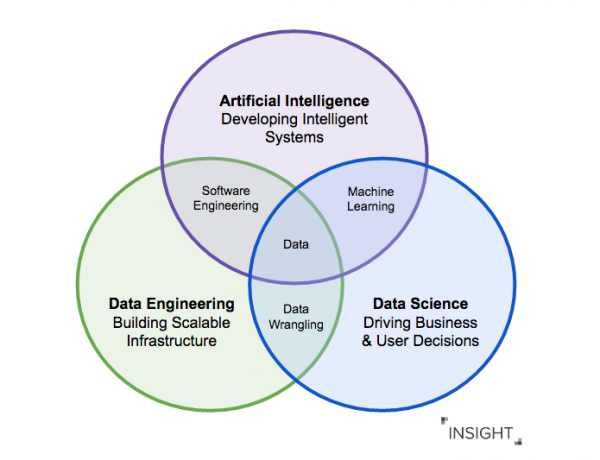
Die Arbeit mit Daten folgt dem GIGO-Prinzip (garbage in — garbage out): Wenn Analysten und Data Scientists mit unvorbereiteten und potenziell fehlerhaften Daten arbeiten, werden selbst mithilfe der ausgeklügeltsten Analysetools die Ergebnisse falsch sein.
Data Engineers lösen dieses Problem, indem sie Pipelines für die Verarbeitung, Bereinigung und Transformation von Daten aufbauen und es dem Data Scientist ermöglichen, mit qualitativ hochwertigen Daten zu arbeiten.
Der Markt bietet viele Werkzeuge zur Datenverarbeitung, die jede Phase abdecken: vom Entstehen der Daten bis zur Anzeige auf dem Dashboard für die Geschäftsführung. Es ist wichtig, dass die Entscheidung über ihren Einsatz vom Ingenieur getroffen wird — nicht, weil es in Mode ist, sondern weil es tatsächlich den anderen Beteiligten im Prozess helfen wird.
Bedarfsweise: Wenn ein Unternehmen BI und ETL zusammenführen möchte — die Datenladeprozesse und die Aktualisierung von Berichten, dann ist hier die typische Legacy-Infrastruktur, mit der sich ein Data Engineer auseinandersetzen muss (es wäre gut, wenn es im Team neben ihm auch einen Architekten gibt).
Aufgaben des Data Engineers
- Entwicklung, Aufbau und Wartung der Infrastruktur zur Datenverarbeitung.
- Fehlerbehandlung und Erstellung zuverlässiger Datenverarbeitungspipelines.
- Umwandlung unstrukturierter Daten aus verschiedenen dynamischen Quellen in ein Format, das für Analysten erforderlich ist.
- Bereitstellung von Empfehlungen zur Verbesserung der Konsistenz und Qualität von Daten.
- Bereitstellung und Unterstützung der Datenarchitektur, die von Data Scientists und Datenanalysten verwendet wird.
- Verarbeitung und Speicherung von Daten konsistent und effizient in einem verteilten Cluster aus Dutzenden oder Hunderten von Servern.
- Bewertung technischer Kompromisse von Werkzeugen zur Schaffung einfacher, aber robuster Architekturen, die Ausfälle überstehen können.
- Überwachung und Unterstützung der Datenströme und der zugehörigen Systeme (Einrichtung von Monitoring und Alerts).
Es gibt eine weitere Spezialisierung innerhalb der Laufbahn des Data Engineers — ML Engineer. Kurz gesagt, solche Ingenieure spezialisieren sich darauf, Modelle für maschinelles Lernen in den produktiven Einsatz zu bringen. Oft ist das Modell, das vom Data Scientist kommt, Teil einer Untersuchung und funktioniert möglicherweise nicht unter Produktionsbedingungen.
Aufgaben des Data Scientists
- Extraktion von Merkmalen aus Daten zur Anwendung von Algorithmen des maschinellen Lernens.
- Einsatz verschiedener Machine-Learning-Tools zur Prognose und Klassifizierung von Mustern in Daten.
- Steigerung der Leistung und Genauigkeit von Machine-Learning-Algorithmen durch Feineinstellung und Optimierung der Algorithmen.
- Entwicklung "starker" Hypothesen gemäß der Unternehmensstrategie, die zu überprüfen sind.
Sowohl Data Engineers als auch Data Scientists tragen wesentlich zur Entwicklung einer datenbasierten Arbeitskultur bei, durch die das Unternehmen zusätzlichen Gewinn erzielen oder Kosten senken kann.
Mit welchen Programmiersprachen und Werkzeugen arbeiten Ingenieure und Wissenschaftler?
Heutzutage haben sich die Erwartungen an Datenverarbeitungs-Spezialisten geändert. Früher erstellten Ingenieure umfangreiche SQL-Abfragen, schrieben MapReduce von Hand und verarbeiteten Daten mit Tools wie Informatica ETL, Pentaho ETL, Talend.
Im Jahr 2020 kommt kein Spezialist ohne Kenntnisse in Python und modernen Berechnungstools (z. B. Airflow) aus, ebenso wie ein Verständnis der Funktionsweise von Cloud-Plattformen (einsetzen zur Einsparung bei der Hardware unter Berücksichtigung der Sicherheitsprinzipien).
SAP, Oracle, MySQL, Redis — das sind die für Dateningenieure typischen Werkzeuge in großen Unternehmen. Sie sind gut, aber die Lizenzkosten sind so hoch, dass es nur in Industrieprojekten sinnvoll ist, damit zu lernen. Es gibt jedoch eine kostenlose Alternative in Form von Postgres — es ist kostenlos und eignet sich nicht nur zum Lernen.
Historisch gesehen wird oft nach Java und Scala gefragt, obwohl diese Sprachen mit der Weiterentwicklung von Technologien und Ansätzen in den Hintergrund treten.
Dennoch sind hardcore Big Data-Technologien wie Hadoop, Spark und der gesamte Zoo nicht mehr zwingend Voraussetzung für Dateningenieure, sondern eine Art von Werkzeugen zur Lösung von Aufgaben, die mit herkömmlichem ETL nicht gelöst werden können.
Im Trend liegen Dienste, die die Verwendung von Tools ohne Kenntnisse der Programmiersprache ermöglichen, in der sie geschrieben wurden (z. B. Hadoop ohne Java-Kenntnisse), sowie die Bereitstellung fertiger Dienste zur Verarbeitung von Streaming-Daten (Spracherkennung oder Bildanalyse in Videos).
Industrielle Lösungen von SAS und SPSS sind beliebt, wobei auch Tableau, Rapidminer, Stata und Julia von Data Scientists für lokale Aufgaben häufig verwendet werden.
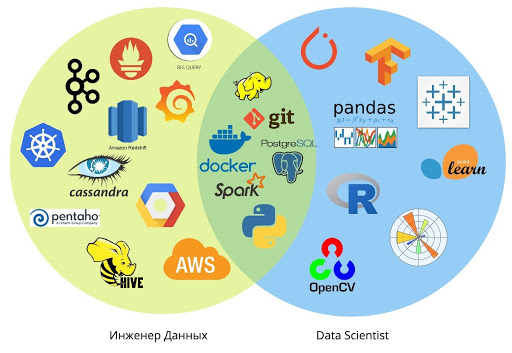
Die Möglichkeit, selbst Pipelines zu erstellen, gab es für Analysten und Data Scientists erst vor ein paar Jahren: Bereits mit relativ einfachen Skripten können Daten in ein auf PostgreSQL basierendes Repository geleitet werden.
In der Regel liegen die Nutzung von Pipelines und integrierten Datenstrukturen im Verantwortungsbereich von Data Engineers. Doch heute ist der Trend zu T-förmigen Spezialisten stärker denn je – mit breiten Kompetenzen in verwandten Bereichen, da die Werkzeuge ständig vereinfacht werden.
Warum Data Engineers und Data Scientists zusammenarbeiten sollten
Durch enge Zusammenarbeit mit Ingenieuren können Data Scientists sich auf den Forschungsaspekt konzentrieren und einsatzbereite Algorithmen für maschinelles Lernen entwickeln.
Die Ingenieure hingegen können sich auf Skalierbarkeit, Wiederverwendbarkeit von Daten konzentrieren und sicherstellen, dass Daten-Ein- und -Ausgabepipelines in jedem einzelnen Projekt mit der globalen Architektur übereinstimmen.
Diese Aufteilung der Verantwortlichkeiten sorgt für Konsistenz zwischen den Gruppen von Fachleuten, die an verschiedenen Projekten des maschinellen Lernens arbeiten.
Die Zusammenarbeit hilft, neue Produkte effektiv zu schaffen. Geschwindigkeit und Qualität werden erreicht, durch das Gleichgewicht zwischen dem Aufbau eines Services für alle (globale Speicherung oder Integration von Dashboards) und der Umsetzung jeder spezifischen Anforderung oder jedes Projekts (spezialisierte Pipeline, Anbindung externer Quellen).
Die enge Zusammenarbeit mit Data Scientists und Analysten hilft Ingenieuren, analytische und forschungsbasierte Fähigkeiten zu entwickeln, um qualitativ besseren Code zu schreiben. Der Wissensaustausch zwischen den Nutzern von Speicher- und Datenbanken wird verbessert, was die Projekte flexibler macht und nachhaltigere Ergebnisse sichert.
In Unternehmen, die sich zum Ziel gesetzt haben, eine Datenkultur zu entwickeln und Geschäftsprozesse darauf aufzubauen, ergänzen sich Data Scientists und Data Engineers und schaffen ein vollständiges System zur Datenanalyse.
Im nächsten Material werden wir darüber sprechen, welche Ausbildung Data Engineers und Data Scientists haben sollten, welche Fähigkeiten sie entwickeln müssen und wie der Markt strukturiert ist.
Von der Redaktion von Netology
Wenn Sie sich für die Berufe Data Engineer oder Data Scientist interessieren, laden wir Sie ein, unsere Kursprogramme zu erkunden:
- Beruf „».
- Beruf „».
Quelle: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish